让序列、构象与实验标注相互对照
蛋白质:从序列、折叠到柔性与功能
含酶洗衣液能帮助去除某些污渍,头发能弯曲,鸡蛋受热后会凝固,这些现象都与蛋白质有关。同样由氨基酸连接而成的长链,为什么能承担如此不同的工作?答案要从链的连接继续往下追:哪些位置能够转动,哪些部分常常靠在一起,哪些区域保留了许多不同的姿势。本节把这些分子图景接到一个实际AI任务上:输入蛋白质序列,学习哪些位置更可能属于实验标注的无序区域。
这项任务能帮助研究者安排后续工作。例如,制作一个蛋白质片段用于实验时,需要知道截取位置可能落在稳定结构内部,还是处在柔性的连接区;比较一组候选序列时,也需要把局部性质的差异定位到具体残基。我们会使用公开参考数据,从最容易解释的氨基酸计数开始,逐步运行局部卷积网络和预训练蛋白质语言模型。模型以无序区参考标注评价逐残基预测,并通过训练曲线观察学习过程。
01一根有方向、有侧链、也有转动限制的长链
第三节介绍过蛋白质由氨基酸残基组成。现在把镜头拉近一点:沿多肽主链走,会反复经过氮原子、α碳原子和羰基碳原子,常记成N—Cα—C′。其中Cα连接着区分氨基酸种类的侧链。把主链比作一条连接带,侧链就像安装在不同位置的附件:有的容易与水接触,有的更适合埋在疏水环境中,有的带电,还有的能形成额外的共价连接。附件的种类和排列共同改变整条链的行为。
常见蛋白质序列用二十种氨基酸的一字母代码记录,例如A表示丙氨酸,G表示甘氨酸,K表示赖氨酸。字母在这里是化学身份的标签。若任意把A、C、D编成1、2、3,数字相减会得到一套人为的远近关系,模型却可能把它当成分子差别。因此,程序先使用独热编码:为一个残基准备二十个格子,只在所属氨基酸的格子填1,其余填0。它像一张只勾选一项的登记表,清楚记录“是哪一种”,让后面的学习步骤再从数据中建立各类残基与预测目标的关系。
序列也有方向。通常从N端写向C端,相当于规定了读链的起点和终点。交换两个残基的位置,即使氨基酸总数保持不变,也改变了谁与谁相邻,以及某种侧链出现在局部环境中的位置。因此,研究蛋白质时可以同时提出两个层次的问题:这条链总共含有哪些成分,以及这些成分怎样沿链排列。前一个问题适合计数,后一个问题需要保留顺序。我们将把它们做成不同的模型输入,直接观察省去位置信息会发生什么。
多肽链的转动并非每一处都同样自由。肽键具有部分双键性质,与它相连的一组原子通常接近共面;主链构象的变化则主要通过相邻的N—Cα和Cα—C′键周围的转动来描述。这两个转角分别记作φ和ψ。可以把它们想成两个相接的转轴:转动第一个会改变前后两块片面的相对方向,转动第二个会继续改变后续链段的朝向。把许多这样的转角接起来,就能从一串局部方向得到整条链的空间路径。
这里还有一条来自高分子物理的基本约束:原子占据空间。某些φ、ψ组合会让本来不相连的原子挤得过近,代价很高;另一些组合能让原子彼此留出足够距离。1963年,Ramachandran、Ramakrishnan与Sasisekharan把多肽的局部几何和空间接近限制放到一起分析,使“链能朝哪些方向转”变成可以画在转角平面上的问题。这篇研究连接了化学键几何与长链构象,也说明为什么不能把所有角度都等概率地交给一个蛋白质模型。
甘氨酸的侧链是氢,局部空间比较宽松;脯氨酸的侧链回接到主链氮,形成环,限制了某些转动。其他残基的侧链大小、带电状态和相互作用方式又各不相同。这些差异并不会把一种氨基酸固定成一种唯一形状,却会改变它在不同局部构象中的偏好。想到一群人通过狭窄走廊时,可以用身上携带物品的大小来理解空间限制;真正的原子还会受到电荷和溶剂等作用,需要把这些因素一起计入。
当若干相邻残基重复采用相近的局部构象,并形成相应的主链氢键排列时,可以出现α螺旋或β折叠等二级结构。α螺旋沿自身轴线盘旋,β链则较为伸展,多条β链之间可以形成片层。再往上看,螺旋、片层与连接区域共同排列成一个结构域,多个结构域又可能通过柔性片段连接。沿着“局部转动受到约束,局部结构进一步组织成整体”这条关系往下看,就能理解为什么一个序列模型既要看邻近位置,也可能需要联系很远的位置。
原子结构图中的曲线、飘带和箭头,是帮助阅读这些层次的画法。飘带画得平滑,并不表示真实分子是一块连续的带状物;某个结构域画得整齐,也不表示它在溶液中完全静止。《高分子链动力学:Rouse模型、扩散与松弛》已经说明,链的构象会随时间改变。在蛋白质里,变化幅度和时间尺度沿序列并不均匀:有些局部结构相对稳定,某些环和连接区则更容易调整。理解这种不均匀性,是从“有一张结构图”走到“知道它怎样工作”的第一步。
02折叠是许多作用的合计,柔性也能参与功能
把一根无标记的细绳放进水里,它可以形成许多相似的盘绕姿势;把带有不同侧链的蛋白质放在相同环境中,不同接触的代价与收益就会有所区别。疏水侧链与水的相处方式、主链与侧链的氢键、电荷之间的作用、原子间的紧密堆积,以及有时存在的二硫键,会共同改变构象的相对机会。前面讨论的能量与熵仍然适用,只是现在链上各处的化学身份明确,哪些位置接近变得尤其重要。
想象整理一根装有不同扣子的软带。某些扣子能够配合,某些组合会互相顶住,另一些位置需要暴露出来与外部物体接触。带子折起来时,许多局部选择会互相影响。这个类比有助于理解序列如何影响接触关系,但分子没有人在逐一扣合:它持续受到热运动驱动,在环境中探索构象,构象之间的自由能差决定长期的统计偏好。折叠过程中的路径和速度,还需要《高分子链动力学:Rouse模型、扩散与松弛》的动力学信息来解释。
Anfinsen及其合作者研究核糖核酸酶A时,利用变性条件和还原处理扰动其结构与二硫键,再考察恢复适当条件后活性的重建。这个研究思路把一个关键问题摆到实验台上:一条已经失去原有空间排列的链,是否仍携带重建活性构象所需的信息?他在1973年发表的诺贝尔演讲中将这些工作与热力学假说联系起来,强调序列、原子相互作用和给定环境之间的关系。序列的重要性由此获得了具体的实验支撑。
要把这种图景写成可以计算的关系,可以暂时把构象归成折叠态集合F和展开态集合U。在两态平衡近似中,ΔG表示F相对于U的摩尔自由能差,等于GF−GU。ΔH是相应的摩尔焓差,反映包括溶剂在内的相互作用变化;ΔS是摩尔熵差,反映可访问状态等因素;T是用开尔文表示的绝对温度。折叠减少链本身的构象选择,同时可能改变水的状态,因此计算熵时需要明确研究系统包含哪些部分。
第二行来自平衡统计:自由能较低的那一类构象占据较大的总体概率。这里R是气体常数,约为8.314 J·mol−1·K−1,所以RT与ΔG都有J·mol−1的单位,两者相除后才能进入指数。PF和PU是两个集合的概率,和为1。由它们的比值再加上这个归一化条件,就能得到第三行。集合内部有多少种构象,已经包含在相应自由能里,不能又额外乘一次构象数。
在300 K时,RT约为2.49 kJ·mol−1。假设某个两态体系的ΔG恰好为−2RT,则折叠态与展开态的概率比为e²,约7.39,折叠比例为7.39/(1+7.39),约88.1%。若ΔG变成0,两类各占一半。这个算例展示的是自由能差怎样转成比例;实际蛋白质的ΔG需要测量或建立适当模型才能得到。看见一个序列,还需要研究其具体相互作用和环境,才能给这个公式填入数值。
两态近似将复杂构象压缩成两个集合,适合先学习统计关系。实际蛋白质可以具有多个结构域、折叠中间态,也可以在不同条件下形成聚集体。煮熟鸡蛋后蛋白质形成新的聚集网络,正说明从一个受热过程返回原条件,并不保证沿原路径回到最初状态。这里要同时考虑自由能分布、分子间接触和动力学通道。我们研究某个蛋白质时,应当先确定实验观察到了哪些状态,再选择能解释这些状态的模型。
还有许多蛋白质区域在其生理条件下保持多种构象,缺少稳定的单一三维折叠,通常称为内在无序区。它们能充当柔性连接,提供可调节的接触范围,或在与伙伴结合时改变局部结构。1996年,Kriwacki等人结合核磁共振、圆二色谱和其他方法研究p21,发现游离的p21及有活性的N端片段缺乏稳定的二级和三级结构,而与Cdk2结合的N端能够形成有序构象。这一实验把柔性与结合功能直接联系起来。
因此,“有序”和“无序”描述的是特定条件下的结构行为,并不等同于“有功能”和“没有功能”。一个有稳定折叠的酶也可能带有活动的环;一段无序链也可能保留短暂的局部结构偏好。它们都可以用构象系综描述,只是概率集中程度、局部相互作用和交换时间不同。第五至八节关于尺寸、溶剂和运动的知识在这里重新汇合:了解一条柔性蛋白质,需要同时知道它占多大空间、对环境如何响应,以及构象怎样随时间变化。
AI进入这个问题时,首先需要选择明确的预测对象。预测三维坐标、预测某个残基的无序标注、预测两个蛋白质是否结合,是三种不同任务,训练标签和评价方法也不同。本节选择第二种:沿一条蛋白质序列输出一串分数,再与公开参考文件中已有的逐残基标注比较。这样可以保留真实的生物问题,同时将计算规模控制在普通CPU能够运行的范围,让我们逐步检查模型究竟从哪些输入中得到帮助。
03先弄清标签,再把蛋白质分给模型学习
一条序列有三百个残基,不意味着已经有三百条同样清楚的结构结论。实验可能只研究了其中一段,某些区域有明确的无序证据,另一些位置能够对应结构资料,还有一些位置不进入当前评价。整理训练数据时,如果把最后一类一律填成“有序”,模型就会学习到实验覆盖范围留下的空白。这个错误很隐蔽:表格变得完整了,监督信号却改变了含义。保留缺少评价标签的位置,是让数据忠实于测量工作的关键步骤。
我们使用CAID官方仓库中公开的Disorder-PDB参考文件。读取固定版本后共有319条蛋白质记录,每条包含标识符、氨基酸序列和等长的标签行。标签“1”表示无序,“0”表示有序,“−”表示不纳入评价。CAID对不同参考集的比较也展示了标签覆盖方式怎样影响评价结果:2021年的原始研究专门比较了保留和过滤不确定位置的参考设置。本例沿用下载文件给定的标签,保持三种状态的区别。
先用一条简短记录练习读法。假设序列为ACDEG,标签为01−10,那么A、C、E、G四个位置参加评价,D所在的位置暂时跳过。有序标签出现在第1和第5位,无序标签出现在第2和第4位。D仍然属于这条蛋白质,模型读取邻近序列时仍可使用它的化学身份;跳过的是这个位置的监督误差,不是从分子链上删掉一个残基。上下文是否存在与监督信息是否存在,需要分别保存。
为了便于在CPU上完整运行,我们预先规定筛选条件:长度在64至768个残基之间,全部使用二十种标准氨基酸代码,并且至少有32个可评价位置。筛选后保留254条蛋白质、90251个残基。筛选依据是长度、编码和标签覆盖,尚未涉及模型分数。原始参考文件与模型权重都固定版本并核对校验值,代码可以重新下载同一份内容。这样读者看到的训练结果能够对应到确定的输入,而不会随网页文件更新悄悄变化。
接着需要划分训练、验证和测试数据。训练集让模型调整权重,验证集选择超参数和训练轮次,测试集在这些选择完成后评价最终模型。如果将同一条蛋白质上的残基随机拆进三组,相邻窗口会大量重叠,模型在训练中见过的上下文几乎原样出现在测试里。更进一步,两条序列相近的蛋白质也可能共享大片模式。因此,划分单位需要从单个残基提高到整条蛋白质,并把满足相似条件的序列放在一起。
本例使用局部序列比对,把相同残基所占比例至少30%、且对两条序列都覆盖至少70%残基的配对连接起来。沿这些连接能够互相到达的蛋白质归入同一组。可以将它想成整理一摞相近版本的文章:甲与乙相似,乙与丙相似,即使甲丙没有直接满足配对条件,也把这三份材料放进同一组,避免相关版本被拆开。这里的“组”由明确的比对规则定义,代码同时保留了相同残基比例和覆盖比例,方便检查。
254条序列形成230个相似性组。用固定随机种子打乱组顺序后,前60%的组进入训练,中间20%进入验证,其余进入测试,最后得到155、50和49条蛋白质。训练集含41877个已标注位置,验证集含13686个,测试集含13122个;其余位置继续保留“−”。我们会先完成整个划分,再提取局部窗口。于是,一个有监督的训练样本不仅包含输入和标签,还能追溯到所属蛋白质与相似性组。
损失函数从已经有实验标签的位置计算。设集合A收集本次参与训练的所有“0”和“1”位置,yᵢ是某位置的标签,pᵢ是模型输出的无序分数。真实标签为1时,用−ln pᵢ衡量偏差;为0时,用−ln(1−pᵢ)。把这些项相加,再除以实际有标签的位置数,就得到平均交叉熵。可以把未知标签看成尚未批改的答题格:它们既不给模型加分,也不扣分。若把未知位置当作0,程序就会把“没有标注”学成“有序”,预测目标也随之改变。
若真实标签为1,预测p=0.8,对应误差约为0.223;若给出p=0.2,误差增至约1.609。对真实标签为0的位置,情况对称。这使模型在给出与标注强烈冲突的高分时付出较大代价。对数中的p没有单位,交叉熵也没有物理单位。它衡量模型输出与监督信息之间的匹配,不是蛋白质的自由能;前面两态公式中的指数与这里的预测公式虽然外形相似,所描述的对象需要分别理解。
读到这里已经可以把实验任务说完整:输入来自真实蛋白质序列,监督来自逐残基的公开参考标注,未知位置参与上下文而不参与损失,相似序列按组分开。接下来增加模型复杂度,改变的是序列表示与学习方法。这几个关于数据的约定始终保持一致,才能把结果差异与模型究竟获得了什么信息联系起来。
04从氨基酸计数,到会读取上下文的模型
第一个模型拿到的是全链组成。对每一种氨基酸a,数出它在序列中出现的次数,再除以总长度L,就得到比例fa。符号si表示第i个残基,带条件的指示函数在条件成立时取1,否则取0。例如一条十残基短链中有两个A,fA就是2/10=0.2。二十种比例加起来为1,既方便比较长度不同的序列,也明确保留了这条链的化学组成信息。
全链组成有一个容易看出的特点:它给同一条蛋白质上的每个位置提供完全相同的输入。因此,这个模型可以学到哪些组成较常出现在无序丰富的蛋白质中,却无法区分同一条链的稳定结构域与柔性末端。结果图上它将是一条水平线。保留这个简单模型很有用,因为它让我们知道,只利用全链统计信息已经能做到什么,后续变化又增加了哪些空间定位能力。
第二个模型把计数窗口移动到各个位置。以第i个残基为中心,向左和向右各看十个残基,最多得到二十一个位置,再在其中统计二十种氨基酸的比例。例如窗口里有三个G,局部甘氨酸比例就是3/21,约0.143。来到序列的第一个残基时,左侧没有残基,窗口实际包含第1至第11位,分母便改成11。这样端点不会因为补入不存在的残基而得到偏小的组成比例。
集合Wi就是这些实际存在的窗口位置,竖线包围集合表示其中元素的数量。公式先说明“在哪些位置计数”,再说明“怎样除以实际窗口长度”。这种写法可以直接对应代码中的左右边界。窗口模型还没有精确区分窗口内部的排列,但它已经能够识别沿序列变化的局部组成。例如,同一条链的一段富含带电残基,另一段含较多疏水残基,两个窗口就会给模型不同的数字。
这两个计数模型都接一个逻辑回归分类器。先用训练集中已标注位置的均值μ和标准差σ,把每个输入特征缩放到便于学习的尺度,再以权重w加权求和,加上偏置b,得到分数z。最后使用sigmoid函数,将任意实数映射到0和1之间。均值与标准差在训练之后固定,验证和测试数据使用同一套转换规则。对于训练中没有变化的特征,程序把缩放因子设为1,避免除以零。
z=0时,输出正好为0.5;z约为1.386时,输出约为0.8。权重决定哪些输入变化会让分数上升或下降,偏置调整整体基准。这里的权重来自有标签的训练数据,通过减小交叉熵学得。训练还加入抑制过大权重的正则化,验证集从五个预先规定的强度中选择一项。这样,读者既能看见模型怎样利用每个特征,也能将训练、参数选择和最终测试分开。
第三个模型是一个小型一维卷积网络。它读取同样宽度的二十一个残基,但为每个相对位置保存不同权重。可以把它看成一把能够学习图案的短尺:短尺从链头滑到链尾,每次检查中心左右的字母组合;尺子上的刻度始终共享同一套规则。于是,某种残基出现在中心左边或右边,可以产生不同影响。相同的局部模式出现在另一条蛋白质上时,也由同一组参数处理。
公式中的xi+δ,a是独热编码,δ从−10到10表示相对中心的偏移,a从1到20表示氨基酸种类,c从1到24表示不同的识别通道。每个通道先计算一组局部加权和u,再经过tanh变成h;tanh会平滑地把数值压到−1至1之间,使模型能够组合非线性的局部模式。最后把二十四个通道加权得到z,再接sigmoid。序列边界外的输入填0,对应代码中卷积的补边操作。
网络的10129个参数从随机初值开始学习。每批训练时,程序先计算已标注位置的误差,再由反向传播求出各个参数对误差的影响,使用Adam更新参数。可以将这个过程理解为反复调整短尺上的刻度:哪些调整能在当前训练样本上减小误差,就沿相应方向小步移动。每轮训练后,再检查整组验证蛋白质的误差,保存验证表现最好的参数。我们用三个随机种子分别训练,再平均三个已选模型的输出。
第四种表示来自蛋白质语言模型。它的预训练任务类似填空:把蛋白质序列中的一些残基遮住,根据其余上下文推断被遮住的氨基酸。大量自然序列提供了这样的自监督信号,模型因而能学习氨基酸搭配与上下文之间的统计关系。2023年,Lin等人的ESM-2相关研究进一步把蛋白质语言模型表示接到结构预测任务上。本例则取其中一个六层、约八百万参数的小模型,考察预训练表示怎样帮助逐残基分类。
程序实际载入ESM-2权重,将每个残基变成一个320维向量。这个向量可以理解为该位置在整条序列上下文中的数值描述;各个分量由预训练共同形成,并没有预先规定“第一维就是疏水性、第二维就是电荷”。我们固定整个预训练网络,只在320维表示上训练逻辑回归分类器。这样,大量序列上已经学得的表示得到复用,而当前任务的监督训练集中在较小的输出层。
这也明确了四种方法之间的资源差别:前三种方法从当前训练蛋白质的标注中学习,第四种方法还带着外部序列预训练的积累。我们的相似性分组控制当前监督数据的划分;若研究目标变成评价模型面对预训练之外全新家族的表现,还需要把预训练序列范围接入去重流程。当前实验回答的是,在同一组公开标注与同一划分下,固定预训练表示能给这个任务提供怎样的帮助。这个问题足以支持一次完整且可以复做的比较。
交互图选择测试集中的DP03933。选择规则只查看长度与标签覆盖:同时具有至少50个有序和50个无序标注、还包含未知位置的测试蛋白质中,取长度最接近400的那条。图中四条曲线都是实际训练后的保存结果。移动窗口时,可以对照一个残基周围的字母、参考标签与预测分数,观察全链组成为什么始终不变,局部模型又怎样沿链改变判断。
沿一条真实蛋白质移动窗口 · DP03933
棕:全链组成 蓝:局部组成 橙:卷积网络 绿:ESM-2。底部参考色带中,蓝为有序,橙为无序,灰为未纳入评价。
试着把窗口从有序区域移到无序区域,再停到灰色标签位置。你会看到模型在灰色位置仍然能输出分数,因为完整序列仍然存在;这个分数尚未对应当前参考文件中的评价标签。接下来若要验证它,就需要回到实验资料或为该区域补充测量。这个操作把“模型有输出”和“已有证据支持评价”分成了两个可以直接观察的事实,也让后续选择研究位置有了清楚依据。
05运行完整实验,读懂模型真正学会了什么
下面的代码从固定版本的参考文件开始,完成筛选、相似性分组、特征提取、模型训练和绘图。首次运行会下载约31 MB的ESM-2权重及参考数据,之后复用本地下载文件;序列分组与训练过程可以重新计算。环境需要NumPy、Matplotlib、scikit-learn、Biopython、PyTorch、Transformers和requests。本页保存的是CPU运行结果,使用PyTorch 2.14.1、Transformers 5.20.2与Biopython 1.88。
阅读代码时,可以沿三处关键连接往下看:序列与标签长度必须一致,整条蛋白质先得到所属数据组,然后只有标签为0或1的位置进入损失和指标计算。预训练模型生成特征时去掉序列起始与结束的特殊标记,使第一个特征向量准确对应第一个真实残基。预测结果保存了每个位置的分数、每个模型的参数和数据划分,因而能够从一幅图追到具体样本与模型参数。
"""Real CAID reference labels, similarity-group splits, and protein sequence learning.
Install: numpy matplotlib scikit-learn biopython torch transformers requests.
First run downloads a pinned CC BY 3.0 reference and MIT ESM-2 checkpoint (~31 MB).
Run in an empty working folder; all caches and outputs stay in that folder.
CPU execution; unknown labels are masked, while their amino acids remain context.
"""
from pathlib import Path
from collections import Counter
import copy
import hashlib
import json
import time
import requests
import numpy as np
import torch
from torch import nn
from Bio.Align import PairwiseAligner, substitution_matrices
from transformers import AutoTokenizer, AutoModelForMaskedLM
from transformers.utils import logging
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import log_loss, average_precision_score, f1_score, precision_recall_curve
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

HERE=Path.cwd()
OUT=HERE/'protein_outputs';OUT.mkdir(exist_ok=True)
AA='ACDEFGHIKLMNPQRSTVWY'
torch.set_num_threads(4);torch.set_num_interop_threads(1)
torch.use_deterministic_algorithms(True)
CAID_COMMIT='7bab7e8880d7f949e480fdb377c5a5c8546ae336'
CAID_SHA='b65848395557c751a818dc38049c89d95534c05fbe6f14651e9f5bfd2bb60469'
MODEL_REVISION='c731040fcd8d73dceaa04b0a8e6329b345b0f5df'
MODEL_FILES={'config.json': 'facb9355e8252149f6f99dff5fd1e32e890c3c655362b261d0c81cd6b5839c85', 'model.safetensors': '24c5fa474c48f3b754b86efe752d5f189d2bcd88190fa2270fc92b2ef3034189', 'special_tokens_map.json': '3aedcd4211c0d43aec4e607ff60a63255f3174ead795e997350f09a5f8cd9ee1', 'tokenizer_config.json': '7e9161ecdb548ec45a41cbc6b24aa4476fdd418461f491c4207baa99419a29ad', 'vocab.txt': '0b82cc0a7c7cf9e567b1e5892d793285b9fbae822c964ca48696f7db44598e03', 'README.md': '462a2f24724e19c6be0efab926315c294a863c9a9770e2c8b3d859b2d81a07de'}

def fetch_checked(url,target,digest):
    if target.exists() and hashlib.sha256(target.read_bytes()).hexdigest()==digest:return
    response=requests.get(url,timeout=120);response.raise_for_status()
    assert hashlib.sha256(response.content).hexdigest()==digest, 'Source checksum changed'
    target.write_bytes(response.content)

def prepare_reference():
    fetch_checked(f'https://raw.githubusercontent.com/BioComputingUP/CAID/{CAID_COMMIT}/demo-data/references/disorder_pdb.fasta',
                  HERE/'caid_disorder_pdb.fasta',CAID_SHA)
    lines=(HERE/'caid_disorder_pdb.fasta').read_text().splitlines();records=[];excluded=[]
    for i in range(0,len(lines),3):
        identifier=lines[i][1:];sequence=lines[i+1];labels=lines[i+2]
        assert len(sequence)==len(labels) and set(labels)<=set('01-')
        reason=[]
        if not 64<=len(sequence)<=768:reason.append('length_outside_64_768')
        if not set(sequence)<=set('ACDEFGHIKLMNPQRSTVWY'):reason.append('noncanonical_residue')
        if sum(v in '01' for v in labels)<32:reason.append('fewer_than_32_evaluable_residues')
        row={'id':identifier,'sequence':sequence,'labels':labels,'length':len(sequence)}
        if reason:excluded.append({'id':identifier,'reasons':reason})
        else:records.append(row)
    records.sort(key=lambda r:r['id'])
    aligner=PairwiseAligner();aligner.mode='local';aligner.substitution_matrix=substitution_matrices.load('BLOSUM62')
    aligner.open_gap_score=-10.;aligner.extend_gap_score=-.5
    parent=list(range(len(records)))
    def root(i):
        while i!=parent[i]:parent[i]=parent[parent[i]];i=parent[i]
        return i
    def union(i,j):
        a,b=root(i),root(j)
        if a!=b:parent[max(a,b)]=min(a,b)
    pairs=[];edges=[];start=time.perf_counter();skipped=0
    for i,a in enumerate(records):
        for j in range(i+1,len(records)):
            b=records[j]
            # Paired-residue coverage >=70% of BOTH sequences is impossible otherwise.
            if min(a['length'],b['length'])/max(a['length'],b['length'])<.7:
                skipped+=1;continue
            alignment=aligner.align(a['sequence'],b['sequence'])[0]
            matched=0;paired=0
            for (a0,a1),(b0,b1) in zip(*alignment.aligned):
                matched+=sum(x==y for x,y in zip(a['sequence'][a0:a1],b['sequence'][b0:b1]))
                paired+=int(a1-a0)
            columns=int(np.max(np.diff(alignment.coordinates,axis=1),axis=0).sum())
            identity=matched/columns;ca=paired/a['length'];cb=paired/b['length']
            pair={'a':a['id'],'b':b['id'],'identity':identity,'coverage_a':ca,'coverage_b':cb}
            pairs.append(pair)
            if identity>=.3 and ca>=.7 and cb>=.7:
                union(i,j);edges.append(pair)
        if i%40==0:print('Aligned index',i,'/',len(records),'elapsed',round(time.perf_counter()-start,1),flush=True)
    groups={}
    for i,row in enumerate(records):groups.setdefault(root(i),[]).append(row)
    ordered=sorted(groups);shuffled=np.random.default_rng(909).permutation(ordered)
    train_end=int(.6*len(shuffled));valid_end=int(.8*len(shuffled))
    for i,g in enumerate(shuffled):
        split='train' if i<train_end else 'validation' if i<valid_end else 'test'
        name=min(r['id'] for r in groups[g])
        for row in groups[g]:row['cluster']=name;row['split']=split
    mapping={r['id']:r for r in records}
    assert all(mapping[e['a']]['split']==mapping[e['b']]['split'] for e in edges)
    stats={}
    for split in ['train','validation','test']:
        subset=[r for r in records if r['split']==split];counts=Counter(''.join(r['labels'] for r in subset))
        stats[split]={'proteins':len(subset),'clusters':len({r['cluster'] for r in subset}),
                      'residues':sum(r['length'] for r in subset),'label_counts':dict(counts)}
        assert counts['0']>0 and counts['1']>0
    output={'source_sha256':hashlib.sha256((HERE/'caid_disorder_pdb.fasta').read_bytes()).hexdigest(),
        'selection':'64<=length<=768; canonical20aminoacids; >=32 evaluated residues; no score-based selection',
        'clustering':'Connected components; local BLOSUM62 alignment open-10 extend-.5; identity>=.30; paired-residue coverage>=.70 of each sequence',
        'split':'seed909 shuffled connected components, first60%train,next20%validation,last20%test',
        'records':records,'excluded':excluded,'similarity_edges':edges,'all_length_compatible_pair_metrics':pairs,
        'length_incompatible_pairs_skipped':skipped,'cluster_count':len(groups),
        'max_cluster_size':max(map(len,groups.values())),'statistics':stats,'elapsed_seconds':time.perf_counter()-start}
    (HERE/'grouped_reference.json').write_text(json.dumps(output,indent=2),encoding='utf-8')
    return output

def prepare_embeddings(reference):
    model_folder=HERE/'esm2_model';model_folder.mkdir(exist_ok=True)
    folder=HERE/'embeddings';folder.mkdir(exist_ok=True)
    for filename,digest in MODEL_FILES.items():
        fetch_checked(f'https://huggingface.co/facebook/esm2_t6_8M_UR50D/resolve/{MODEL_REVISION}/{filename}',
                      model_folder/filename,digest)
    records=sorted(reference['records'],key=lambda r:(r['length'],r['id']))
    logging.set_verbosity_error();logging.disable_progress_bar()
    tokenizer=AutoTokenizer.from_pretrained(model_folder,local_files_only=True)
    model=AutoModelForMaskedLM.from_pretrained(model_folder,local_files_only=True,use_safetensors=True)
    model.eval();model.requires_grad_(False)
    assert model.config.hidden_size==320 and model.config.num_hidden_layers==6
    entries=[]
    with torch.inference_mode():
        for start in range(0,len(records),4):
            batch=records[start:start+4]
            inputs=tokenizer([r['sequence'] for r in batch],padding=True,return_tensors='pt')
            assert np.array_equal(inputs['attention_mask'].sum(dim=1).numpy(),[r['length']+2 for r in batch])
            hidden=model.esm(**inputs).last_hidden_state.cpu().numpy()
            for j,row in enumerate(batch):
                features=hidden[j,1:row['length']+1].copy()
                assert features.shape==(row['length'],320) and np.isfinite(features).all()
                target=folder/(row['id']+'.npy');np.save(target,features,allow_pickle=False)
                entries.append({'id':row['id'],'sequence_sha256':hashlib.sha256(row['sequence'].encode()).hexdigest(),
                                'feature_sha256':hashlib.sha256(target.read_bytes()).hexdigest()})
    (HERE/'feature_checksums.json').write_text(json.dumps(entries,indent=2),encoding='utf-8')
    print('Frozen ESM-2 embeddings:',len(records),'proteins, 320 features per residue',flush=True)

def encode(sequence):
    return np.eye(20,dtype=np.float32)[[AA.index(a) for a in sequence]]

def windows(onehot,radius=10):
    prefix=np.vstack([np.zeros((1,20)),np.cumsum(onehot,axis=0)])
    left=np.maximum(0,np.arange(len(onehot))-radius)
    right=np.minimum(len(onehot),np.arange(len(onehot))+radius+1)
    return (prefix[right]-prefix[left])/(right-left)[:,None]

class LocalCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.network=nn.Sequential(nn.Conv1d(20,24,21,padding=10),nn.Tanh(),nn.Conv1d(24,1,1))
    def forward(self,x):return self.network(x).squeeze(1)

def batch_tensor(rows,indices):
    width=max(rows[i]['length'] for i in indices)
    x=np.zeros((len(indices),20,width),dtype=np.float32)
    y=np.zeros((len(indices),width),dtype=np.float32)
    mask=np.zeros((len(indices),width),dtype=bool)
    for j,i in enumerate(indices):
        row=rows[i];length=row['length'];x[j,:,:length]=row['onehot'].T
        y[j,:length]=np.maximum(0,row['y']);mask[j,:length]=row['y']>=0
    return torch.from_numpy(x),torch.from_numpy(y),torch.from_numpy(mask)

def predict_cnn(model,rows,indices):
    model.eval();pred={}
    with torch.inference_mode():
        for start in range(0,len(indices),16):
            ids=indices[start:start+16];x,_,_=batch_tensor(rows,ids)
            p=torch.sigmoid(model(x)).numpy()
            for j,i in enumerate(ids):pred[i]=p[j,:rows[i]['length']].astype(float)
    return pred

def concat_known(rows,indices,pred=None):
    yy=np.concatenate([rows[i]['y'][rows[i]['y']>=0] for i in indices])
    if pred is None:return yy
    pp=np.concatenate([pred[i][rows[i]['y']>=0] for i in indices])
    return yy,pp

def metrics(rows,indices,pred,threshold):
    y,p=concat_known(rows,indices,pred)
    per={rows[i]['id']:float(log_loss(rows[i]['y'][rows[i]['y']>=0],
         pred[i][rows[i]['y']>=0],labels=[0,1])) for i in indices}
    return {'residue_BCE':float(log_loss(y,p,labels=[0,1])),
        'average_precision':float(average_precision_score(y,p)),
        'F1':float(f1_score(y,p>=threshold)), 'threshold':float(threshold),
        'protein_macro_BCE':float(np.mean(list(per.values()))),'protein_losses':per}

def main():
    started=time.perf_counter()
    reference=prepare_reference()
    prepare_embeddings(reference)
    rows=reference['records'];groups={s:[i for i,r in enumerate(rows) if r['split']==s]
                                     for s in ['train','validation','test']}
    for row in rows:
        row['onehot']=encode(row['sequence'])
        row['y']=np.array([-1 if x=='-' else int(x) for x in row['labels']])
    tr,va,te=[groups[s] for s in ['train','validation','test']]
    ytrain=concat_known(rows,tr);yvalid=concat_known(rows,va)
    predictions={};heads={};histories=[];cnn_runs=[]
    for name in ['composition','window21','ESM2_frozen']:
        features=[]
        for row in rows:
            if name=='composition':f=np.repeat(row['onehot'].mean(axis=0)[None,:],row['length'],axis=0)
            elif name=='window21':f=windows(row['onehot'])
            else:f=np.load(HERE/'embeddings'/(row['id']+'.npy'),allow_pickle=False)
            # Use float64 for the convex classifier so the solver tolerance is meaningful.
            features.append(np.asarray(f,dtype=np.float64))
        xtrain=np.concatenate([features[i][rows[i]['y']>=0] for i in tr])
        xvalid=np.concatenate([features[i][rows[i]['y']>=0] for i in va])
        scaler=StandardScaler().fit(xtrain)
        xtrain=scaler.transform(xtrain);xvalid=scaler.transform(xvalid)
        choices=[];best=None
        for c in [.001,.01,.1,1.,10.]:
            head=LogisticRegression(C=c,max_iter=2000,tol=1e-7,solver='lbfgs').fit(xtrain,ytrain)
            assert int(head.n_iter_.max())<2000
            loss=float(log_loss(yvalid,head.predict_proba(xvalid)[:,1],labels=[0,1]))
            choices.append({'C':c,'validation_BCE':loss})
            if best is None or loss<best[0]:best=(loss,c,head)
        loss,c,head=best
        predictions[name]={i:head.predict_proba(scaler.transform(f))[:,1] for i,f in enumerate(features)}
        heads[name]={'selected_C':c,'choices':choices,'mean':scaler.mean_.tolist(),
                     'scale':scaler.scale_.tolist(),'coef':head.coef_[0].tolist(),
                     'intercept':float(head.intercept_[0])}
        print(name,'selected C',c,'validation BCE',round(loss,5),flush=True)

    for seed in [9,19,29]:
        torch.manual_seed(seed);rng=np.random.default_rng(seed)
        model=LocalCNN();initial={k:v.detach().clone() for k,v in model.state_dict().items()}
        optimizer=torch.optim.Adam(model.parameters(),lr=.003,weight_decay=.0001)
        best_loss=float('inf');best_state=None;best_epoch=0;history=[]
        for epoch in range(1,61):
            model.train();total_loss=0.;total_known=0
            order=rng.permutation(tr).tolist()
            for start in range(0,len(order),16):
                ids=order[start:start+16];x,y,mask=batch_tensor(rows,ids)
                optimizer.zero_grad(set_to_none=True)
                loss=nn.functional.binary_cross_entropy_with_logits(model(x)[mask],y[mask])
                loss.backward();optimizer.step()
                total_loss+=float(loss.detach())*int(mask.sum());total_known+=int(mask.sum())
            vp=predict_cnn(model,rows,va);yy,pp=concat_known(rows,va,vp)
            value=float(log_loss(yy,pp,labels=[0,1]))
            history.append({'epoch':epoch,'online_train_BCE':total_loss/total_known,'validation_BCE':value})
            if value<best_loss:
                best_loss=value;best_epoch=epoch;best_state=copy.deepcopy(model.state_dict())
            if epoch-best_epoch>=12:break
        model.load_state_dict(best_state)
        delta=float(sum(torch.sum((best_state[k]-initial[k])**2) for k in initial).sqrt())
        assert delta>0
        pred=predict_cnn(model,rows,list(range(len(rows))));cnn_runs.append(pred)
        histories.append({'seed':seed,'best_epoch':best_epoch,'best_validation_BCE':best_loss,
            'weight_change_l2':delta,'history':history,
            'state_dict':{k:v.detach().numpy().tolist() for k,v in best_state.items()}})
        print('CNN',seed,'best epoch',best_epoch,'val BCE',round(best_loss,5),'weight change',round(delta,3),flush=True)
    predictions['CNN21']={i:np.mean([r[i] for r in cnn_runs],axis=0) for i in range(len(rows))}
    results={'data':reference['statistics'],'data_url':f'https://raw.githubusercontent.com/BioComputingUP/CAID/{CAID_COMMIT}/demo-data/references/disorder_pdb.fasta',
        'reference_license':'CC BY 3.0','model_id':'facebook/esm2_t6_8M_UR50D','model_revision':MODEL_REVISION,
        'model_weight_sha256':MODEL_FILES['model.safetensors'],'pretraining':'frozen pretrained sequence model; supervised labels only from training components',
        'runtime':{'torch':torch.__version__,'numpy':np.__version__},'sequence_groups':reference['cluster_count'],
        'source_sha256':reference['source_sha256'],'heads':heads,'cnn_runs':histories,
        'CNN_description':'20 one-hot channels -> Conv1d(20,24,kernel21,padding10) -> tanh -> Conv1d(24,1,1); average of three validation-selected seeds',
        'threshold_rule':'maximize validation residue F1 over .05,.06,...,.95; first threshold wins ties',
        'test_metrics':{},'validation_metrics':{},'bootstrap':{}}
    rng=np.random.default_rng(1909)
    clusters=sorted({rows[i]['cluster'] for i in te})
    draws=rng.integers(0,len(clusters),size=(1000,len(clusters)))
    for name,pred in predictions.items():
        yy,pp=concat_known(rows,va,pred)
        candidates=np.arange(5,96)/100
        threshold=float(candidates[np.argmax([f1_score(yy,pp>=t) for t in candidates])])
        results['test_metrics'][name]=metrics(rows,te,pred,threshold)
        results['validation_metrics'][name]=metrics(rows,va,pred,threshold)
        losses=results['test_metrics'][name]['protein_losses']
        # Resample whole similarity components, keeping all proteins of each selected component.
        sums=np.array([sum(losses[rows[i]['id']] for i in te if rows[i]['cluster']==c) for c in clusters])
        counts=np.array([sum(rows[i]['cluster']==c for i in te) for c in clusters])
        bootstrap=sums[draws].sum(axis=1)/counts[draws].sum(axis=1)
        results['bootstrap'][name]={'protein_macro_BCE_95_percentile':np.quantile(bootstrap,[.025,.975]).tolist(),
                                  'replicates':1000,'unit':'whole sequence-similarity component'}
    # Example selection uses labels and length, never a prediction error.
    eligible=[i for i in te if rows[i]['labels'].count('0')>=50 and rows[i]['labels'].count('1')>=50 and '-' in rows[i]['labels']]
    example=min(eligible,key=lambda i:(abs(rows[i]['length']-400),rows[i]['id']))
    results['example_id']=rows[example]['id']
    results['example_selection']='test proteins with >=50 ordered and >=50 disordered labels plus unknowns; length nearest400, ID tie-break'
    results['seed_test_AP']=[float(average_precision_score(*concat_known(rows,te,p))) for p in cnn_runs]
    results['test_disorder_fraction']=float(np.mean(concat_known(rows,te)))
    samples={'source':'CAID pinned repository demo-data/references/disorder_pdb.fasta',
        'license':'CC BY 3.0','records':[{k:v for k,v in row.items() if k not in ['onehot','y']}|{
            'predictions':{name:pred[i].tolist() for name,pred in predictions.items()}}
            for i,row in enumerate(rows)],'similarity_edges':reference['similarity_edges']}
    (OUT/'samples.json').write_text(json.dumps(samples,separators=(',',':')),encoding='utf-8')
    (OUT/'results.json').write_text(json.dumps(results,indent=2),encoding='utf-8')
    for name,m in results['test_metrics'].items():
        print(name,'test AP',round(m['average_precision'],4),'F1',round(m['F1'],4),
              'residue BCE',round(m['residue_BCE'],4),'protein macro BCE',round(m['protein_macro_BCE'],4),flush=True)
    render_plots(results,samples)
    print('Example:',results['example_id'],'; six panels, all sequences and scores saved.',flush=True)

def render_plots(results,samples):
    plt.rcParams.update({'font.family':'DejaVu Sans','font.size':11,'axes.spines.top':False,
        'axes.spines.right':False,'axes.labelcolor':'#273b36','text.color':'#273b36',
        'svg.hashsalt':'ai4s-L09','savefig.facecolor':'#fffdf8'})
    names=['composition','window21','CNN21','ESM2_frozen']
    colors=['#a39372','#5c7899','#c17150','#267b69']
    labels=['Whole-protein composition','21-residue composition','21-residue CNN (3 seeds)','Frozen ESM-2 + linear head']
    test=[r for r in samples['records'] if r['split']=='test']
    example=next(r for r in test if r['id']==results['example_id'])
    yy=np.array([int(v) for r in test for v in r['labels'] if v!='-'])
    pp={k:np.array([p for r in test for p,v in zip(r['predictions'][k],r['labels']) if v!='-']) for k in names}
    def panel(ax,key):
        if key=='sequence':
            x=np.arange(1,example['length']+1)
            for k,c,label in zip(names,colors,labels):ax.plot(x,example['predictions'][k],color=c,lw=1.3,label=label)
            colors_label={'0':'#5c7899','1':'#c17150','-':'#d9d9d3'}
            rgba=np.array([matplotlib.colors.to_rgba(colors_label[v]) for v in example['labels']])[None,:,:]
            ax.imshow(rgba,extent=(.5,example['length']+.5,-.15,-.04),aspect='auto')
            ax.set(xlim=(.5,example['length']+.5),ylim=(-.17,1.04),xlabel='Residue position / 1-based',ylabel='Disorder score',
                   title='')
            ax.set_title('A  '+example['id']+': scores along one test protein',pad=52)
            ax.legend(frameon=False,fontsize=8,loc='lower left',bbox_to_anchor=(0,1.01),ncol=2)
            ax.text(.02,-.20,'Reference strip: blue = order; orange = disorder; gray = excluded',transform=ax.transAxes,fontsize=8)
        elif key=='ranking':
            for k,c,label in zip(names,colors,labels):
                precision,recall,_=precision_recall_curve(yy,pp[k])
                ap=results['test_metrics'][k]['average_precision']
                ax.plot(recall,precision,c=c,label=f'{label}: AP {ap:.3f}')
            ax.axhline(yy.mean(),c='#b7b8ab',ls='--',label=f'Positive fraction: {yy.mean():.3f}')
            ax.set(xlim=(0,1),ylim=(0,1.03),xlabel='Recall of annotated disorder',ylabel='Precision among selected residues',title='B  Ranking known labels on 49 test proteins')
            ax.legend(frameon=False,fontsize=8,loc='lower left')
        elif key=='protein_errors':
            for j,(k,c) in enumerate(zip(names,colors)):
                values=np.array(list(results['test_metrics'][k]['protein_losses'].values()))
                jitter=np.linspace(-.15,.15,len(values))
                ax.scatter(np.full(len(values),j)+jitter,values,s=13,c=c,alpha=.35)
                mean=results['test_metrics'][k]['protein_macro_BCE']
                low,high=results['bootstrap'][k]['protein_macro_BCE_95_percentile']
                ax.plot([j,j],[low,high],c='#253e35',lw=2.5)
                ax.scatter([j],[mean],c=c,s=85,edgecolors='white',zorder=4)
            ax.set_xticks(range(4),['Global\ncomposition','Local\ncomposition','Local CNN','Frozen ESM-2'])
            ax.set(ylabel='Mean binary cross-entropy per protein',title='C  Each dot is one held-out protein')
            ax.text(.02,.98,'Large dots: equal-protein means\nBars: 95% component-bootstrap intervals',va='top',transform=ax.transAxes,fontsize=9)
        elif key=='learning':
            for run,c in zip(results['cnn_runs'],colors[1:]):
                history=run['history'];xx=[h['epoch'] for h in history]
                ax.plot(xx,[h['validation_BCE'] for h in history],c=c,label=f'Validation, seed {run["seed"]}')
                ax.plot(xx,[h['online_train_BCE'] for h in history],c=c,ls=':',alpha=.6)
                ax.scatter([run['best_epoch']],[run['best_validation_BCE']],c=c,s=45,zorder=3)
            ax.set(xlabel='Training epoch',ylabel='Binary cross-entropy',title='D  Select checkpoints using validation proteins')
            ax.text(.02,.02,'Dotted: online training loss; dots: selected checkpoints',transform=ax.transAxes,fontsize=8)
            ax.legend(frameon=False,fontsize=8)
        elif key=='data':
            splits=['train','validation','test'];bottom=np.zeros(3)
            for lab,c,label in [('0','#5c7899','Order (0)'),('1','#c17150','Disorder (1)'),('-','#d9d9d3','Excluded (-)')]:
                count=np.array([results['data'][s]['label_counts'][lab] for s in splits])/1000
                ax.bar(range(3),count,bottom=bottom,color=c,label=label,width=.58)
                for j,v in enumerate(count):ax.text(j,bottom[j]+v/2,f'{v:.1f}k',ha='center',va='center',fontsize=10)
                bottom+=count
            ax.set_xticks(range(3),[f'{s.title()}\n{results["data"][s]["proteins"]} proteins' for s in splits])
            ax.set(ylabel='Number of residues / thousand',title='E  Three labels, with whole-component splitting')
            ax.legend(frameon=False,fontsize=9)
        else:
            ax.plot([0,1],[0,1],c='#b8b9ab',ls='--',label='Equal score and observed fraction')
            edges=np.linspace(0,1,11)
            for k,c,label in zip(names,colors,labels):
                xx=[];observed=[];counts=[]
                bins=np.clip(np.digitize(pp[k],edges)-1,0,9)
                for b in range(10):
                    use=bins==b
                    if use.sum()>=30:xx.append(pp[k][use].mean());observed.append(yy[use].mean());counts.append(use.sum())
                ax.plot(xx,observed,c=c,lw=1,label=label)
                ax.scatter(xx,observed,c=c,s=12+np.array(counts)/60,alpha=.6)
            ax.set(xlim=(0,1),ylim=(0,1),xlabel='Mean predicted score in a bin',ylabel='Observed annotated-disorder fraction',title='F  Does a score behave like a probability?')
            ax.legend(frameon=False,fontsize=8,loc='upper left')
        ax.grid(alpha=.14)
    keys=['sequence','ranking','protein_errors','learning','data','calibration']
    for key in keys:
        fig,ax=plt.subplots(figsize=(7.4,5.4),layout='constrained',facecolor='#fffdf8');panel(ax,key)
        fig.savefig(OUT/(key+'.svg'),metadata={'Date':None});plt.close(fig)
    fig,axes=plt.subplots(3,2,figsize=(16,18),layout='constrained',facecolor='#fffdf8')
    for ax,key in zip(axes.flat,keys):panel(ax,key)
    fig.savefig(OUT/'protein_learning.svg',metadata={'Date':None})
    fig.savefig(OUT/'protein_learning.png',dpi=160,metadata={'Software':'Matplotlib'});plt.close(fig)

if __name__=='__main__':main()
本次实际运行输出
Aligned index 0 / 254 elapsed 0.0
Aligned index 40 / 254 elapsed 10.4
Aligned index 80 / 254 elapsed 16.5
Aligned index 120 / 254 elapsed 22.6
Aligned index 160 / 254 elapsed 26.7
Aligned index 200 / 254 elapsed 29.2
Aligned index 240 / 254 elapsed 30.7
Frozen ESM-2 embeddings: 254 proteins, 320 features per residue
composition selected C 0.001 validation BCE 0.509
window21 selected C 0.01 validation BCE 0.44533
ESM2_frozen selected C 0.001 validation BCE 0.28239
CNN 9 best epoch 31 val BCE 0.42394 weight change 8.44
CNN 19 best epoch 24 val BCE 0.42333 weight change 8.875
CNN 29 best epoch 22 val BCE 0.42326 weight change 7.922
composition test AP 0.6542 F1 0.5888 residue BCE 0.5281 protein macro BCE 0.6394
window21 test AP 0.8531 F1 0.7603 residue BCE 0.3764 protein macro BCE 0.4442
ESM2_frozen test AP 0.9443 F1 0.8594 residue BCE 0.2229 protein macro BCE 0.2952
CNN21 test AP 0.8562 F1 0.7645 residue BCE 0.3754 protein macro BCE 0.4612
Example: DP03933 ; six panels, all sequences and scores saved.
先读A图的一条真实测试序列。最下方色带给出参考标注:蓝色是有序,橙色是无序,灰色是未纳入评价的位置。上方四条线表示四种方法的无序分数。全链组成模型是一条水平线,这是它输入不含位置信息的直接结果;局部组成与卷积模型开始随序列变化,预训练表示则给出了另一种由全序列上下文支持的判断。对照色带,可以把模型之间的差异定位到一段具体区域,再返回序列查看。
一个分数并不自动意味着一个二元判断。假设要挑出最值得检查的无序候选位置,可以先按分数从高到低排序;挑得少时,希望挑中的位置大多确实有无序标注,挑得多时,又希望覆盖更多已经标注的无序位置。前者对应精确率,后者对应召回率。它们分别使用不同分母,因此要放在一起阅读,避免一个模型靠极少量预测得到很高的精确率,却漏掉多数目标位置。
TP表示选中的真实无序位置数,FP表示误选的有序位置数,FN表示没有选中的真实无序位置数。例如,挑出十个位置,其中八个有无序标注,则精确率为8/10=0.8;如果全部已标注无序位置有二十个,召回率就是8/20=0.4。降低阈值后,更多位置被纳入,两者通常会随之改变。B图用整条精确率—召回率曲线呈现这个过程,全部计算都跳过了灰色位置。
AP称为平均精确率。按阈值从高到低逐步纳入预测时,Rk表示当前召回率,Pk表示相应精确率,新增的召回量Rk−Rk−1作为权重,最后将各步加起来。它概括的是排序质量,数值越大越好。本次49条测试蛋白质中,全链组成、局部组成、卷积网络和固定ESM-2表示的AP分别为0.654、0.853、0.856和0.944。这些数值来自本节选定子集,便于比较这四种实际运行的方法。
代码还输出了固定阈值下的F1,它等于精确率与召回率乘积的两倍,再除以两者之和。当精确率为0.8、召回率为0.4时,F1约为0.533;只有两项都比较高,F1才会较高。本例在验证集上从0.05至0.95的候选阈值中选择F1最大的一项,再固定该阈值评价测试集。于是,测试集中的F1对应一个已经选好的使用规则,而AP则概括了不同阈值下的排序表现。
一次运行 · 六幅结果图
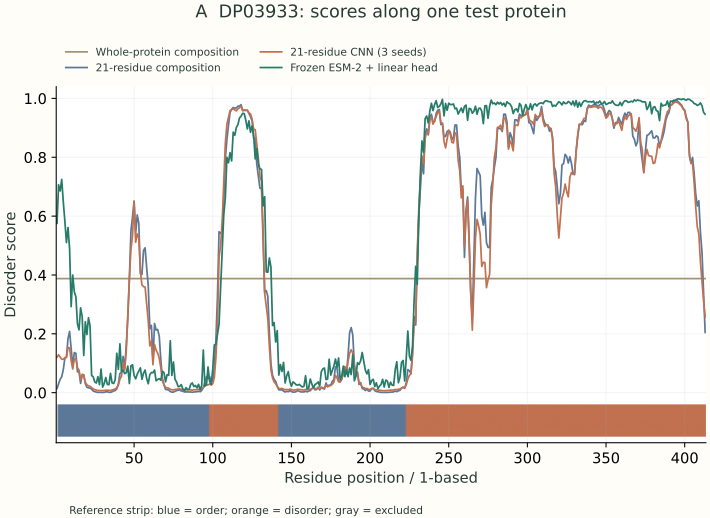
A|沿真实测试蛋白质DP03933比较四种分数。底部色带保留有序、无序与未纳入评价三类状态。
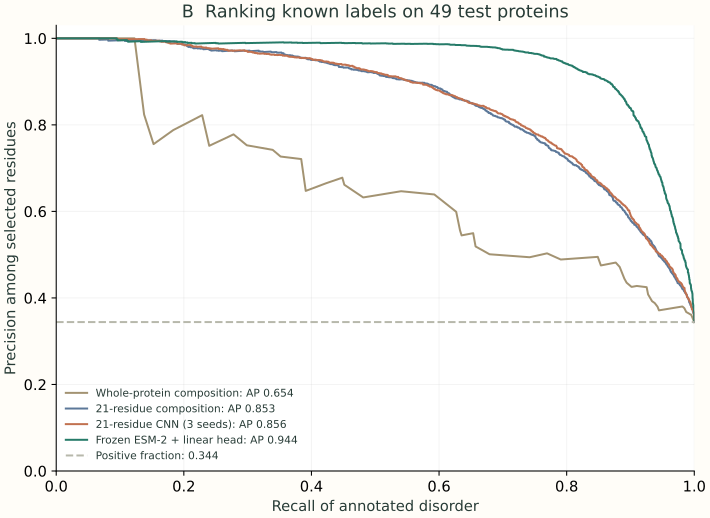
B|逐步降低阈值,观察找到的无序位置与误选位置如何改变精确率和召回率。
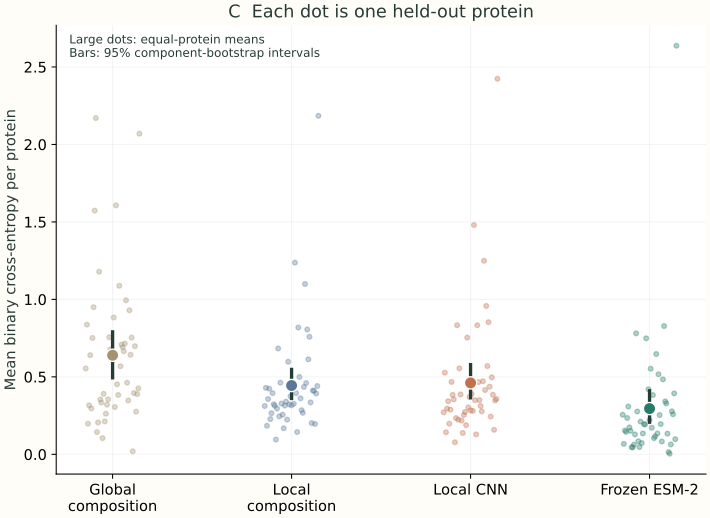
C|小点对应49条测试蛋白质的各自误差,大点为等权平均;区间按完整相似性组重新抽样。
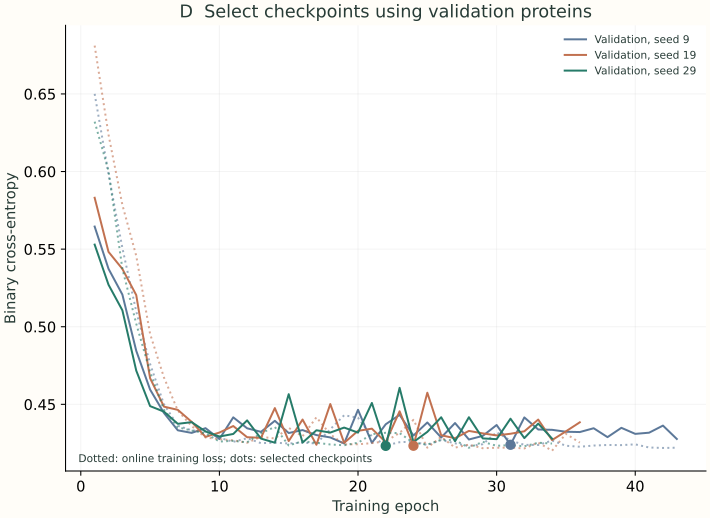
D|三个随机种子的卷积网络均真实训练;验证曲线决定保存哪一轮,测试数据不参与选择。
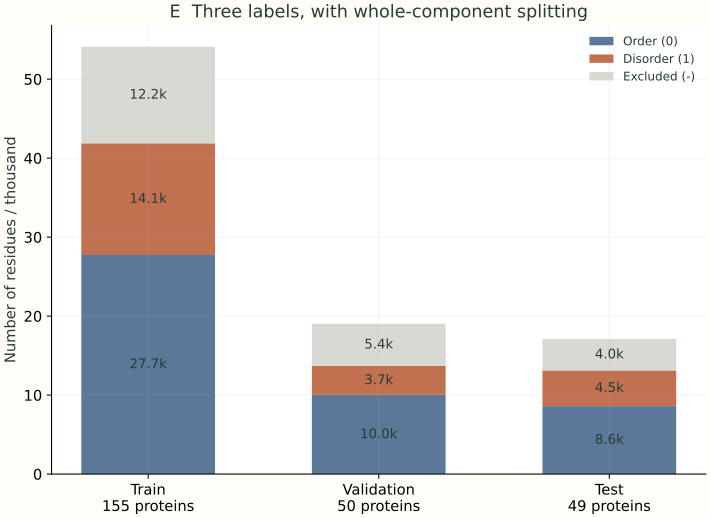
E|三组数据都保留未知位置;灰色位置可参与序列上下文,但不进入监督损失和指标。
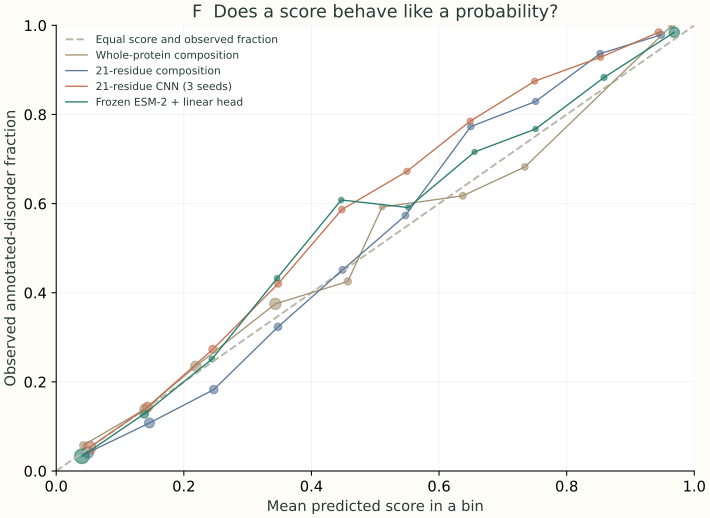
F|对照分数与实际标注比例,查看概率解释是否合适。圆点面积随该分数组的样本数增加。
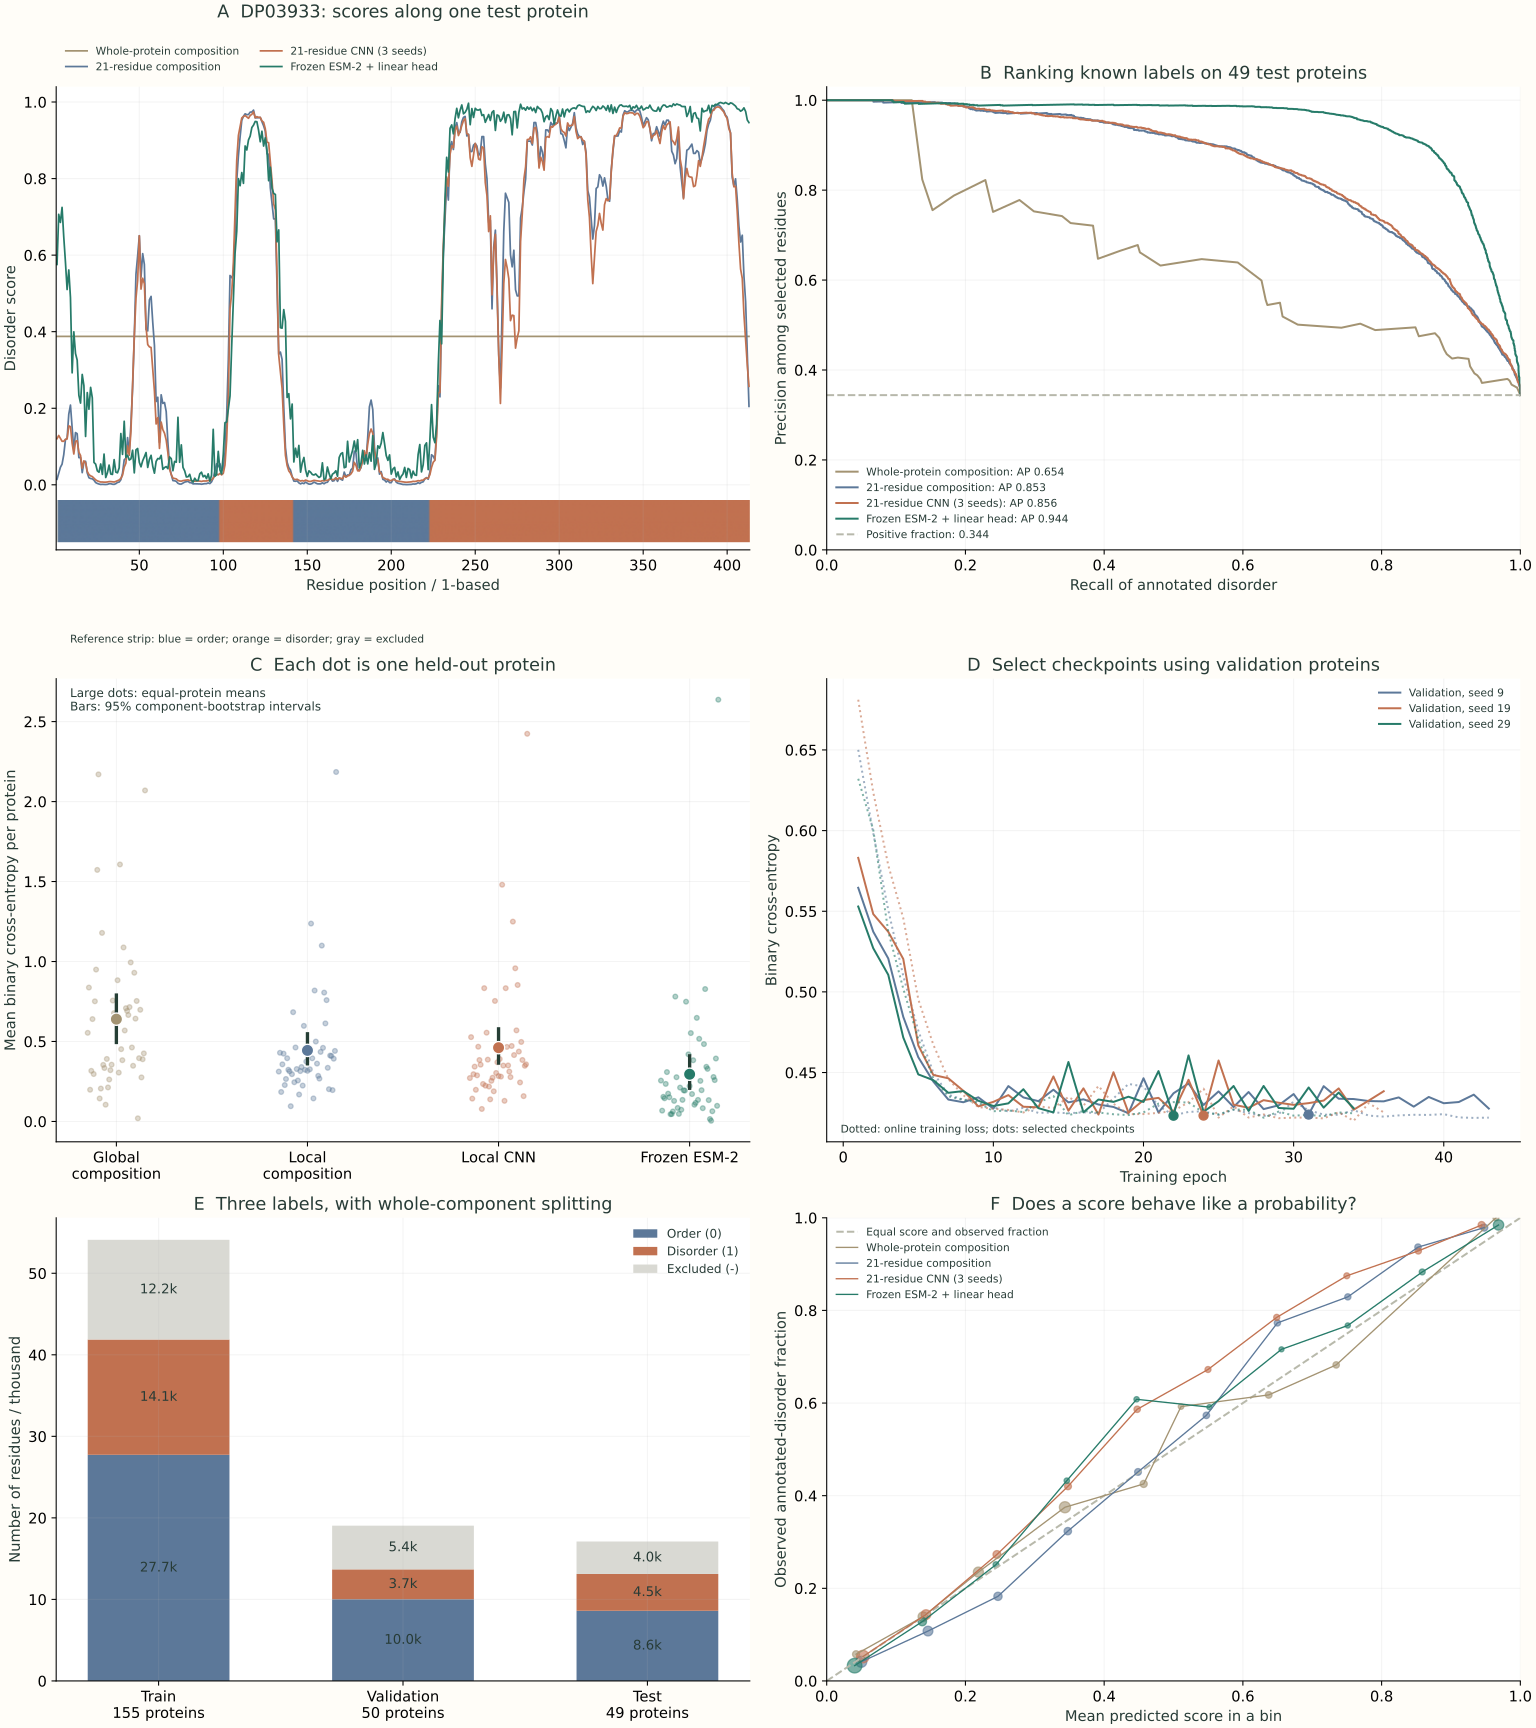
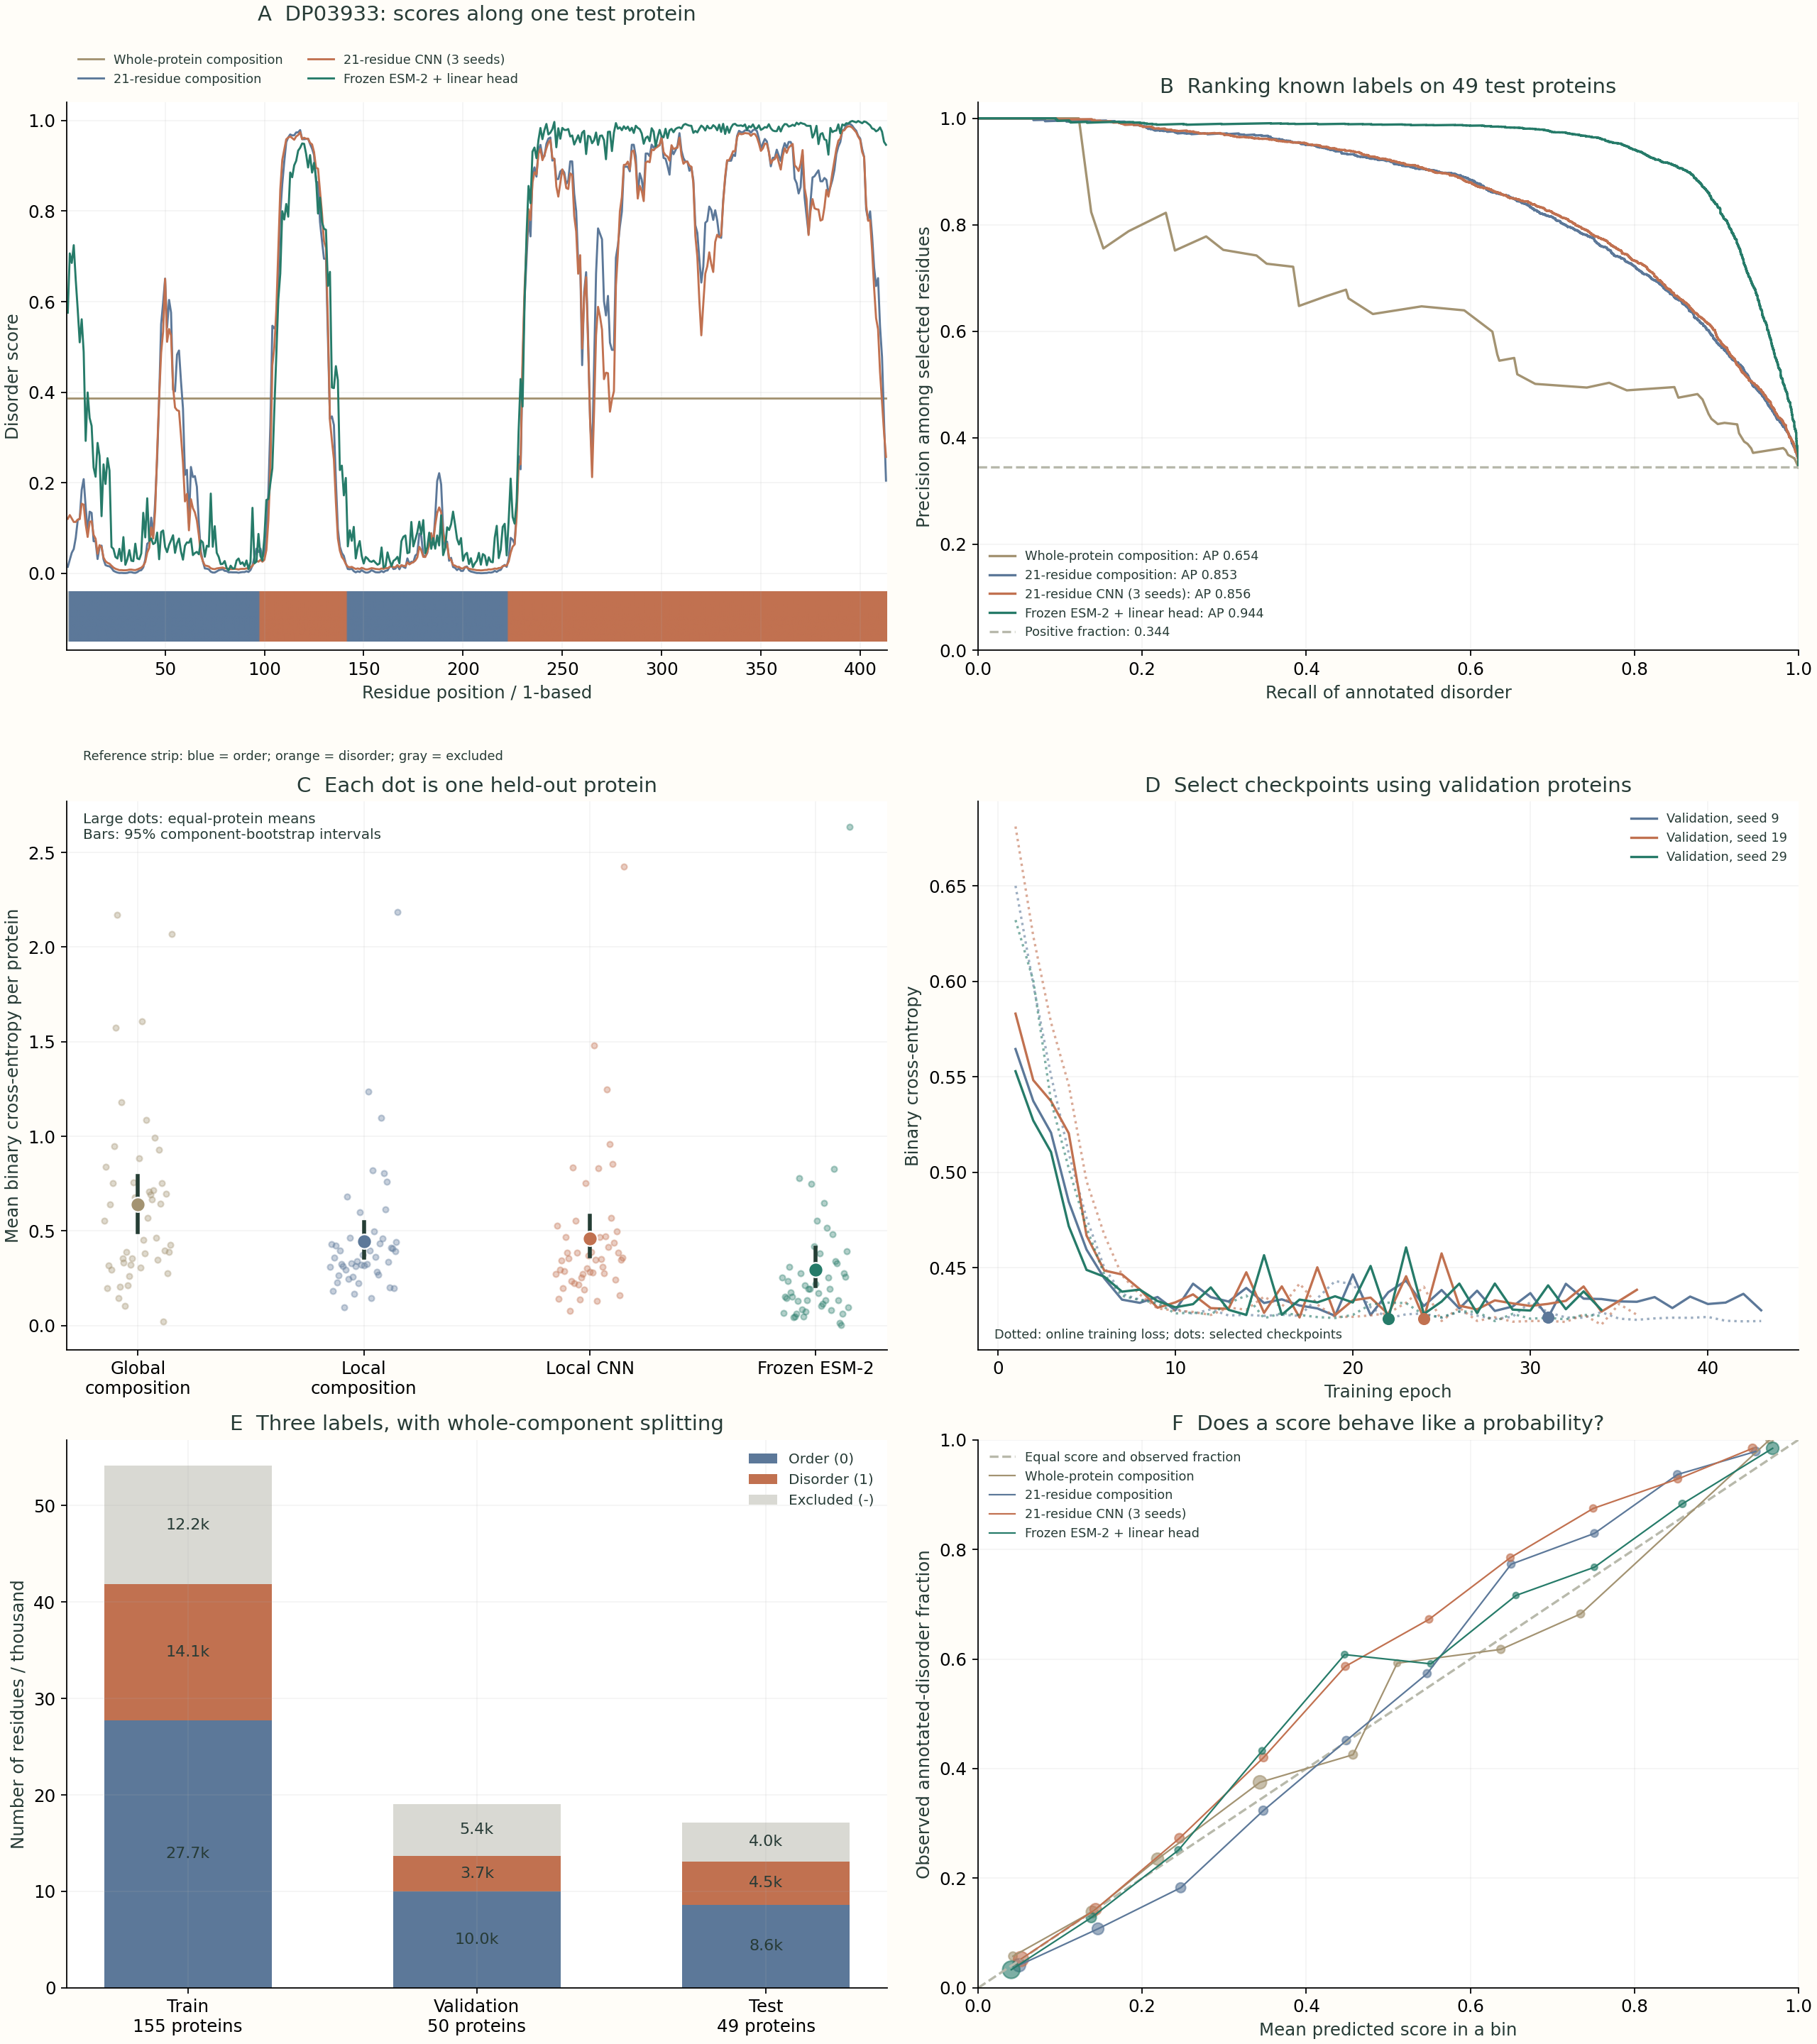
最明显的变化出现在两个地方:把全链计数改成沿序列移动的局部计数,模型就获得了定位不同区域的能力;加入固定的预训练表示后,排序进一步改善。卷积网络与局部组成模型在这次实验中的AP很接近,分别约为0.856与0.853。这个结果值得保留下来,因为它说明,保留更多顺序细节能提供新的建模能力,但最终收益还与样本数量、任务和训练设置有关。一个经过认真设计的简单基线,能帮助我们判断这些新能力在当前问题中发挥了多大作用。
AP把全部已标注测试残基汇在一起,长蛋白质或者标注更多的蛋白质会贡献更多位置。研究中还常关心另一个问题:把每一条蛋白质视为一个研究对象时,模型表现是否均衡?C图先分别计算49条蛋白质的平均交叉熵,再给每条蛋白质相同权重。q是蛋白质编号,Q是蛋白质条数,Aq是第q条蛋白质中有标签的位置集合。这样,“先平均残基”与“先平均每条蛋白质”就有了清楚的计算区别。
例如,一条蛋白质有一百个已标注位置、平均误差为0.2,另一条有一千个、平均误差为0.8。按全部残基平均得到约0.745,按蛋白质等权平均则得到0.5。两种数值都可以计算,它们回答的研究问题不同。本次局部组成与卷积网络的蛋白质等权平均误差分别约为0.444和0.461,与AP上的细小差别共同说明,比较模型需要读清楚评价对象和权重。固定ESM-2表示对应约0.295,C图同时显示了各条蛋白质之间的差异。
C图中的区间通过重新抽取完整的序列相似性组计算,每次保留被抽中组内的全部蛋白质,再重算等权平均,重复一千次。这样,原本相关的序列不会在误差估计时被拆成许多独立小样本。区间展示当前测试样本组成变化时指标的波动;大点是实际49条蛋白质的平均值,小点则让我们看见汇总数字后面有哪些较容易或较困难的对象。对某个高误差样本追踪标签范围和序列特点,通常比只盯着整体平均更能提出下一步问题。
D图展示卷积网络的真实训练过程。虚线记录训练批次中的平均误差,实线记录每轮结束后在验证蛋白质上的误差,圆点标出保存的轮次。三个种子分别在第31、24和22轮取得各自最低的验证误差,程序在之后连续十二轮没有改善时停止该次训练。最终平均三个保存模型的分数。训练误差继续减小而验证误差不再下降时,说明继续贴合已有训练样本,并没有同时改善这组独立验证对象上的表现。
E图把三种标签在训练、验证和测试集中的数量直接画出来。测试集中共有13122个参与评价的位置,其中4516个为无序,比例约34.4%。B图中的水平虚线标出这个正例比例,帮助读者认识任务的标签构成。若只报告总体正确率,一个总猜“有序”的模型也会因有序位置较多而得到看似不错的数字;精确率—召回率曲线则直接关注我们正在寻找的无序位置。数据图与指标图要一起读,才能知道一个分数是在怎样的样本分布中产生的。
F图进一步检查分数的含义:将预测分数按区间分组,横轴是该组的平均预测值,纵轴是其中实际标注为无序的比例。若平均分数约为0.8的一组位置中,大约80%具有无序标注,这一组就靠近对角线。图中圆点面积随样本数增加,少于三十个已标注位置的组不显示。它让我们看到排序与概率校准是两个问题:能把候选排在前面,还需要额外检查分数能否在目标数据中按概率解释。
将这个流程用于自己的研究,可以从一个清楚的决定开始:希望模型帮助选择哪一段序列、支持哪一个实验动作,以及用什么测量判断它是否有用。例如,为后续表达与结构实验选择截取边界时,可以把本节的无序分数、已有结构域信息和具体实验条件一起查看,列出候选边界,再用表达量、溶解性或结构测量反馈选择结果。预测为这个流程提供了可比较的信息,实验反馈则把序列分数接回真正关心的功能与材料行为。
可以再做一个小练习:保留当前划分和训练设置,观察一条全链组成相近、局部排列不同的测试序列。先用局部计数解释两处窗口为何不同,再检查卷积与ESM-2的输出是否也在这些区域分开。若要修改窗口宽度,应重新用验证集作选择,并把新的最终模型放到另外留出的评价对象上。这样的练习将化学直觉、数据约定与学习结果放在同一条推理链中,也为《糖链:连接方式怎样改变水合、识别与支撑》研究连接方式更复杂的糖链做好准备。
资料与延伸阅读
Ramachandran、Ramakrishnan与Sasisekharan,1963,Stereochemistry of polypeptide chain configurations:从局部几何与空间接近限制研究多肽链构象。Anfinsen,1973,Principles that Govern the Folding of Protein Chains:序列、环境与折叠的实验和热力学关系。Kriwacki等,1996,p21游离态与Cdk2结合态的结构研究:无序、结合与功能的具体实验例子。
Lin等,2023,Evolutionary-scale prediction of atomic-level protein structure with a language model;本例使用其模型系列中的ESM-2六层模型,权重采用MIT许可。数据取自CAID固定版本仓库的demo-data/references/disorder_pdb.fasta,按仓库CC BY 3.0许可注明来源;参考集设计背景见Necci等2021年的CAID原始研究。本页四幅科学史图为解释研究问题而绘制的概念图,六幅数值图由页面中的Python程序实际生成。