从一根纤维到细胞表面的识别信号
糖链:连接方式怎样改变水合、识别与支撑
米饭里的淀粉和棉布里的纤维素,都以葡萄糖为基本构件,却在生活中承担着很不一样的工作。前者是常见的食物成分,后者形成可以纺成线的纤维。再看人体,细胞表面伸出的糖链参与识别,组织中的一些多糖则与水、离子和蛋白质共同影响材料的柔软程度。要理解这些差别,我们需要看清糖残基之间的连接,把化学结构、周围环境与实际测量接起来。
本节让AI学习一项具体的实验读数:给出糖链结构,预测它在使用指定凝集素的糖链阵列实验中的荧光信号。凝集素是能够识别糖结构的蛋白质;阵列把许多糖链放在可区分的位置,通过信号强弱比较它们与凝集素的结合表现。我们先给模型一张组成清单,记录各类糖有几个,再补上各残基之间怎样连接。两种输入用同一批数据检验,就能观察连接信息是否改善预测,也能回到分子图上寻找差别。后面的代码将完成数据读取、结构表示、训练和画图,让这场比较可以逐步重现。
01相同的糖,可以接成不同的长链
日常说的“糖”常让人想到甜味,但化学中的糖类还包括许多不甜的长链。一个葡萄糖分子可以在溶液中形成环状结构,环上不同位置带有羟基等基团。把这样的单元连接起来以后,已经进入链中的部分称为糖残基。“残基”强调它属于连接后的分子结构,类似蛋白质里的氨基酸残基;它仍保留可辨认的化学身份,同时又与相邻单元共享一条连续的连接关系。
读糖链的连接,可以先把每个单糖想成带有编号接口的积木。普通的线性字母串只告诉我们哪个字母挨着哪个字母,糖链还要写清楚使用了哪个接口,以及接口处的空间构型。这个类比特别适合解释为什么糖链常出现分支:同一个残基的不同位置可以分别接上其他残基。真实的接口是参与成键的原子位置,连接以后还存在转动与空间接近限制,不能只根据纸面上的折线判断三维形状。
以Glc(α1→4)Glc为例,Glc表示葡萄糖残基。左侧残基的异头碳C1,通过糖苷连接接到右侧残基C4位置的氧;“1→4”把两端使用的位置写出来,α描述左侧异头中心的构型。将α改成β,即使单糖种类和连接碳位都相同,也已经换成另一种结构。计算机输入中常用a1-4和b1-4表示这两类标签,后面的代码会完整保留它们。
α和β需要相对于规定的参考构型来理解。对于通常绘制的D-葡萄吡喃糖Haworth图,异头取代基与参照的CH₂OH基团处在环平面两侧时对应α,同侧时对应β。转动整张图不会改变分子的身份,因此不能把屏幕上“朝下”或“朝上”当成所有糖都通用的定义。初学时可以先记住:这两个字母记录的是一个具体立体化学差别,模型若把它们删掉,就会把某些不同分子写成同一种输入。
直链淀粉主要含α1→4连接,支链淀粉还具有α1→6分支;纤维素的主链则由β1→4连接的葡萄糖残基组成。连接方式改变相邻糖环之间常见的相对姿势,进一步影响长链如何排列、与水接触以及被酶识别。人体消化淀粉所用的酶具有相应的底物选择性,不能把它们看成遇到任何葡萄糖长链都能沿途剪开的剪刀。局部连接与酶的空间匹配,已经在这里影响了材料进入生物系统后的命运。
纤维素的承载能力还来自多条链形成的有序排列以及更高层次的纤维组织。1928年,Meyer和Mark发表了关于纤维素结晶部分结构的研究;此后,衍射方法不断把链的排列变成可以检验的结构问题。2002年,Nishiyama、Langan和Chanzy结合X射线与中子衍射,解析了纤维素Iβ的分子排列和氢键体系。X射线帮助定位碳、氧等原子,中子信息则帮助研究氢的位置,两类证据共同约束结构。
从这段科学史可以看到,认识材料要跨过几个层次:先确认残基怎样连接,再研究链采取哪些构象,接着考察许多链怎样排列。纤维素含有大量能够与水相互作用的羟基,普通水中却不会因此轻易分散成单条分子。让链离开原有排列,需要改变链间接触和周围水的状态。用“亲水”一个词描述它,只回答了部分相互作用问题;解释溶解与承载,还需要把链的集合结构放进来。
现在把视角缩回一条糖链。若用一个节点代表一个糖残基、用一条边代表两个残基之间的糖苷连接,许多明确的支化糖链可以画成一棵树。这里的树可以直,也可以有分叉,条件是所有节点连通且残基之间不形成闭环。每个单糖自己可以是环状分子,这与残基图是否有环是两个层次;我们画节点时,已经把单糖内部的原子结构收进了节点标签。
V表示节点集合,E表示边集合,竖线表示集合中的元素数,N就是残基数。为什么边数是N−1?从一个残基开始,每接入一个新的残基,要加一条边才能把它连到已有结构;若额外再加边,就会出现环。因此三个残基的树有两条连接,十个残基的树有九条连接。这个关系能检查数据是否完整,但它不能区分一条直链和一条支链:两者可能有相同节点数、边数,甚至相同的残基组成。
这给AI输入提出了一个很具体的要求。单糖计数告诉模型材料用了哪些构件,连接表告诉它这些构件如何组织,α/β及碳位标签则保留局部化学差别。三类信息可以逐步增加,形成容易解释的比较实验。我们不必一开始就使用复杂网络,也能检查每增加一类信息后,原本混在一起的结构能否分开;后续再把这种表示用于真实测量,判断它是否帮助预测。
02糖链与水的关系,为什么会影响支撑和柔软
把多糖放入水中,水并非只是在长链旁边填满空隙。水分子会在羟基、羧基以及其他极性基团附近形成不断变化的相互作用,离子也会参与其中。与此同时,链与链原有的接触需要重新调整。一个材料是溶解、溶胀,还是保持纤维形态,取决于这些变化共同带来的自由能差,以及分子重新组织需要多长时间。前几节讨论的溶剂与动力学,在糖链中都能找到具体的化学对象。
可以把溶解与溶胀分别想成一束线逐根散入水中,以及一张线网吸水后鼓起来。前一种情况下,分子链能够离开原有集合并在溶液中分布;后一种情况下,仍有足够的连接或稳定接触维持整体,水进入以后增加体积。这个区分对生物材料很实用:想做一种均匀溶液,和想做一种吸水后仍能拿起来的材料,需要安排不同的分子联系。第十三节会进一步计算网络怎样限制体积变化。
甲壳素提供了另一个熟悉的例子。它存在于甲壳动物的外骨骼等结构中,主链由β1→4连接的N-乙酰氨基葡萄糖残基组成,常写作GlcNAc。与葡萄糖相比,这个残基在C2位置带有不同的含氮侧基。外壳的实际性能还涉及蛋白质、矿物以及层级排列,因此观察一块虾壳时,需要把“某种高分子在其中”与“整个复合结构怎样承载”联系起来,才能合理选择材料模型。
当部分GlcNAc残基脱去乙酰基,得到GlcN残基,链上可以质子化的氨基比例随之改变。通常称为壳聚糖的材料便与这种脱乙酰过程有关。酸性环境中,部分氨基带上正电,会改变链与水及离子的相互作用;与此同时,侧基变化也会影响原有排列。我们需要记录改了多少残基,而不能只在数据表里填一个“壳聚糖”名称,因为不同样品的组成、链长和处理历史都可能不同。
D是脱乙酰度,NGlcN与NGlcNAc分别表示两类残基的数量。二者相加得到这个二元组成模型中的总数,用已脱乙酰残基数除以总数,就得到0到1之间的比例。例如一百个残基中有七十个GlcN,D=70/(70+30)=0.70,也可以写成70%。这里按残基数或物质的量计算,不能直接把两类残基的质量比例代入,因为它们的摩尔质量不同。
这个比例仍没有交代这些残基如何沿链排列。七十个GlcN可以较均匀地分散,也可以聚集成较长片段,它们形成局部接触的方式可能不同。2000年,Cho等人研究部分脱乙酰甲壳素的酸中与水中溶解行为,把组成变化与结晶结构、氢键和溶解性联系起来。这段研究提醒我们,给模型增加一个“脱乙酰度”数字很有用,但若要跨制备方法比较,还应保留能够解释排列差别的测量。
透明质酸则让我们看到带负电的糖链如何进入生物组织。它的链由葡萄糖醛酸和N-乙酰氨基葡萄糖交替构成,羧基在许多生理条件下带负电。链周围的水、可移动离子和其他分子共同影响溶液的流动与压缩响应。硫酸软骨素还带有硫酸基,不同位置的硫酸化既改变电荷分布,也改变可被蛋白质接触的局部结构。因此,数据中的“硫酸化”最好细化到发生在哪个残基、哪个位置。
带电糖链吸引反离子,盐又会改变静电作用的范围;这与第四节讨论的屏蔽相接。若把一份多糖样品在低盐和高盐环境中测量,链的构象与分子间作用都可能变化,得到的黏度或膨胀状态也可能不同。AI若只看到多糖名称而没有盐浓度,就可能把环境造成的差别归到化学结构上。对于水合与支撑任务,结构字段之外还应记录浓度、温度、pH、盐种类及测量时间尺度。
这里还需要区别“水合”与“组织能承受压力”。前者描述水与分子周围环境的关系,后者涉及水在受力过程中能否流走、网络怎样约束变形,以及其他组分怎样分担载荷。就像湿海绵受压时,水流出的快慢会影响手指感觉到的阻力,组织中的水与固体网络也要一起考虑。这个生活类比帮助我们安排问题:短时间的压缩、长时间的平衡和持续剪切,应当分别定义实验输入与输出。
因此,多糖研究可以形成两条彼此衔接的AI路线。一条面向材料行为,用链组成、修饰、浓度与制备条件预测吸水量或力学响应;另一条面向分子识别,用明确的糖残基连接预测与某种蛋白质的结合读数。本节选择后一条,因为可以在一个清楚的数据集里直接比较连接信息的作用。前一条路线中的水合、网络和加工因素,会在后面的凝胶与制备章节中继续进入模型。
03细胞表面的识别,怎样变成一张数据表
许多细胞表面的糖链连接在蛋白质或脂质上,向周围环境伸出不同的化学结构。识别它们的蛋白质中,有一类称为凝集素。结合时,蛋白质表面的空间形状、氢键位置和其他相互作用,会对糖残基的身份、连接与展示方式作出选择。可以把这种接触想成手指摸到一组凸起:凸起数量相同,位置和朝向换了,接触感受也会改变。分子层面的选择还受到水与热运动影响,需要用实验判断。
研究者若逐个测量数百种糖链,会需要大量重复操作。糖链阵列将许多探针安排在一块表面的不同位置,使同一种蛋白质能够在一组受控条件下与它们接触,再通过检测系统读取信号。2004年,Blixt等人展示了包含二百种糖序列的共价印制糖链阵列,用来研究多类糖结合蛋白的识别特征。阵列方法把“认识哪一种糖链”转成了可并行比较的数据问题。
一张阵列图中较亮的点,意味着在该检测流程下得到了较强信号。要解释亮度,还需要知道用了什么蛋白、蛋白浓度、糖链怎样固定、如何洗涤以及如何检测。同一糖链换一种连接到表面的方式,可能改变暴露程度;同一蛋白换一个浓度,也可能改变信号。因此我们把预测目标定义成具体实验条件下的阵列读数,使输入、标签与用途相互对应。若要研究溶液中的解离常数,则需要相应的浓度依赖测量与结合模型。
本例采用Lundstrøm等人2024年公开的CMA1研究数据。CMA1是一种来自甜瓜的凝集素,研究者对重组蛋白进行了糖链结合实验。我们读取补充工作簿中的imperial表,共866条探针记录;相应方法记载蛋白浓度为100 µg/mL、孵育一小时,并使用脂质连接的糖探针阵列。这个选择固定了受体和主要实验平台,后面的学习都围绕这一张表展开。
RFU表示相对荧光单位,它依赖仪器和检测设置。公开表格为每个探针提供一个汇总读数,程序按原样读取这些数值。表中还有其他阵列及另一种凝集素的数据,但我们把它们保留为不同的实验对象。同样写着RFU,若检测设置或蛋白身份改变,数字的直接可比性也会改变;把这些记录用于联合学习时,需要进一步建立批次和受体字段,并明确跨实验的评价任务。
原表中存在大量零读数。它们记录的是这套检测与处理流程给出的零值,适合直接作为本任务的监督目标;解释时应当同时保留实验条件。模型可以学习哪些结构更可能在这个阵列中获得较高信号。随后若要研究某个零读数候选的结合机制,可以改变浓度、检测方式或展示密度,安排新的测量。这样,数据表中的一个数字就对应到下一步可以实施的实验,而不会被误读成脱离条件的分子属性。
结构整理也需要明确规则。程序只接收能够完整解析为糖残基树、残基名称属于已支持集合、连接位置与α/β明确的记录,并检查括号和连接是否完整。866条记录中有649条满足这些解析条件,包含503种规范化后的树。其余217条保留排除原因,供以后扩展表示时重新处理;其中有概括性残基名称、当前语法未支持的修饰和不完整连接。解析规则限定的是这个程序能够怎样读取结构。
接着检查同一棵糖残基树出现了几次。有些结构以不同探针形式多次出现,直接平均会把展示方式的差别藏起来。为了让本例的输入与标签容易逐条核对,我们保留在649条可解析记录中只出现一次的结构,得到403条学习记录;选择过程使用结构与出现次数,没有按荧光强弱挑样本。探针名称中明确的AO标记另存为一个输入字段,表示已知的一种固定方式,其他记录合为“未标记AO”类别。
下面的交互图把连接差别放到两个具体探针上。H-Tri-T2-AO和Lex-Tri-AO都含一个岩藻糖Fuc、一个半乳糖Gal和一个GlcNAc,也都带AO标记。前者的Fuc接到Gal的2号位置,后者的Fuc接到GlcNAc的3号位置,并形成不同的分支关系。它们在原表中的读数分别为4091和0 RFU。Lex这棵树在原表有多个展示记录,因此这对探针用于解释结构与测量,完整模型评价仍使用前面定义的403条队列。
同样的三种糖,连接到哪里会改变
H-Tri-T2-AO:4091 RFU;Fuc通过α1→2接到Gal,Gal通过β1→4接到GlcNAc。
第0层只记录每种糖残基出现几次。
图中切换结构时,可以沿着连接看岩藻糖究竟接到了哪里。按“重排编号”只会改变节点的显示号码,残基身份与连接保持不变;正确的结构表示应当给出相同描述。按“逐层读取”则会依次显示只认识自身、读取直接邻居以及读取更远邻域的过程。这个过程将把我们带到图学习:先明确一个节点从邻居获得什么信息,再讨论模型怎样使用这些信息,而不是先记住一个网络名称。
在训练之前还要安排数据划分。我们按各类残基及显式修饰的数量组成分组,让组成相同的连接异构体始终留在同一组。403条记录形成265个组成组,固定随机种子后按组划分,得到258条训练、81条验证和64条测试记录。这种设置询问模型能否利用已学习的局部结构去处理新的组成组;不同组仍可能共享常见糖残基或短片段,这正是局部表示能够迁移信息的来源。
最后将目标转换为适合回归的数值。原始RFU的大小跨度较大,少数高信号会在平方误差里占很大比重。使用自然对数能压缩较大的数值,同时保持大小顺序;在比值前加1,则让零读数可以直接进入计算。I表示原始读数,I₀是固定的1 RFU参考量,先相除得到无量纲数,再取对数。这里的参考量定义了变换尺度,在训练、验证和测试中保持一致。
例如,I为0、99和999 RFU时,y分别为0、ln 100≈4.605和ln 1000≈6.908。原来相差900 RFU的后两个数,变换后相差约2.303;高信号对平方误差的影响因此被压缩了。模型此时学习的是对数变换后的信号,评价指标也先在这个尺度上计算。要读回RFU,用I₀(exp y−1)还原,坐标和单位才与原始实验一致。还要区分“先平均再还原”和“先还原再平均”:指数函数是一条弯曲的曲线,这两种运算一般给出不同结果。因此,本例的还原值应读作模型在变换尺度上预测的位置所对应的RFU值。
04让模型沿着连接认识一条糖链
最简单的结构表示是组成向量。例如Fuc、Gal、GlcNAc各一个,可以写成相应三个计数都为1。这样做计算方便,也能保留残基种类与修饰信息,却会给前面的两条三糖相同输入。给它增加一张连接表,就能区分谁与谁相连;再把α/β、供体和受体碳位写到边上,模型才有机会分开连接图相同、局部成键类型不同的糖链。比较这些层次,能够直接检查信息是在什么地方丢失的。
本例使用三个可学习的模型:组成计数模型、忽略键类型的邻域图模型,以及保留键类型的邻域图模型。三者都使用相同的训练、验证和测试记录,加入相同的AO展示标记,并采用相同的回归方法。另设一个只输出训练目标平均值的基线。这个基线的用途很清楚:在尚未利用任何结构差别时,当前训练数据能给出怎样的固定预测;其他方法需要在具体指标上说明结构信息带来了什么改变。
图模型怎样读取结构,可以从给每个节点做一张卡片开始。第一轮卡片只写残基类型,例如Gal。下一轮把“我是谁”与“我的每个邻居是谁、通过什么连接相邻”写在一起。再下一轮,邻居递来的卡片已经包含它们自己的周围信息,于是一个节点间接认识了两步之内的结构。每轮都同时读取上一轮的卡片,避免节点更新先后影响结果;最后统计各种卡片在整条糖链中出现了多少次。
2011年,Shervashidze等人在Weisfeiler–Lehman图核研究中,系统使用逐轮更新节点标签的方法建立图之间的比较。这使局部连接可以转换成一组可计算的模式计数,再交给学习方法。本节据此构造教学实现,并为糖链加入朝向和键类型。模式本身由明确规则生成,回归系数从实验数据学习;这也为第十八节进一步学习可训练的消息传递网络建立直观基础。
公式里v表示当前节点,u表示它的一个邻居,N(v)是全部邻居组成的集合,上标t表示已经更新了几轮。c是节点的当前标签,evu记录邻接方向与连接类型。这里的方向是朝向还原端根节点,还是朝向末端分支,并非图在屏幕上朝左或朝右。Sort把邻居项目排列成确定顺序,得到邻居列表M;Encode把完整内容保存成一个标签,两个内容相同的标签会被认作同一模式。
为什么需要排序?同一分支结构可以先写左边再写上边,也可以先写上边再写左边。画法或读取顺序改变,不应该产生一个新的化学分子。把邻居项目按固定规则排序以后,这些不同书写顺序就会得到同一张卡片。若有两个相同类型的邻居,它们仍保留两份,不能因内容相同而删去一个。对于糖链来说,“有一个这种分支”与“有两个这种分支”本来就是不同结构信息。
以Gal(β1→4)GlcNAc为例,初始时模型记录一个Gal和一个GlcNAc。读取一轮后,Gal的卡片会包含“通过β1→4连接朝向GlcNAc”,GlcNAc的卡片则包含相反的根端方向关系。如果将β改为α,带键类型的卡片随之变化;忽略键类型的模型仍看到原来那两个相邻残基。这样,一个很小的二糖就足以检验表示是否保留了我们希望研究的化学区别。
统计零轮、一轮和两轮卡片后,得到一条向量h,每个分量表示一种局部模式出现了几次。直接比较计数时,长链常因包含更多节点而获得较大的内积,所以本例先用向量长度归一化。分母是全部分量平方和的平方根,它与几何中计算一根向量长度的方法相同。归一化以后,比较更偏向模式组成的相近程度;链长信息的作用也随之改变,因此这一步属于需要说明的表示选择。
G和H表示两条糖残基图,h上面的帽子表示已经归一化。内积逐项相乘再相加:两条图共享的模式会贡献相似性,各自独有的模式在交叉项中贡献0。例如两条计数向量分别为(1,1,0)和(1,0,1),各自长度都是√2,归一化内积便是1/2。若完全相同则为1。所有模式计数非负,因此这个结构相似性在0到1之间,数值越大表示在当前描述规则下共享的模式越多。
公式的第二项保留AO标记。z是二元独热向量:明确标为AO时写成(0,1),其他记录写成(1,0),同类标记的内积为1,异类为0。我们预先把这组特征的幅度设为0.25,因此它对核相似性的贡献为0.25²=0.0625。这是所有可学习模型共有的实验展示字段,并非从测试结果调出来的补偿。它只记录已有标记,其他展示差别还需要在更完整的数据中继续补充。
计算词表时还有一个容易忽略的细节。训练集中没有出现的新模式,与训练模式的内积为0,但它仍属于新糖链的结构,必须进入新向量的长度。例如原向量有三个分量,若只因为其中两个未在训练中见过,就把分母也改成仅含一个分量,会把剩下的共同部分人为放大。程序用训练结构建立可计算的列,同时用每条糖链的全部模式计算归一化分母,使这两个步骤保持各自的含义。
有了相似性,还需要用读数学习预测规则。T表示训练记录的索引集合,KTT是训练糖链彼此之间的核矩阵,α是要从数据求得的一组系数。先从每条训练目标中减去训练均值,再求解下面的线性方程。λ是正则化强度,I是单位矩阵;给对角线加上正数,有助于抑制在相似训练对象之间出现过大的补偿系数。新糖链的预测由训练均值加上这些相似性加权项得到。
这组方程来自带惩罚的最小二乘拟合。把归一化模式和展示标记合成普通特征后,可以用一组权重做线性预测;训练时,让全部预测误差的平方和,加上λ倍权重平方和,尽可能小。后一项使模型在贴合读数之外,也倾向于使用较平缓的权重。对这个二次函数求最低点,可以得到线性方程;用特征内积构成的K改写,就得到下面的核形式。粗体1表示每个分量都为1的向量,用于从每条目标中减去同一个训练均值。这里的特征、目标和核值均无量纲。
可以先看两个训练对象的简化算例。假设它们的目标为2和6,均值为4;两者自身的核值均为1,彼此为0,λ取1。减去均值后目标为−2和2,两个方程分别为2α₁=−2和2α₂=2,得到系数−1和1。新对象若与两者的相似性为0.3和0.1,预测就是4−0.3+0.1=3.8。完整代码同时求解258个相互关联的系数;系数可以为正也可以为负,因此预测并非把最近邻标签简单取平均。
深度和λ由验证集选择。组成模型固定使用零轮计数,两个图模型比较一轮与两轮邻域;每种表示分别试六个λ,并选择验证组等权误差最小的组合。代码最后一次性计算选定模型的测试指标。若两个λ在验证集接近,可以通过新的分组重复划分研究选择稳定性;本例先固定一次清楚的划分,让每一步都能从保存的输入、系数和预测中复算。
05运行真实实验,读懂模型得到的结果
下面的完整程序会下载并核对同一份工作簿,解析糖链,保留符合结构规则的记录,再执行组成分组、表示构造和回归。首次运行需要网络读取数据,之后可使用已保存的文件。程序使用NumPy、SciPy、Matplotlib、openpyxl和requests,普通CPU即可完成本节实验。输出包括六幅图、全部学习样本与预测、排除记录和最终模型参数。
"""Glycan connectivity and a learned kernel: reproduce the real CMA1 array example.
Install: python -m pip install numpy scipy matplotlib openpyxl requests
Data: Lundstrøm et al. (2024), doi:10.3762/bjoc.20.31, CC BY 4.0.
The 403-row cohort is selected by structure and presentation occurrence, not RFU.
"""
from pathlib import Path
from collections import Counter
import hashlib
import json
import re
import io
import requests
import openpyxl
import numpy as np
from scipy.stats import spearmanr
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

OUT=Path('glycan_outputs');OUT.mkdir(exist_ok=True)
URL='https://www.beilstein-journals.org/bjoc/content/supplementary/1860-5397-20-31-S1.xlsx'
SHA='403d65ebe15cef6d05a92fa0a231fb81ea681fcdd2184a65b526ce3bf40e391a'
cache=OUT/'cma1_arrays.xlsx'
if not cache.exists():
    response=requests.get(URL,timeout=60);response.raise_for_status()
    cache.write_bytes(response.content)
raw=cache.read_bytes()
assert hashlib.sha256(raw).hexdigest()==SHA,'Source file differs from the published example'
book=openpyxl.load_workbook(io.BytesIO(raw),read_only=True,data_only=True)
values=list(book['imperial'].values);headers=values[0]
source_rows=[dict(zip(headers,row)) for row in values[1:]]
book.close()

BASES=['GlcNAc','GalNAc','Neu5Ac','Neu5Gc','GlcNS','GlcN','GlcA','IdoA','GalA','ManA','GulA','ManNAc','Glc','Gal','Man','Fuc','Xyl','Ara','Rha','Fru']
MONOMER=re.compile('(?:'+'|'.join(sorted(BASES,key=len,reverse=True))+r')(?:[1-9][SP])*$')

def parse(sequence):
    # Exact token coverage: no silent stripping of placeholders or unknown linkages.
    tokens=re.findall(r'\[|\]|\([ab][12]-[1-9]\)|[A-Za-z0-9]+',sequence)
    if ''.join(tokens)!=sequence:raise ValueError('unsupported_or_incomplete_notation')
    nodes=[];edges=[];pos=len(tokens)-1
    def chain(parent=None,branch=False):
        nonlocal pos
        current=parent;first=None
        while pos>=0 and tokens[pos]!='[':
            token=tokens[pos]
            if token==']':
                if current is None:raise ValueError('branch_without_parent')
                pos-=1;chain(current,True)
                if pos<0 or tokens[pos]!='[':raise ValueError('unbalanced_branch')
                pos-=1;continue
            if token.startswith('('):
                if current is None:raise ValueError('dangling_link')
                link=token[1:-1];pos-=1
                if pos<0 or not MONOMER.fullmatch(tokens[pos]):raise ValueError('unknown_residue')
                node=len(nodes);nodes.append(tokens[pos]);edges.append({'child':node,'parent':current,'link':link})
                current=node;pos-=1
            else:
                if current is not None or not MONOMER.fullmatch(token):raise ValueError('unknown_residue_or_missing_link')
                current=len(nodes);nodes.append(token);pos-=1
            if first is None:first=current
        return first
    root=chain()
    if pos!=-1 or not nodes or len(edges)!=len(nodes)-1:raise ValueError('not_a_complete_tree')
    children={i:[] for i in range(len(nodes))}
    for e in edges:children[e['parent']].append((e['link'],e['child']))
    for values in children.values():
        acceptor=[link.split('-')[1] for link,_ in values]
        if len(acceptor)!=len(set(acceptor)):raise ValueError('duplicate_acceptor_site')
    def canonical(i):return nodes[i]+'{'+','.join(link+':'+canonical(c) for link,c in sorted(children[i],key=lambda q:(q[0],canonical(q[1]))))+'}'
    return {'nodes':nodes,'edges':edges,'root':root,'canonical':canonical(root)}


accepted=[];excluded=[]
for index,row in enumerate(source_rows):
    try: accepted.append(row|{'row':index+2,'graph':parse(row['glycan'])})
    except ValueError as error:
        excluded.append({'row':index+2,'reason':str(error),'glycan':row['glycan']})
parsed={'accepted':accepted,'excluded':excluded}
assert len(source_rows)==866 and len(accepted)==649
counts=Counter(r['graph']['canonical'] for r in parsed['accepted'])
rows=[r for r in parsed['accepted'] if counts[r['graph']['canonical']]==1]
rows.sort(key=lambda r:r['graph']['canonical'])
families=sorted({json.dumps(sorted(Counter(r['graph']['nodes']).items())) for r in rows})
order=np.random.default_rng(1010).permutation(len(families))
partition={families[int(j)]:('train' if i<int(.6*len(order)) else 'validation' if i<int(.8*len(order)) else 'test') for i,j in enumerate(order)}
for r in rows:
    r['composition_group']=json.dumps(sorted(Counter(r['graph']['nodes']).items()))
    r['split']=partition[r['composition_group']]
    r['AO_label']=int(bool(re.search(r'[-.]AO(?:\b|\*)',r['original_notation'])))
    r['id']=f"ICL-{r['row']:04d}"
groups={s:np.array([i for i,r in enumerate(rows) if r['split']==s]) for s in ['train','validation','test']}
y=np.log1p([r['RFU'] for r in rows]);tr,va,te=[groups[s] for s in groups]

def descriptors(graph,depth,typed=True):
    labels=list(graph['nodes']);out=Counter('0:'+x for x in labels)
    adjacency=[[] for _ in labels]
    for edge in graph['edges']:
        i,j=edge['child'],edge['parent'];link=edge['link'] if typed else '*'
        adjacency[i].append(('to-parent:'+link,j));adjacency[j].append(('to-child:'+link,i))
    for level in range(1,depth+1):
        labels=[json.dumps([labels[i],sorted((edge,labels[j]) for edge,j in neighbors)],separators=(',',':'))
                for i,neighbors in enumerate(adjacency)]
        out.update(str(level)+':'+label for label in labels)
    return dict(out)

def matrix(dicts):
    # Feature vocabulary from training structures only; unseen motifs contribute zero.
    vocabulary=sorted({k for i in tr for k in dicts[i]});index={k:j for j,k in enumerate(vocabulary)}
    x=np.zeros((len(dicts),len(vocabulary)),dtype=float)
    for i,d in enumerate(dicts):
        for key,value in d.items():
            if key in index:x[i,index[key]]=value
    # Include unseen motif counts in the norm: they are orthogonal features,
    # not a reason to inflate the similarity of the remaining known motifs.
    norm=np.array([np.sqrt(sum(v*v for v in d.values())) for d in dicts])[:,None]
    x=np.divide(x,norm,out=np.zeros_like(x),where=norm>0)
    # Observed AO notation is an assay-presentation covariate, shared by every learned model.
    presentation=np.array([[int(r['AO_label']==0),r['AO_label']] for r in rows],float)
    return np.hstack([x,.25*presentation]),vocabulary

def metrics(pred,indices):
    loss=(pred[indices]-y[indices])**2
    unique=sorted({rows[i]['composition_group'] for i in indices})
    per=[float(np.mean([loss[j] for j,i in enumerate(indices) if rows[i]['composition_group']==f])) for f in unique]
    return {'RMSE_log':float(np.sqrt(loss.mean())),'MAE_log':float(np.mean(abs(pred[indices]-y[indices]))),
            'R2_log':float(1-loss.sum()/np.sum((y[indices]-y[indices].mean())**2)),
            'group_equal_RMSE_log':float(np.sqrt(np.mean(per))),
            'spearman':float(spearmanr(pred[indices],y[indices]).statistic) if np.std(pred[indices])>1e-12 else None}

predictions={'train_mean':np.full(len(rows),y[tr].mean())};models={}
for name,depths,typed in [('composition',[0],True),('untyped_graph',[1,2],False),('typed_graph',[1,2],True)]:
    mean=float(y[tr].mean());choices=[];best=None
    for depth in depths:
        dictionaries=[descriptors(r['graph'],depth,typed) for r in rows];x,vocabulary=matrix(dictionaries)
        kernel=x@x.T
        for reg in [1e-4,1e-3,.01,.1,1.,10.]:
            alpha=np.linalg.solve(kernel[np.ix_(tr,tr)]+reg*np.eye(len(tr)),y[tr]-mean)
            prediction=mean+kernel[:,tr]@alpha
            value=metrics(prediction,va)['group_equal_RMSE_log']
            choices.append({'depth':depth,'regularization':reg,'validation_group_RMSE':value})
            if best is None or value<best[0]:best=(value,reg,alpha,prediction,depth,x,vocabulary)
    value,reg,alpha,prediction,depth,x,vocabulary=best;predictions[name]=prediction
    models[name]={'depth':depth,'typed_edges':typed,'vocabulary':vocabulary,'alpha':alpha.tolist(),
        'train_mean':mean,'selected_regularization':reg,'choices':choices,'features':x.tolist()}
    print(name,'dimensions',x.shape[1],'lambda',reg,'val',round(value,3),'test',metrics(prediction,te),flush=True)
results={'data_source_doi':'10.3762/bjoc.20.31','source_sheet':'imperial','source_sha256':'403d65ebe15cef6d05a92fa0a231fb81ea681fcdd2184a65b526ce3bf40e391a',
 'selection':'Explicit parsed glycan tree with one occurrence among the structurally eligible source rows; no response-based selection',
 'rows':len(rows),'composition_groups':len(families),'split_seed':1010,
 'split':{s:{'indices':ids.tolist(),'rows':len(ids),'groups':len({rows[i]['composition_group'] for i in ids}),
             'positive_reported_RFU':sum(rows[i]['RFU']>0 for i in ids)} for s,ids in groups.items()},
 'transform':'natural_log(1+RFU/1RFU)','models':models,'test_metrics':{k:metrics(p,te) for k,p in predictions.items()}}
samples={'rows':[r|{'log_RFU':float(y[i]),'predictions':{k:float(v[i]) for k,v in predictions.items()}} for i,r in enumerate(rows)],
         'exclusions':parsed['excluded'],'repeated_tree_rows_excluded':len(parsed['accepted'])-len(rows)}

# Keep source identifiers and molecular fields in the downloadable learning table.
for row in samples['rows']:
    row.pop('original_notation',None);row.pop('Zscore',None)
samples.update(source_doi='10.3762/bjoc.20.31',license='CC BY 4.0')
pair=[]
for name in ['H-Tri-T2-AO','Lex-Tri-AO']:
    matches=[r for r in source_rows if r['original_notation']==name]
    assert len(matches)==1
    r=matches[0];pair.append({'name':name,'glycan':r['glycan'],'RFU':r['RFU'],
                             'graph':parse(r['glycan'])})
results['illustrative_isomers']=pair
results['source_rows']=len(source_rows)
results['structurally_parsed_rows']=len(accepted)
results['zero_reported_RFU']=sum(r['RFU']==0 for r in rows)
results['presentation_covariate']='explicit AO marker vs other; fixed feature amplitude 0.25'
results['isomer_scope']='Source measurements for illustration, not a two-sample model evaluation; Lex tree occurs repeatedly and is outside the learning cohort.'
(OUT/'results.json').write_text(json.dumps(results,ensure_ascii=False,indent=2),encoding='utf-8')
(OUT/'samples.json').write_text(json.dumps(samples,ensure_ascii=False,indent=2),encoding='utf-8')
print({s:v['rows'] for s,v in results['split'].items()},'positive RFU',sum(y>0))
print('Mean baseline:',results['test_metrics']['train_mean'])

plt.rcParams.update({'font.family':'DejaVu Sans','font.size':11,'axes.spines.top':False,
    'axes.spines.right':False,'axes.labelcolor':'#273b36','text.color':'#273b36',
    'svg.hashsalt':'ai4s-L10','savefig.facecolor':'#fffdf8'})
names=['train_mean','composition','untyped_graph','typed_graph']
labels=['Training mean','Composition','Graph: no bond type','Graph: typed bonds']
colors=['#a39372','#5c7899','#c17150','#267b69']
toy=[parse(f'Gal({link})GlcNAc') for link in ['a1-3','b1-3','a1-4','b1-4']]
d=[descriptors(g,2,True) for g in toy]
similarity=np.array([[sum(v*b.get(k,0) for k,v in a.items())/
    np.sqrt(sum(v*v for v in a.values())*sum(v*v for v in b.values())) for b in d] for a in d])

def panel(ax,key):
    if key=='data':
        splits=list(groups);n=np.array([len(groups[s]) for s in splits])
        pos=np.array([sum(rows[i]['RFU']>0 for i in groups[s]) for s in splits]);zero=n-pos
        ax.bar(range(3),zero,color='#d4dcd2',label='Reported RFU = 0',width=.58)
        ax.bar(range(3),pos,bottom=zero,color=colors[-1],label='Reported RFU > 0',width=.58)
        for j in range(3):
            ax.text(j,zero[j]/2,str(zero[j]),ha='center',va='center')
            ax.text(j,n[j]+7 if pos[j]<15 else zero[j]+pos[j]/2,str(pos[j]),
                    ha='center',va='center',color=colors[-1] if pos[j]<15 else 'white')
        ax.set_xticks(range(3),[f'{s.title()}\n{results["split"][s]["groups"]} groups' for s in splits])
        ax.set(ylabel='Number of glycan probes',ylim=(0,320),title='A  Split whole composition groups')
        ax.legend(frameon=False,fontsize=9)
    elif key=='prediction':
        p=predictions['typed_graph'][te];observed=y[te];positive=observed>0
        ax.scatter(observed[~positive],p[~positive],c='#a4b7ad',alpha=.5,s=32,label='Reported zero')
        ax.scatter(observed[positive],p[positive],c='#c17150',edgecolors='white',s=65,label='Reported positive')
        ax.plot([0,11],[0,11],c='#a9afa5',ls='--',label='Equal prediction and observation')
        ax.axhline(y[tr].mean(),c=colors[0],ls=':',label='Training-mean baseline')
        ax.set(xlabel='Observed ln(1 + RFU / 1 RFU)',ylabel='Predicted transformed response',
               title='B  Typed graph: all 64 test probes',xlim=(-.4,11),ylim=(min(-.5,p.min()-.4),11))
        ax.legend(frameon=False,fontsize=8,loc='upper left')
    elif key=='metrics':
        for j,(k,c) in enumerate(zip(names,colors)):
            rmse=results['test_metrics'][k]['RMSE_log'];mae=results['test_metrics'][k]['MAE_log']
            ax.plot([mae,rmse],[j,j],c=c,lw=3,alpha=.5)
            ax.scatter([mae],[j],c=c,s=65,marker='o');ax.scatter([rmse],[j],c=c,s=65,marker='D')
            ax.text(mae-.05,j-.17,f'{mae:.2f}',ha='right',fontsize=9)
            ax.text(rmse+.05,j+.20,f'{rmse:.2f}',ha='left',fontsize=9)
        ax.set_yticks(range(4),labels);ax.invert_yaxis()
        ax.set(xlim=(1.2,3.4),ylim=(3.7,-.7),xlabel='Error on transformed response / lower is better',
               title='C  Typical error and large errors weigh differently')
        ax.scatter([],[],c='#273b36',marker='o',label='MAE');ax.scatter([],[],c='#273b36',marker='D',label='RMSE')
        ax.legend(frameon=False,fontsize=9,loc='lower right')
    elif key=='validation':
        for k,c,label in zip(names[1:],colors[1:],labels[1:]):
            model=models[k]
            for depth in sorted({r['depth'] for r in model['choices']}):
                selected=[r for r in model['choices'] if r['depth']==depth]
                ax.plot([r['regularization'] for r in selected],
                        [r['validation_group_RMSE'] for r in selected],
                        c=c,ls='-' if depth==model['depth'] else ':',
                        label=f'{label}, depth {depth}')
            r=next(r for r in model['choices'] if r['depth']==model['depth'] and r['regularization']==model['selected_regularization'])
            ax.scatter([r['regularization']],[r['validation_group_RMSE']],c=c,s=65,zorder=4)
        ax.set(xscale='log',xlabel='Regularization strength',ylabel='Equal-group validation RMSE',
               title='D  Validation selects depth and regularization')
        ax.legend(frameon=False,fontsize=8)
    elif key=='isomers':
        vals=[r['RFU'] for r in pair]
        ax.bar([0,1],vals,color=[colors[-1],colors[2]],width=.5)
        for j,v in enumerate(vals):ax.text(j,v+100,f'{v:,} RFU',ha='center')
        ax.set_xticks([0,1],['H-Tri-T2-AO\nFuc to Gal: alpha 1-2','Lex-Tri-AO\nFuc to GlcNAc: alpha 1-3'])
        ax.set(ylabel='Published CMA1 array response / RFU',ylim=(0,5200),
               title='E  Same composition, different connectivity')
        ax.text(.02,.97,'Source illustration: two AO-labelled probes\nBoth contain one Fuc, one Gal and one GlcNAc',
                va='top',transform=ax.transAxes,fontsize=9)
    else:
        im=ax.imshow(similarity,cmap='YlGnBu',vmin=0,vmax=1)
        ticks=['alpha 1-3','beta 1-3','alpha 1-4','beta 1-4']
        ax.set_xticks(range(4),ticks);ax.set_yticks(range(4),ticks)
        for i in range(4):
            for j in range(4):ax.text(j,i,f'{similarity[i,j]:.2f}',ha='center',va='center',
                                     color='white' if i==j else '#273b36')
        ax.set(title='F  A representation can retain bond identity',xlabel='Gal(link)GlcNAc / defined structural examples')
        ax.text(.5,-.22,'Composition and untyped-graph similarities are all 1.00.\nShown: typed, depth-2 motif cosine; no assay covariate.',
                ha='center',transform=ax.transAxes,fontsize=8)
        ax.grid(False)
        return
    ax.grid(alpha=.14)

keys=['data','prediction','metrics','validation','isomers','similarity']
for key in keys:
    fig,ax=plt.subplots(figsize=(7.7,5.6),layout='constrained',facecolor='#fffdf8');panel(ax,key)
    fig.savefig(OUT/(key+'.svg'),metadata={'Date':None});plt.close(fig)
fig,axes=plt.subplots(3,2,figsize=(16,18),layout='constrained',facecolor='#fffdf8')
for ax,key in zip(axes.flat,keys):panel(ax,key)
fig.savefig(OUT/'glycan_learning.svg',metadata={'Date':None})
fig.savefig(OUT/'glycan_learning.png',dpi=160,metadata={'Software':'Matplotlib'});plt.close(fig)
print('Saved six panels, all cohort rows, predictions, selected models and exclusions.')
本次实际运行输出
composition dimensions 29 lambda 1.0 val 3.131 test {'RMSE_log': 2.5180997811870185, 'MAE_log': 1.8576954221857684, 'R2_log': -0.26648086739097177, 'group_equal_RMSE_log': 2.5768225901938404, 'spearman': 0.29427119201512697}
untyped_graph dimensions 205 lambda 0.01 val 2.113 test {'RMSE_log': 3.04591624886402, 'MAE_log': 1.6879143514232147, 'R2_log': -0.8530565723303392, 'group_equal_RMSE_log': 3.2672519487554483, 'spearman': 0.24026943787176566}
typed_graph dimensions 920 lambda 0.1 val 2.307 test {'RMSE_log': 2.4682108425624634, 'MAE_log': 1.5610383992964285, 'R2_log': -0.2167946017650808, 'group_equal_RMSE_log': 2.589012334628697, 'spearman': 0.33531160899799173}
{'train': 258, 'validation': 81, 'test': 64} positive RFU 86
Mean baseline: {'RMSE_log': 2.4035798433067335, 'MAE_log': 2.055609867701193, 'R2_log': -0.15390450628146568, 'group_equal_RMSE_log': 2.390403340816057, 'spearman': None}
Saved six panels, all cohort rows, predictions, selected models and exclusions.
先读A图的数据分布。403条学习记录中有86条正RFU,其余317条为零。训练、验证和测试中的正读数分别为62、17和7条,因此测试组里大部分对象都处在零值一侧。这个分布会影响模型评价:始终给出一个较低值,可能让许多零读数对象的误差不大;少数高信号若预测偏离较多,又会对平方误差产生较大贡献。先看数据分布,才能理解后面的几种指标为什么没有给出完全相同的排序。
B图将64条测试记录的实际变换目标放在横轴,带键类型图模型的预测放在纵轴。对角线上的点表示两者一致;橙色点对应原表中的正读数,灰绿色点对应零读数。水平虚线给出训练均值基线。所有零读数在横轴上重合,因此需要结合A图理解其数量,不能只凭可见点的个数判断样本组成。回归直接预测变换后的实数,少量负预测也保留在图中,它们表示模型在零目标以下的偏差。
C图比较两种误差。MAE把每条记录的偏差取绝对值后平均,容易读成一次预测通常偏了多远;RMSE先把误差平方,平均后再开方,对少数较大的偏差更敏感。两者都在前面定义的无量纲对数目标上计算,不能把数值当成RFU直接相减。选择哪个指标作为研究目标,应当与实验用途有关:希望整体候选排序稳定,还是特别希望避免漏掉高信号对象,会提出不同的要求。
式中n是测试记录数,本例为64;yi是第i条记录的变换目标,带帽子的y是预测值。假设三次预测的绝对误差为0、0、6,MAE为2,而RMSE为√12≈3.464。若另一方法的三次误差都为2,则MAE仍为2,RMSE也为2。这个小算例解释了为什么同样的平均绝对偏差,可能对应很不一样的大误差风险,也说明两幅指标图应该一起阅读。
一次运行 · 六幅结果图
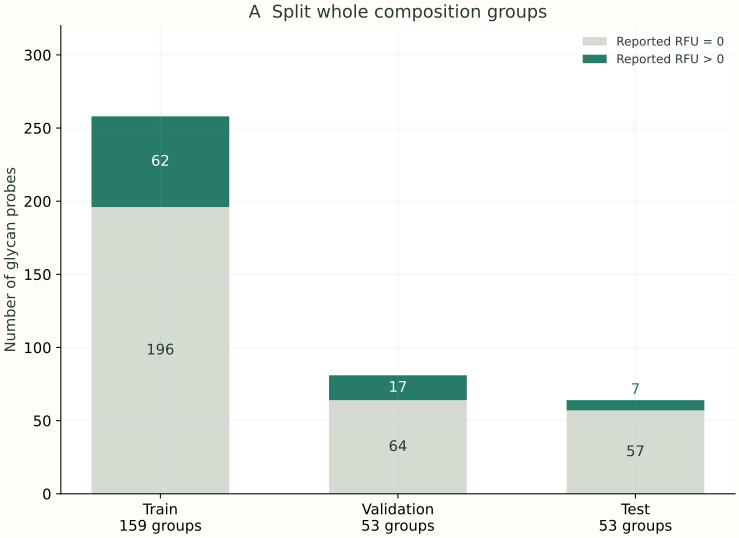
A|相同糖残基组成留在同一组,再划分训练、验证和测试。颜色区分原表中的零读数与正读数。
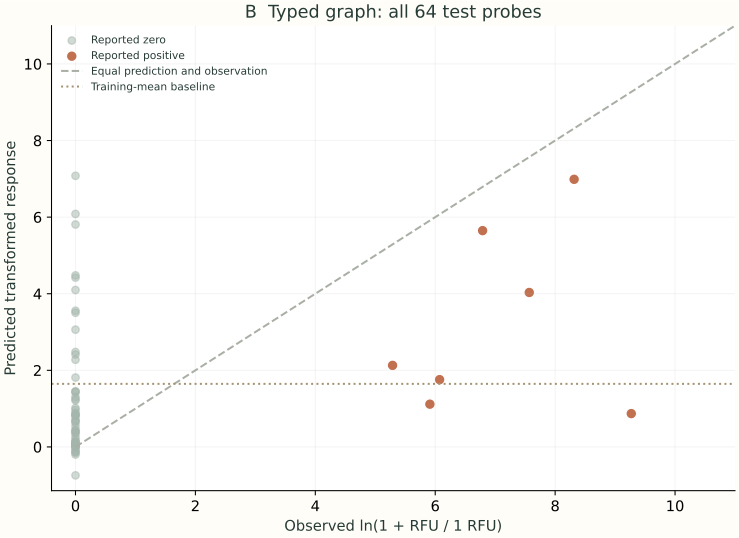
B|带键类型的图模型预测64条测试探针;对角线表示预测与测量相等,水平虚线为训练均值。
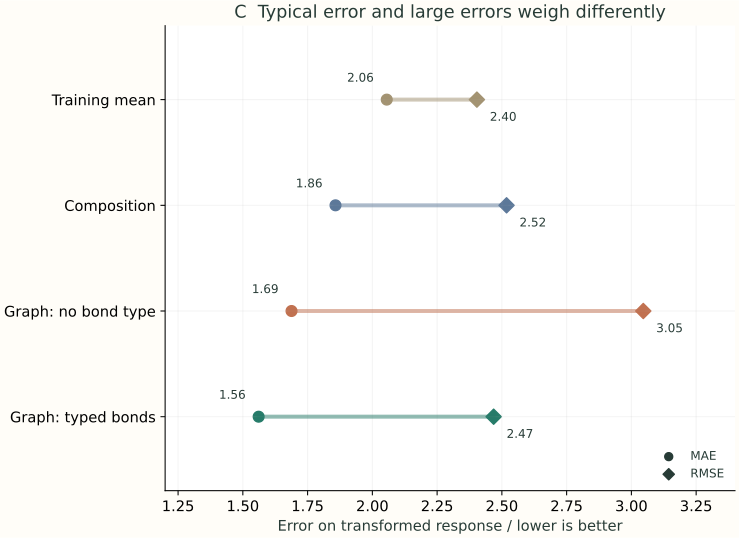
C|圆点为MAE,菱形为RMSE。四种方法在相同测试样本上比较,数值越小越好。
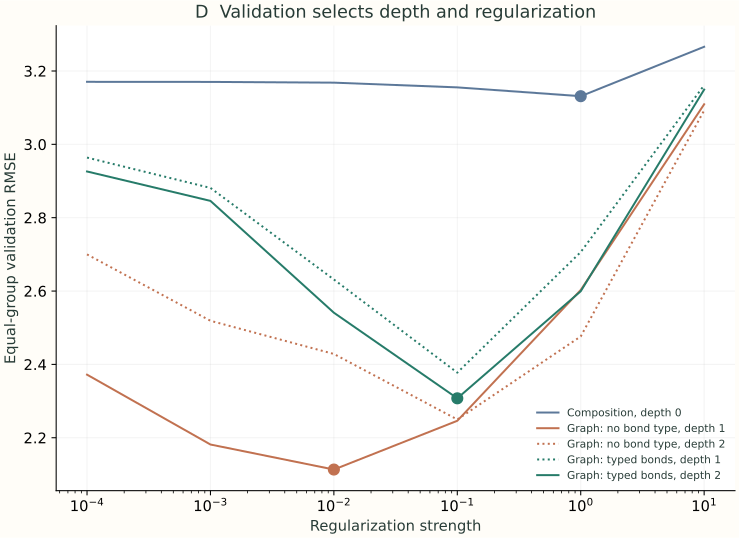
D|验证集选择连接邻域的深度与正则化强度;圆点标出最终采用的组合。
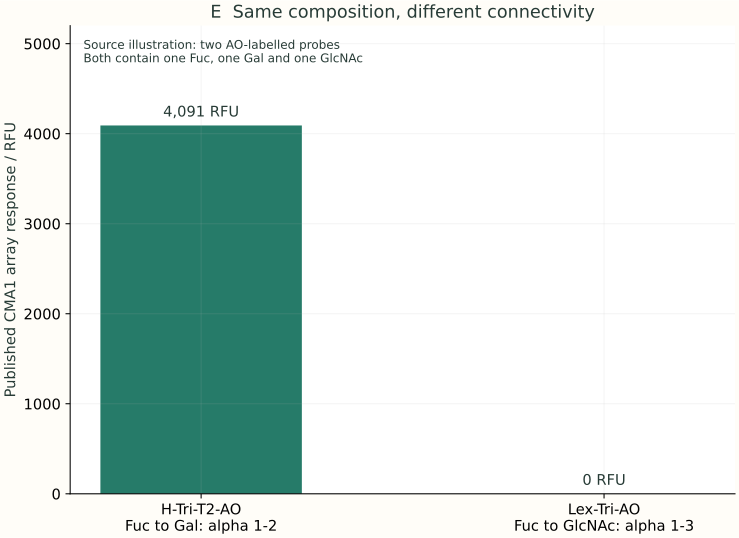
E|两个AO标记探针含有相同种类和数量的糖残基,岩藻糖的连接对象与碳位不同;柱高来自原表。
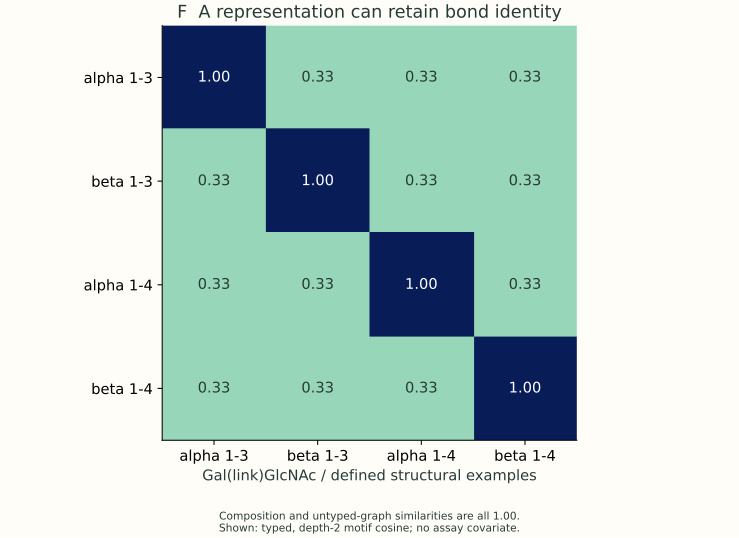
F|四个定义明确的二糖结构只改变连接标签。热图为带键类型的结构相似性;组成和忽略键类型的表示均得到全1矩阵。
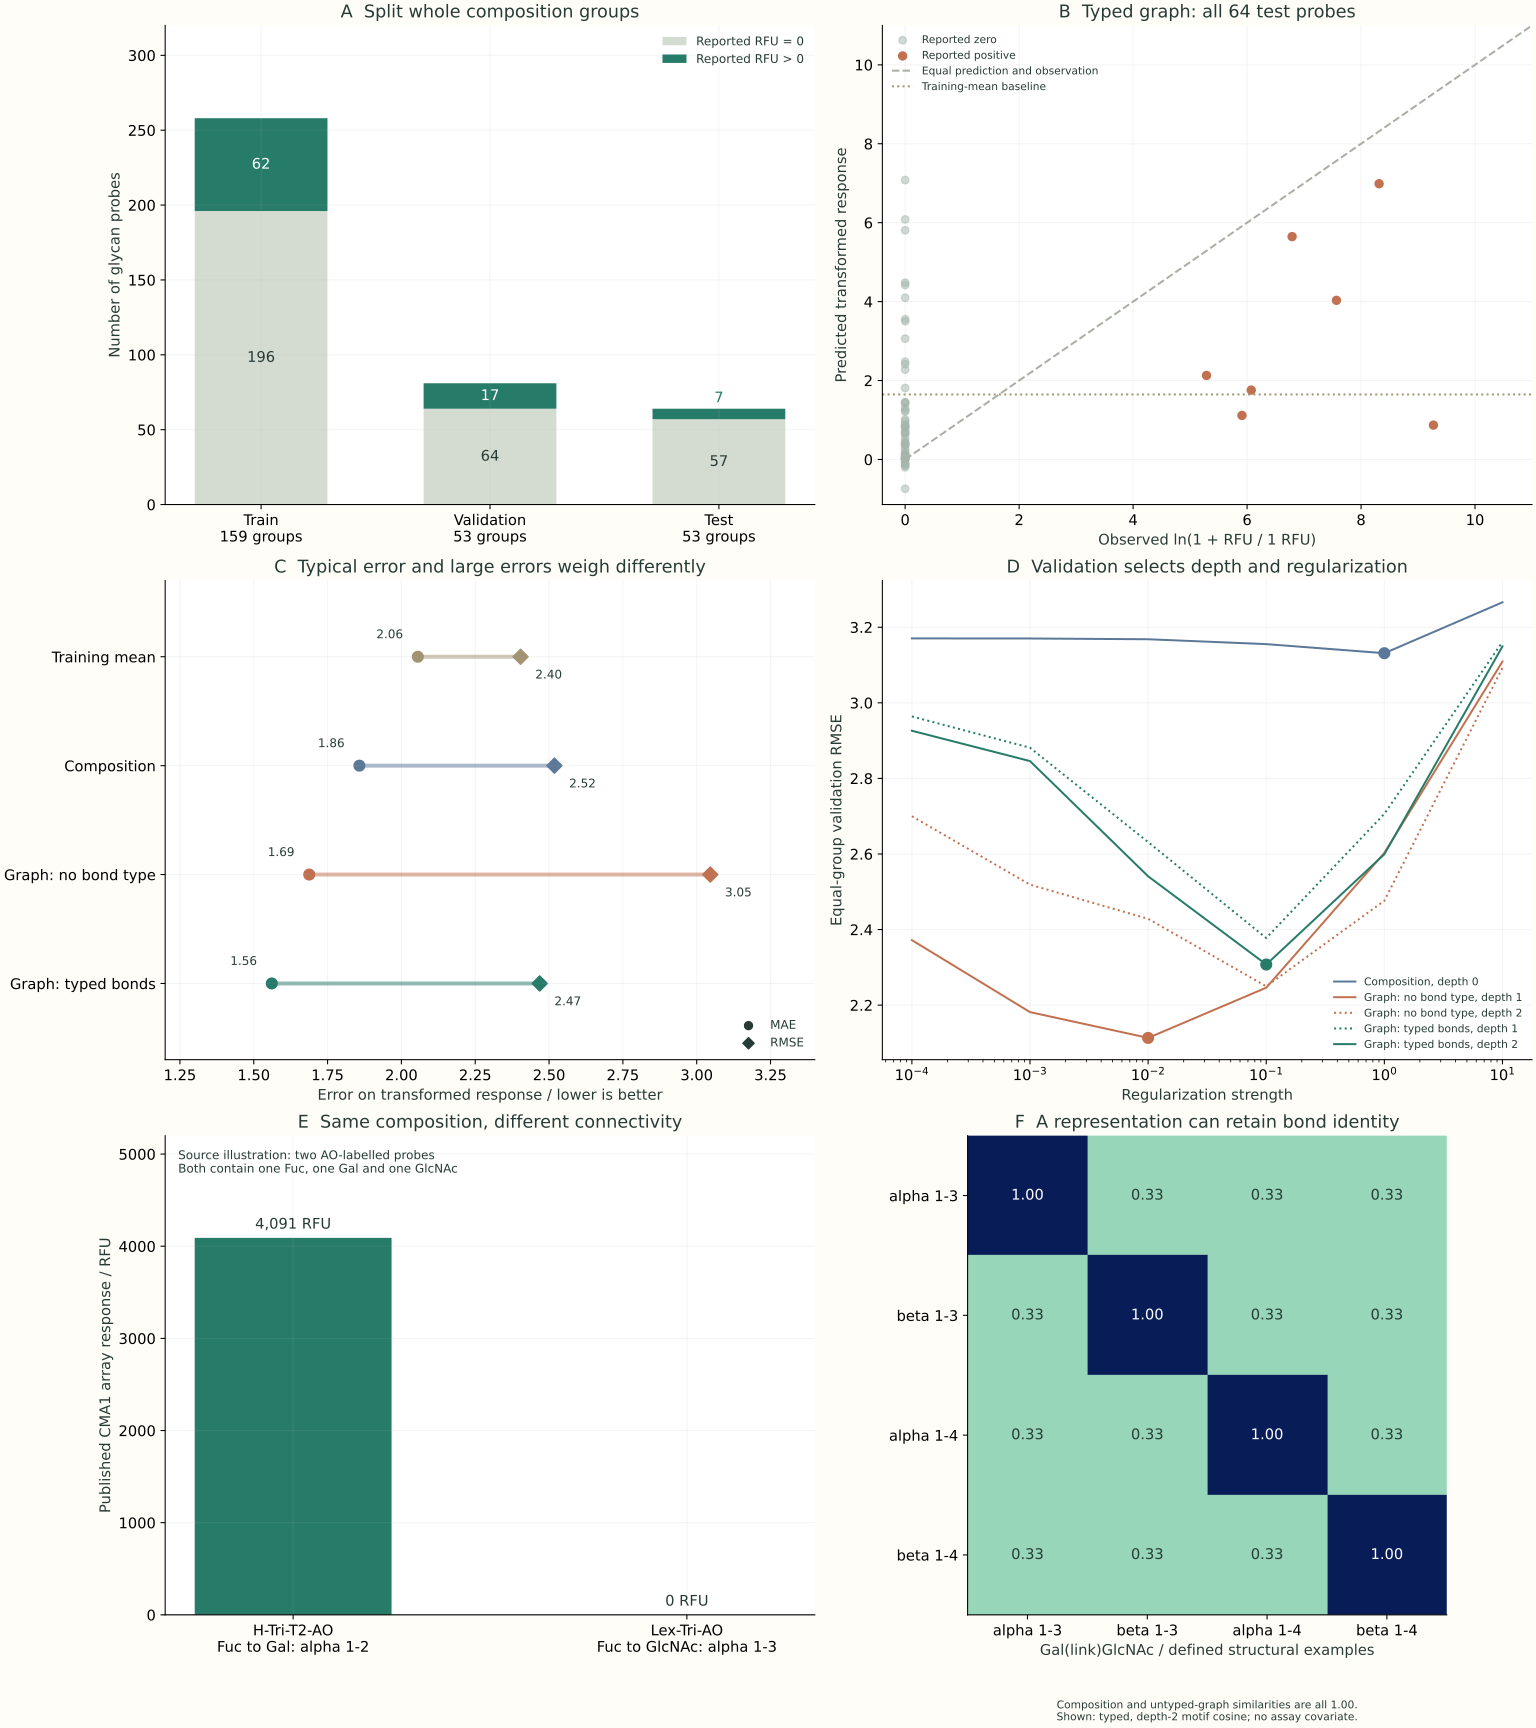
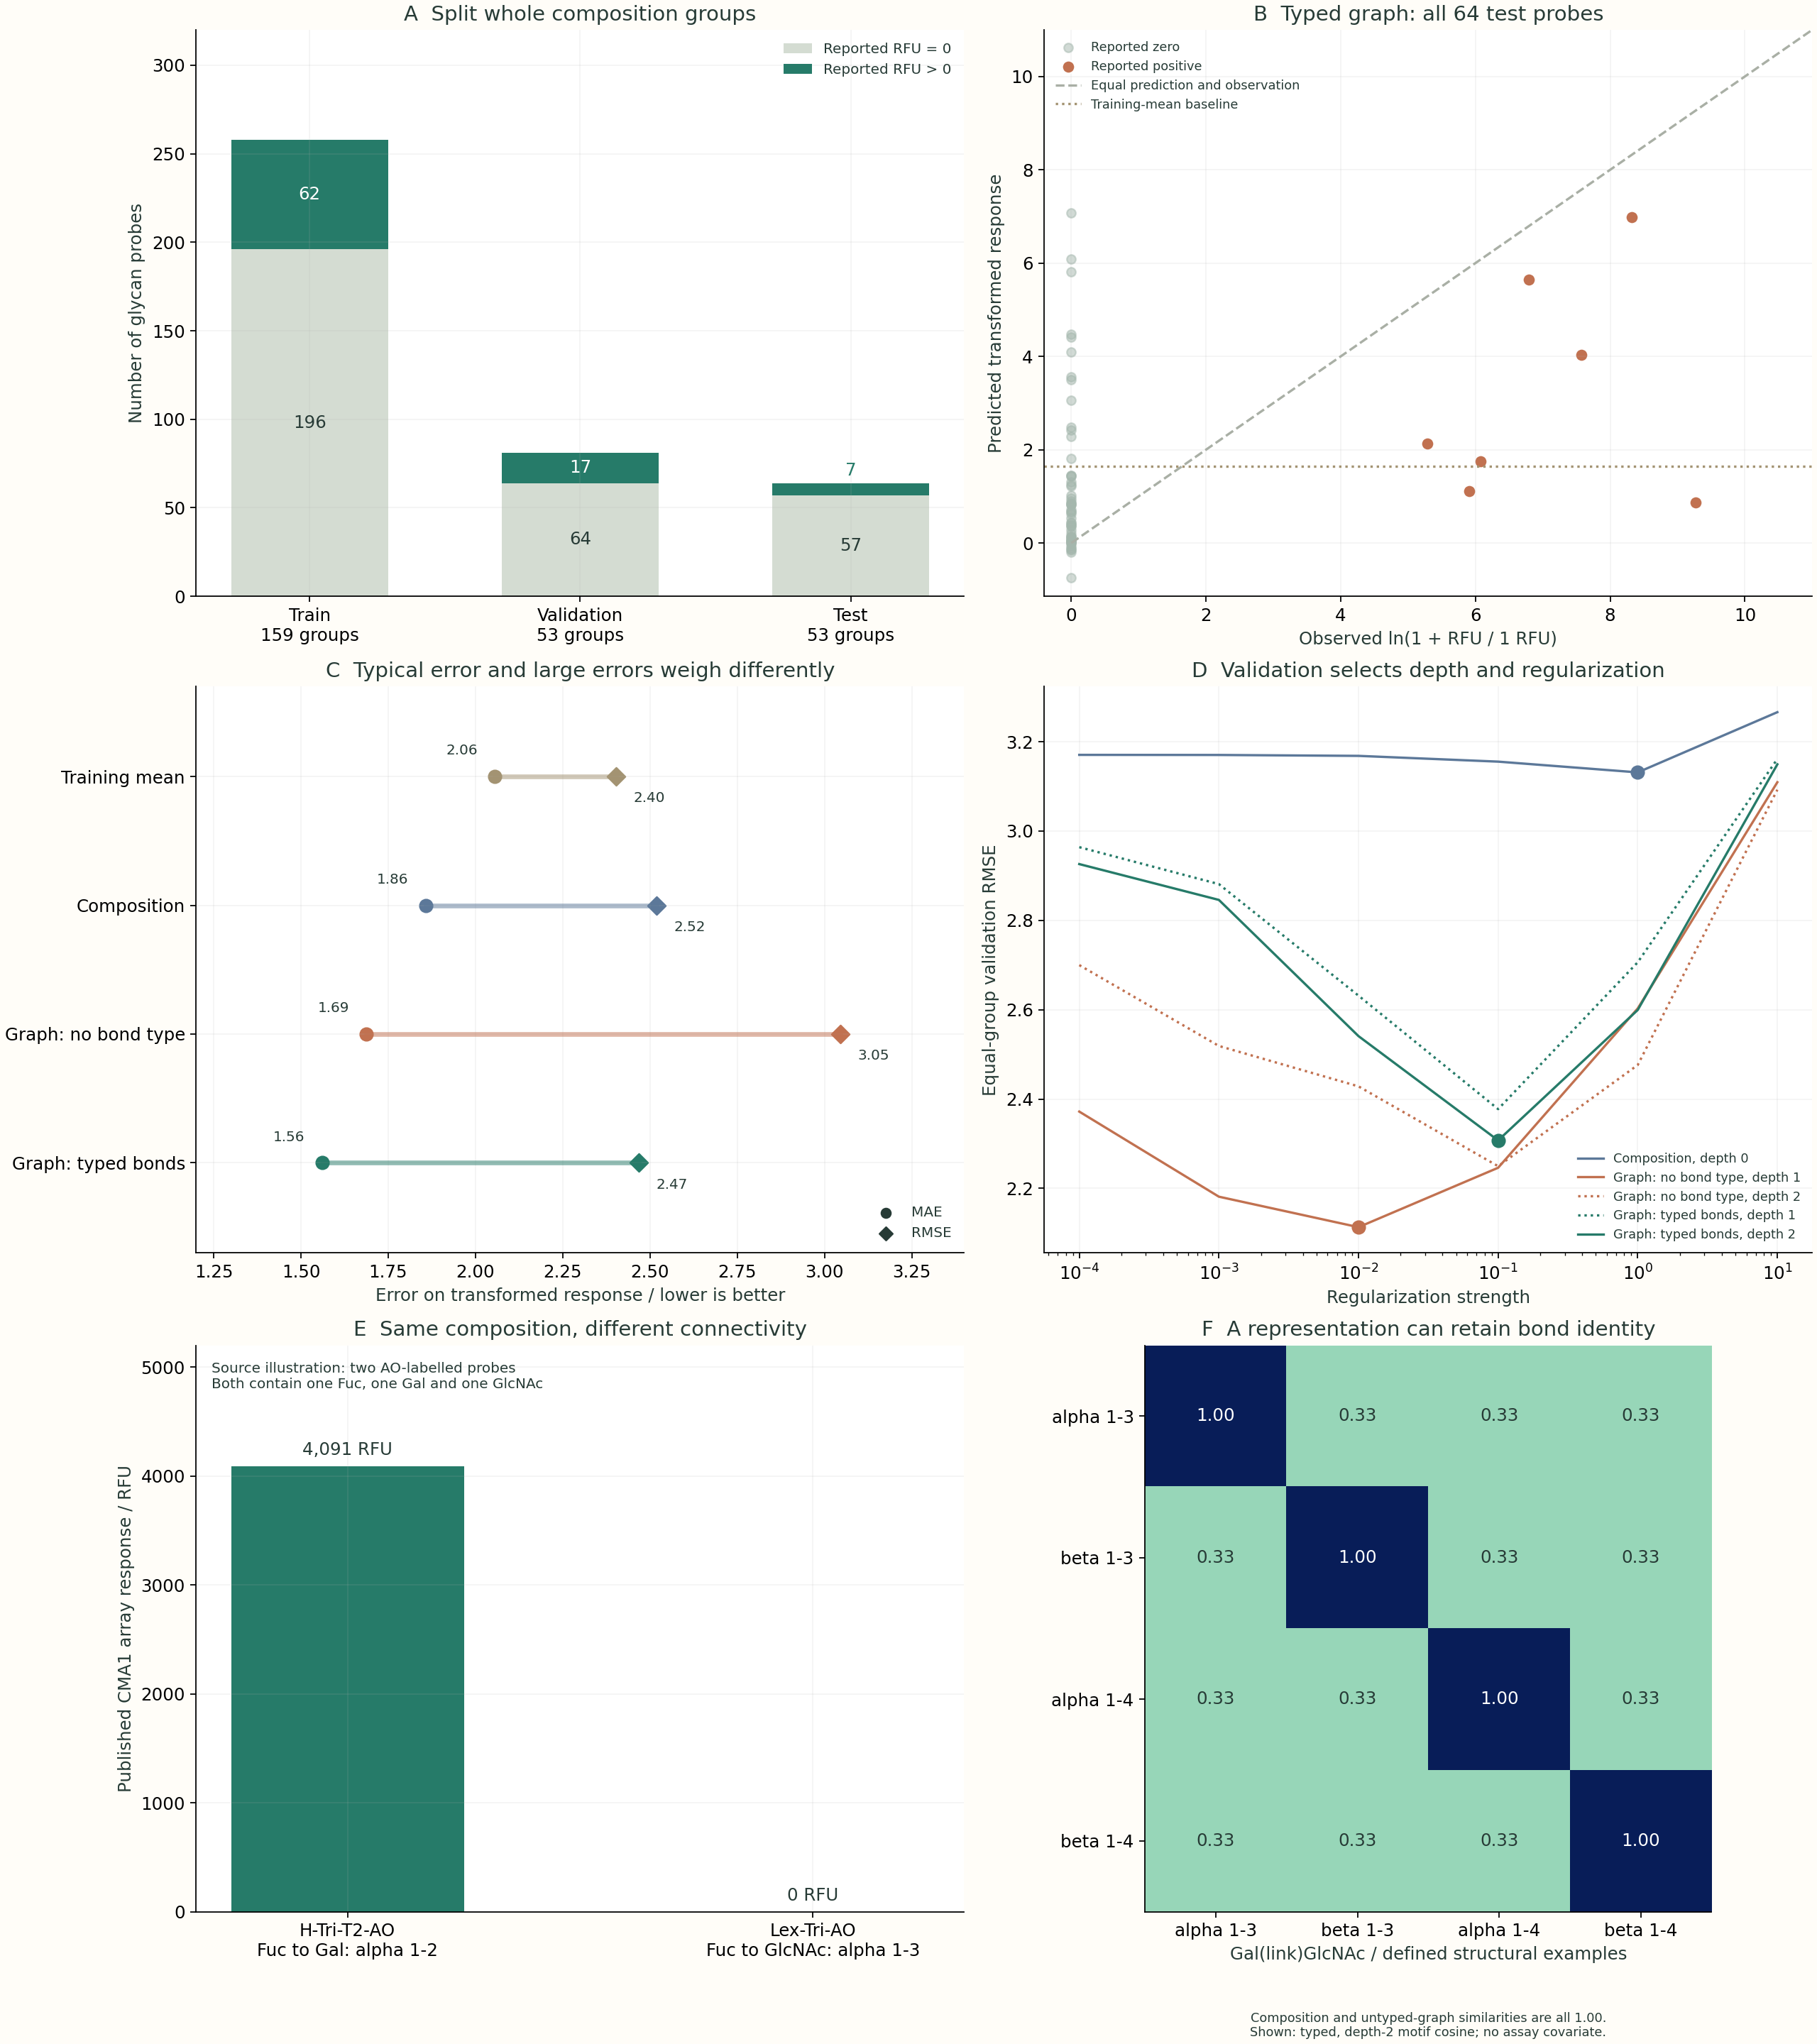
本次带键类型图模型的MAE为1.561,训练均值基线为2.056;RMSE分别为2.468和2.404。也就是说,图模型减小了平均绝对偏差,而训练均值在这批测试记录上的平方误差汇总更低。组成模型与忽略键类型模型的结果也完整列在C图和运行输出中。这里需要同时保留两个观察:结构表示已经具备区分连接的能力,它在当前样本分布中的预测收益则要用具体指标判断。
D图回答另一件事:最终采用的模型是怎样从候选中选出的?横轴为λ,使用对数刻度;纵轴为验证集的组成组等权RMSE。组成模型选中λ=1,忽略键类型的模型选中一轮邻域与λ=0.01,带键类型的模型选中两轮邻域与λ=0.1。图中的实线展示所选深度,其他候选深度以点线呈现,圆点标出最终组合。测试记录不参与这些代码中的超参数选择。
q代表一个组成组,Q是参与平均的组数,nq是该组记录数。先在组内平均平方误差,再对各组等权平均并开方,可以避免拥有许多连接异构体的组成组仅凭记录较多而占据更大权重。例如两个组分别含一条和九条记录,组内平均平方误差为4和1,则组等权结果为√2.5≈1.581;若直接合并十条记录,结果为√1.3≈1.140。两者回答的平均对象不同,本例用前者选择超参数。
E图将前面的两个AO探针读数放回实际数值尺度。组成相同的两个结构,一个为4091 RFU,一个为0 RFU,说明“每种糖有几个”不足以复述这一对测量差别。它们同时改变了岩藻糖的连接对象、受体碳位和分支关系,因此适合解释连接信息的重要性。若下一步想单独研究α/β的作用,应安排只改变异头构型、其他因素尽量一致的一组探针,而不能把这两个读数直接归给某一个局部因素。
F图正好补上一个可以完全控制输入的检查。四个指定的二糖都由Gal和GlcNAc构成,分别采用α1→3、β1→3、α1→4和β1→4连接。它们的组成相同,去掉边标签后图结构也相同,因此前两种表示的相似性全为1;带键类型的两轮描述则使不同连接的相似性降至约0.33。这里比较的是表示本身的计算结果,读者可以逐项数出共同和不同的模式,再理解热图中的数字。
把E图与F图放在一起,研究逻辑就连起来了。E图提供真实测量中的结构差别,帮助确定输入必须保留什么;F图检查程序是否确实保留了这些信息;B、C图再检查用这种表示训练的模型在整组留出的样本上表现怎样。科学问题、表示检查与预测评价各自承担一个明确任务,避免只用一张漂亮的热图就推断模型已经学会了所有结合规律。
若要继续开展研究,可以从当前误差较大的测试结构中提出实验问题,但新的模型选择需要安排新的独立评价对象。一个可执行的方案是固定同一种凝集素与检测流程,补充一组组成相同、只改变某条连接的探针,记录展示方式和重复测量,再研究哪个局部模式对应稳定的信号变化。想扩展到其他凝集素时,可以加入蛋白质身份或序列表示,并把整个新凝集素作为留出对象,检验模型能否跨受体使用信息。
糖链让我们看到,生物大分子的数据并不总是一串字母。残基种类、连接碳位、立体构型、分支与实验展示都可能影响标签含义。沿着这条思路,AI的作用可以落到具体研究步骤上:整理结构、比较局部模式、预测同一测量条件下的候选读数,再据此安排新的对照实验。《DNA与RNA:序列怎样组织成结构》转向DNA与RNA时,我们仍会追问同样的问题:输入保留了什么结构信息,模型输出又对应哪一种可以检验的分子行为?
资料与延伸阅读
Meyer与Mark,1928,纤维素结晶部分的结构研究;Nishiyama、Langan与Chanzy,2002,纤维素Iβ的X射线、中子衍射与氢键体系。Cho等,2000,部分脱乙酰甲壳素的溶解性研究,将组成、晶体结构与溶解联系起来。图中的链、衍射点和水分子为帮助解释研究方法而绘制的概念示意。
Blixt等,2004,Printed covalent glycan array for ligand profiling of diverse glycan binding proteins。Lundstrøm等,2024,CMA1的糖链结合特异性与结构研究,本例数据来自其补充工作簿,按CC BY 4.0许可使用并注明来源;具体阵列方法见同文补充MIRAGE文件。公开读数经过本节明确的结构筛选、目标变换与分组后用于学习。
Shervashidze等,2011,Weisfeiler–Lehman Graph Kernels。本节将逐轮邻域标签与模式计数用于糖残基树,并显式保留连接朝向、α/β及碳位。四幅科学史图为原创概念重绘,六幅数值图由本页Python程序生成;交互中的两个探针读数来自原始工作簿。