从遗传信息的载体到可以设计的分子结构
DNA与RNA:序列怎样组织成结构
一条拉链能够合上,既要两侧的齿彼此匹配,也要按合适的方向对齐。核酸中的互补配对给分子提供了类似的选择性:一段序列可以识别另一段序列,一条长链也可以折回来,让相隔较远的位置靠在一起。正是这些联系,使DNA与RNA既能参与信息存储和传递,也能形成有特定形状的结构。本节从最容易画清楚的配对开始,讨论一串字母怎样变成分子之间的关系。
给模型一条RNA序列,可以让它预测每个位置有多大机会参与配对。这个任务需要同时考虑字母身份、所在位置,以及远处有没有合适的伙伴。本节先用一套明确的配对规则计算结构分布,再训练小型神经网络近似由此得到的概率。已知规则提供了可以逐项核对的答案:当预测出错时,我们能追问是模型没读到远处信息、训练例子不够,还是换了长度以后没有延续原来的规律。代码、交互图和误差曲线会始终围绕这同一个任务展开。
01先读懂一条有方向的核酸链
核酸的基本构件是核苷酸。每个构件包含糖、磷酸相关部分和碱基,连接成链以后,糖与磷酸构成连续的骨架,碱基从骨架上伸出。DNA常用A、T、C、G四个字母表示腺嘌呤、胸腺嘧啶、胞嘧啶和鸟嘌呤;RNA通常把T换成U,即尿嘧啶。序列中的每个字母代表一个带有相应碱基的核苷酸残基,它不是一个可以脱离骨架自由移动的符号。
DNA使用脱氧核糖,RNA使用核糖,两者在糖的2′位置存在化学差别:RNA在这里带有羟基。一个小小的侧基变化,会影响局部构象以及化学反应的可能性。因此,DNA与RNA即使具有相近的字母排列,也不能直接共用所有结构和反应参数。前面研究糖链时已经看到,残基上的侧基和连接方式会改变分子行为;现在,同样的化学思想又出现在核酸骨架上。
5′和3′来自糖上碳原子的编号。相邻核苷酸通过磷酸二酯连接,把一个糖的3′位置与下一个糖的5′位置联系起来,使整条链具有方向。读到一段核酸序列时,通常默认按5′→3′书写。可以把这想成一条带箭头的道路:沿不同方向走,会依次遇到不同的标记。对AI来说,序列顺序与方向是输入的一部分,反过来写并不只是改变版面。
在常见的DNA双螺旋中,两条链反向平行,A与T、C与G形成互补配对。一条链写成5′-ACGTTA-3′时,与它逐位对齐的另一条链应写成3′-TGCAAT-5′。但若要把第二条也按通常的5′→3′方向录入数据库,就要写成5′-TAACGT-3′。这一步既交换了碱基,又反转了阅读顺序,所以称为反向互补。只换字母而不处理方向,会把本应对齐的关系写错。
L表示原链长度,si是原链第i个碱基,ri是按5′→3′写出的互补链第i个碱基。comp表示按A↔T、C↔G交换。为什么下标是L+1−i?第二条链的起点正好对着第一条链的终点,因此第一个位置先读取sL,第二个读取sL−1,再依次向前。例如上面的六碱基序列中,r₁来自s₆=A的互补T,r₂来自s₅=T的互补A,于是得到开头的TA。
理解双螺旋的历史,也是在学习怎样把不同证据接到同一个结构问题上。1953年,Franklin与Gosling发表了DNA纤维的分子构型研究,衍射观察为链的空间排列提供了约束;同一期中,Watson与Crick提出DNA双链结构模型,将骨架方向与特定碱基配对联系起来。研究者面对的并不是一张已经标好每个原子的照片,而是需要与化学几何共同解释的测量信息。
双螺旋常被画成扭转的梯子,梯子两侧表示糖—磷酸骨架,横档表示碱基配对。这个比喻方便识别结构层次,但真实分子的稳定性还涉及相邻碱基的堆积、溶剂、离子和构象选择。沿着链把相邻碱基叠放起来,与横向形成一对碱基,是彼此相关而又不同的作用。若只把稳定性归结成“有几根氢键”,就会漏掉序列邻接关系和环境带来的贡献。
核酸骨架上的磷酸基团使它在许多常见水溶液条件下带负电。水与离子因而参与结构平衡,盐浓度变化也会影响链之间的作用。前面讨论过的电荷屏蔽,在这里能帮助理解为什么配对实验需要记录溶液条件。研究一段序列是否形成双链时,除了字母本身,还要知道温度、浓度以及离子环境;这些条件决定了一个结构问题究竟是在怎样的实验中被提出。
互补性也解释了核酸怎样把信息与分子接触联系起来。一条链的排列能够约束与之匹配的另一条链,为复制和识别提供结构基础。若把一段短核酸作为探针,便可以利用这种选择性寻找目标片段。真正设计探针时,还要检查它是否会与自身或其他序列形成竞争结构。于是,“能与目标配对”和“在混合体系中主要与目标配对”成为两个需要分别研究的问题。
这一部分给后续计算准备了三个基本约定:序列按固定方向读取,互补关系由明确规则给出,骨架与配对处在不同的连接层次。骨架把所有位置串成一条链,配对则在这条链内部或不同链之间增加联系。AI需要从序列学习的,正是这些联系出现的倾向;我们接下来先研究一条RNA内部的联系,使结构可以用一张清楚的图表示。
02同一条链折回来,会出现什么结构
RNA常常以单链形式参与生物过程,但“单链”并不意味着始终伸展开来。链上的某一段可以与较远的一段互补,让中间部分绕成一个环,形成茎环或发夹结构。可以用一条两端带有相配扣子的软带来理解:两端扣上后,中间仍需要留出足够长度转弯。真实分子中的转弯涉及骨架构象与熵,环的序列和大小也会影响结构的相对稳定性。
对于RNA,常见配对包括A–U与C–G,也可以出现G–U摆动配对。后面的教学模型允许这三类配对的两个方向,并规定配对位置之间至少隔着三个位置。这个间隔是模型中明确写入的规则,帮助形成基本的环结构。先把允许的配对集合和间隔条件说清楚,才能判断程序算出的弧线是否合法;更丰富的RNA结构研究还会使用详细的堆积、环和环境参数。
描述核酸结构有几个常用层次。一级结构是序列,二级结构记录哪些碱基彼此配对,三级结构进一步描述这些局部结构在三维空间中的组织。转运RNA的工作就与这样的层次有关:它需要维持能够与其他分子接触的空间结构,同时携带氨基酸参与蛋白质合成。画出二级结构能够帮助理解局部配对,但从配对图走到完整的三维形状,还要处理空间排列与更多相互作用。
点括号是一种紧凑的二级结构写法。点表示该位置在当前结构里未配对,左括号与对应的右括号表示一对位置。序列GGGAAACCC可以对应“(((...)))”:前三个G依次与末端三个C配对,中间AAA构成未配对环。外层括号先打开、最后闭合,表示更外侧的配对把内层结构包在里面。写这种表示时,字符数必须与序列长度相同,每个括号也必须有对应伙伴。
如果把序列沿一条直线排开,再用弧线连接配对位置,就能直接看出哪些联系跨得较远。本节计算的结构允许弧线彼此嵌套,也允许两个独立茎环并排,但不允许两条弧出现i<k<j<l这样的交叉次序。这个非交叉条件使长区间可以拆成独立子区间,是后面快速计算的关键。真实RNA可以出现需要额外表示的假结结构,学习这种情况时,要相应扩展结构集合和算法。
核酸的可选择连接,也使它成为可以设计的高分子构件。2006年,Rothemund在DNA折纸研究中,用一条长单链作为支架,再设计许多较短的“订书钉链”,让短链分别与支架上的不同片段互补。短链把原本相隔较远的位置联系起来,支架便在自组装过程中形成预定的二维轮廓。这将序列选择、链的连接和纳米尺度形状直接放进了同一个设计流程。
“折纸”这个名称容易让人想到用手折一张纸,但实验中的操作是选择序列、制备分子并设置混合与退火条件。分子依靠自身相互作用组织起来,研究者再用显微方法检查结果。这个例子延续了高分子科学的一条主线:局部连接怎样传到整体形状。若希望AI帮助设计此类结构,输入就需要包含目标几何、可使用的序列片段以及相关条件,输出也应当对应能够进一步计算或测量的候选方案。
从复制、探针到折纸,可以看到核酸同时具有信息载体与材料构件的特点。对一个预测任务而言,序列给定,问题是它会偏向哪些结构;对一个设计任务而言,结构目标给定,问题是哪些序列能够支持它。两者的方向不同,却共享配对规则与结构评价工具。本节先做好预测方向,训练模型读取序列;后面学习如何选择下一次实验时,再把预测接到候选设计与实验反馈上。
即使序列与环境已经给定,也常有多个结构可以参与分布。某一对位置靠近时,另一些位置可能暂时失去原来的伙伴;一个稳定的局部茎也可以与较柔性的连接区同时存在。因此,计算一张配对图只是描述的一种方式。若关心某个位置是否经常暴露,或者某个短片段是否容易参与结合,更合适的输出可能是配对概率,而不是只保留一张最优图。
这与第二节的构象系综相接:我们不再试图用一幅照片代表所有可能,而是研究每种状态在指定模型中的权重。下面先用“配对数最多”练习如何搜索结构,再把同样的分解方法改成汇总所有结构。一个问题给出代表性的配对图,另一个给出概率分布。读者可以在交互图中切换两种看法,观察一条很短的RNA为什么也能拥有许多合法结构。
03从寻找一张结构,到计算许多结构的概率
如果一条链有许多位置,逐个猜测配对方案会很快变得繁琐。动态规划的做法是先算短片段,把答案保存下来,再用它们组合出较长片段的答案。Nussinov与Jacobson在1980年的RNA结构算法研究中讨论了这种快速求解思路。本节使用一个容易核对的版本:在给定配对与非交叉条件下,寻找含有最多碱基对的结构,每增加一对就记一分。
令M(i,j)表示从第i位到第j位这一段能够形成的最大配对数。最左侧的i只有两类情况:它不配对,问题就留给i+1到j;或者它与某个合法位置k配对。后一种情况已经得到一分,内部的i+1到k−1与右侧的k+1到j又分别成为较小问题。因为禁止交叉,这两个区间的配对不会互相穿过,便可以将它们的最优分数相加。
Ai(j)表示i在当前区间内允许选择的伙伴集合,其中k必须满足碱基类型与最小间隔规则。公式中的第一个1就是新加的(i,k)这一对。空区间没有碱基,所以M为0;若没有合法伙伴,就只保留i不配对的情况。程序按区间从短到长计算,保证用到的小区间已经有答案,再沿保存的选择回溯出一张点括号结构。若多个方案同分,程序按固定顺序选择其中一个。
一个五碱基例子就能把计算说清楚。GAAAC只有首尾G与C满足允许配对及间隔条件,因此可以选择“.....”,得零分,也可以选择“(...)”,得一分。最大配对算法选择后者。对于GGGAAACCC,可以把三对嵌套起来,得到“(((...)))”与三分。分数描述的是本规则下的配对数量,并不是以焦耳或千卡计的实验自由能;详细能量模型需要给不同的堆积和环设置相应代价。
要从最优结构走向结构分布,可以给每张合法结构S一个权重。K(S)表示它的配对数,θ是预先设定的无量纲参数,权重取exp[θK(S)]。θ越大,增加配对带来的相对权重越高;θ=0时,所有合法结构权重相同。本例主实验固定θ=1,并把每张不同的二级结构作为一个计数状态。这样,概率含义完全由结构集合和权重规则决定,可以逐项验证。
Ω是全部合法结构的集合,Z是它们的权重总和,称为配分和。把某张结构的权重除以Z,得到概率P(S),所有概率相加为1。这个写法与统计物理中的玻尔兹曼分布有直接联系:若给每一对同样的能量降低ε,就可以令θ=ε/(kBT)。本节采用的是等配对权重的受控模型,真实RNA的环熵、堆积与溶液条件则需要更细致的自由能项来描述。
回到GAAAC,θ=1时,未配对结构的权重为1,配对结构的权重为e≈2.718,总和Z≈3.718。因此首尾配对的概率约为2.718/3.718=0.731,而不是每次都配对。这个小算例说明,“最大配对算法选中了它”和“体系始终只有它”是不同含义。前者寻找一个最大值,后者需要考察其他结构是否也有可观权重。
1990年,McCaskill在RNA配分函数与碱基配对概率研究中,将动态规划用于计算结构系综及局部配对概率。这使研究者能够从一张最优结构图转向观察备选结构及局部差异。本节沿用“分解区间并汇总权重”的思想,采用前面明确的简化权重,让初学者可以完整实现并检查每一步;原研究中的热力学模型具有更丰富的结构能量描述。
计算Z时仍然观察最左侧位置。若i不配对,贡献是剩余区间的Z;若i与k配对,就乘上这一对的权重eθ,再乘内部区间与右侧区间的配分和。两个子区间的选择可以组合,所以用乘法;不同k代表互不相同的配对选择,所以用加法。这样分解时,每张合法结构都按i的状态进入唯一一项,不会因组合顺序不同被重复计算。
这一次,空区间的Z必须设为1。原因是空区间有一种“什么都不放”的选择,其权重为e⁰=1;如果设成0,只要某一侧为空,整个乘积就会被错误地消掉。这里正好可以对照上一条公式:空区间的最大配对数为0,空区间的权重和为1,两个数回答的对象不同。理解初始条件为什么这样设,比照着程序记住一组常数更有用。
一条短RNA的许多种配对方式
当前显示最大配对数的一种结构;下方数值来自全部二十种合法结构的权重。
在默认的GGGAAACCC中,共有二十种合法结构:一张零配对、九张一配对、九张两配对和一张三配对。θ=1时,三配对结构的单张权重最大,但九张两配对结构合起来也占很大比例。按全部结构计算,平均配对数约为1.943,全链平均配对比例约为0.432。拖动θ后,程序会重新归一化这些结构;连续抽样则按当前概率独立抽取结构,帮助观察分布。
再把某一对位置(i,j)在各结构中出现的概率相加,便得到配对矩阵Pij。若只关心位置i是否配对,可以把它与所有伙伴的概率加起来,得到pi。一个位置在一张合法结构里最多有一个伙伴,因此这些事件互不重叠,直接相加便可得到总体配对概率。矩阵还记录伙伴是谁,逐位置向量则把伙伴身份汇总掉了,两者适合回答不同的研究问题。
指示函数在结构S含有(i,j)这一对时取1,否则取0。全链平均配对比例p̄再把全部pi求平均;每一对同时涉及两个位置,所以它等于平均配对数的两倍除以链长L。GAAAC首尾两个位置的概率都约0.731,中间三个位置为0,因此p̄≈2×0.731/5≈0.292。代码为更长序列计算相同的目标,这些无量纲概率就是接下来供神经网络学习的标签。
04让神经网络读取序列中的远近关系
规则模型给定后,可以为许多序列生成明确的监督信息。我们先生成不同长度、不同碱基比例以及不同连续重复程度的序列,再为每条序列制作一个保持组成不变的打乱版本。这样得到的成对样本拥有相同的A、C、G、U数量,却可能因排列不同而改变结构分布。这个设计承接《糖链:连接方式怎样改变水合、识别与支撑》的思想:如果要研究组织方式,数据里就要安排能够把组成与排列区分开的对象。
程序生成576条序列。其中480条长度为24、32或40,另外96条长度为56或64。原始序列与其打乱版本始终留在同一组;组成完全相同的记录,以及相同长度下逐位一致率达到80%的记录,也按连接关系合并成组。这个相似性规则适用于当前人工生成的数据,定义清楚了哪些对象要共同划分。较长序列全部留到最后评价,从一开始就不用于训练或选择模型。
短序列按组打乱后,得到288条训练、96条验证和96条测试记录,分别来自144、48和48个组;较长测试集另有48个组。训练集负责更新参数,验证集负责挑选保存的训练轮次,两个测试集在最终模型确定后评价。对于每条序列,规则算法计算所有位置的配对概率。数据生成、结构规则与组划分均固定随机种子,读者重新运行代码即可得到同一批输入和目标。
第一个参照只输出训练序列的平均配对比例。它不读取序列差别,因而在任何位置都给出同一个数。第二个模型更具体:每个位置输入自己的碱基类型、整条链的四种碱基比例、位置与边界信息,以及链长,再经过一个小型前馈网络预测配对概率。这样既给了模型基本化学身份,也给了它链的整体组成和端点线索,但没有让它逐个读取其他位置的碱基。
输入共十二个数字。当前碱基用四维独热向量表示,四种全链比例再占四维;位置比例(i−1)/(L−1)、距左端的倒数1/i、距右端的倒数1/(L+1−i)占三维,最后一维为L/40。这里i从1开始,40用于给长度选一个方便的数值尺度。若L=40、i=1,则位置比例为0,两个距离特征分别为1与1/40。所有输入都从序列本身计算,不使用目标配对概率。
要让一个位置知道远处具体有哪些碱基,可以引入序列注意力。它让每个位置产生一份“想查什么”的查询向量,同时让其他位置提供用于匹配的键向量和待传递的值向量。查询与键的匹配程度决定信息汇总时的权重,值向量承载实际传回的数值表示。可以把它想成阅读一篇文章时,当前词语需要回看前文的相关词,而不是永远只看固定宽度的邻近窗口。
RNA结构中的统计学习已有较长的研究历史。Do、Woods与Batzoglou在2006年的CONTRAfold研究中,通过条件概率模型学习结构评分参数,将结构特征与训练数据联系起来。2017年,Vaswani等人的Transformer研究进一步展示了以注意力为核心处理序列的方式。本节使用一个从头训练的小型注意力网络,考察它能否从核酸序列中提取对当前规则目标有用的信息。
在一个注意力头里,qi是位置i的查询,kj是位置j的键,vj是它提供的值。这些向量由可训练的线性变换产生。查询与键做内积,得到匹配分数;除以√d,是为了调整分数随向量维数增大而变化的尺度。随后取指数并除以有效位置上的指数总和,便得到总和为1的非负权重。最后用这些权重对值向量求和,形成新的位置表示。
V表示序列中真正存在的位置,补齐用的空位不进入分母。d是每个头的向量维数,本例为8。若某个查询对两个候选位置的缩放分数分别为0与ln 3,取指数后是1与3,归一化权重便为0.25与0.75。假设两个位置传来的值是标量2与6,加权结果就是0.25×2+0.75×6=5。真实模型对八维值向量执行相同运算,每个分量都按这套权重相加。
注意力权重与配对矩阵虽然都可以画成方格图,含义却不同。配对矩阵来自结构集合,一个位置最多选择一个伙伴,因此受到对称性和结构约束;注意力用于汇总信息,可以读取自身,也可以读取不能与当前碱基直接配对的位置。那些位置可能提供组成、端点或竞争结构的线索。把两者区分开,才能正确解释网络:它在学习怎样获取有用上下文,最终输出仍要与规则产生的pi比较。
本例先把十二维输入映射成三十二维表示,再经过两层注意力模块。每层有四个头,每头八维,让不同的映射学习不同的信息关系;还包含逐位置的前馈变换、残差连接和归一化。最后一层把每个位置的表示变成一个数,经sigmoid函数得到0到1之间的预测。位置组成网络有4641个参数,注意力网络有17537个参数,二者都从当前训练数据学习,没有调用预训练模型。
训练标签记录每个位置参与配对的概率。规则计算给出0.7、模型预测0.5时,平方误差为(0.5−0.7)²=0.04;预测0.8时,误差降为0.01。这里的0.7表示许多可能结构中有多大概率让这个位置配对,一张选定结构只能记录它当时配对或未配对。程序先在每条序列内部求平均,再对序列等权平均,让每条RNA各占一份权重。长度不同的序列装进同一个计算批次时会补齐空位,这些空位只是为了排成整齐的数组,既不作为注意力的有效键,也不进入损失的求和与分母。
Q是本次参与计算的序列数,Lq是第q条序列的真实长度,pq,i是规则目标,p̂q,i是模型预测。模型通过反向传播更新权重,使这一平均误差下降。两种网络各训练三个随机种子,每次最多八十轮;每轮检查验证集,保存误差较小的参数,若连续十二轮没有改善则提前结束。最终平均三个保存模型的预测,把初始化带来的变化也放进观察范围。
这里的学习任务可以理解为给一个明确的计算模型制作近似器。规则计算提供完整、可核对的监督目标,神经网络尝试从序列直接得到其中一种输出。它学会的是当前非交叉结构集合与权重规则下的配对倾向。要进一步研究真实RNA,可以用实验约束与更细的能量模型更新目标,再重新安排训练和评价。这样的衔接把“模型能算什么”与“下一步需要测什么”放到了同一条研究路线里。
05完整运行一次,观察模型学到了哪些规律
下面的程序从生成序列开始,完整计算结构目标、划分数据、训练两类网络并生成六幅图。它使用NumPy、PyTorch和Matplotlib,所有训练均在CPU上完成。规则计算中的区间在代码里采用Python常用的右端不包含写法,例如[i,j)包含i到j−1;正文公式则用两端都包含的i到j表示,两种写法对应同样的分解。输出文件保留全部序列、目标、预测、训练曲线与模型参数,便于逐条核对。
"""Learn per-position pairing probabilities from a controlled RNA model.
Install: python -m pip install numpy matplotlib torch
Generated teaching labels: noncrossing AU/CG/GU pairs, minimum enclosed positions 3,
equal dimensionless pair log-weight 1. No experimental RNA labels are used.
All sequence variants in one composition/similarity component stay in one split.
"""
from pathlib import Path
from collections import Counter
import time, json, math, copy
import numpy as np
import torch
from torch import nn

OUT=Path('rna_outputs');OUT.mkdir(exist_ok=True)
torch.set_num_threads(4);torch.set_num_interop_threads(1)
torch.use_deterministic_algorithms(True)
BASES='ACGU';ALLOWED={'AU','UA','CG','GC','GU','UG'}

def reference(s,theta=1.):
    n=len(s);z=np.eye(n+1);best=np.zeros((n+1,n+1),int);choice=np.full((n+1,n+1),-1,int)
    valid=np.array([[s[i]+s[j] in ALLOWED and j-i>=4 for j in range(n)] for i in range(n)])
    w=math.exp(theta)
    for length in range(1,n+1):
        for i in range(n-length+1):
            j=i+length;k=np.flatnonzero(valid[i,i:j])+i
            z[i,j]=z[i+1,j]+w*np.dot(z[i+1,k],z[k+1,j])
            best[i,j]=best[i+1,j]
            if len(k):
                scores=1+best[i+1,k]+best[k+1,j];q=int(np.argmax(scores))
                if scores[q]>best[i,j]:best[i,j]=scores[q];choice[i,j]=k[q]
    adj=np.zeros_like(z);adj[0,n]=1.;p=np.zeros((n,n))
    for length in range(n,0,-1):
        for i in range(n-length+1):
            j=i+length;k=np.flatnonzero(valid[i,i:j])+i;a=adj[i,j]
            adj[i+1,j]+=a
            p[i,k]+=a*w*z[i+1,k]*z[k+1,j]/z[0,n]
            adj[i+1,k]+=a*w*z[k+1,j];adj[k+1,j]+=a*w*z[i+1,k]
    p+=p.T;brackets=['.']*n
    def trace(i,j):
        if i>=j:return
        k=choice[i,j]
        if k<0:trace(i+1,j)
        else:brackets[i]='(';brackets[k]=')';trace(i+1,k);trace(k+1,j)
    trace(0,n)
    return {'p':p.sum(1).tolist(),'pair_matrix':p.tolist(),'structure':''.join(brackets),
            'log_Z':math.log(z[0,n]),'max_pairs':int(best[0,n])}

def generate():
    rng=np.random.default_rng(1111);rows=[]
    for length_class,number,lengths in [('short',240,[24,32,40]),('long',48,[56,64])]:
        for family in range(number):
            n=int(rng.choice(lengths));freq=rng.dirichlet(np.full(4,2.));stay=float(rng.choice([0.,.3,.6]))
            s=[str(rng.choice(list(BASES),p=freq))]
            for i in range(1,n):s.append(s[-1] if rng.random()<stay else str(rng.choice(list(BASES),p=freq)))
            # Composition-preserving sibling: change order while keeping every count.
            sibling=list(rng.permutation(s))
            for variant,letters in enumerate([s,sibling]):
                rows.append({'id':f'{length_class}-{family:03d}-{variant}','origin_group':f'{length_class}-{family:03d}',
                    'sequence':''.join(letters),'length':n,'length_class':length_class})
    # Merge generator siblings, exact compositions and high positional identity.
    parent=list(range(len(rows)))
    def root(i):
        while parent[i]!=i:parent[i]=parent[parent[i]];i=parent[i]
        return i
    def union(i,j):
        a,b=root(i),root(j)
        if a!=b:parent[max(a,b)]=min(a,b)
    groups={}
    for i,row in enumerate(rows):
        for key in [('origin',row['origin_group']),('composition',tuple(row['sequence'].count(a) for a in BASES))]:
            if key in groups:union(i,groups[key])
            else:groups[key]=i
    for n in sorted({r['length'] for r in rows}):
        ids=[i for i,r in enumerate(rows) if r['length']==n]
        matrix=np.array([list(rows[i]['sequence']) for i in ids])
        for j,i in enumerate(ids):
            same=np.mean(matrix[j+1:]==matrix[j],axis=1)
            for k in np.flatnonzero(same>=.8):union(i,ids[j+1+int(k)])
    components=sorted({root(i) for i,row in enumerate(rows) if row['length_class']=='short'})
    shuffled=np.random.default_rng(1112).permutation(components)
    split={int(c):('train' if j<int(.6*len(shuffled)) else 'validation' if j<int(.8*len(shuffled)) else 'test')
           for j,c in enumerate(shuffled)}
    for i,row in enumerate(rows):
        row['group']=root(i);row['split']='long_test' if row['length_class']=='long' else split[root(i)]
        row.update(reference(row['sequence']))
    return rows

def features(rows):
    nmax=max(r['length'] for r in rows);x=np.zeros((len(rows),nmax,12),np.float32)
    target=np.zeros((len(rows),nmax),np.float32);mask=np.zeros_like(target)
    for q,r in enumerate(rows):
        s=r['sequence'];n=len(s);one=np.eye(4)[[BASES.index(a) for a in s]]
        x[q,:n,:4]=one;x[q,:n,4:8]=one.mean(0);pos=np.arange(n)
        x[q,:n,8]=pos/max(1,n-1);x[q,:n,9]=1/(pos+1);x[q,:n,10]=1/(n-pos);x[q,:n,11]=n/40
        target[q,:n]=r['p'];mask[q,:n]=1
    return tuple(torch.from_numpy(v) for v in [x,target,mask])

class Learner(nn.Module):
    def __init__(self,kind):
        super().__init__();self.kind=kind
        self.embed=nn.Linear(12,32)
        if kind=='attention':
            block=nn.TransformerEncoderLayer(32,4,64,dropout=0.,batch_first=True,activation='gelu')
            self.context=nn.TransformerEncoder(block,2,enable_nested_tensor=False)
        else:self.context=nn.Sequential(nn.Linear(32,64),nn.GELU(),nn.Linear(64,32))
        self.head=nn.Linear(32,1)
    def forward(self,x,mask):
        h=torch.tanh(self.embed(x))
        if self.kind=='attention':h=self.context(h,src_key_padding_mask=~mask.bool())
        else:h=self.context(h)
        return self.head(h).squeeze(-1).sigmoid()


def fit(rows):
    x,y,mask=features(rows)
    groups={s:np.array([i for i,r in enumerate(rows) if r['split']==s])
            for s in ['train','validation','test','long_test']}
    tr,va=groups['train'],groups['validation']
    def mse(p,target,active):
        return (((p-target)**2*active).sum(1)/active.sum(1)).mean()
    base=float((y[tr].sum(1)/mask[tr].sum(1)).mean())
    predictions={'training_mean':np.full(y.shape,base)};runs={};weights={}
    for kind in ['position_composition','attention']:
        run_predictions=[];runs[kind]=[];weights[kind]=[]
        for seed in [11,21,31]:
            torch.manual_seed(seed);model=Learner(kind)
            optimizer=torch.optim.Adam(model.parameters(),lr=.003)
            order=np.random.default_rng(1113);best=1e9;stale=0;history=[];saved=None
            for epoch in range(1,81):
                model.train();permutation=order.permutation(tr)
                for start in range(0,len(tr),64):
                    ids=permutation[start:start+64];optimizer.zero_grad()
                    p=model(x[ids],mask[ids]);loss=mse(p,y[ids],mask[ids])
                    loss.backward();optimizer.step()
                model.eval()
                with torch.no_grad():
                    v=float(mse(model(x[va],mask[va]),y[va],mask[va]))
                    train=float(mse(model(x[tr],mask[tr]),y[tr],mask[tr]))
                history.append({'epoch':epoch,'training_MSE':train,'validation_MSE':v})
                if v<best-1e-8:
                    best=v;saved=copy.deepcopy(model.state_dict());stale=0;best_epoch=epoch
                else:stale+=1
                if stale>=12:break
            model.load_state_dict(saved);model.eval()
            with torch.no_grad():run_predictions.append(model(x,mask).numpy())
            runs[kind].append({'history':history,'best_epoch':best_epoch,
                'best_validation_MSE':best,'parameters':sum(p.numel() for p in model.parameters()),'seed':seed})
            weights[kind].append({k:v.tolist() for k,v in saved.items()})
            print(kind,'seed',seed,'selected epoch',best_epoch,'validation MSE',round(best,6),flush=True)
        predictions[kind]=np.mean(run_predictions,axis=0)
        for k,run in enumerate(runs[kind]):
            run['split_RMSE']={s:float(np.sqrt(np.mean([
                np.mean((run_predictions[k][i,:rows[i]['length']]-np.array(rows[i]['p']))**2)
                for i in ids]))) for s,ids in groups.items()}
    metrics={}
    for name,p in predictions.items():
        metrics[name]={}
        for split,ids in groups.items():
            errors=np.array([np.mean((p[i,:rows[i]['length']]-np.array(rows[i]['p']))**2) for i in ids])
            metrics[name][split]={'sequence_equal_RMSE':float(np.sqrt(errors.mean())),
                                  'sequence_errors':errors.tolist()}
    # Choose the first held-out 32-base sequence by ID, before looking at errors.
    example=min((i for i in groups['test'] if rows[i]['length']==32),key=lambda i:rows[i]['id'])
    for i,r in enumerate(rows):
        r['predictions']={k:p[i,:r['length']].tolist() for k,p in predictions.items()}
    results={'scope':'controlled noncrossing RNA ensemble; generated labels, no experimental labels',
        'theta':1.,'minimum_enclosed_positions':3,'allowed_pairs':sorted(ALLOWED),
        'seeds':[11,21,31],'generator_seed':1111,'split_seed':1112,
        'split_rule':'Generator siblings, equal A/C/G/U counts, or >=80% same-position identity at equal length are joined before group split; 56/64 bases reserved for long_test.',
        'metrics':metrics,'runs':runs,'weights':weights,'example_id':rows[example]['id'],
        'example_pair_matrix':rows[example]['pair_matrix'],
        'split':{s:{'rows':len(ids),'groups':len({rows[i]['group'] for i in ids}),
                    'lengths':sorted({rows[i]['length'] for i in ids})} for s,ids in groups.items()}}
    for name,m in metrics.items():
        print(name,{s:round(v['sequence_equal_RMSE'],5) for s,v in m.items()},flush=True)
    samples={'rows':[{k:v for k,v in r.items() if k!='pair_matrix'} for r in rows],
             'label_scope':results['scope']}
    (OUT/'results.json').write_text(json.dumps(results,indent=2),encoding='utf-8')
    (OUT/'samples.json').write_text(json.dumps(samples,separators=(',',':')),encoding='utf-8')
    plots(results,samples)
    print('Example:',results['example_id'],'; six panels and all targets/predictions saved.')

def plots(results,samples):
    import matplotlib
    matplotlib.use('Agg')
    import matplotlib.pyplot as plt
    plt.rcParams.update({'font.family':'DejaVu Sans','font.size':11,'axes.spines.top':False,
        'axes.spines.right':False,'axes.labelcolor':'#273b36','text.color':'#273b36',
        'svg.hashsalt':'ai4s-L11','savefig.facecolor':'#fffdf8'})
    rows=samples['rows'];names=['training_mean','position_composition','attention']
    labels=['Training mean','Base + composition + position','Sequence attention']
    colors=['#a39372','#5c7899','#267b69']
    example=next(r for r in rows if r['id']==results['example_id'])
    def panel(ax,key):
        if key=='sequence':
            xx=np.arange(1,example['length']+1)
            ax.plot(xx,example['p'],color='#202f29',lw=2,label='Exact rule-model target')
            for k,c,label in zip(names,colors,labels):
                ax.plot(xx,example['predictions'][k],color=c,lw=1.4,label=label)
            ax.set(xlabel='Position / 1-based',ylabel='Probability of being paired',
                   xlim=(1,example['length']),ylim=(-.02,1.02))
            ax.set_title('A  '+example['id']+': predict a marginal probability',pad=52)
            ax.legend(frameon=False,fontsize=8,loc='lower left',bbox_to_anchor=(0,1.01),ncol=2)
        elif key=='pairs':
            matrix=np.array(results['example_pair_matrix'])
            im=ax.imshow(matrix,origin='lower',cmap='YlGnBu',vmin=0,vmax=float(matrix.max()),
                         extent=(.5,len(matrix)+.5,.5,len(matrix)+.5))
            ax.figure.colorbar(im,ax=ax,label='Rule-model pairing probability',shrink=.8)
            ax.set(xlabel='Partner position j',ylabel='Position i',
                   title='B  Exact partner probabilities for the same sequence')
            ax.grid(False);return
        elif key=='length':
            lengths=[24,32,40,56,64]
            for k,c,label in zip(names,colors,labels):
                vals=[]
                for n in lengths:
                    selected=[r for r in rows if r['length']==n and r['split'] in ['test','long_test']]
                    vals.append(np.sqrt(np.mean([np.mean((np.array(r['predictions'][k])-r['p'])**2) for r in selected])))
                ax.plot(lengths,vals,'o-',c=c,label=label)
            ax.axvspan(48,68,color='#eadbc7',alpha=.45)
            ax.text(60,.265,'Lengths not used\nin training',ha='center',fontsize=9)
            ax.set(xlabel='Sequence length / bases',ylabel='Equal-sequence RMSE',
                   xlim=(21,68),ylim=(0,.31),xticks=lengths,title='C  Held-out sequences and held-out lengths')
            ax.legend(frameon=False,fontsize=8,loc='upper left')
        elif key=='learning':
            for run,c in zip(results['runs']['attention'],['#267b69','#587fa0','#c17a53']):
                h=run['history'];xx=[v['epoch'] for v in h]
                ax.plot(xx,[v['validation_MSE'] for v in h],c=c,label=f'Validation, seed {run["seed"]}')
                ax.plot(xx,[v['training_MSE'] for v in h],c=c,ls=':',alpha=.7)
                ax.scatter([run['best_epoch']],[run['best_validation_MSE']],c=c,s=40)
            ax.set(xlabel='Epoch',ylabel='Equal-sequence mean squared error',
                   title='D  Three actual attention-model training runs')
            ax.legend(frameon=False,fontsize=8);ax.text(.02,.03,'Dotted: training; dots: saved checkpoints',transform=ax.transAxes,fontsize=8)
        elif key=='data':
            splits=['train','validation','test','long_test'];counts=np.zeros(6)
            for split,c in zip(splits,['#267b69','#9bbca8','#5c7899','#c9a47b']):
                values=np.array([sum(r['length']==n and r['split']==split for r in rows) for n in [24,32,40,48,56,64]])
                ax.bar(range(6),values,bottom=counts,color=c,label=split,width=.65);counts+=values
            ax.set_xticks(range(6),[24,32,40,48,56,64])
            ax.set(xlabel='Sequence length / bases',ylabel='Number of sequences',ylim=(0,220),
                   title='E  Whole components stay in one split')
            ax.legend(frameon=False,fontsize=9)
        else:
            pairs=[]
            for origin in sorted({r['origin_group'] for r in rows if r['split']=='test'}):
                siblings=sorted([r for r in rows if r['origin_group']==origin],key=lambda r:r['id'])
                if len(siblings)==2:pairs.append(siblings)
            actual=np.array([np.mean(b['p'])-np.mean(a['p']) for a,b in pairs])
            extent=max(.02,float(np.max(abs(actual))))*1.2
            lo=-extent;hi=extent;ax.plot([lo,hi],[lo,hi],c='#b2b5a7',ls='--')
            for k,c,label in zip(names[1:],colors[1:],labels[1:]):
                predicted=[np.mean(b['predictions'][k])-np.mean(a['predictions'][k]) for a,b in pairs]
                ax.scatter(actual,predicted,c=c,s=30,alpha=.65,label=label)
            ax.set(xlim=(lo,hi),ylim=(lo,hi),xlabel='Rule target change in mean paired fraction',
                   ylabel='Predicted change after shuffling',title='F  Keep composition; rearrange the sequence')
            ax.legend(frameon=False,fontsize=8,loc='upper left')
        ax.grid(alpha=.14)
    keys=['sequence','pairs','length','learning','data','shuffle']
    for key in keys:
        fig,ax=plt.subplots(figsize=(7.7,5.6),layout='constrained',facecolor='#fffdf8');panel(ax,key)
        fig.savefig(OUT/(key+'.svg'),metadata={'Date':None});plt.close(fig)
    fig,axes=plt.subplots(3,2,figsize=(16,18),layout='constrained',facecolor='#fffdf8')
    for ax,key in zip(axes.flat,keys):panel(ax,key)
    fig.savefig(OUT/'rna_learning.svg',metadata={'Date':None})
    fig.savefig(OUT/'rna_learning.png',dpi=160,metadata={'Software':'Matplotlib'});plt.close(fig)

def main():
    rows=generate()
    print('Generated',len(rows),'sequences; rule-model targets and whole-component splits.')
    fit(rows)

if __name__=='__main__':main()
本次实际运行输出
Generated 576 sequences; rule-model targets and whole-component splits.
position_composition seed 11 selected epoch 78 validation MSE 0.011367
position_composition seed 21 selected epoch 80 validation MSE 0.01148
position_composition seed 31 selected epoch 78 validation MSE 0.011343
attention seed 11 selected epoch 80 validation MSE 0.011142
attention seed 21 selected epoch 80 validation MSE 0.010129
attention seed 31 selected epoch 80 validation MSE 0.01005
training_mean {'train': 0.23747, 'validation': 0.23194, 'test': 0.23921, 'long_test': 0.22921}
position_composition {'train': 0.10329, 'validation': 0.10589, 'test': 0.10202, 'long_test': 0.0997}
attention {'train': 0.09, 'validation': 0.09964, 'test': 0.08961, 'long_test': 0.08559}
Example: short-019-0 ; six panels and all targets/predictions saved.
A图选择测试集中按编号排在最前的三十二碱基序列,选择规则在查看误差之前确定。黑线是动态规划给出的逐位置配对概率,棕色水平线是训练均值,蓝线与绿线分别为位置组成网络和注意力网络。三条模型线都对应同一个学习目标。曲线的起伏让我们看到,一条链内部不同位置的行为并不均匀;只用一个全链平均数,无法保留这些局部差别。
B图展示同一条序列的规则配对矩阵。横纵轴都表示位置,颜色较深的格子说明这一对位置在结构分布中出现得更频繁。矩阵关于对角线对称,因为i与j配对和j与i配对是同一个事件;对角线为0,因为位置不能与自身配对。将某一行所有格子的数值相加,就得到A图黑线在该位置的高度。若一行有多个较浅的格子,总和也可能较大,表示它经常配对,但伙伴有不同选择。
C图比较不同长度下的误差。我们仍然先对每条序列内部平均平方误差,再对该长度的测试序列平均,最后开方。这一口径与训练时的序列等权原则一致,数值回到概率偏差的尺度。图中24、32、40来自未参与训练的短序列组,56与64来自单独保留的长序列组;底色把后一种长度检验标出来,帮助读者分清新序列与新长度两种变化。
例如两条序列的平均平方误差分别为0.01与0.04,等权平均后为0.025,开方得到约0.158。Q是当前评价的序列数,Lq始终使用各条序列自己的真实长度。本次短序列测试集上,训练均值、位置组成网络与注意力网络的误差分别为0.2392、0.1020和0.0896;长序列测试集中,后两种网络分别为0.0997和0.0856。这些数值描述本节生成分布与规则目标下的结果。
一次运行 · 六幅结果图
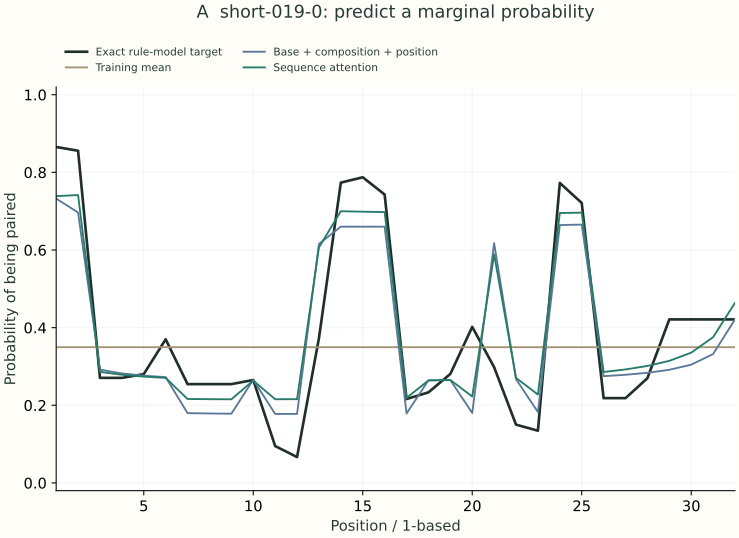
A|同一条留出序列的逐位置配对概率:规则精确值、训练均值、位置组成网络和注意力网络。
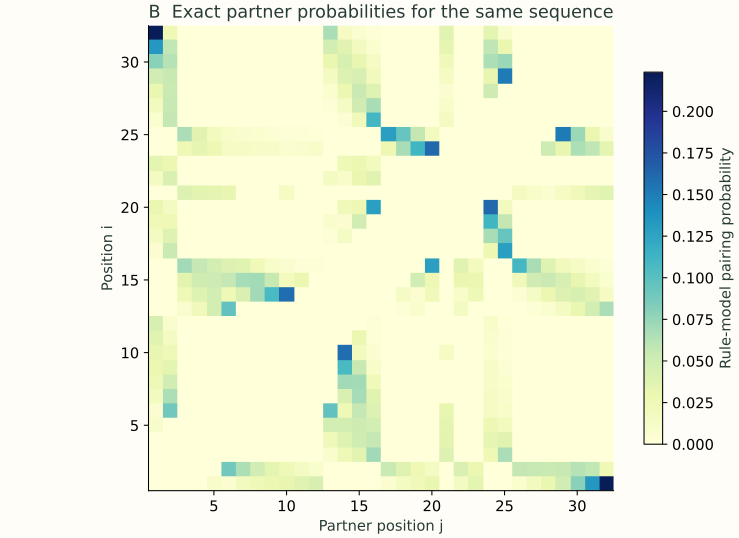
B|同一序列的规则配对矩阵。每行求和得到A图黑线,矩阵保留伙伴身份。
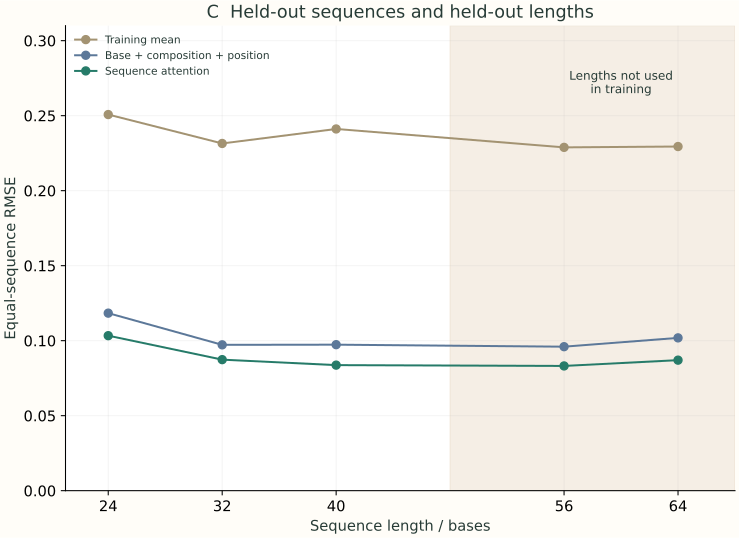
C|在24、32、40碱基的新序列,以及56、64碱基的新长度上计算序列等权误差。
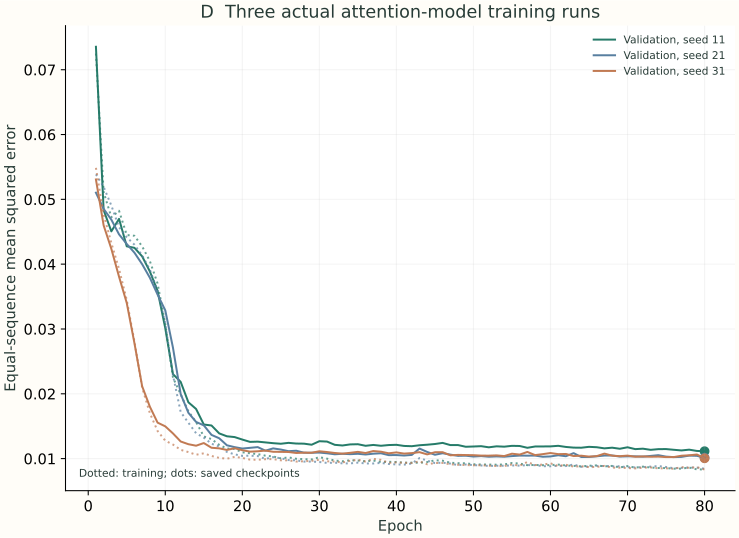
D|三个随机种子的注意力网络实际训练曲线。保存轮次由验证误差决定。
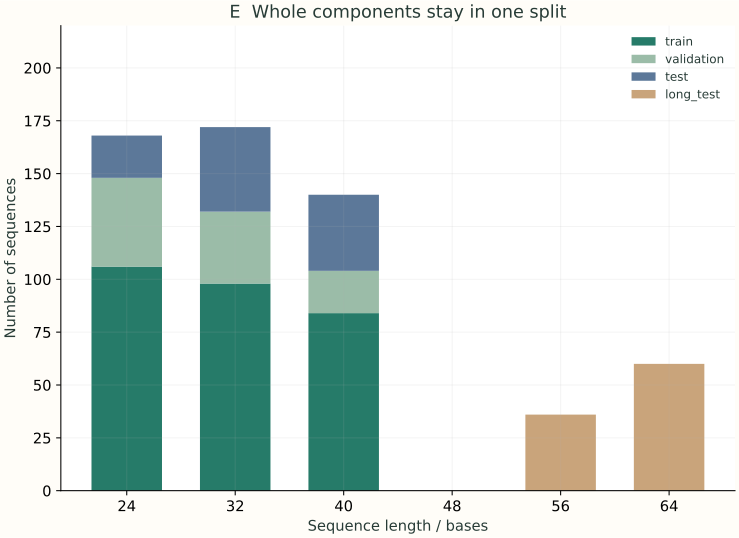
E|生成序列按长度与用途分布;同组成和相关变体保持同组,长序列单独留出。
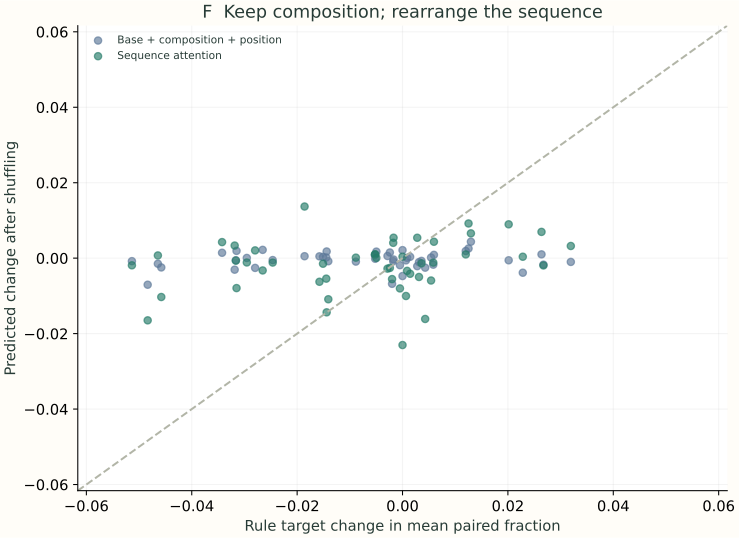
F|同组成序列打乱前后的平均配对比例变化。横轴来自规则,纵轴来自模型预测。
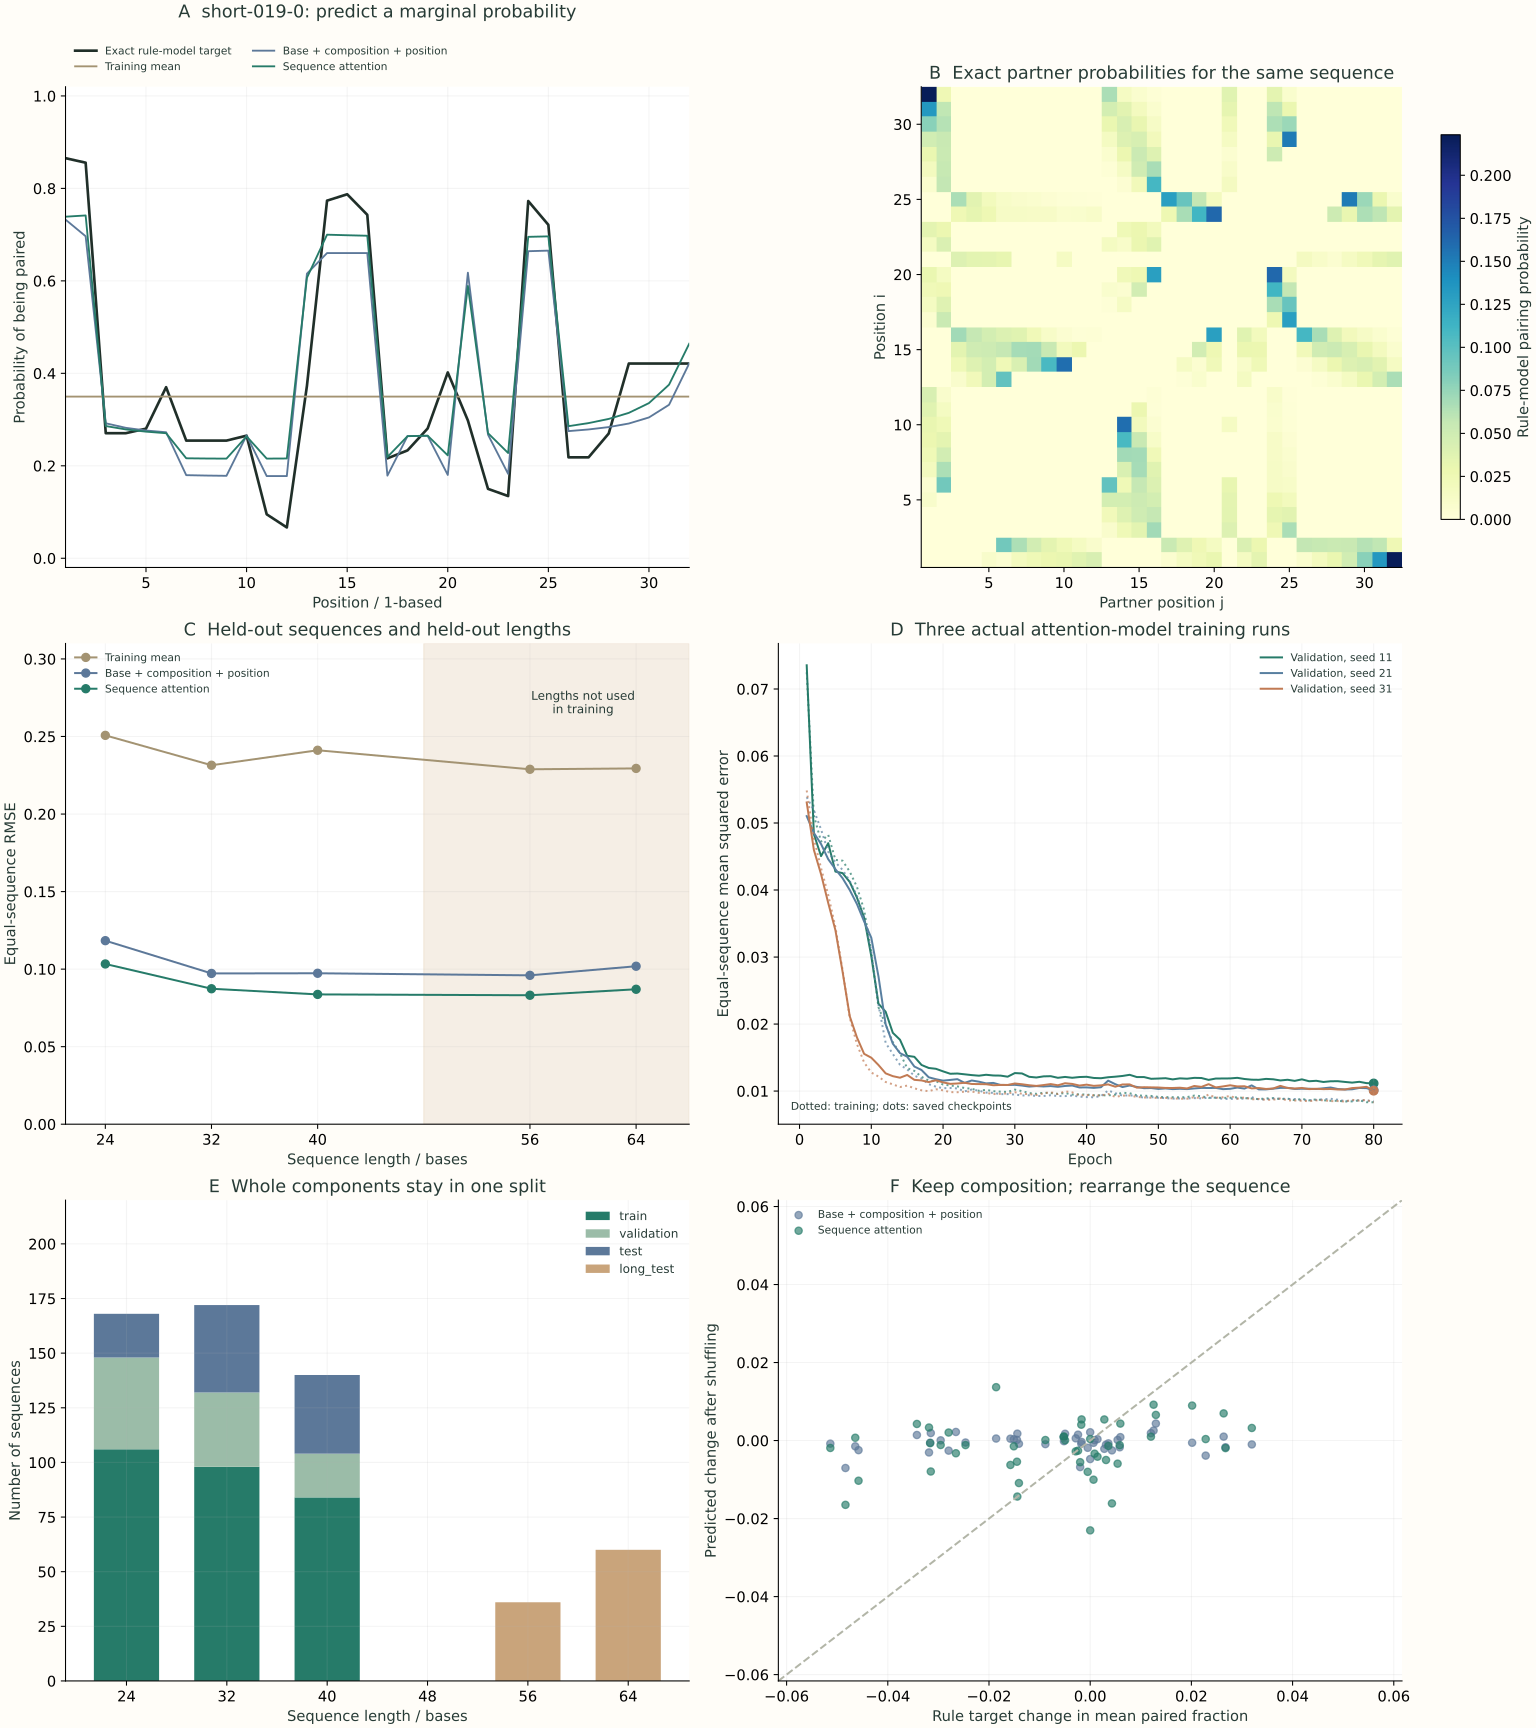
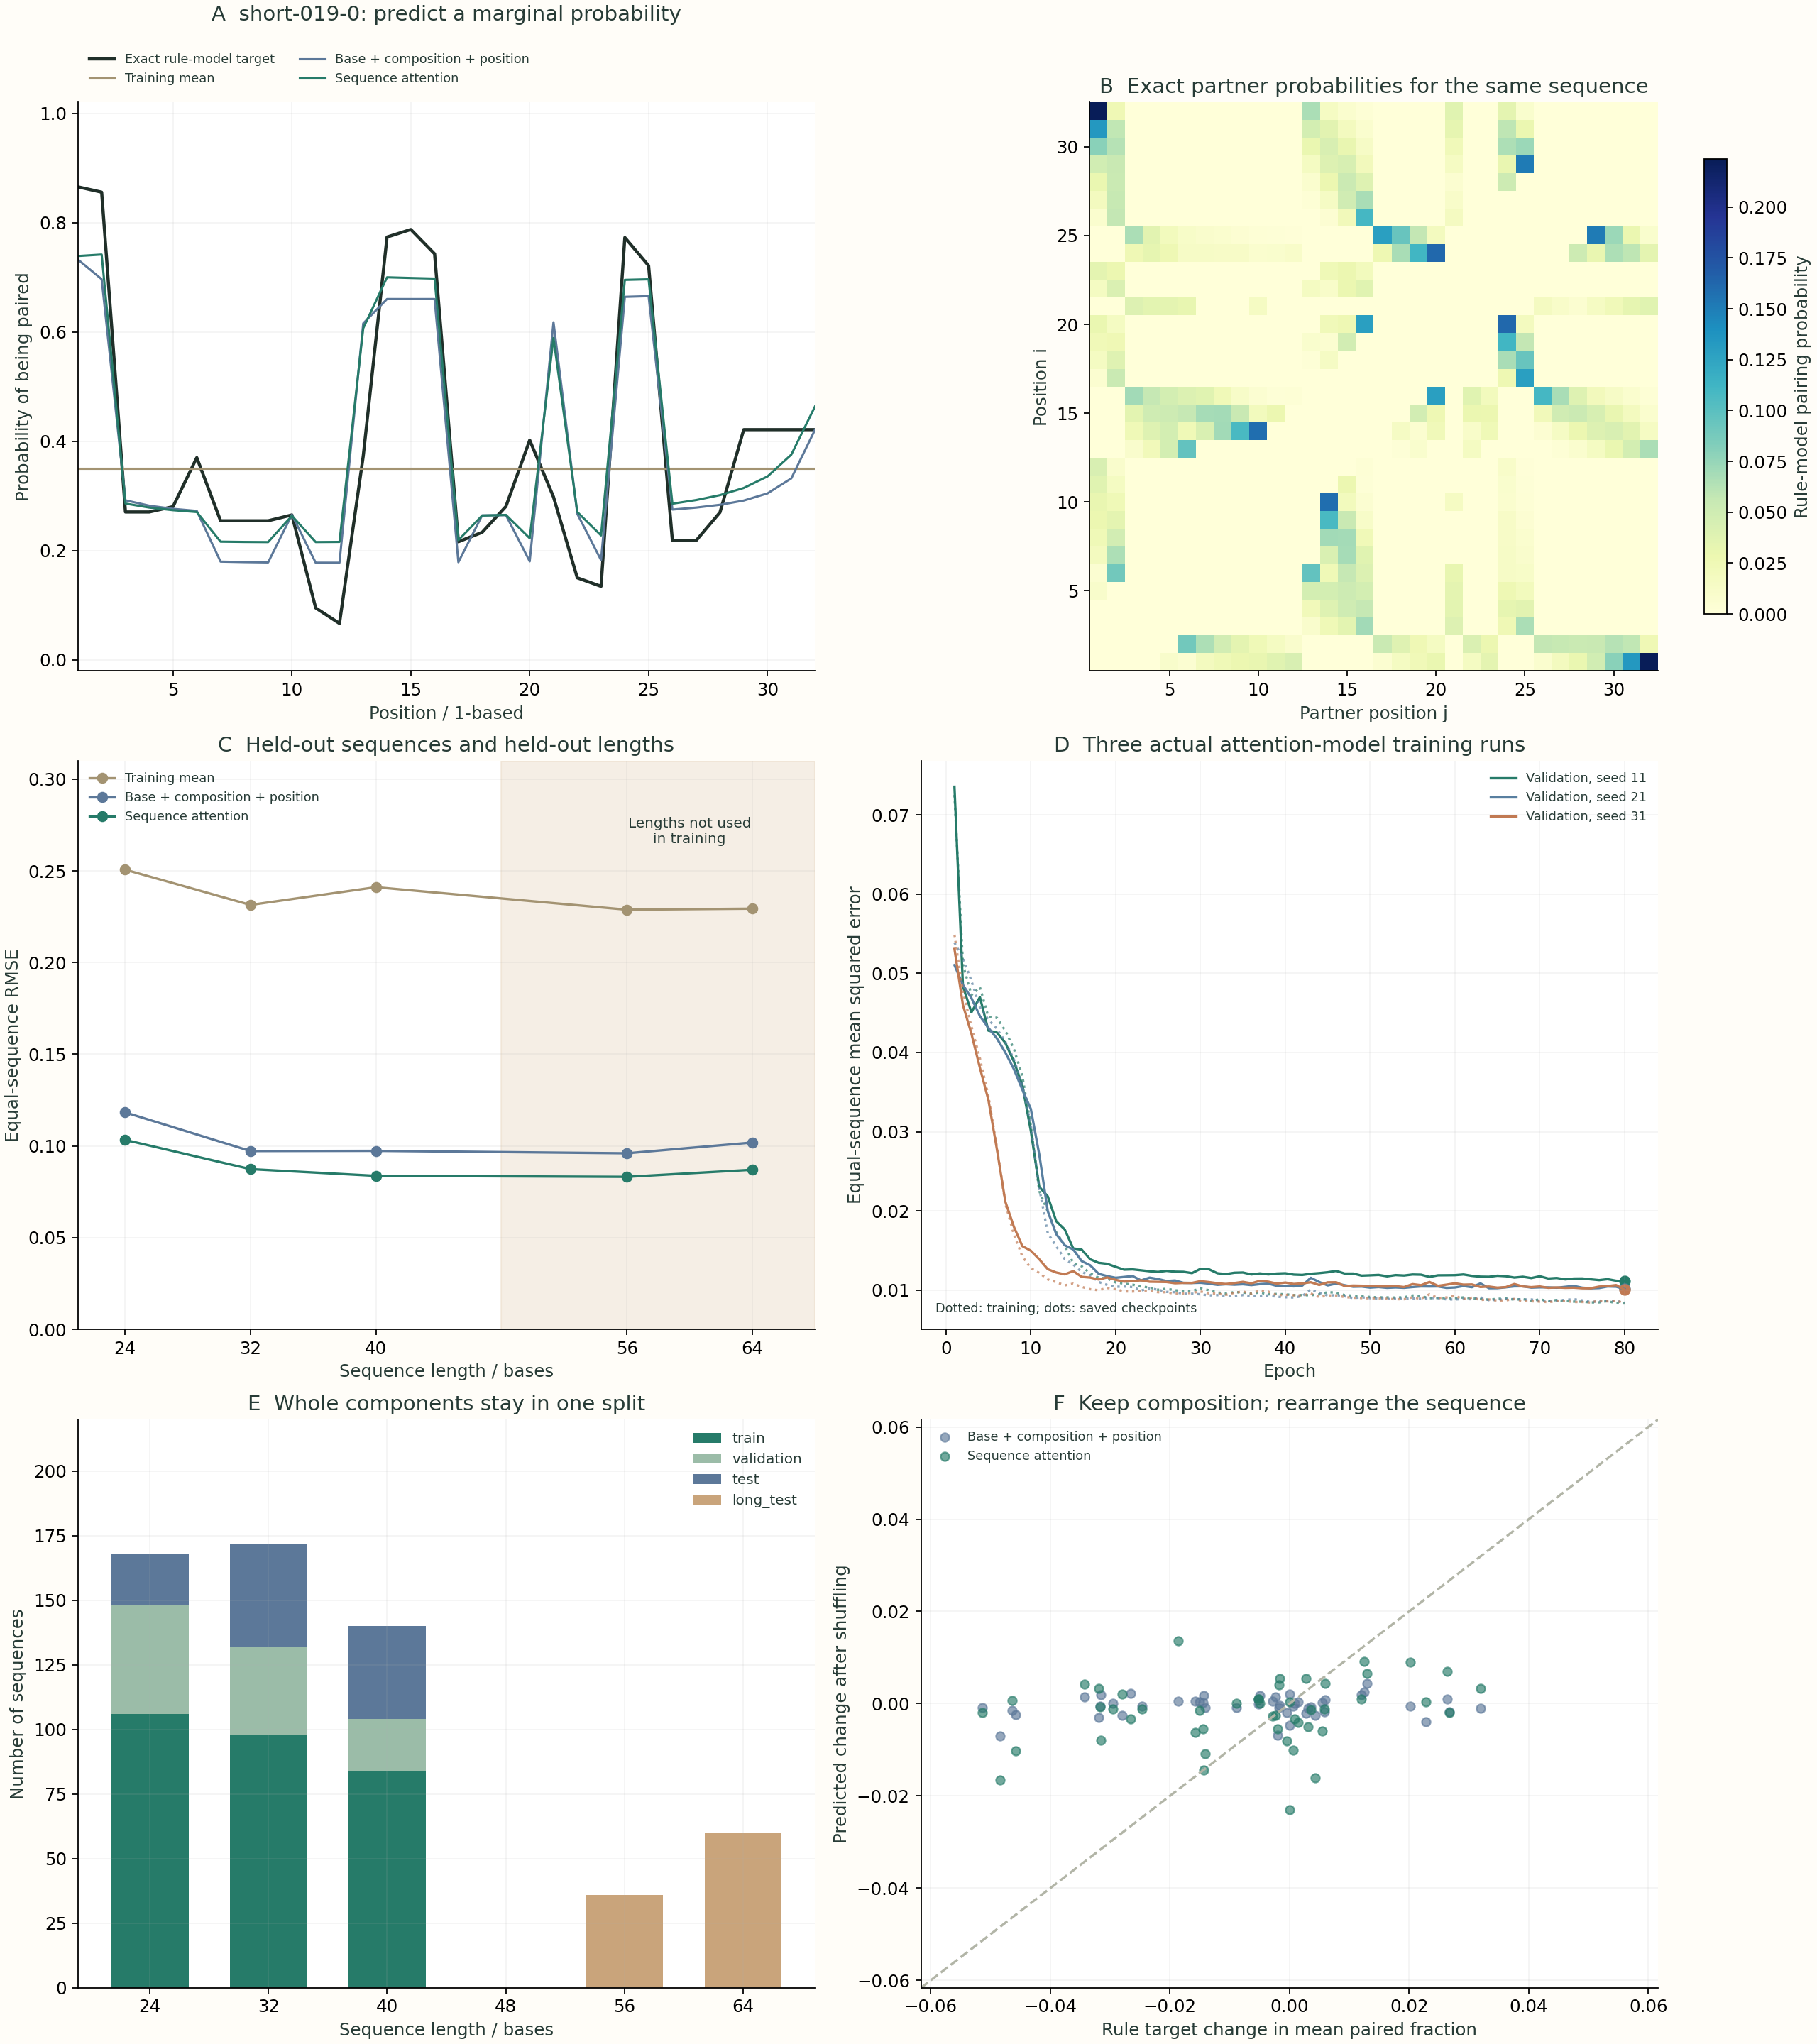
最明显的改善来自给每个位置提供碱基身份、全链组成和端点信息:它们已经能够解释配对概率中的相当一部分变化。加入序列注意力后,当前两组测试的平均误差继续减小,说明读取其他位置的表示又提供了帮助。长序列组的平均误差略小于短序列组,需要结合具体生成分布理解;两组样本并非同一批对象,不能把这一数值顺序直接解释成序列越长越容易预测。
D图保留了三个注意力模型的实际训练过程。实线为每轮结束后的验证误差,点线为训练误差,圆点标出最终保存的轮次。这次三个种子都在八十轮训练范围的最后一轮取得各自最低验证值。它说明当前运行仍有明确的训练预算边界,也给读者留下一个可以研究的问题:增加训练轮次或改变结构表示,会怎样影响新的验证对象?这类选择应继续由验证数据支持,再安排新的测试。
平均三个模型可以减小一部分初始化波动,但还应看各次训练本身。三个注意力模型在短序列测试集上的误差约为0.0935、0.0953和0.0894,在长序列测试集上约为0.0873、0.0943和0.0891。平均预测后的误差分别约为0.0896和0.0856。平均的是每个位置的预测概率,并非先把三个误差相加除以三;平方误差是非线性的,两种计算通常得到不同结果。
E图把长度和划分直接画出来。训练与验证都使用24、32、40三种长度,48的位置留空,56和64只出现在长序列测试中。来自同一起始序列的版本都以组为单位保留,因此一个序列及其打乱版本不会分别落入训练和测试。这张图让读者看到模型究竟获得过哪些长度与多少条序列,也明确了当前结果已经在哪些输入范围内接受评价。
F图进一步检查排列的作用。每个点对应一对组成相同的短测试序列,横轴是打乱后规则平均配对比例的变化,纵轴是模型预测的相应变化。靠近对角线表示变化幅度也被较好地预测。图中一些横轴变化已经较明显的对象,纵轴仍接近0,说明当前学习器对这类整体变化响应较小。这个观察与逐位置平均误差一起看,能把“预测大部分位置的常见倾向”与“敏感地识别排列扰动”区分开。
如果下一步特别关心排列扰动,就可以为它设计更直接的学习目标。例如,在保留当前基础任务的同时,增加同组成变体之间配对比例差的训练项,或者让模型进一步输出受结构约束的伙伴矩阵。新的数据划分仍需将相关变体放在一起,并保留一组新的排列方式用于评价。这样,F图提出的问题就能转成具体的方法改进,而不是只要求网络更大或训练更久。
还可以从一个很小的手算练习开始:把交互中的GGGAAACCC改为同组成的GCGACAGAC,比较最大配对数、合法结构数和平均配对比例。三种碱基的数量没有改变,但允许的连接位置与嵌套关系变了。再回看A图和F图,就能理解为什么核酸AI需要同时处理化学身份、顺序和结构约束。这里每一步都能由一个明确的小例子走到可运行的程序,再走到留出数据中的评价。
当这一流程用于实际研究,最先需要补齐的是目标对应的证据:实验记录了哪种环境、哪些位置有结构约束,以及希望预测的是配对、暴露程度还是功能读数。明确这些内容后,规则计算可以提供结构先验,机器学习可以从数据中调整表示或评分,实验则继续检验候选。核酸的方向和互补性提供了设计基础,而把结构分布与学习输出分清楚,能让AI在这条研究链中承担具体、可验证的工作。
资料与延伸阅读
Franklin与Gosling,1953,Molecular Configuration in Sodium Thymonucleate;Watson与Crick,1953,A Structure for Deoxyribose Nucleic Acid。Rothemund,2006,Folding DNA to create nanoscale shapes and patterns,原文可从作者实验室阅读。历史图中的链、衍射与折纸轮廓均为解释研究思路而绘制的概念示意。
Nussinov与Jacobson,1980,RNA二级结构的快速算法;McCaskill,1990,RNA二级结构的配分函数与碱基配对概率。本节使用明确列出的非交叉配对与等权重规则生成教学标签,所有数据来自该受控模型。图中配对矩阵、概率曲线与学习结果由同页代码实际计算。
Do、Woods与Batzoglou,2006,CONTRAfold;Vaswani等,2017,Attention Is All You Need。本节的注意力网络从头训练,用于近似逐位置配对概率;完整结构规则、训练设置和各次训练结果均在代码与可下载数据中保留。