从构象照片走向带时间的分子轨迹
高分子链动力学:Rouse模型、扩散与松弛
把一根软绳分别放进水和较黏的糖浆,轻轻拨动后,它们恢复形状的快慢会不同。绳子的连接没有变,周围流体对运动的阻碍却变了。分子尺度也存在这样的区别:两条链可以有相近的平均尺寸,却需要很不一样的时间才能重新安排姿势。本节给前面讨论的构象加上时间,理解链怎样扩散、哪些形变消退得快,以及AI能从一小段过去推断怎样的未来。
时间尺度直接影响研究中的观察方式。记录分子时,相机间隔过长,快速运动会在两帧之间消失;模拟一条很慢的链时,密集保存许多帧,得到的也可能只是同一段缓慢变化的重复记录。我们将运行一批独立的链轨迹,让模型利用过去8次观测预测不同时间以后的状态,同时用已知的物理关系计算参照。读完这一节,就能把“预测得准不准”与“观察了什么、隔多久观察、要预测多远”放到一起判断。
01给构象加上一条时间线
《高分子链的舒展与塌缩:排除体积和吸引作用》的滑块改变环境参数后,程序立即重新计算了平衡构象的概率。这回答的是一个统计问题:如果在新条件下观察足够久,各种姿势大致会以什么比例出现。真实分子则需要通过连续运动才能走到这些姿势。它可能先转动一小段,再带动邻近部分,经过许多局部调整,整体才发生明显变化。因此,平衡分布描述“长期怎样分配”,动力学描述“分配怎样随时间建立”,两类信息互相衔接,却各自包含新的内容。
一个熟悉的类比是给班级重新安排座位。最终座位表只告诉我们每个人坐在哪里;实际换座位时,过道是否拥挤、需要搬多少东西、前面的人是否已经让开,都会影响完成速度。同样,分子链最终的构象机会由能量与熵共同决定,而从一种构象移动到另一种构象,还受到摩擦、连接和空间通道的影响。即使最终统计尺寸相似,改变这些运动条件,也可以让过程明显加快或减慢。
我们把一段持续观测称为轨迹。轨迹可以记录所有珠子的三维坐标,也可以只记录一个量,例如链的末端向量、回转半径,或者两个标记点之间的距离。记录中除了数值,还需要时间间隔Δt:连续两行相差一微秒,与相差一秒,代表完全不同的过程。若数据表只保留坐标却丢掉时间单位,后面即使画出一条很平滑的曲线,也无法从中解释真实的运动速度。
轨迹里常见两种同时存在的变化。施加一个外部扰动后,原先偏离平衡的整体形变会逐渐减弱,这称为松弛;与此同时,热运动不断引入新的局部起伏。拉开一条链再松手,可以看到伸展趋势消退,但链不会从此固定在某个标准姿势。它会进入一个持续变化的平衡系综。《高分子链的舒展与塌缩:排除体积和吸引作用》的构象概率于是以新的方式出现:足够长的轨迹在各种姿势中停留的比例,与相应的平衡统计联系起来。
1994年,Perkins、Quake、Smith与Chu用荧光显微成像观察单个DNA分子:借助光镊操控连接DNA的微珠,用流动拉展开分子,再在停止流动后记录其松弛。研究把以往常由整体材料响应推断的过程,转成了一段可观察的单分子变化,并考察了回复时间与分子长度的关系。这项原始研究让“链需要多久才能改变状态”成为能够逐帧追踪的问题。
看这样的分子电影时,最容易注意到的是线条如何移动;真正用于分析的,却往往是从每一帧提取的少数观察量。我们可以沿拉伸方向测量投影,也可以记录整条链最远两点的间距。不同观察量会突出不同的运动过程:整体平移可能让所有珠子坐标都变了,却不改变链的内部形状;局部回转可能显著移动一个标记点,却只轻微改变回转半径。选择观察量,就是选择这部电影中要追踪的物理内容。
本节的学习实验记录末端向量在x方向上的分量。取最后一个珠子的x坐标减去第一个珠子的x坐标,就得到一个可正可负的数。正值表示末端偏向+x,负值表示偏向−x,接近零则表示这个方向上的投影较小。它与始终非负的末端距离不同。使用带符号的分量有一个好处:在没有外力、各方向等价的平衡系综中,它的平均值为零,而随时间的正负变化仍然保留了链的方向与形变信息。
为了先把这种联系看清,我们采用一个能精确计算时间更新的高斯珠—弹簧模型。它将一段较粗尺度的链表示为珠子与有效连接,连接长度允许涨落,珠子分别受到摩擦和热碰撞。后面的代码从这个模型生成全部轨迹,前面的DNA实验则提供研究问题的历史背景。模型与实验之间的桥梁是观察量和时间关系:选定对象后,可以比较相同测量定义下的轨迹、分布与相关性,再决定需要加入哪些实际分子机制。
02热碰撞与阻力怎样配合
把一个小珠子放进流体,它会不断受到周围分子的碰撞。短时间内,各个方向的撞击不会恰好抵消,因此珠子会发生不规则位移。若许多相同珠子从同一位置出发,它们向左和向右运动的机会相同,平均位移可以接近零,但散开的范围会越来越大。用平均位移判断运动强弱,会把这些正负变化抵消掉;将位移平方以后再平均,就能保留它们的大小。
流体同时阻碍运动。在速度足够低、可以忽略惯性的描述中,阻力的大小与速度成正比,比例系数记作ζ,希腊字母zeta。它的单位是力除以速度,也就是kg/s。热能kBT提供运动的能量尺度,ζ描述把运动传给周围流体有多困难。两者的比值给出自由粒子的扩散系数D,单位是长度平方除以时间。扩散越快,同一时间内位移平方的平均值越大。
这里先写一个坐标方向的运动。ξ读作xi,是均值为0、方差为1的标准正态随机数;程序每推进一步,就重新抽取一个独立ξ。乘在它前面的平方根决定这一步位移的典型大小。因为ξ的平方平均为1,位移平方的平均便是2DΔt。这一步也解释了为什么时间间隔放在平方根里:扩散的方差随时间线性增长,而典型距离随时间的平方根增长。
例如,为一个教学粒子设D=0.1微米²/秒,经过1秒,一维均方根位移是√0.2微米,约0.447微米。经过4秒,它变为√0.8微米,约0.894微米,只增大到两倍。时间增加四倍、距离增加两倍,是随机方向不断相互抵消后的结果。若三个坐标方向独立且扩散系数相同,三个方向的位移平方相加,三维均方位移就是6DΔt。因而读取公式或实验报告时,要先确认讨论的是一个投影还是完整三维位移。
这与匀速走路很不一样。匀速运动在一段时间内持续朝同一方向积累位移,距离正比于时间;扩散则不断改变方向,新增的一步可能延续原来的偏离,也可能把粒子带回去。把一条随机轨迹放大到很短的时间范围,常会看到某几步碰巧朝同一方向前进。要判断扩散规律,需要比较许多独立轨迹,或者使用足够长、并考虑相关性的时间记录,让偶然的局部排列与整体统计分开。
连接成链以后,珠子还会受到邻居的力。我们用M表示珠数,因而相邻连接共有M−1个,珠子编号从0到M−1。连接能写成相邻位置差的平方和,每个平方前乘刚度ks的一半。这个模型中的连接是粗粒化后的高斯连接,零距离处的能量最低,平衡下的非零平均尺寸来自三维空间中的热涨落。它描述许多微观构象汇总后的有效弹性,而不是把一个真实化学键的平衡长度设为零。
r⃗i表示第i个珠子的三维位置,竖线平方表示位置差的三个分量分别平方后相加。对内部珠而言,右边连接提供指向右邻居的力,左边连接提供指向左邻居的力,两者相加就得到第二行。若两个邻居恰好分布在它两侧的对称位置,合力为零;若珠子偏离两者中点,合力会把它拉向中点。端点只有一个邻居,计算时只保留那一条连接,因而不会凭空增加一个固定边界。
从单位也能检查这条关系。ks是能量除以长度平方,乘位置差以后,得到能量除以长度,也就是力。忽略惯性后,力除以摩擦系数给出确定性的移动速度;热碰撞再在这个趋势上叠加随机位移。两部分必须配套:摩擦改变运动响应,也影响热随机位移的幅度。只减小确定性运动而保持原来的噪声强度,会改变模型最终达到的统计分布。
本节选择的单位使计算更简洁。用b₀表示平衡下一个高斯连接的均方根长度,用kBT₀作为能量单位,用ζ₀作为参考摩擦单位,则时间单位t₀=ζ₀b₀²/(kBT₀)。程序将这三个参考量的数值都设为1,并设ks=3,这样三个方向的连接涨落合起来恰好给出均方连接长度1。输出中的0.5t₀是一段已经定义好的模型时间;为具体体系确定b₀、温度和参考摩擦后,便能进一步换算成秒。
还可以从合力看出整体平移的性质。把所有珠子的内部连接力相加,每条连接在两个端点上施加的力大小相同、方向相反,最终互相抵消。整条链的质心因此能够在热运动下扩散,而内部形变会受到连接约束。对于每珠摩擦相同且彼此独立的本模型,整体摩擦为Mζ,质心扩散系数为kBT/(Mζ)。链更长时,移动整个质心涉及更多摩擦,整体扩散随之变慢。
03一条链为什么有许多速度
一条珠—弹簧链的各个珠子彼此相连,直接追踪每个珠子容易让人觉得运动十分复杂。另一种看法是把形状拆成几种共同变化的方式:有的让整条链缓缓弯曲,有的只让相邻几段交替偏移。这些方式称为模式。类似一条皱起的床单,既有覆盖整张床的大褶皱,也有局部的小褶皱;描述每个模式的强弱,就能重新组合出完整形状。
Rouse在1953年建立的经典链动力学描述,以有效弹性连接、每个珠子的摩擦与热运动为基础。1956年,Zimm进一步考虑了一个链段运动引起的溶剂流动如何影响其他链段。这段发展说明,给静态链模型加上时间时,必须选择运动之间怎样相互联系。本节先完整计算独立珠摩擦的Rouse模型,让每一种假设都能在程序中找到对应位置,再讨论加入其他机制会改变什么。原始来源分别见Rouse论文与Zimm论文。
对自由端的高斯链,模式可以用一组余弦形状表示。第一非零模式在整条链上缓慢变化,较高编号的模式包含更多局部起伏。将珠子坐标按这些形状加权组合,就得到模式幅度ap;幅度越大,该模式在当前构象中的成分越强。这里采用正交归一的权重,意思是不同模式彼此可区分,归一化后使用同一套幅度标准。代码中的余弦表负责坐标与模式之间的转换。
每个非平移模式都有自己的松弛时间τₚ。可以先选一个模式,让它比平衡状态多出一点平均形变,再看这部分形变如何消退:经过一个τₚ,剩下原来的1/e,约37%;经过两个τₚ,剩下约14%。它很像按固定比例逐轮减少的余额,每过同样长的一段时间,保留的比例相同。松弛时间因此是一把比较快慢的尺子,变化会在这个时刻以后继续发生。单条分子轨迹还受到热涨落扰动,判断这种衰减通常要看许多轨迹的平均,或者查看不同时刻的运动还有多强的相关性。
p是模式编号,取1到M−1;λp是由链的连接和端点条件确定的无量纲系数。p较小,正弦的角度较小,λp也较小,因此τp较大。p=0对应整条链平移,不属于具有有限回复时间的形变模式,需要像刚才的质心扩散那样单独处理。式子中的ζ/ks具有时间单位,因为摩擦单位除以弹簧刚度单位恰好得到秒,这也是对公式最直接的量纲核对。
当M很大时,第一模式中的角度很小,可以用角度本身近似正弦,得到最慢时间随M²增长的关系。珠数加倍,最长形变时间约增至四倍。这个变化包含了两个相互联系的事实:长尺度形变需要协调更多珠子,形变沿连接传递也涉及更长的链。它与质心扩散随1/M变化,分别描述内部回复和整体移动。代码同时保留精确的正弦式与长链近似,图中能够看到有限珠数时的差别。
本例M=16、ks=3、ζ=1,最慢松弛时间为8.674t₀。若只把摩擦增至四倍,各个模式的松弛时间也都增至四倍,而同一温度下的平衡模式方差保持不变。就像相同形状的软绳在更黏的流体中移动得更慢,阻力改变了到达各种姿势的速度。这个比较把影响时间的因素单独拿出来,避免将尺寸改变和速度改变混在同一条解释里。
为了生成这样的运动,程序直接使用每个模式在有限时间步内的精确高斯更新。下一步包含两部分:已有幅度乘上一个小于1的衰减因子qp,再加上新抽到的热涨落。Vp表示该模式的平衡方差。每个模式、每个坐标方向、每个时间步都使用独立的标准正态随机数。模式更新完成后,再将它们组合回珠子坐标,就得到一条新的链构象。
为什么噪声前面是√[Vp(1−qp²)]?假设当前幅度的方差已经为Vp,乘qp后,旧部分的方差降为qp²Vp。新噪声与旧幅度独立,方差可以相加;补入Vp(1−qp²),总方差就回到Vp。因此,旧形变不断衰减,新的热涨落又不断补充,平衡分布能够保持稳定。这个简单核算同时检查了运动更新与静态统计是否一致。
同一条链,改变摩擦,观察松弛与热涨落
动画初始状态可以额外加入第一模式的形变。开始播放后,链的整体偏离逐渐减弱,局部却一直在动;切换为平衡初态,则从一开始就能看到持续的构象起伏。画面固定质心,使整体漂移不会把链带出视野,但内部三维运动仍被保留。重新设置相同初态,再改变摩擦,就能比较同样一段模型时间内发生了多少形变。比例尺保持不变,因而较慢的移动不会被自动缩放伪装成另一种尺寸。
现实中,溶剂流动还能把远处链段联系起来,拥挤环境中的其他长链也会限制运动通道。前者是Zimm思路关注的内容,后者与缠结和管模型有关。对于本节的独立珠摩擦模型,模式时间的平方标度有清楚的来源;加入流体关联或链不能穿越的约束以后,时间关系需要相应调整。后面讨论网络与材料响应时,我们会再次遇到这些约束,看到同样的分子为何在不同组织方式下表现出不同回复速度。
04从过去学习未来,先想清楚预测的量
有了轨迹,就可以问:给模型看一小段过去,它能告诉我们下一次观测大概是什么吗?先把末端x分量除以它在本模型中的平衡标准差,得到无量纲观测s。对于M珠高斯链,未归一化分量的方差是(M−1)kBT/ks,本例为5。归一化后,平衡均值为0、方差为1。这些数值来自已定义的模型,不需要从测试数据估计,因而也为预测误差提供了共同尺度。
衡量过去与未来的联系,可以使用自相关。把相隔一定时间的两个s相乘,再在许多起点和轨迹之间平均:若一个正偏离之后仍常常保持正值,或者一个负偏离之后仍常常保持负值,乘积就倾向于为正;若前后已经几乎没有联系,正负乘积会相互抵消。再除以s的方差,就得到从1开始衰减的无量纲相关函数。它告诉我们,过去的观测在多长时间内仍然保留预测信息。
式中的ta是观察起点,t是前后两次观测相隔的时间。一个独立Rouse模式的相关函数是单指数,但末端投影包含了多个模式,因此它的相关函数是不同快慢指数的加权组合。较快模式先消退,较慢模式继续保留信息。这也解释了为什么只记录当前一个末端投影可能丢掉信息:两个不同构象可以给出相同投影,却包含不同的内部模式,随后演化的趋势会不同。过去几帧提供了额外线索,让模型部分辨认这个数值背后的变化方式。
这类问题也推动了分子动力学中的表示学习。2018年,Mardt等人提出VAMPnets,用相隔一定时间的构象参与训练,学习与慢动力学和状态转换有关的表示。模型因此需要保留有助于预测时间变化的信息,而不只是把几何外观相近的构象放在一起。原始论文展示了从分子坐标到动力学状态模型的学习思路,本节则用可直接核对的线性时间模型理解其中的基本问题。
第一个参照非常简单:未来仍等于当前值。这种“保持上一时刻”的预测不需要训练,在很短的时间间隔上往往已经有一定准确度,因为相邻帧本来就很像。第二个模型使用训练轨迹拟合一个系数ρ,令下一次观测的平均预测等于当前值乘ρ。若0<ρ<1,预测会逐步向平衡均值0靠近。它称为一阶自回归,常写作AR(1),数字1表示只直接使用最近一次观测。
ρ的估计来自最小二乘:选择一个系数,使所有训练时间对中“下一次观测减ρ乘当前观测”的平方和尽可能小。对这个单参数问题求最小值,就得到上面的分式。分子保留相邻帧的共同变化,分母用当前值的平方和作尺度。本模型在平衡下均值已知为零,因此这里使用零截距。若处理有漂移或基线变化的真实记录,还要先确定平均值与趋势应如何进入模型。
学到一步关系后,可以反复使用它预测多个时间步:两步乘ρ²,h步乘ρ的h次方。本次训练得到ρ约为0.8748。不过,末端投影由多个模式组成,一次相关系数只把它们压缩成一个数,连续重复这个数,未必能保留较长时间的真实衰减。我们因此再训练一个使用过去8次观测的模型,为1、4、16、64帧以后的目标分别学习一组权重,直接预测这些未来时距。
第一行可以按普通加权求和来读。j=0对应当前值,j=1对应上一帧,依次直到7;Wjh告诉我们,预测h帧以后的目标时,第j个历史值贡献多少。W的每一列对应一种预测时距。第二行给出求这些权重的方式:X的每一行放入一个8个数的历史窗口,Y的同一行放入它对应的四个未来观测,nw是训练窗口数。矩阵转置与乘法把所有窗口中的共同变化汇总起来,求解线性方程后便得到W。
η是正则化强度,I是单位矩阵。增加一个适当的正则化项,可以减少模型为了追逐有限样本波动而产生的大幅权重变化。程序只在独立验证轨迹上选择η,测试轨迹一直保留到最后。这里的时间模型确实从样本学习了权重,而线性形式又与高斯链的动力学相配合,使我们能够比较“从数据学到的关系”与“从模型算出的关系”。遇到更复杂的势能、构象状态或序列信息时,再考虑增加非线性的表示能力。
数据划分发生在提取窗口之前。448条独立轨迹中,256条用于训练,64条用于验证,128条用于测试,每条记录1024帧。每隔8帧提取一个历史窗口,并保留到最远目标所需的未来部分,每条轨迹得到120个窗口。同一条轨迹的窗口共享时间相关性,因此它们整体留在同一个集合。这样,测试评估面对的是新生成的完整运动记录,而不是同一条轨迹中紧邻训练窗口的另一片段。
为了公平比较,物理参照也只接收相同的8个历史观测。高斯模型给出了它们两两之间以及它们与未来目标之间的协方差,我们可以据此计算未来的条件均值μh和仍然存在的条件方差σh²。Cpast是一张8×8的表,ch是长度为8的一列数,分别记录历史内部的关联和未来与历史的关联。求出权重wh后,同样通过加权求和得到预测。
条件均值的含义是:把所有与这段历史相容的未来放在一起,在指定时刻求平均。即使历史完全相同,新的热碰撞仍会产生不同未来,因此平均值周围保留了条件方差。在本节线性高斯模型中,这些量可以精确计算;随着预测时间变长,过去与未来的关联减弱,均值趋向0,方差趋向平衡值1。这给学习结果提供了一个具体参照:长时间预测中的随机起伏,应由未来分布来描述。
05运行轨迹,看清误差从哪里来
下面的完整代码先构造链的模式,再用精确高斯更新生成独立轨迹。每条轨迹都从平衡分布中独立抽取初态,因此从第一帧开始就具有规定的平稳统计。程序只模拟学习任务需要的一个坐标方向;三个方向在本模型中彼此独立,所以这一分量的统计与完整三维模拟一致。页面中的动画另外生成三维坐标,用来观察姿势变化,二者使用同样的模式关系。
训练部分比较保持当前值、一阶自回归和8次历史的直接回归,再计算相同输入信息下的物理参照。程序把每条测试轨迹中所有窗口的误差先平均,然后在128条独立测试轨迹之间计算均值和标准误差。图上的误差棒使用这个标准误差的两倍,反映整批独立运动记录之间的统计波动。窗口虽然很多,误差棒的独立单位仍是整条轨迹,这样才能与数据的真实生成方式对应。
程序还做了两个相互补充的比较。第一组把摩擦从1增至4,检查静态分布与时间相关性分别怎样变化。第二组固定总观察时长,只改变保存记录的间隔,再用相邻记录的相关系数估计一个单指数时间。后者可以帮助判断:一个拟合出来的时间,究竟反映了某个明确模式,还是把多个快慢过程压在了一起。所有图和数值都由下面的同一段程序产生。
"""Learn future conditional means from Gaussian-chain trajectories.
Python + NumPy + Matplotlib. Reduced units: b0=1, kBT=1, zeta0=1,
t0=zeta0*b0**2/kBT=1, spring constant ks=3*kBT/b0**2.
The trajectories are model simulations; experimental history is cited in the text.
"""
from pathlib import Path
import base64
import json
import zlib
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

OUT=Path("dynamics_outputs"); OUT.mkdir(exist_ok=True)
M=16; KS=3.; KT=1.; ZETA=1.; DT=.5
STEPS=1024; TOTAL=448; HISTORY=8
HORIZONS=np.array([1,4,16,64])
COLORS=["#247968","#c46c46","#596d99","#b3945d"]
plt.rcParams.update({"font.family":"DejaVu Sans","font.size":11,
    "axes.spines.top":False,"axes.spines.right":False,
    "axes.labelcolor":"#273b36","text.color":"#273b36",
    "svg.hashsalt":"ai4s-L08","savefig.facecolor":"#fffdf8"})


def chain_modes(beads):
    p=np.arange(1,beads)
    eigenvalue=4*np.sin(np.pi*p/(2*beads))**2
    basis=np.sqrt(2/beads)*np.cos((np.arange(beads)[:,None]+.5)*p*np.pi/beads)
    variance=KT/(KS*eigenvalue)
    end_coeff=basis[-1]-basis[0]
    return eigenvalue,basis,variance,end_coeff


LAM,BASIS,VAR,END=chain_modes(M)
END_VARIANCE=float((END**2)@VAR)


def simulate(count,friction,seed,keep_modes=False):
    rng=np.random.default_rng(seed)
    decay=np.exp(-KS*LAM*DT/friction)
    noise=np.sqrt(VAR*(1-decay**2))
    modes=rng.normal(size=(count,M-1))*np.sqrt(VAR)
    trace=np.empty((count,STEPS))
    first=np.empty((count,STEPS)) if keep_modes else None
    for t in range(STEPS):
        trace[:,t]=modes@END/np.sqrt(END_VARIANCE)
        if keep_modes: first[:,t]=modes[:,0]/np.sqrt(VAR[0])
        if t+1<STEPS:
            modes=modes*decay+rng.normal(size=modes.shape)*noise
    return trace,first


def correlation(lag_frames,friction=ZETA):
    lag=np.asarray(lag_frames)
    weights=END**2*VAR/END_VARIANCE
    return np.sum(weights*np.exp(-abs(lag)[...,None]*DT*KS*LAM/friction),axis=-1)


def measured_correlation(traces,lag):
    if lag==0:return 1.
    return float(np.sum(traces[:,:-lag]*traces[:,lag:])/np.sum(traces[:,:-lag]**2))


def make_windows(traces):
    times=np.arange(HISTORY-1,STEPS-HORIZONS.max(),8)
    x=traces[:,times[:,None]-np.arange(HISTORY)[None,:]]
    y=traces[:,times[:,None]+HORIZONS[None,:]]
    return x,y,times


def physics_prediction_weights(horizons):
    past=np.arange(HISTORY)
    covariance=correlation(past[:,None]-past[None,:])
    cross=correlation(past[:,None]+np.asarray(horizons)[None,:])
    weights=np.linalg.solve(covariance,cross)
    residual_variance=1-np.sum(cross*weights,axis=0)
    return weights,residual_variance,covariance,cross


def main():
    trace,first_mode=simulate(TOTAL,ZETA,808,keep_modes=True)
    slow,_=simulate(256,4.,809)
    # Split independent trajectories BEFORE creating windows.
    train=np.arange(256); valid=np.arange(256,320); test=np.arange(320,TOTAL)
    x,y,origins=make_windows(trace)
    xtr=x[train].reshape(-1,HISTORY); ytr=y[train].reshape(-1,len(HORIZONS))
    candidates=[]
    for reg in [0.,1e-5,1e-3,.01,.1]:
        w=np.linalg.solve(xtr.T@xtr/len(xtr)+reg*np.eye(HISTORY),xtr.T@ytr/len(xtr))
        loss=float(np.mean((x[valid]@w-y[valid])**2))
        candidates.append((loss,reg,w))
    validation_loss,regularization,weights=min(candidates,key=lambda row:row[0])
    rho=float(np.sum(trace[train,:-1]*trace[train,1:])/np.sum(trace[train,:-1]**2))
    physical_weights,physical_variance,_,_=physics_prediction_weights(HORIZONS)
    prediction={"persistence":np.repeat(x[test,:,0,None],len(HORIZONS),axis=-1),
        "AR1_recursive":x[test,:,0,None]*rho**HORIZONS,
        "direct_history8":x[test]@weights,"same_history_physics":x[test]@physical_weights}
    metrics={};per_trajectory_errors={}
    for name,values in prediction.items():
        # Windows overlap in time; uncertainty is calculated across whole trajectories.
        errors=np.mean((values-y[test])**2,axis=1)
        per_trajectory_errors[name]=errors
        metrics[name]={"mse":errors.mean(axis=0).tolist(),
            "standard_error":(errors.std(axis=0,ddof=1)/np.sqrt(len(test))).tolist()}

    # A fixed test trajectory and origin selected before examining its future.
    example_id=320; origin=256; future=np.arange(1,65)
    history=trace[example_id,origin-np.arange(HISTORY)]
    fw,fv,cov,cross=physics_prediction_weights(future)
    conditional_mean=history@fw
    residual_cov=correlation(future[:,None]-future[None,:])-cross.T@fw
    factor=np.linalg.cholesky(residual_cov+1e-12*np.eye(len(future)))
    alternatives=conditional_mean+np.random.default_rng(1808).normal(size=(5,len(future)))@factor.T

    # Same physical observation duration, different recording intervals.
    strides=np.array([1,2,4,8,16,32])
    measured=[]; theoretical=[]; mode_measured=[]
    for stride in strides:
        sparse=trace[test,::stride]; sparse_mode=first_mode[test,::stride]
        rr=measured_correlation(sparse,1); rm=measured_correlation(sparse_mode,1)
        assert 0<rr<1 and 0<rm<1
        measured.append(-stride*DT/np.log(rr))
        theoretical.append(-stride*DT/np.log(correlation(stride)))
        mode_measured.append(-stride*DT/np.log(rm))
    equilibrium={}
    for name,values in [("zeta1",trace),("zeta4",slow)]:
        moments=np.mean(values**2,axis=1)
        mean=float(moments.mean()); se=float(moments.std(ddof=1)/np.sqrt(len(moments)))
        equilibrium[name]={"mean":float(values.mean()),"second_moment":mean,"second_moment_se":se,
                           "second_moment_z":(mean-1)/se}
        assert abs((mean-1)/se)<5

    # Independent force/mode and stationary-covariance algebra checks.
    lap=np.diag(np.r_[1,np.full(M-2,2),1])-np.diag(np.ones(M-1),1)-np.diag(np.ones(M-1),-1)
    mode_error=float(np.max(abs(lap@BASIS-BASIS*LAM)))
    orthogonal_error=float(np.max(abs(BASIS.T@BASIS-np.eye(M-1))))
    decay=np.exp(-KS*LAM*DT/ZETA)
    stationary_error=float(np.max(abs(VAR*decay**2+VAR*(1-decay**2)-VAR)))
    assert mode_error<1e-12 and orthogonal_error<1e-12 and stationary_error<1e-12
    assert abs(END_VARIANCE-(M-1)*KT/KS)<1e-12
    paired_difference=per_trajectory_errors['AR1_recursive']-per_trajectory_errors['direct_history8']
    results={"model":"3D Gaussian vector-spring Rouse chain; observed endpoint x projection; stationary start; free ends",
        "units":{"length":"b0","energy":"kBT0","friction":"zeta0","time":"t0=zeta0*b0^2/(kBT0)"},
        "parameters":{"M":M,"ks":KS,"kBT":KT,"zeta":ZETA,"dt":DT,"steps":STEPS},
        "tau1":float(ZETA/(KS*LAM[0])),"end_x_variance":END_VARIANCE,
        "split":{"train_ids":train.tolist(),"validation_ids":valid.tolist(),"test_ids":test.tolist()},
        "history":HISTORY,"window_stride":8,"windows_per_trajectory":len(origins),
        "horizons_frames":HORIZONS.tolist(),"horizons_time":(HORIZONS*DT).tolist(),
        "AR1_coefficient":rho,"direct_weights":weights.tolist(),"physical_weights":physical_weights.tolist(),
        "validation_choices":[{"lambda":reg,"mse":loss} for loss,reg,_ in candidates],
        "selected_regularization":regularization,"selected_validation_mse":validation_loss,
        "theoretical_residual_variance":physical_variance.tolist(),"test_metrics":metrics,
        "paired_AR1_minus_direct":{"mean":paired_difference.mean(axis=0).tolist(),
            "standard_error":(paired_difference.std(axis=0,ddof=1)/np.sqrt(len(test))).tolist()},
        "sampling":{"stride":strides.tolist(),"apparent_tau_observed":measured,
            "apparent_tau_theory":theoretical,"pure_mode_tau_observed":mode_measured},
        "equilibrium":equilibrium,"checks":{"mode_operator_error":mode_error,
            "orthonormal_basis_error":orthogonal_error,"stationary_variance_identity_error":stationary_error},
        "reference_information":"Physical predictor receives exactly the same eight scalar observations as the learned predictor."}
    # Full float64 trajectories are compressed losslessly to keep the download small.
    encoded=base64.b64encode(zlib.compress(trace.astype('<f8').tobytes(),level=9)).decode('ascii')
    samples={"trajectory_encoding":"zlib compressed base64, little-endian float64, row-major",
        "trajectory_shape":list(trace.shape),"trajectory_data":encoded,
        "window_origins":origins.tolist(),"horizons_frames":HORIZONS.tolist(),
        "example":{"trajectory_id":example_id,"origin":origin,"past":history.tolist(),
            "future_actual":trace[example_id,origin+future].tolist(),
            "conditional_mean":conditional_mean.tolist(),"conditional_variance":fv.tolist(),
            "conditional_sample_futures":alternatives.tolist()},
        "per_test_trajectory_mse":{key:val.tolist() for key,val in per_trajectory_errors.items()}}
    (OUT/'samples.json').write_text(json.dumps(samples,indent=2),encoding='utf-8')
    (OUT/'results.json').write_text(json.dumps(results,indent=2),encoding='utf-8')

    def panel(ax,name):
        if name=='forecast':
            ft=future*DT
            ax.fill_between(ft,conditional_mean-1.6448536269514722*np.sqrt(fv),
                conditional_mean+1.6448536269514722*np.sqrt(fv),color=COLORS[0],alpha=.13,label='90% pointwise conditional band')
            for i,alternative in enumerate(alternatives[:3]):
                ax.plot(ft,alternative,c=COLORS[2],alpha=.22,lw=1,label='Other possible futures' if i==0 else None)
            ax.plot(ft,trace[example_id,origin+future],c=COLORS[1],lw=1.5,label='Observed test future')
            ax.plot(ft,conditional_mean,c=COLORS[0],lw=2,label='Physical conditional mean')
            ax.scatter(HORIZONS*DT,history@weights,c='#263a35',s=36,zorder=5,label='Learned mean (4 horizons)')
            ax.scatter([0],[history[0]],c='#263a35',s=24)
            ax.set(xlabel='Future time / t0',ylabel='Normalized endpoint projection s',title='A  A mean forecast and possible futures')
            ax.legend(frameon=False,fontsize=8,loc='lower right')
        elif name=='correlation':
            lag=np.arange(129)
            for fr,values,c in [(1.,trace[test],COLORS[0]),(4.,slow,COLORS[1])]:
                ax.plot(lag*DT,correlation(lag,fr),c=c,label=f'Exact, friction = {fr:g}')
                picks=np.arange(0,129,8)
                ax.scatter(picks*DT,[measured_correlation(values,int(q)) for q in picks],facecolors='none',edgecolors=c,s=25)
            ax.axhline(0,c='#b9c1b8',lw=1)
            ax.set(xlabel='Time separation / t0',ylabel='Normalized autocorrelation',title='B  Same equilibrium size, different speed')
            ax.legend(frameon=False,fontsize=9)
        elif name=='modes':
            sizes=np.arange(4,65)
            for order,c in zip([1,2,4],COLORS):
                use=sizes>order
                tau=ZETA/(4*KS*np.sin(np.pi*order/(2*sizes[use]))**2)
                ax.plot(sizes[use],tau,c=c,label=f'Mode p = {order}')
            ax.plot(sizes,ZETA*sizes**2/(KS*np.pi**2),'--',c=COLORS[3],label='Large-M approximation, p = 1')
            ax.set(xscale='log',yscale='log',xlabel='M / beads',ylabel='Relaxation time / t0',title='C  Large-scale shapes relax more slowly')
            ax.legend(frameon=False,fontsize=9)
        elif name=='weights':
            im=ax.imshow(weights.T,aspect='auto',cmap='BrBG',
                norm=matplotlib.colors.TwoSlopeNorm(vmin=-.1,vcenter=0,vmax=.75))
            ax.set_xticks(range(HISTORY),[str(j) for j in range(HISTORY)])
            ax.set_yticks(range(4),[str(t) for t in HORIZONS*DT])
            ax.set(xlabel='Past observation / frames before present',ylabel='Forecast horizon / t0',title='D  Learned temporal weights')
            for i in range(4):
                for j in range(HISTORY):
                    displayed=0. if abs(weights[j,i])<.005 else weights[j,i]
                    ax.text(j,i,f'{displayed:.2f}',ha='center',va='center',fontsize=9,color='white' if weights[j,i]>.5 else '#273b36')
            ax.figure.colorbar(im,ax=ax,label='Regression weight',shrink=.8)
        elif name=='errors':
            labels=['Keep current value','Learned AR(1), iterated','Learned 8-value history','Same-history physical mean']
            for (key,metric),label,c in zip(metrics.items(),labels,COLORS):
                ax.errorbar(HORIZONS*DT,metric['mse'],yerr=np.array(metric['standard_error'])*2,
                    marker='o',capsize=3,c=c,label=label,ls='--' if key=='same_history_physics' else '-')
            ax.plot(HORIZONS*DT,physical_variance,'k:',lw=1.5,label='Exact conditional residual variance')
            ax.set(xscale='log',xlabel='Forecast horizon / t0',ylabel='Test mean squared error',title='E  Prediction error grows with horizon')
            ax.legend(frameon=False,fontsize=8,loc='upper left')
        else:
            ax.plot(strides*DT,theoretical,c=COLORS[0],label='Endpoint: exact lag-dependent value')
            ax.scatter(strides*DT,measured,c=COLORS[0],label='Endpoint: sampled estimate',s=26)
            ax.axhline(ZETA/(KS*LAM[0]),c=COLORS[2],ls='--',label='Slowest mode: exact relaxation time')
            ax.scatter(strides*DT,mode_measured,c=COLORS[2],marker='s',s=26,label='Slowest mode: sampled estimate')
            ax.set(xscale='log',xlabel='Recording interval / t0',ylabel='Single-exponential apparent time / t0',title='F  What time does a one-step fit measure?')
            ax.legend(frameon=False,fontsize=8,loc='lower right')
        if name!='weights':ax.grid(alpha=.15)

    keys=['forecast','correlation','modes','weights','errors','sampling']
    for name in keys:
        fig,ax=plt.subplots(figsize=(6.7,5),layout='constrained',facecolor='#fffdf8')
        panel(ax,name);fig.savefig(OUT/(name+'.svg'),metadata={'Date':None});plt.close(fig)
    fig,axes=plt.subplots(3,2,figsize=(16,17),layout='constrained',facecolor='#fffdf8')
    for ax,name in zip(axes.flat,keys):panel(ax,name)
    fig.savefig(OUT/'dynamics_diagnostics.svg',metadata={'Date':None})
    fig.savefig(OUT/'dynamics_diagnostics.png',dpi=160,metadata={'Software':'Matplotlib'});plt.close(fig)
    print('Independent trajectories, train / validation / test: 256 / 64 / 128')
    print('Each trajectory: 1024 frames; input history: 8; windows per trajectory:',len(origins))
    print('Exact slowest relaxation time:',round(results['tau1'],4),'t0')
    print('Selected regularization:',regularization,'; learned AR(1) coefficient:',round(rho,5))
    for name,metric in metrics.items(): print(name,'MSE:',np.round(metric['mse'],5).tolist())
    print('Exact residual variance:',np.round(physical_variance,5).tolist())
    print('Equilibrium second moments, friction 1 and 4:',[round(equilibrium[k]['second_moment'],4) for k in equilibrium])
    print('Saved full compressed trajectories, fitted weights, six panels and checks.')


if __name__=='__main__':main()
本次实际运行输出
Independent trajectories, train / validation / test: 256 / 64 / 128
Each trajectory: 1024 frames; input history: 8; windows per trajectory: 120
Exact slowest relaxation time: 8.6739 t0
Selected regularization: 0.001 ; learned AR(1) coefficient: 0.87483
persistence MSE: [0.24907, 0.60957, 1.3239, 1.96829]
AR1_recursive MSE: [0.23445, 0.5254, 0.93214, 0.99921]
direct_history8 MSE: [0.22678, 0.50206, 0.88158, 0.99899]
same_history_physics MSE: [0.2268, 0.50192, 0.88118, 0.9991]
Exact residual variance: [0.22789, 0.5055, 0.87957, 0.99952]
Equilibrium second moments, friction 1 and 4: [0.9987, 1.0114]
Saved full compressed trajectories, fitted weights, six panels and checks.
一次运行 · 六幅结果图
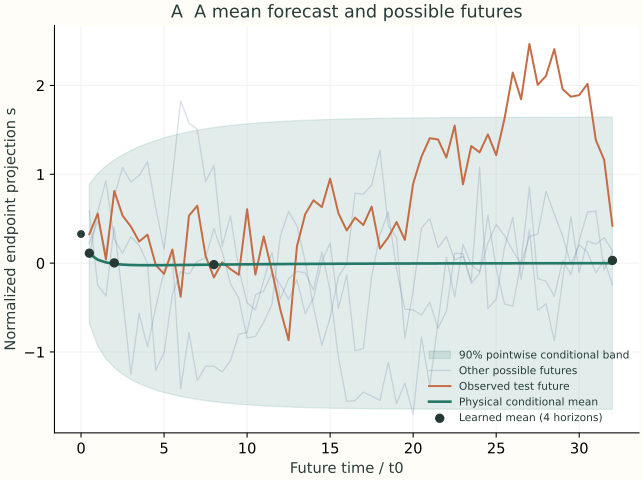
A · 固定一段已观测历史,展示实际未来、其他可能的未来、物理条件均值与学习预测;浅色带为每个时刻分别定义的90%条件范围。
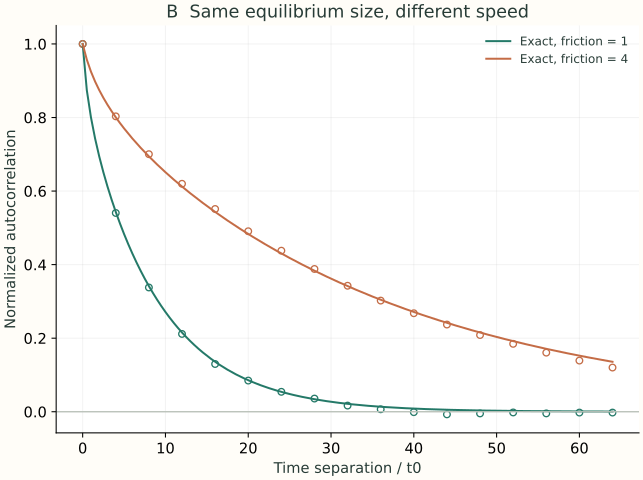
B · 改变珠子的摩擦,平衡尺寸保持相同,时间相关性消退的速度改变;线为理论,点为轨迹统计。
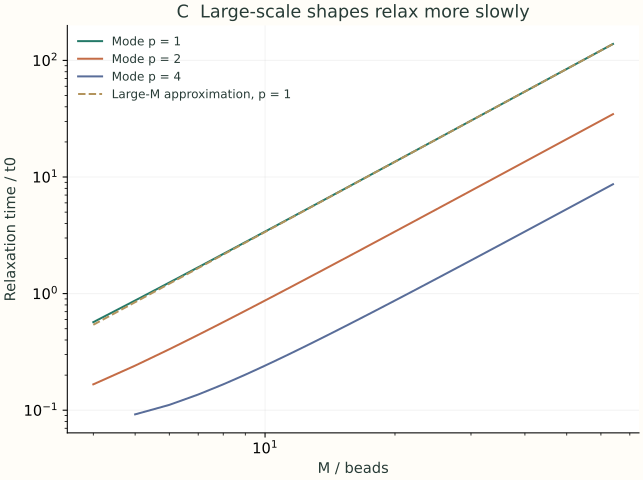
C · 珠数越多,最慢形变模式的松弛时间越长;同一条链也有不同快慢的模式。
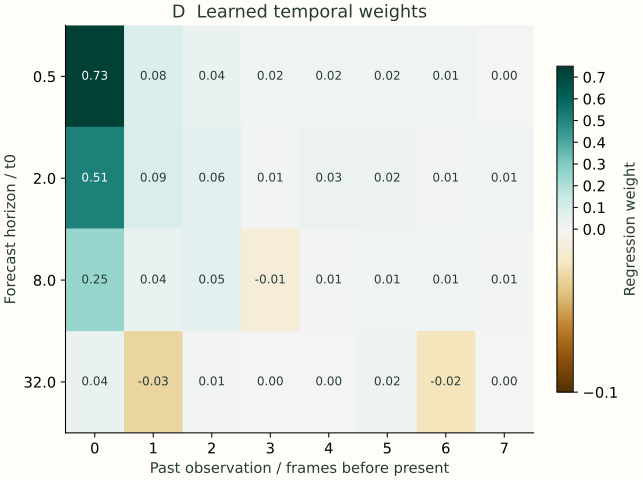
D · 直接从训练轨迹学到的时间权重。每一行对应一种预测时长,每一列对应过去的一次观测。
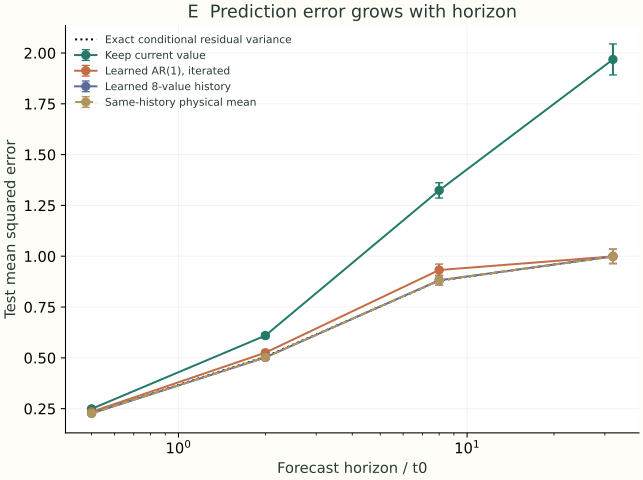
E · 128条完整测试轨迹的预测误差;误差棒为跨轨迹标准误差的两倍,点线给出相同历史信息下的理论残余方差。
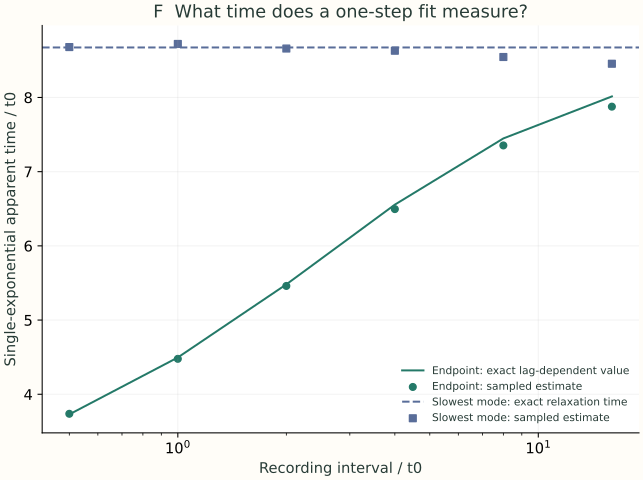
F · 对同样物理时长的记录改变采样间隔,单一慢模式与包含多个模式的末端投影给出不同的单指数时间估计。
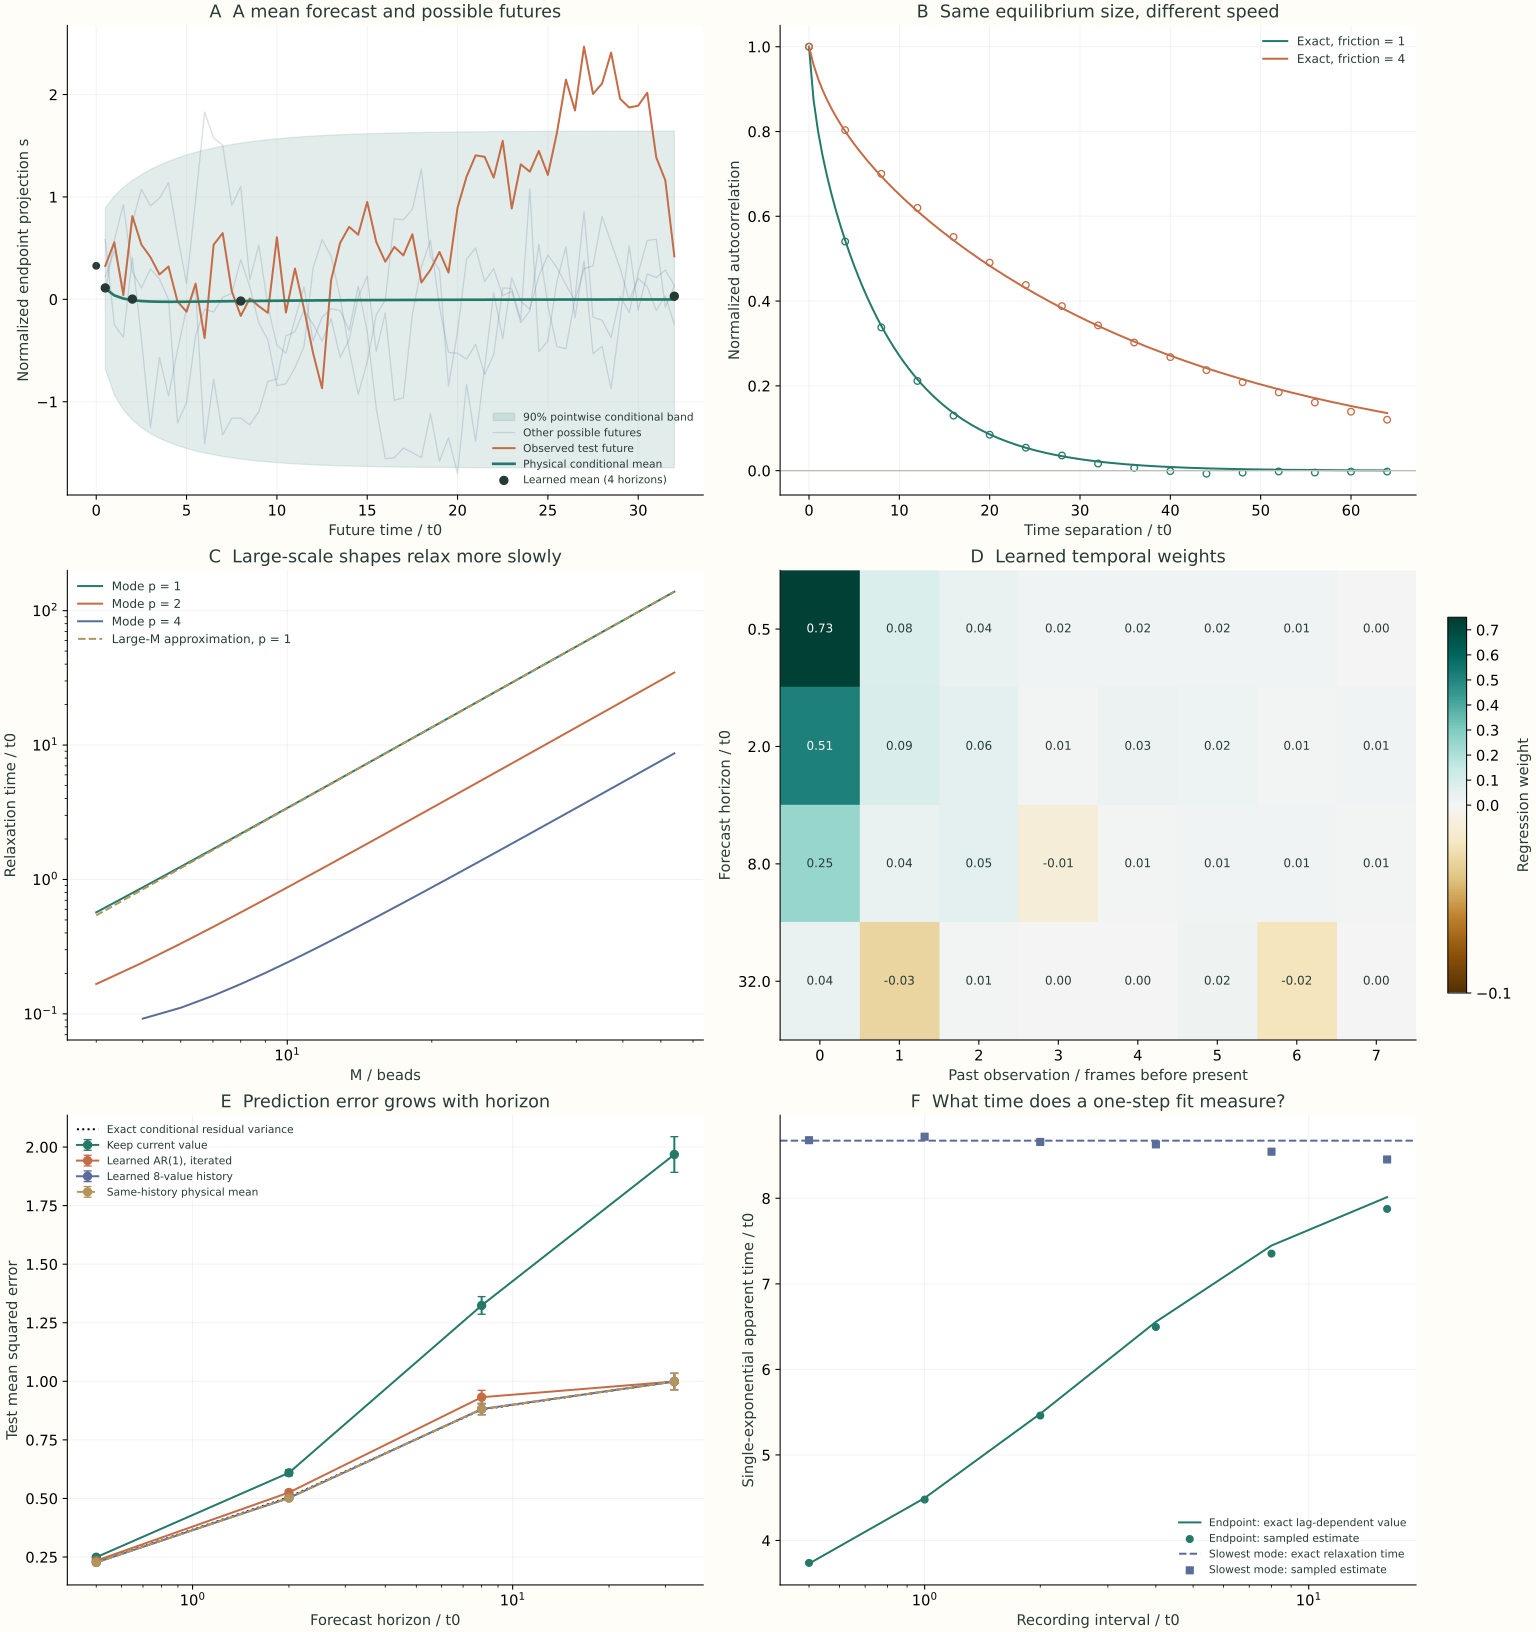
图A选定一条测试轨迹及一个事先规定的预测起点。橙色线是随后实际产生的一段未来,较浅的线是根据同一段历史抽取的其他可能未来,绿色线是物理条件均值,黑点是学习模型在四个时距上的预测。不同未来有明显的起伏,而平均趋势比较平滑。浅色带在每个时刻覆盖条件分布中间90%的范围,它逐点描述波动大小;随着时间推进,一整条随机轨迹可以多次进出这个范围。
这张图适合回答一个常见疑惑:为什么模型预测曲线越来越接近零,真实轨迹却仍然在动?因为我们预测的是给定历史以后,未来可能取值的平均。长时间后,过去提供的方向信息逐渐消退,正负偏离在平均中抵消,但单个分子的热运动依然存在。若要生成未来轨迹,就需要同时描述均值、波动和不同时刻之间的联系,像图中的其他可能未来那样抽样,而不只是把一条平均曲线当作电影播放。
图B让静态与动态的区别更加清楚。摩擦为1与4的两组轨迹,其归一化观测二阶矩分别为0.999和1.011,都围绕理论值1波动;较大摩擦的相关性却保持得更久。图C进一步展示,在同一个摩擦条件下,较长链的最低模式也更慢。把两幅图放在一起,就能分别辨认外部阻力与内部长度如何进入时间尺度,避免把所有“运动变慢”都归到链变大这一件事上。
图D把模型怎样使用过去8次观测直接画了出来。预测较近的未来时,当前值通常最有用,前几帧提供补充;预测距离拉长后,整段历史的影响逐渐减弱。有些权重为负也容易理解:两次相近的观测相减,能够提示最近是在上升还是下降。回归权重是在组合观测值,不必像概率那样都为正、加起来等于1。图中权重由256条训练轨迹计算,正则化强度用64条验证轨迹选择;128条测试轨迹再回答另一件事:按这种方式利用历史,预测误差实际有多大。
在0.5t₀以后的预测上,一阶自回归的均方误差为0.234,8次历史模型为0.227;到了8t₀,分别为0.932和0.882。较长历史及针对不同时间的直接拟合,帮助模型保留了单一一步系数压缩掉的关联信息。图E中的物理参照与历史模型接近,说明在这个已定义的高斯系统里,训练数据确实让模型学到了相应的时间关系。有限测试样本上的细小高低变化,应结合误差棒一起阅读。
到了32t₀,历史模型的误差约为0.999,而始终保持当前值的参照约为1.968。前者接近平衡方差1,后者接近2。原因可以直接从两个独立的零均值状态理解:经过足够长时间,当前与未来几乎失去联系;预测平衡均值0时,误差就是未来值自身的方差;如果坚持拿另一个独立的当前值作预测,两个状态的方差相加,误差便约为2。这个极限把误差数字与具体的物理信息联系了起来。
图F讨论了“从一个相关系数得到一个时间”时需要看清的对象。单指数相关满足ρ=exp(−Δt/τ),因此取自然对数后,可以算出τ=−Δt/lnρ。对于单独的最慢模式,不同采样间隔应得到接近同一个τ。末端投影包含多个模式,其相邻帧的相关性则随采样间隔以不同方式混合快慢过程,所以用同样公式得到的是随间隔变化的表观时间。图中的两类曲线并排展示了这种区别。
采样过于稀疏时,较快模式已经在两次观测之间消退,记录无法告诉我们它们在中间怎样运动;采样很密时,相邻帧高度相似,多保存几张照片也不会自动增加独立的慢过程。为一个实际研究选择记录间隔,可以先估计关注过程的大致时间,再同时安排足够细的局部记录和足够长的总观察时长。训练时间模型时,这两个设计分别影响可看见的快变化和可统计的慢变化。
把流程用于生物大分子研究时,输入可以进一步包含序列、盐浓度、温度或局部环境,观察量也可以换成残基接触、结构距离或某种构象状态。目标一旦改变,数据与模型就需要保留相应信息:预测状态转换时要追踪转换本身,预测平均回复时要定义扰动与观察方向,估计慢时间时要有足够长的记录。这里建立的轨迹划分、参照预测和时间单位,可以继续沿用到这些任务中。
至此,我们已经有了一组共同语言:连接和序列决定分子有哪些组成与约束,环境改变构象权重,统计尺寸概括空间分布,动力学则决定这些分布如何随时间实现。接下来的章节把这套语言放回具体的生物大分子。先从蛋白质开始,考察一条氨基酸序列为什么可能形成稳定结构,也可能保留柔性区域,以及AI需要什么样的表示和实验标签,才能研究这些不同层次的行为。
资料与延伸阅读
科学史图均为依据研究思路重新绘制的概念图。程序与动画使用明确给定的高斯链模型,结果文件保存模型参数、数据划分、时间权重与评价值;完整轨迹以无损压缩形式保存在样本JSON中,编码、数组形状和数值类型随文件一并记录。
- Perkins, T. T., Quake, S. R., Smith, D. E. & Chu, S. Relaxation of a single DNA molecule observed by optical microscopy. Science 264, 822–826 (1994). DOI: 10.1126/science.8171336。
- Rouse, P. E. A Theory of the Linear Viscoelastic Properties of Dilute Solutions of Coiling Polymers. Journal of Chemical Physics 21, 1272–1280 (1953).
- Zimm, B. H. Dynamics of Polymer Molecules in Dilute Solution: Viscoelasticity, Flow Birefringence and Dielectric Loss. Journal of Chemical Physics 24, 269–278 (1956).
- Mardt, A., Pasquali, L., Wu, H. & Noé, F. VAMPnets for deep learning of molecular kinetics. Nature Communications 9, 5 (2018). DOI: 10.1038/s41467-017-02388-1。