把环境放进分子与模型的共同描述
高分子链的舒展与塌缩:排除体积和吸引作用
把一串带有小磁扣的软绳摊在桌上,磁扣很弱时,绳子可以摆成许多松散的形状;吸引增强后,原本离得较远的几段更容易贴在一起。绳长没变,占据的空间却缩小了。水里的生物大分子也会受到环境影响:温度、盐和溶液成分改变链段之间的有效作用,各种姿态出现的机会随之改变。这些姿态及其出现概率合在一起,称为构象系综。本节从数清一个短链模型的全部姿态开始,解释吸引怎样改变平均尺寸,再让学习模型根据链长和环境预测这种变化。
这件事关系到一些很具体的研究选择。研究者想让某段蛋白质保持柔软舒展,想知道多糖在配方里能占多大空间,或者想比较同一条核酸在不同离子条件下的尺寸,都需要把“是什么分子”与“处在什么环境”一起记录。我们将从一个可以数清所有姿势的小模型出发,算出环境响应,训练条件回归模型,再补充三组新观测,检查这些信息究竟改变了哪些预测。
01同样的链,新的环境
前两节研究链的大小和拉伸时,已经看到了一条重要线索:链的尺寸是许多构象共同产生的统计量。现在固定链段数、段长和连接顺序,只改变周围条件。这样做相当于把一组照片的拍摄对象保持不变,却改变每种姿势出现的频率。如果舒展姿势变得更常见,平均尺寸就会增大;如果紧凑姿势占的比例上升,平均尺寸就会减小。观察到尺寸改变时,先想到构象分布发生了变化,往往比立即设想化学键断裂或分子长短改变更贴近问题。
真实链段占据空间,是理解这一变化的第一步。自由连接链把每一段视为方向可以独立转动的线段,因此允许一段路径穿过另一段路径,甚至让不同珠子落到同一位置。对于真实分子,两个原子的电子云靠得过近时会产生很大的排斥代价。我们可以用一个简化规则表达这种占位:同一格位置只能放一个珠子。它像一条需要绕过自己已经走过位置的路线,原本允许的某些折返路径因此被删掉了。
第二步是考虑周围的水和其他溶液成分。某两段链靠近时,改变的不只是它们彼此之间的距离,也包括周围水分子的安排、原来与水形成的接触,以及附近离子的分布。于是,链段靠近是否有利,应比较整个局部环境的变化。高分子物理常把这些复杂过程归并为“有效相互作用”:我们只追踪链,把被省略的环境影响放进少数参数。这个参数描述的是某种条件下的综合结果,换一种溶液,它就可能需要重新确定。
“好溶剂”中的“好”,是相对于某一种聚合物而言的。在这样的条件下,链段与周围环境相处比较有利,单条链通常较为舒展;在较差的溶剂条件下,链段彼此聚在一起可能更有利,单链趋向紧凑。一个日常类比是座位安排:如果每个人与周围邻居都能自在相处,座位可以分散;如果只有熟悉的小组坐在一起更舒服,分布就会聚拢。分子没有偏好和意图,类比帮助我们区分的是两种接触安排所对应的统计代价。
这种语言在生物大分子中尤其有用,但要结合具体化学结构使用。带电链受到的排斥可能随着盐屏蔽而减弱;极性基团的水合、疏水基团的暴露以及特定离子的结合,也会改变构象机会。把这些过程全部压缩成一个“温度越高越舒展”的口号,就会丢掉决定变化方向的内容。比较样品时,应保留分子序列或组成、温度、酸碱度、盐种类与浓度,以及用于测量的溶液配方,让每一个尺寸都对应一个清楚的环境。
蛋白质科学为这个问题提供了很直观的实例。2006年,Sherman与Haran利用单分子荧光研究蛋白质L的展开态,发现随着变性剂浓度增加,展开态的尺寸仍会逐渐变化。“已经展开”因此不是一个固定尺寸的终点:同一条展开的链,还可以拥有较紧凑或较舒展的系综。这项研究把蛋白质问题与高分子的线团—球状收缩联系起来。原始论文给出了相应测量与分析。
理解这个例子时,可以把“缩小”与“形成特定结构”分别放在脑中。把一张地图揉成团,整体尺寸会明显减小,但这并没有把它折成一个按指定折痕制作的纸模型。蛋白质进入较紧凑的系综,与它形成特定的天然接触和功能结构,也是在不同层次上描述变化。我们本节先关心整体尺寸,后面讨论蛋白质时,再引入残基种类、序列排列和特定接触,解释哪些紧凑状态具有生物学意义。
实验还提醒我们,“尺寸”需要具体说明测量定义。荧光标记反映两个位置之间的距离相关信息,散射能够提供另一类整体结构信息,扩散则与水动力尺度相连。它们从不同角度观察同一个系综,彼此之间通常需要模型才能转换。本节统一使用均方根回转半径:先对每个构象计算各珠子到质心的距离平方平均,再在构象之间平均,最后开平方。这样得到的量既保留了整条链的空间分布,也与第五节的定义一致。
接下来的计算把化学细节暂时收进一个接触参数,让我们集中观察占位与吸引的竞争。这个选择还带来一个实际好处:链足够短时,所有允许构象都能列出来,平均尺寸便有一个可逐项核对的答案。后面的学习模型要预测的,正是这些已定义条件下的统计量。分子模型负责产生清楚的问题,数据负责记录响应,学习模型负责从部分条件推向新条件。
02把拥挤和吸引数出来
想象空间由许多边长为b的小立方格构成。一条链有N段、N+1个等质量珠子,每一步沿着某个坐标轴前进一格,因此有前、后、左、右、上、下六种方向。珠子不能落到已经占据的位置,但链可以弯曲并靠近自己。程序把b设为一个长度单位;若以后为这个粗粒化模型指定了实际段长,所有尺寸就按同一比例换算。此处一个珠子代表一个模型单元,其大小由建模方式决定。
还要区分两种“相邻”。第i个珠子与第i+1个珠子之间有链上的连接,它们必然相隔一格。另一些珠子沿着链相距很远,却可能在空间里靠到相隔一格的位置,这才是我们计数的非成键接触。用m表示这样的珠子对数,每一对只数一次。例如,一条三段链沿正方形的三条边走完,首尾珠子就会形成一次非成键接触;如果三段一直向前走,则一次也没有。
程序为每次非成键接触赋予同样的有效能量降低ε,希腊字母epsilon。一个构象有m次接触,总接触能就是负的ε乘m。负号表示接触降低能量,ε本身取非负值。再用《高分子链的熵弹性:拉伸模型与参数反演》出现的热能尺度kBT去除ε,就得到无量纲参数u。ε与kBT都具有能量单位,二者相除后只剩一个数,这让我们能够直接比较“吸引有多强”与“热运动有多强”。
这里c是构象的编号,m(c)说明接触数随构象而变。u=0时,接触没有额外能量奖励,所有满足占位规则的完整路径等权;u增大时,多接触构象获得更高权重。若在一个特定模型中保持ε不变,降低绝对温度会使u增大。对于真实水溶液,ε本身也可能随温度与成分变化,所以实验中应先确定这些条件如何影响有效作用,再把它们映射到u。u是本模型的吸引尺度,不能直接当成酸碱度或盐浓度的数值。
平衡时,一个状态的玻尔兹曼权重正比于其能量负值除以kBT后的指数。把E=−εm代入,两个负号抵消,就得到exp(um)。exp是以自然常数e为底的指数函数;例如u=1时,多一个接触会让单个构象的相对权重乘上约2.718。为了把相对权重变成概率,我们将所有权重相加,得到Z,再把每个权重除以Z。无论列表有多长,得到的概率加起来都等于1。
式子里的竖线读作“在给定条件下”:p(c|u)是在u已经确定时构象c出现的概率。求和符号Σ表示把后面的量沿着全部允许构象加起来。最后一行先用这些概率对Rg²加权平均,再开平方,得到具有长度单位的均方根回转半径。如果只有两个构象,Rg分别为1b和2b,概率各为一半,那么结果是√[(1²+2²)/2]b,约1.581b。它与先平均半径得到的1.5b不同,计算顺序因此要保持一致。
计算时,把接触数相同的构象放进一组会更清楚。设Ωₘ是接触数为m的构象个数,每个构象的权重都是exp(um),整组权重便是Ωₘexp(um)。这像比较两类商品卖出的总金额:一类单价高,另一类数量多,必须把“每个的贡献”与“有多少个”相乘以后才知道总量。链也一样,紧凑构象可能每个都因接触而获得较高权重,松散构象却可能有更多种摆法。u改变时,这两方面的竞争会重新分配整组概率。《高分子链的熵弹性:拉伸模型与参数反演》讲的构象熵,到这里就体现在Ωₘ所记录的数量之中。
自由能这一行把同一件事换了一种表达。−um来自接触能,−lnΩm来自构象数量,最后的共同常数不影响不同m之间的比较。增加吸引使第一项更偏向多接触状态;较大的构象数量则使第二项更偏向那一组。两项共同决定哪些接触数占优势。可以想象几个售票窗口:某个窗口单人的服务速度快,并不保证它完成的总人数最多,还要看有多少人进入那条队伍。此处比较的是状态的单个权重与总数量。
完整枚举十段链时,若固定第一步沿+x方向,共有1,468,313条允许路径。其余五个首步方向只把整条链旋转到别处,对于接触数和回转半径这样的旋转不变量,六倍因子在概率的分子与分母中抵消。固定第一步因此节省了计算,又保留了我们需要的统计量。程序从每个位置继续尝试所有允许方向,而不是随机选择一个可走方向就结束;这样,每一条完整路径都被数到一次。
改变接触吸引,观察整组构象的概率如何移动
拖动滑块时,构象清单没有改变,改变的是清单中每一项的权重。十段链的均方根回转半径从u=0时的1.656b变为u=2时的1.131b,平均接触数相应从1.33增至5.92。平均接触数出现小数很自然:单个构象的接触数是整数,而许多不同整数按概率平均后可以是小数。图中的概率柱比一幅单独的紧凑链照片提供了更多信息,它显示的是整个系综怎样重新分配。
短链也使我们能够检查一个容易忽略的抽样问题。如果每一步只在当前可走方向中等概率选择,某条路径可能在每一步都有五个选择,另一条路径却曾遇到只有两个选择的局面,两条完整路径最终被抽到的机会就不同。完整枚举绕开了这个生长偏差,直接为整条路径计数。本节随后产生“观测”时,也从完整的平衡分布中独立抽取,而不是把这些逐步生长的路径误当成等概率样本。
03从短链走向长链,哪些规律会留下
一百多万个姿势听起来很多,但它们属于一条只有十段的链。真实生物大分子可能包含数百到数千个重复单元,把所有姿势逐一列出会迅速变得困难。长链理论于是换了一个问题:不求每个姿势,而是考察典型尺寸随链长怎样增长。就像研究一座城市时,既可以记录每个人的位置,也可以比较人口增加后城市范围如何变化,后一种描述关注跨越许多微观细节后仍然存在的尺度关系。
Flory的链构象研究把这种思路发展成了高分子物理的重要组成部分。他在1974年的诺贝尔演讲中以大分子链的空间构象为主线,讨论局部化学结构如何联系整体统计性质。对我们眼前的问题而言,关键进展是把链段的空间占位纳入考虑:相距很远的链段沿着链没有直接相连,却会因为在空间中相遇而影响彼此。这篇演讲展示了围绕链构象建立物理描述的思路。
先看三维稀溶液中的一条很长、较柔软的链,用R表示它的典型空间尺寸。R增大时,链被展开,构象熵代价会上升;《高分子链的熵弹性:拉伸模型与参数反演》的高斯链已经告诉我们,这项代价与R²/(Nb²)同阶。R减小时,大量链段挤进更小的体积,彼此相遇的机会变多。若有效排斥占优势,这种拥挤又会增加另一项代价。两项分别偏向较小和较大的尺寸,把它们相加,就可以估计平衡尺寸所在的范围。
为什么拥挤项写成N²/R³?可以先估算链所占区域内的链段数密度,约为N/R³。两段相遇的机会与密度的平方有关,再乘整个区域的体积R³,就留下N²/R³。最后乘有效二体排除体积v,使结果成为无量纲数。v带有长度三次方的单位,综合了排斥与吸引的效果;它描述两段之间的有效作用,而不等于拿尺子测出的某个珠子体积。这里的N用作长链单元数,端点多出一个珠子的差别已进入小修正。
这是一条尺度估计,符号“∼”表示忽略不影响主要幂次关系的数值系数。把R增大一点,第一项的增长率与R/(Nb²)同阶,第二项的减少率与vN²/R⁴同阶。平衡时,两种变化大致抵消,因此R的五次方与vb²N³成正比;取五次方根,便得到N的3/5次方。即使暂时不使用微分,也可以沿着“变大使哪项上升、哪项下降”的思路理解这个极小值为何出现。
3/5约为0.6,比理想长链的1/2大。链段数增加一百倍时,理想链的典型尺寸约增大十倍,而这个良溶剂尺度估计给出约十六倍。相同的增长倍数,对应更舒展的空间安排。3/5是Flory方法给出的近似指数;长链模型还可以通过更精细的理论和数值方法研究其修正。我们在这里使用它,是为了看清排除体积如何改变链长与尺寸之间的关系,而不是为十段链强行指定一个长链指数。
进一步降低溶剂质量时,有效二体排斥会减弱。在θ条件附近,二体作用的主要贡献相互抵消,足够长链的整体尺度接近理想链的平方根关系。希腊字母θ读作theta,这种条件针对的是具体聚合物与溶剂体系。链段依然占有空间,局部结构也依然存在;相互抵消发生在粗粒化后的有效作用层面。这与把所有珠子想成可以毫无代价地重合,有着不同的物理含义。
上面的两项估计适用于v为正的舒展链。若要描写吸引占优时的紧凑状态,就要补入在高密度下限制继续压缩的物理作用,例如更高阶的排斥,或像本节格点模型这样直接禁止重叠。把负的v代入原来的两项式,吸引项会随着R趋向零而不断下降,模型就缺少了稳定尺寸所需的内容。这个现象告诉我们何时该补充模型:问题已经从稀疏链段之间的相遇,走向了密集空间中的占位。
如果一条很长的链形成密度大致恒定的紧凑球团,体积与单元数成正比,而三维体积又与尺寸的三次方成正比,于是尺寸随N的1/3次方增长。这个推理和理想链的1/2、良溶剂估计的3/5一起,构成了三种有用的参照。它们分别包含恒定密度、理想统计或有效排斥等条件。对有限长度、半柔性、带电或序列不均匀的链,实际曲线可能处在这些尺度行为之间,比较时应先检查相关物理条件。
本节的短链结果能够清楚展示概率权重和有限链收缩,但链长范围只从3到10,端点与局部几何占有很大比例。我们因此直接报告每个N和u下的尺寸,不用这几个点去宣布一个长链相变位置。这个做法也给AI的数据设计一个提示:可计算的小模型很适合检查学习流程,模型中的长度范围、环境范围与相互作用定义,则共同决定了这批标签究竟回答什么问题。
04让模型看见环境,再谈新条件预测
现在假设我们没有完整的尺寸响应表,手里只有部分条件下的观测,希望快速补出其余位置。最简单的输入是链段数N,输出是回转半径。但同一个N可以对应多个u,也就对应多个不同尺寸;只输入N的模型会把这些差别压进同一个预测里。即使换成更大的神经网络,这个输入仍然缺少区分环境的信息。把u加入输入,模型才有机会学习“同一条链在什么条件下变大或变小”。
在真实研究中,这相当于为一条序列附上测量条件。序列记录连接与化学组成,温度、盐、酸碱度或溶剂组分记录外部环境,两类信息共同定义一个数据点。若不同实验的条件已经混在同一列尺寸标签里,学习算法可能把环境造成的差别归给序列,也可能把它们当成随机噪声。把条件字段整理完整,通常比先增加模型层数更直接地改变可学习的问题。数据表的每一行,都应对应一个能重新描述的样品与条件组合。
2024年,Lotthammer等人提出ALBATROSS,用循环神经网络从无序蛋白质区段的序列预测系综性质,训练标签来自分子模拟。原研究的相关模拟采用300K和150mM隐式盐条件。这个例子展示了序列与统计尺寸之间可以建立快速预测关系,也说明标签包含其生成环境。要研究另一套环境,就应把新条件及其响应接入学习任务。原始研究给出了模型与模拟设置。
我们用一个较小的核回归模型把这件事做完整。它与神经网络都能从数据学习输入到输出的关系,但组织预测的方式不同:核回归比较新样本与已有训练样本有多相似,再组合训练得到的权重。样本只有几十条时,这种方法的计算过程很容易展开,便于逐步查看环境输入在哪里发挥作用。后面处理真实序列和分子图时,我们再使用能够学习更复杂表示的网络。
先把预测目标换成一个更便于比较的量。链越长,尺寸本来就会变大;我们用同样N和b的理想自由连接链作为参照,将当前尺寸除以参考尺寸。第五节已经推导了N段、N+1个等质量珠子的有限长度修正,因此这里直接保留它。这样得到的比值y没有单位,y大于1表示相对理想参考更舒展,小于1表示更紧凑。参照是一个规定清楚的基准,其本身不依赖训练标签。
例如N=10、b=1时,理想参考为√(120/66),约1.348。前面的无吸引自避免链尺寸约为1.656,比值约1.229;当u增至2,尺寸约为1.131,比值约0.839。一个比值把链长的基本影响与环境导致的偏离分开,模型便可以集中学习这种偏离。预测完成后,乘回理想参考就恢复实际模型长度单位。代码里从头到尾都保留这一步换算,图中也显示换算后的尺寸。
为了计算相似度,输入写成两个无量纲数:N/10与u。除以10只是选定一个固定的数值尺度,不需要查看测试标签。对两个输入,分别计算每个方向上的差别,再除以该方向的核长度ℓ,平方、相加,最后放进负指数。这里ℓ描述输入空间中多大的变化仍算相近,与分子的持久长度是不同的参数。用下标d表示输入维度,两个维度就是链长方向和环境方向。
当两个输入完全相同时,指数为0,相似度为1;如果只有某一维相差一个对应的ℓ,相似度就是exp(−1/2),约0.607;相差两个ℓ时则降为约0.135。这种逐渐降低的权重比“相同或不同”的二分判断更细致。较小的ℓ使模型主要参考附近样本,较大的ℓ让较远条件之间也能相互影响。我们会用单独的验证条件选择这些尺度,观察哪种相似度定义更适合当前数据。
接下来需要让相似度真正参与学习。将所有训练样本两两比较,形成矩阵K;第i行、第j列的元素就是第i与第j条训练记录的相似度。α是一列待求权重,长度与训练记录数相同。方程右边的y−1表示训练尺寸相对于理想参考的偏离。单位矩阵I只有对角线上是1,λI在求解中起正则化作用,让模型对观测中的细小波动更平稳。代码使用线性方程求解器一次求出全部α。
不熟悉矩阵也可以从联立方程理解这一步:每条训练记录都提供一个希望匹配的数值,所有权重需要共同满足这些关系。求得权重后,预测新输入只需要计算它与各训练输入的相似度,将相似度乘上对应α后相加,最后加回参考值1。α可以为正也可以为负,因为它们共同拟合曲线,而不是分别代表某个构象出现的概率。先前的玻尔兹曼概率与这里的学习权重,分别承担不同的工作。
本节把u=0、0.25、0.5、0.75、1的五组条件用于训练,每组包含N=3至10的八条记录,共40条。四组夹在其间的条件用于验证,共32条,选择链长核尺度、环境核尺度和正则化强度。u=1.25、1.5、1.75、2留给新环境评价。每个u下的所有链长一起进入对应集合,因此模型面对的是整组新条件。链长在集合之间保持相同,是为了单独研究环境推广能力。
标签来自完整平衡分布中的独立抽样:每个条件抽取10000个构象,计算一次均方根回转半径。它们围绕枚举得到的精确值有小幅统计波动。训练时模型只接触抽样观测,评价时我们用完整枚举作为参考。只输入N的模型与同时输入N和u的模型采用相同的训练记录、目标归一化和验证流程,差别集中在有没有环境输入。验证集合参与了参数选择,因此它描述的是选择过程中的表现,新环境集合才承担最终评价。
05运行一次,再用三组新观测更新模型
完整程序分成几个相互连接的步骤。首先递归枚举三维链,把每个构象的接触数与回转半径平方记录为直方图;相同统计值对应的不同路径通过计数保留。随后按指定u赋权,产生独立观测,划分训练、验证与新环境数据。接着比较两类核回归,并在u=1.5补充N=4、6、8的三条观测,学习一个修正项。最后保存完整样本、模型权重和六幅结果图,下面的代码可以整体复制运行。
枚举产生的联合直方图非常适合重复利用。同一份构象清单只需改变权重,就能计算许多个u;同样的接触数中,回转半径也可能不同,因此程序保留“接触数、尺寸平方、出现次数”的组合。这里用整数形式存储回转半径平方的分子,最后统一除以(N+1)²,可以避免在直方图的键值中比较浮点小数。这个整数式来自质心恒等式:珠子数乘坐标平方和,再减去坐标总和的平方。
三组新观测如何加入已有模型?先用旧模型预测这三个位置,再将观测减去预测,得到残差。残差若为正,说明原预测在该位置偏小;若为负,则说明偏大。随后只用这三个残差训练一个核修正项,并把它加到原预测上。核尺度和正则化参数沿用先前验证选择的值,所以新增标签用于学习修正权重,不再用新环境的评分结果选择修正强度。这个小实验展示了如何把新测量接入已有预测流程。
下标A表示新增的三条记录,β是修正项的三个待求权重。KA是三条新增记录之间的相似度矩阵,大小为3×3。理解这条式子时,可以先想象只有一条新增观测:它在附近提供一次向上或向下的修正,影响随距离逐渐降低。三条记录则共同确定一片区域的修正形状。旧模型保留了已有学习结果,新观测增加了一层具体条件下的信息,更新后的表现需要重新在未观测位置上检查。
评价名单也随之明确:原本32条新环境记录中,有三条已用于更新,剩余29条继续保留作评价。我们同时报告u=1.5下另外五种链长的误差,观察补测条件附近的变化,以及全部29个点的误差,观察修正向其他环境传播的效果。两次比较都使用同一组未观测目标。评价指标是相对绝对误差的平均值:每个预测与参考值之差取绝对值,除以该点参考尺寸,再对所有评价点平均并乘100%。
"""Environment-conditioned learning from exactly enumerated 3D lattice chains.
Run with Python, NumPy and Matplotlib. All distances use lattice step b = 1.
The generated observations are independent samples from the model, not lab data.
"""
from pathlib import Path
from collections import defaultdict
import json
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

OUT = Path("solvent_outputs")
OUT.mkdir(exist_ok=True)
DIRS = ((1,0,0), (-1,0,0), (0,1,0), (0,-1,0), (0,0,1), (0,0,-1))
NS = np.arange(3, 11)
TRAIN_U = [0, .25, .5, .75, 1]
VALID_U = [.125, .375, .625, .875]
NEW_U = [1.25, 1.5, 1.75, 2]
ADAPT_N = [4, 6, 8]
OBSERVATIONS = 10000
COLORS = ["#247968", "#c46c46", "#596d99", "#b3945d"]
plt.rcParams.update({"font.family":"DejaVu Sans", "font.size":11,
    "axes.spines.top":False, "axes.spines.right":False,
    "axes.labelcolor":"#273b36", "text.color":"#273b36",
    "svg.hashsalt":"ai4s-L07", "savefig.facecolor":"#fffdf8"})


def enumerate_chains():
    # A histogram preserves multiplicity: distinct walks can share both m and Rg2.
    tables = [defaultdict(int) for _ in range(11)]
    occupied = {(0,0,0), (1,0,0)}
    points = [(0,0,0), (1,0,0)]
    representatives = {}

    def visit(n, position, contacts, sx, sy, sz, squared_sum):
        beads = n+1
        numerator = beads*squared_sum-sx*sx-sy*sy-sz*sz
        tables[n][(contacts, numerator)] += 1
        if n == 10:
            if contacts not in representatives:
                representatives[contacts] = [list(p) for p in points]
            return
        for dx, dy, dz in DIRS:
            new = (position[0]+dx, position[1]+dy, position[2]+dz)
            if new in occupied:
                continue
            # The previous bead is always adjacent; its chemical bond is excluded.
            added = sum((new[0]+a,new[1]+b,new[2]+c) in occupied
                        for a,b,c in DIRS)-1
            occupied.add(new); points.append(new)
            visit(n+1, new, contacts+added, sx+new[0], sy+new[1], sz+new[2],
                  squared_sum+sum(v*v for v in new))
            points.pop(); occupied.remove(new)

    visit(1, (1,0,0), 0, 1,0,0,1)
    histograms = {}
    for n in range(1,11):
        histograms[n] = np.array([[m, a, count] for (m,a),count
                                  in sorted(tables[n].items())], dtype=float)
    return histograms, representatives


def distribution(histograms, n, u):
    table = histograms[int(n)]
    contacts, numerator, counts = table.T
    log_weight = np.log(counts)+u*contacts
    weight = np.exp(log_weight-log_weight.max())
    weight /= weight.sum()
    rg2 = numerator/(n+1)**2
    return contacts, rg2, weight


def exact_response(histograms, n, u):
    m, rg2, probability = distribution(histograms, n, u)
    return float(np.sqrt(probability@rg2)), float(probability@m)


def ideal_size(n):
    n = np.asarray(n)
    return np.sqrt(n*(n+2)/(6*(n+1)))


def observation(histograms, n, u, rng):
    _, rg2, probability = distribution(histograms, n, u)
    counts = rng.multinomial(OBSERVATIONS, probability)
    observed = np.sqrt(counts@rg2/OBSERVATIONS)
    mean = probability@rg2
    variance = probability@((rg2-mean)**2)
    # Delta-method standard error of sqrt(mean Rg2), valid for a large sample.
    se = np.sqrt(variance/OBSERVATIONS)/(2*np.sqrt(mean))
    return float(observed), float(se)


def kernel(a, b, lengths):
    difference = (np.asarray(a)[:,None,:]-np.asarray(b)[None,:,:])/lengths
    return np.exp(-.5*np.sum(difference*difference, axis=2))


def fit_kernel(x, y, lengths, regularization, mean=1.):
    matrix = kernel(x, x, lengths)+regularization*np.eye(len(x))
    weights = np.linalg.solve(matrix, y-mean)
    return {"x":x.tolist(), "weights":weights.tolist(), "lengths":list(lengths),
            "regularization":regularization, "mean":mean}


def predict(model, x):
    return model["mean"]+kernel(x, model["x"], model["lengths"])@model["weights"]


def select_model(x, y, train, validation, condition):
    choices = []
    for ln in [.25, .5, 1.]:
        for lu in ([.25, .5, 1., 2.] if condition else [None]):
            lengths = [ln, lu] if condition else [ln]
            for reg in [1e-5, 1e-4, 1e-3]:
                model = fit_kernel(x[train], y[train], lengths, reg)
                loss = float(np.mean((predict(model,x[validation])-y[validation])**2))
                choices.append((loss, model))
    loss, model = min(choices, key=lambda item:item[0])
    model["validation_mse"] = loss
    return model


def main():
    histograms, representatives = enumerate_chains()
    full_counts = [int(6*histograms[n][:,2].sum()) for n in range(1,11)]
    assert full_counts == [6,30,150,726,3534,16926,81390,387966,1853886,8809878]
    rng = np.random.default_rng(707)
    rows = []
    for split, conditions in [("train",TRAIN_U),("validation",VALID_U),("new",NEW_U)]:
        for u in conditions:
            for n in NS:
                observed, se = observation(histograms, int(n), u, rng)
                exact, contacts = exact_response(histograms, int(n), u)
                role = "adapt" if split=="new" and u==1.5 and n in ADAPT_N else split
                rows.append({"N":int(n),"u":u,"split":role,"observed_Rg":observed,
                    "standard_error_Rg":se,"exact_Rg":exact,"exact_contacts":contacts})
    x = np.array([[r["N"]/10,r["u"]] for r in rows])
    ns = np.array([r["N"] for r in rows])
    scale = ideal_size(ns)
    y = np.array([r["observed_Rg"] for r in rows])/scale
    exact = np.array([r["exact_Rg"] for r in rows])
    role = np.array([r["split"] for r in rows])
    train, val, adapt, test = [role==name for name in ["train","validation","adapt","new"]]
    baseline = select_model(x[:,:1],y,train,val,False)
    conditioned = select_model(x,y,train,val,True)
    # A residual learner uses just three newly observed labels; test labels stay hidden.
    correction = fit_kernel(x[adapt], y[adapt]-predict(conditioned,x[adapt]),
        conditioned["lengths"],conditioned["regularization"],mean=0.)
    estimates = {"N_only":predict(baseline,x[:,:1])*scale,
        "conditioned":predict(conditioned,x)*scale,
        "updated":(predict(conditioned,x)+predict(correction,x))*scale}
    assert all(np.all(v>0) for v in estimates.values())
    metrics = {}
    for group, mask in [("validation_selected",val),("new_conditions",test),
                        ("u_1p5_unmeasured_N",test & (x[:,1]==1.5))]:
        metrics[group] = {key:float(100*np.mean(abs(p[mask]-exact[mask])/exact[mask]))
                          for key,p in estimates.items()}
    for i,row in enumerate(rows):
        row["predictions"] = {key:float(p[i]) for key,p in estimates.items()}
    # Independent repeated equilibrium samples quantify sampling scatter for one point.
    replicate_rng = np.random.default_rng(1707)
    repeat = np.array([observation(histograms,10,1.5,replicate_rng)[0] for _ in range(100)])
    reference = exact_response(histograms,10,1.5)[0]
    declared_se = observation(histograms,10,1.5,np.random.default_rng(2707))[1]
    derivative_checks = []
    for n in [4,7,10]:
        for u in [0,.5,1,1.5,2]:
            m, rg2, p = distribution(histograms,n,u)
            variance_m = p@((m-p@m)**2)
            covariance = p@((rg2-p@rg2)*(m-p@m))
            eps = 1e-5
            plus = exact_response(histograms,n,u+eps)
            minus = exact_response(histograms,n,u-eps)
            derivative_checks.extend([abs((plus[1]-minus[1])/(2*eps)-variance_m),
                abs((plus[0]**2-minus[0]**2)/(2*eps)-covariance)])
    # Every saved illustrative path satisfies the constraints and contact count.
    for m,path in representatives.items():
        points = np.array(path)
        assert len(set(map(tuple,path))) == len(path)
        assert np.all(np.sum(abs(np.diff(points,axis=0)),axis=1)==1)
        counted = sum(np.sum(abs(points[i]-points[j]))==1
                      for i in range(len(points)) for j in range(i+2,len(points)))
        assert counted == m
    z = [(r["observed_Rg"]-r["exact_Rg"])/r["standard_error_Rg"] for r in rows]
    check = {"enumerated_counts_all_orientations":full_counts,
        "first_direction_fixed_N10":full_counts[-1]//6,
        "response_derivative_max_error":float(max(derivative_checks)),
        "max_sampling_abs_z":float(np.max(np.abs(z))),
        "replicate_standard_error_ratio":float(repeat.std(ddof=1)/declared_se),
        "replicate_mean_z":float((repeat.mean()-reference)/(declared_se/10)),
        "train_rows":int(train.sum()),"validation_rows":int(val.sum()),
        "adapt_rows":int(adapt.sum()),"test_rows":int(test.sum())}
    assert check["response_derivative_max_error"] < 1e-7
    assert set(TRAIN_U).isdisjoint(VALID_U+NEW_U)
    assert not np.any(adapt & test)
    results = {"model":"3D cubic lattice; N segments, N+1 equal beads; no repeated site; E=-epsilon*m",
        "units":"b=1 lattice step; u=epsilon/(kBT); Rg is sqrt(mean Rg2)",
        "observation_source":"10000 independent equilibrium draws per (N,u) from exact joint histogram",
        "train_u":TRAIN_U,"validation_u":VALID_U,"new_u":NEW_U,
        "adaptation":{"u":1.5,"N":ADAPT_N,"method":"three-label residual kernel regression"},
        "models":{"N_only":baseline,"conditioned":conditioned,"correction":correction},
        "metrics_relative_mae_percent":metrics,"checks":check,
        "N10_u0_Rg":exact_response(histograms,10,0)[0],
        "N10_u2_Rg":exact_response(histograms,10,2)[0],
        "N10_u0_contacts":exact_response(histograms,10,0)[1],
        "N10_u2_contacts":exact_response(histograms,10,2)[1],
        "replicate_observations":repeat.tolist()}
    sample_output = {"rows":rows,"histograms":{str(n):h.astype(int).tolist() for n,h in histograms.items()},
        "histogram_columns":["contacts","Rg2_numerator","multiplicity_first_step_fixed"],
        "representative_paths":representatives,
        "representatives_note":"First enumerated path for each contact count, illustrative, not an equilibrium sample."}
    (OUT/"samples.json").write_text(json.dumps(sample_output,indent=2),encoding="utf-8")
    (OUT/"results.json").write_text(json.dumps(results,indent=2),encoding="utf-8")

    def panel(ax, name):
        if name == "populations":
            for u,c in zip([0,1,2],COLORS):
                m,_,p = distribution(histograms,10,u)
                prob = np.bincount(m.astype(int),weights=p,minlength=8)
                ax.plot(np.arange(8),prob,"o-",color=c,label=f"u = {u}")
            ax.set(xlabel="Nonbonded contacts m",ylabel="Probability",title="A  Multiplicity and attraction, N = 10")
            ax.legend(frameon=False)
        elif name == "response":
            us = np.linspace(0,2,81)
            for n,c in zip([4,6,8,10],COLORS):
                ax.plot(us,[exact_response(histograms,n,u)[0] for u in us],c=c,label=f"N = {n}")
            ax.axvline(1,c="#8b9590",ls="--",lw=1)
            ax.set(xlabel="Attraction / thermal energy, u",ylabel="RMS radius of gyration / b",title="B  Exact finite-chain response")
            ax.legend(frameon=False,ncol=2)
        elif name == "conditional":
            us = np.linspace(0,2,121); xx = np.c_[np.ones(len(us)),us]
            truth = [exact_response(histograms,10,u)[0] for u in us]
            ax.axvspan(1,2,color="#eee2cd",alpha=.55,label="New conditions")
            ax.plot(us,truth,c=COLORS[0],lw=2.5,label="Exact enumeration")
            ax.plot(us,predict(baseline,xx[:,:1])*ideal_size(10),c=COLORS[2],ls=":",label="N only")
            ax.plot(us,predict(conditioned,xx)*ideal_size(10),c=COLORS[1],ls="--",label="N and u")
            mask = train & (ns==10)
            ax.scatter(x[mask,1],y[mask]*scale[mask],s=25,c="#273b36",zorder=5)
            ax.set(xlabel="u",ylabel="RMS radius of gyration / b",title="C  Same chain, different conditions")
            ax.legend(frameon=False,fontsize=9)
        elif name == "adaptation":
            xx = np.c_[NS/10,np.full(len(NS),1.5)]; scales = ideal_size(NS)
            ax.plot(NS,[exact_response(histograms,int(n),1.5)[0] for n in NS],"o-",c=COLORS[0],label="Exact enumeration")
            ax.plot(NS,predict(conditioned,xx)*scales,"--",c=COLORS[1],label="Before new labels")
            ax.plot(NS,(predict(conditioned,xx)+predict(correction,xx))*scales,"-.",c=COLORS[2],label="After 3 new labels")
            ax.scatter(ns[adapt],y[adapt]*scale[adapt],marker="*",s=150,c=COLORS[3],edgecolor="#806235",zorder=5,label="New observations")
            ax.set(xlabel="N / segments",ylabel="RMS radius of gyration / b",title="D  Updating at u = 1.5")
            ax.legend(frameon=False,fontsize=9)
        elif name == "errors":
            groups = ["new_conditions","u_1p5_unmeasured_N"]
            for i,group in enumerate(groups):
                vals = [metrics[group][key] for key in ["N_only","conditioned","updated"]]
                bars = ax.bar(np.arange(3)+(i-.5)*.36,vals,width=.36,color=COLORS[i],label=["All 29 held-out points","5 unmeasured N at u = 1.5"][i])
                ax.bar_label(bars,fmt="%.2f",padding=3,fontsize=9)
            ax.set_xticks(range(3),["N only","N and u","+ 3 labels"])
            ax.set(ylabel="Mean absolute relative error / %",title="E  Errors on unobserved targets")
            ax.margins(y=.22); ax.legend(frameon=False,fontsize=9)
        else:
            ax.hist((repeat-reference)/declared_se,bins=np.linspace(-4,4,19),color=COLORS[0],alpha=.75,edgecolor="white")
            ax.axvline(0,c=COLORS[1],lw=2,label="Exact equilibrium mean")
            ax.set(xlabel="(Sample RMS Rg - exact RMS Rg) / SE",ylabel="Repeated observations / count",title="F  100 independent observations, N = 10")
            ax.text(.04,.92,"u = 1.5; 10,000 draws each",transform=ax.transAxes,fontsize=10)
            ax.legend(frameon=False,fontsize=9)
        ax.grid(alpha=.15)

    keys = ["populations","response","conditional","adaptation","errors","sampling"]
    for name in keys:
        fig,ax = plt.subplots(figsize=(6.5,4.8),layout="constrained",facecolor="#fffdf8")
        panel(ax,name); fig.savefig(OUT/(name+".svg"),metadata={"Date":None}); plt.close(fig)
    fig,axes = plt.subplots(3,2,figsize=(16,16),layout="constrained",facecolor="#fffdf8")
    for ax,name in zip(axes.flat,keys): panel(ax,name)
    fig.savefig(OUT/"solvent_diagnostics.svg",metadata={"Date":None})
    fig.savefig(OUT/"solvent_diagnostics.png",dpi=160,metadata={"Software":"Matplotlib"}); plt.close(fig)
    print("Exact 3D walks (N=10, first direction fixed):",full_counts[-1]//6)
    print("Train / validation / new labels / untouched test:",train.sum(),val.sum(),adapt.sum(),test.sum())
    print("Selected conditional lengths, regularization:",conditioned["lengths"],conditioned["regularization"])
    for group in ["new_conditions","u_1p5_unmeasured_N"]:
        print(group,"relative MAE (%):",{k:round(v,3) for k,v in metrics[group].items()})
    print("Response derivative check:",f'{max(derivative_checks):.2e}')
    print("Independent replicate scatter / predicted SE:",round(check["replicate_standard_error_ratio"],3))
    print("Saved six figures, equilibrium histograms, observations and learned weights.")


if __name__ == "__main__":
    main()
本次实际运行输出
Exact 3D walks (N=10, first direction fixed): 1468313
Train / validation / new labels / untouched test: 40 32 3 29
Selected conditional lengths, regularization: [0.25, 2.0] 1e-05
new_conditions relative MAE (%): {'N_only': 16.693, 'conditioned': 2.113, 'updated': 1.93}
u_1p5_unmeasured_N relative MAE (%): {'N_only': 16.283, 'conditioned': 1.613, 'updated': 1.469}
Response derivative check: 9.60e-11
Independent replicate scatter / predicted SE: 0.935
Saved six figures, equilibrium histograms, observations and learned weights.
一次运行 · 六幅结果图
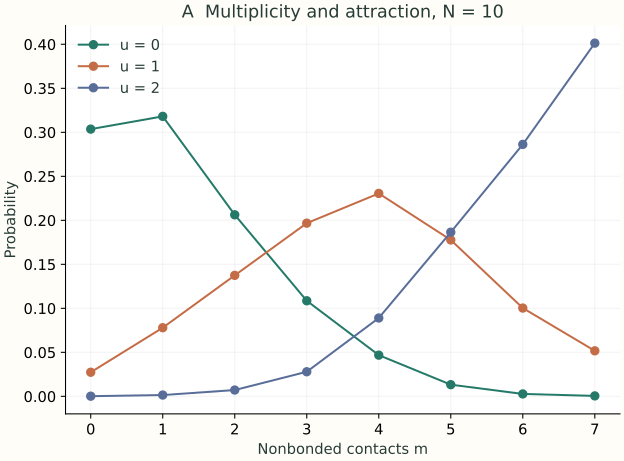
A · 同一条十段链,不同接触数的总概率随吸引参数u改变;每类内部的构象数已计入。
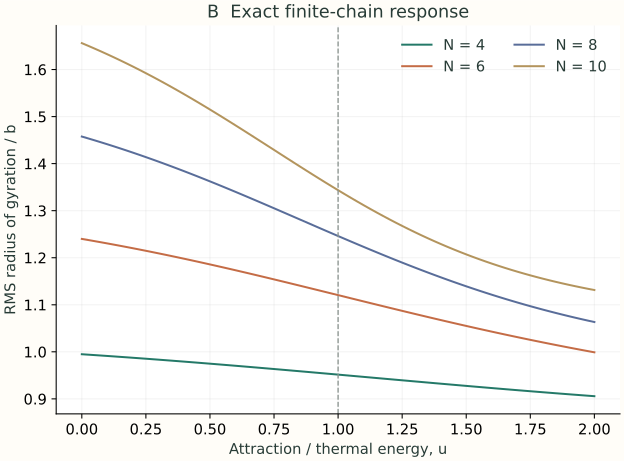
B · 四种链长的完整枚举结果,虚线右侧为学习任务中的新条件范围。
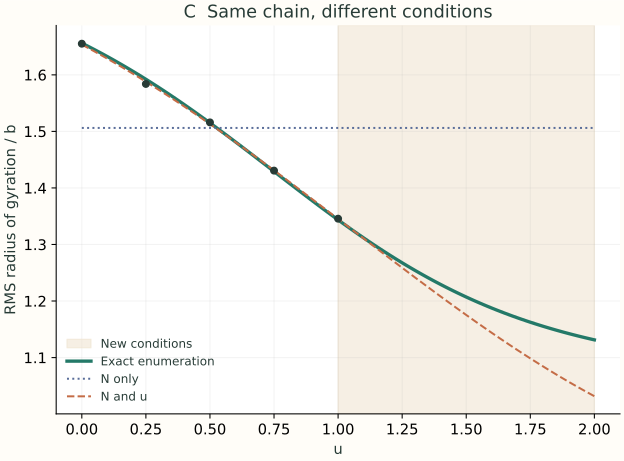
C · 只输入链长时,同一条链只能得到一个预测;加入环境参数后可学习变化趋势。
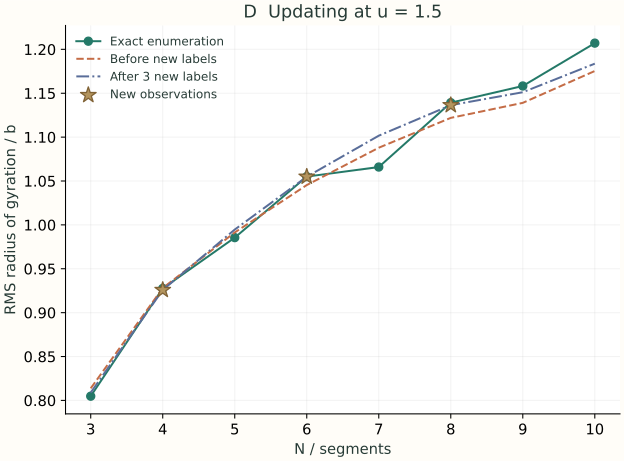
D · 在u=1.5补充三组观测,星号是更新用的链长,其余五种链长留作评价。
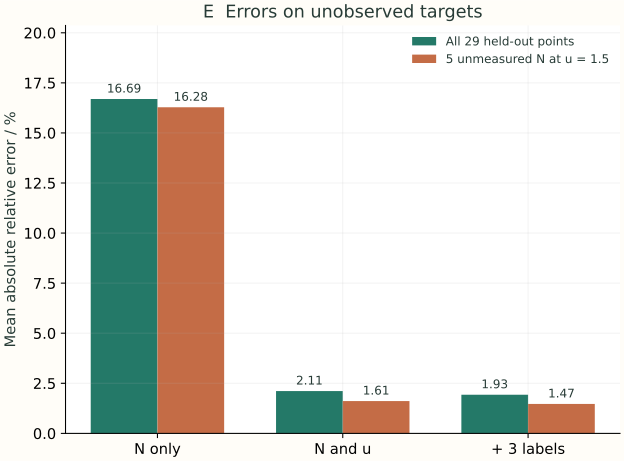
E · 所有29个未观测新条件点与u=1.5的五个未观测链长分别评分;三组新增标签均不计入评分。
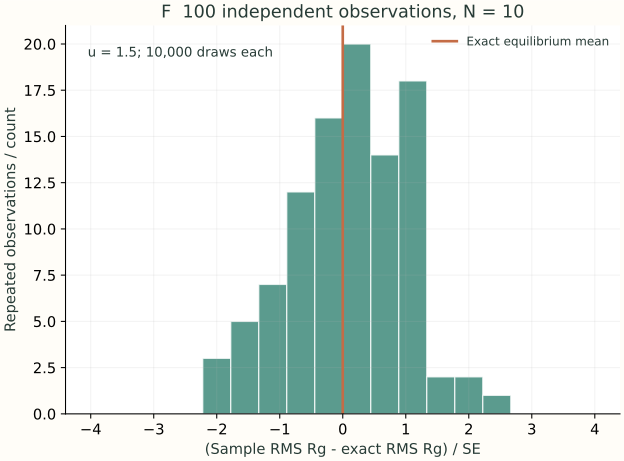
F · 固定N=10、u=1.5,重复100次独立抽样,每次10000个构象,观察平均尺寸的统计波动。
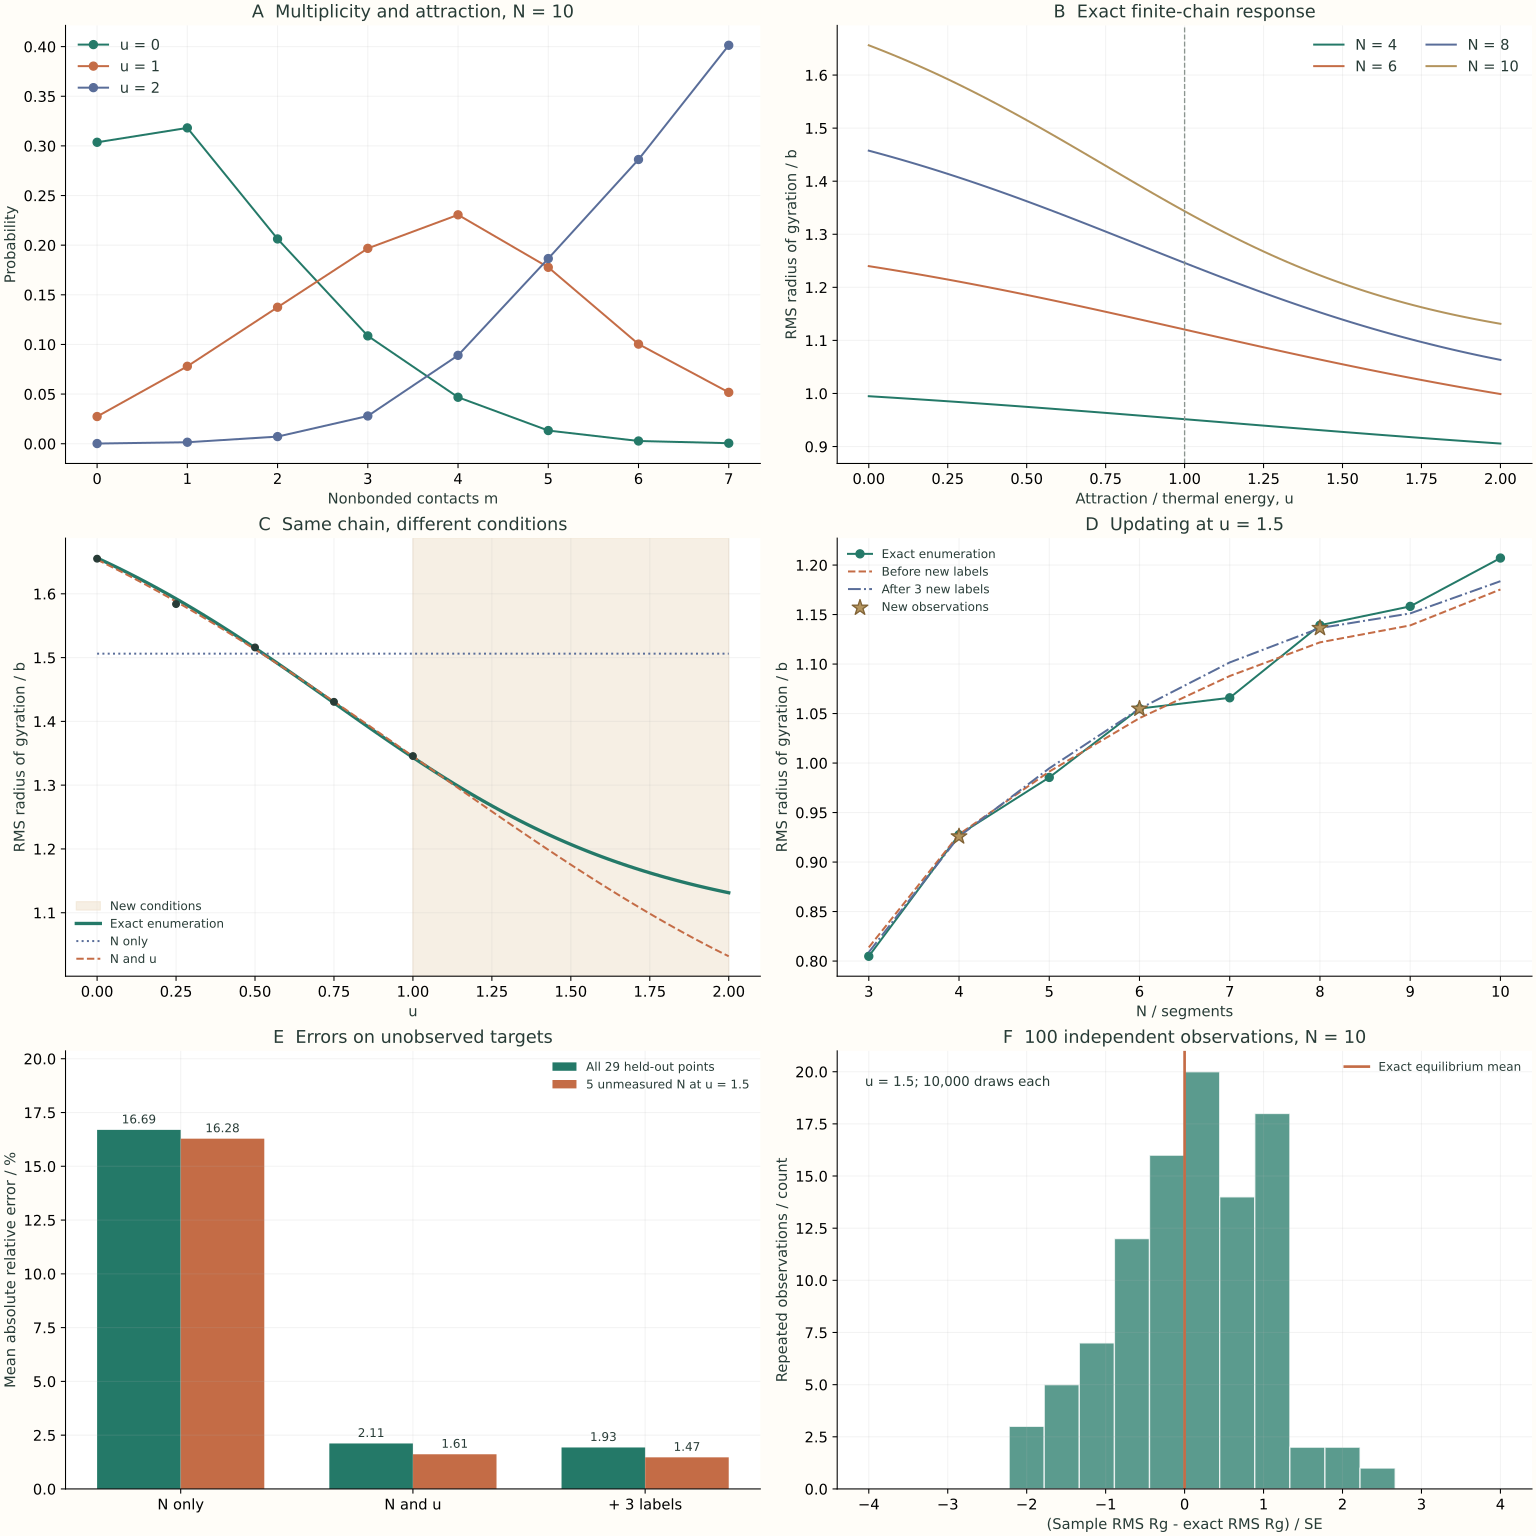
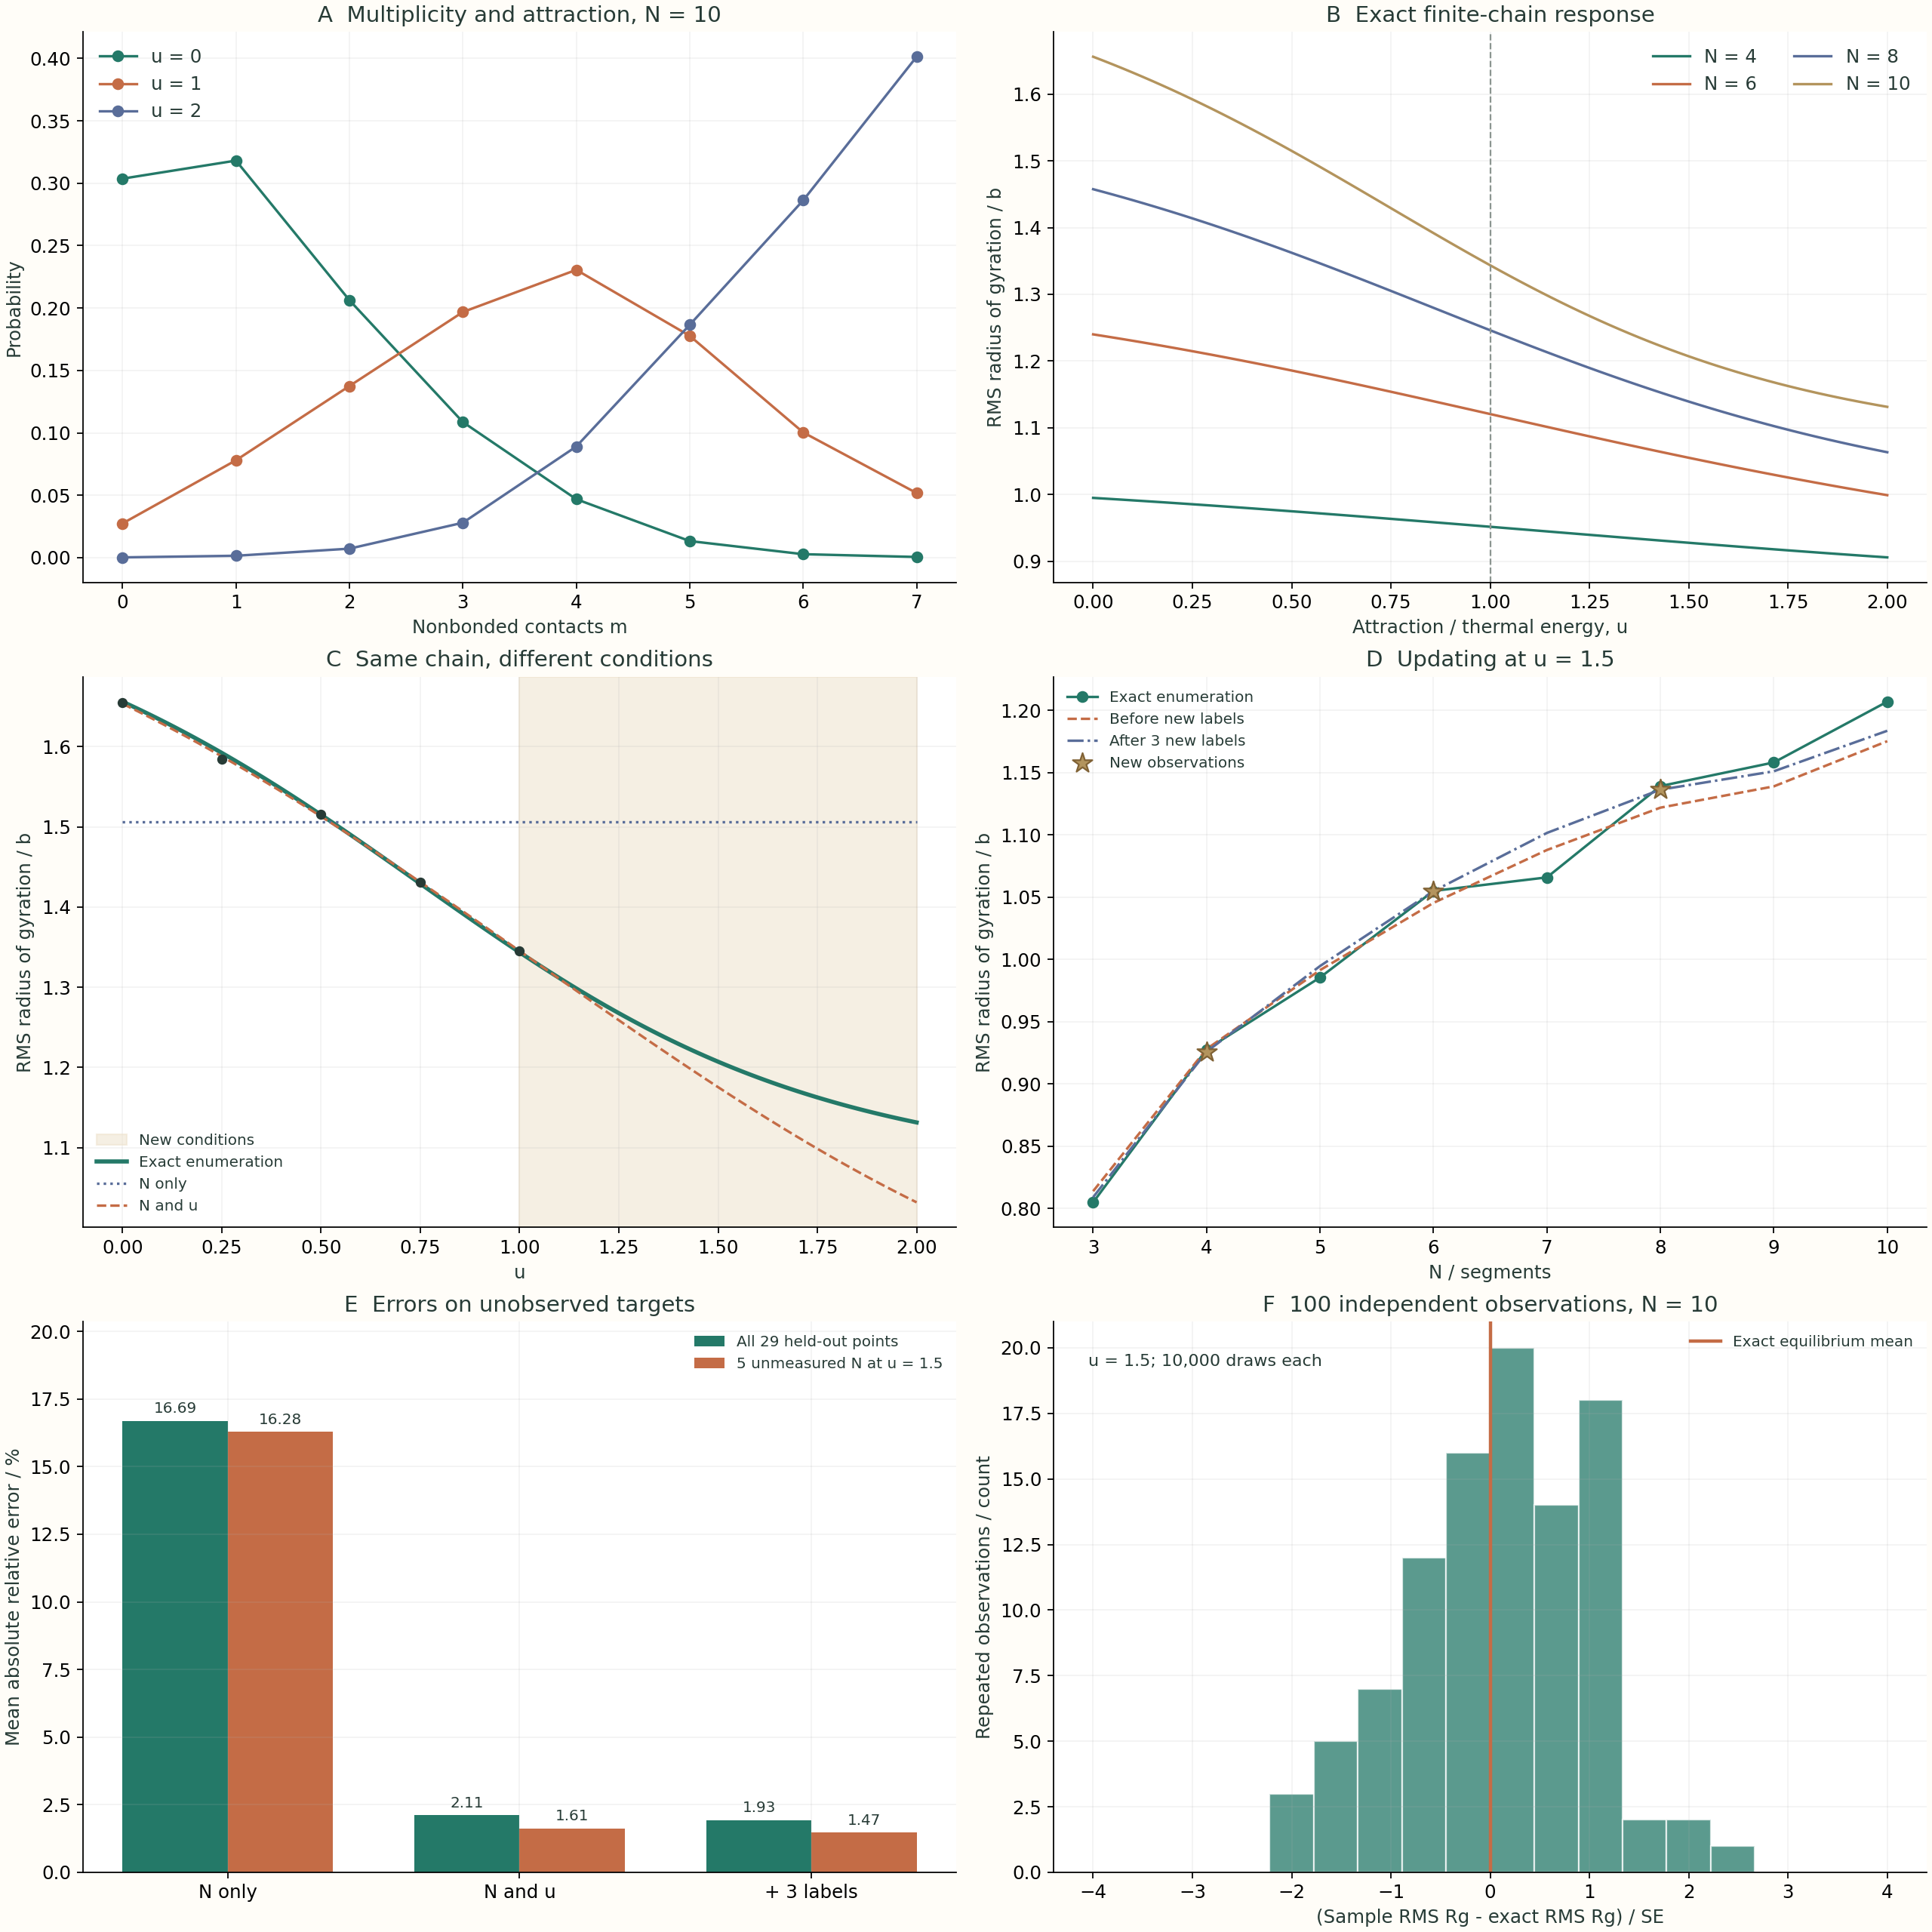
先看图A与图B,它们给出学习之前的物理答案。吸引增大,多接触组的总概率上升,同一条链的平均尺寸随之缩小。N较大的链在本例中具有更多接触与空间安排的可能,但每条曲线都是对应有限链的完整平衡计算。图C将这个答案与学习结果放在一起:只输入N的模型对N=10画出一条水平线,因为它无法识别横轴上的u;加入u后,模型才能沿着环境方向改变预测。
在29个未观测新条件点上,只输入链长的模型平均相对绝对误差为16.69%,加入环境后的模型为2.11%。两个模型都经过数据拟合,差别首先来自输入是否保留了决定响应的信息。这个例子也解释了为何研究数据的条件字段很有价值:环境并不是可以随手附在表格末尾的备注,而是预测关系的一部分。模型越需要跨条件使用,就越需要在数据中明确记录这些条件。
补充三组观测后,全部29个点上的误差变为1.93%;在u=1.5的五种未观测链长上,误差从1.61%变为1.47%。这次改善是逐步的,三条数据并没有把整个响应面一次补齐。图D能进一步显示修正发生在哪些链长附近,图E则将局部与整体评价并排展示。如果只盯着一个总分,就容易忽略某些区域已经改善、另一些区域仍然需要数据的情况。
图D在N=7附近的变化还值得回到构象表中查看。枚举显示,N从6增至7时,最大可能接触数由3变成5;从7增至8时,这个最大值仍为5。多加一个珠子会开放新的紧凑摆法,有限格点链的几何机会因而具有离散变化。高斯核则倾向于把邻近输入连接成平滑关系,在这类位置容易留下局部误差。把误差图与接触分布对照,就能找到比“模型还不够复杂”更具体的研究线索。
更新还会影响原有范围。先前验证条件上的误差由0.15%变为0.64%,说明这次残差修正向较远条件传播时,也改变了原来已经较准确的预测。这与选中的环境核尺度有关:核越宽,一条新增观测影响的区域越广。后续可以在新增条件上再划分独立验证记录,比较更局部的修正,或者联合旧数据重新拟合。此处把原范围和新范围都检查一遍,便能据实际变化决定下一次该补充什么信息。
图F把另一种误差单独拿出来:观测本身也会波动。固定N=10和u=1.5,重复100次独立观测,每次都重新抽取10000个构象,得到的平均尺寸围绕精确平衡值分布。横轴用标准误差归一化,标准误差描述这种平均值在重复观测间的典型波动。单个构象的大小变化通常比平均值大得多;增加独立构象数会让平均值更稳定。这里各次抽样相互独立,因此可以直接观察这一统计效应。
将这样的计算接到生物研究中,第一步是明确要预测的分子与尺寸定义,第二步是把环境条件作为输入保存,第三步是在未用于训练的新条件下获取观测。若研究的是特定蛋白质片段,就需要保留序列,并用相应测量或经过比较的分子模型建立标签;若研究的是多糖或核酸,还要加入影响响应的连接、分支或离子信息。短链实验提供了一套能够逐步检查的流程,后续章节将把这些化学内容接入表示和模型。
本节一直比较“在某个条件下,平衡时有哪些姿势以及各占多少”。滑块移动后,我们立即重算平衡分布;真实分子则需要经历一连串运动才能改变状态。环境刚发生变化时,链是否来得及达到新的分布,取决于它怎样运动、哪些动作受到阻碍,以及观察持续了多久。《高分子链动力学:Rouse模型、扩散与松弛》把这条时间线接上,从尺寸的统计走向链的动力学,并让学习模型处理随时间变化的轨迹。
资料与延伸阅读
科学史图均为依据相关研究问题绘制的概念示意。格点构象、概率分布、观测样本和学习结果由本页程序生成,长度以格点步长b为单位。完整样本文件保留联合直方图、独立抽样标签和数据划分,结果文件保留拟合权重、选定参数与评价数值。
- Flory, P. J. Spatial Configuration of Macromolecular Chains. Nobel Lecture, 1974. 从链的局部结构理解大分子空间构象的历史资料。
- Sherman, E. & Haran, G. Coil-globule transition in the denatured state of a small protein. PNAS 103, 11539–11543 (2006). DOI: 10.1073/pnas.0601395103。
- Lotthammer, J. M. et al. Direct prediction of intrinsically disordered protein conformational properties from sequence. Nature Methods 21, 465–476 (2024). DOI: 10.1038/s41592-023-02159-5。