从回缩的直觉走向分子测量
高分子链的熵弹性:拉伸模型与参数反演
拉开一根橡皮筋再松手,它会缩回来。这个熟悉的动作里藏着一个分子尺度的问题:如果链上的每一段都没有明显变长,只是原来弯弯曲曲的姿势被展开,为什么仍然需要用力?答案与一条链可以摆出的姿势有关。本节从四步长的小链开始计数,把构象机会逐步变成自由能和恢复力,再走到真实DNA的拉伸曲线。
拉伸实验给出的是一组力和伸长值,我们想知道的却是链的轮廓长度和持久长度。持久长度描述链沿轮廓走多远以后还保留多少原来的方向;它越大,链通常越不容易弯曲。由参数计算曲线叫正向计算,由曲线寻找参数叫反演。本节让物理拟合与神经网络都完成这项反演,并保持每条曲线的测量点数相同,只改变拉力覆盖范围。我们由此能比较:算法换了以后答案怎样变化,把测量做到更有辨别力的位置又会带来什么变化。
01先数一数,链可以怎样摆
《高分子链尺寸:末端距、回转半径与标度关系》用自由连接链说明,同样的链段数和段长可以产生许多空间姿势。现在先把三维空间收窄成一条直线,让每一段只能向左或向右,段长仍为b。这种小模型很适合计数:四段链共有2×2×2×2=16种方向顺序。第一步向右、第二步向左,与第一步向左、第二步向右,是不同的路径,尽管它们都可能到达相同的终点。我们要数的正是这些可区分的路径。
四步走完后,末端可以停在−4b、−2b、0、2b和4b五个位置。要到4b,四步必须全向右,只有一种顺序;要到2b,需要三步向右、一步向左,把那一步向左放在四个不同位置,就得到四种顺序;要回到0,需要两步向右、两步向左,共有六种。另一半由左右对称得到。因此,五个位置分别对应1、4、6、4、1种构象,加起来恰好是16。
用稍一般的符号记录这个过程。N是总步数,n+是向右的步数,向左的步数自然为N−n+。两者相减,再乘每步长度,就得到带方向的末端位移z。构象数用希腊字母Ω表示,读作omega;组合数C(N,n+)表示从N个位置里选出哪些位置向右,其余位置自动向左。式子里看起来较高的括号,就是这个组合数的常见写法。
只要所有完整的左右顺序具有相同机会,某个末端位置的概率就是它对应的构象数除以16。中心的概率为6/16,最右端为1/16。我们因此可以说,把这条小链的末端限制在最右端,比允许它停在中心附近,更强地限制了可选构象。这个结论完全来自计数,不需要假设每个链段是一根被拉长的小弹簧。模型里的段长从始至终都保持不变,变化发生在方向选择上。
可以把它类比成安排四个人坐座位:自由安排有许多次序,附加条件越具体,满足条件的安排通常越少。类比中的“选择”说的是可能性,而分子姿势的变化来自热运动。链没有意图,也不需要知道自己在哪里;它与周围环境不断交换能量,不同状态出现的统计机会由整个体系的物理条件决定。计数提供了一种清楚的起点,让我们知道端点约束究竟删去了哪些状态。
三维长链的构象远比16种多,但相同的思想仍然有用。接近完全伸直时,几乎所有链段都要朝着拉伸方向,能够容纳的转向很少;允许端点相距较近时,链段可以通过许多不同的组合彼此抵消位移。整体回缩的趋势与这种构象数量的变化联系起来。具体到一条短链,它仍会不断波动;要把这种趋势写成稳定的测量结果,需要比较固定条件下许多构象的平均。
接下来要做的是把“六种比一种多”变成一个可以和能量比较的量。设两套互不影响的系统分别有Ω1和Ω2种构象,放在一起以后有Ω1Ω2种组合。如果希望描述它们的热力学量能够相加,可以使用对数,因为乘积的对数等于两个对数之和。这个简单的性质,解释了统计熵为什么与构象数的对数联系在一起。
S表示熵,kB是玻尔兹曼常数,单位为J/K;Ω是无量纲的计数,ln是自然对数。自然对数以e为底,e约为2.718,可以先把它理解为把相乘关系变为相加关系的一种刻度。四步链从中心的六种构象限制到最右端的一种,熵变化为kBln1−kBln6=−kBln6,约为−1.79kB。负号表示在规定端点以后,可用的构象数量减少了。
第二行引入Helmholtz自由能A,用来在固定温度等约束下比较状态。U是内能,T用开尔文表示,TS与U一样具有能量单位。在这个等能构象的理想小模型里,各状态的U相同,熵减少便使A增加。于是,拉伸的代价可以来自“少了哪些构象”,即使链段本身没有储存更多伸长能。真实材料还可能改变链间接触或内部结构,分析时可以把这些变化放进同一套能量与熵的比较中。
02从构象机会,算到恢复力
四步链让计数变得直观,但实际测量通常希望得到一条平滑的力—伸长曲线。对包含许多独立链段的三维链,在离完全伸直还很远的范围内,末端位置的三个坐标分量可以近似看成钟形分布。原因与《高分子链尺寸:末端距、回转半径与标度关系》的求和有关:每个坐标都是许多小位移相加,不同贡献不断叠加后,中间区域的统计分布趋近高斯形状。我们现在借用这个近似,把离散的构象计数换成连续空间中的概率密度。
p(粗体R)描述末端向量出现在某个位置附近的概率密度。密度乘一个很小的体积,才得到相应小区域中的概率。比较同样大小的小体积,体积因子会约掉,因此密度的比值直接反映相应位置附近的相对机会。这里固定的是末端向量,既指定距离,也指定方向;如果把同一距离上的所有方向合在一起统计,还会多出球壳所含的空间数量,那对应另一种约束。
三维各向同性使三个坐标方向平均分担末端距平方。既然〈R²〉=Nb²,每个坐标的方差便是Nb²/3。高斯分布的指数包含“位移平方除以两倍方差”,把三个方向相加,就出现3R²/(2Nb²)。分布前面的归一化系数在密度比中抵消。于是,把末端从原点附近限制到某个位移附近的自由能差,可以写成下面的形式。
第一行的指数带负号,表示较大的指定末端位移在这个近似中具有较低的密度。第二行取负对数,再乘kBT,把相对机会转为能量代价。对数与指数互相抵消,负号也相互抵消,最后留下一个正的二次项。R²、Nb²都具有长度平方单位,因此对数内部的比值与指数都没有单位;乘上热能尺度以后,自由能差才具有能量单位。
这个二次形式与普通弹簧的能量很像,但它在这里来自许多方向的统计。设末端已经沿某个方向移动了R,再向前移动一小段δR,R²会增加2RδR+(δR)²。当δR很小时,后面那项比前面小得多。能量增量除以位移增量,就接近一个与R成正比的量,这便是维持缓慢拉伸所需的外力。用数学语言说,我们对自由能求了位移方向上的导数。
粗体fext表示施加在链端、维持伸长的外力,它沿着末端位移方向;粗体fchain表示链对端点施加的恢复力,方向相反。两者符号不能混用。可以想象右手握住链的一端向右拉:手给链向右的力,链给手向左的力。平衡时两种作用的大小对应,而当我们研究末端怎样运动时,还要把摩擦、惯性或其他作用一起放进运动方程。
代入一个可以手算的例子:N=100、b=1nm、R=10nm、T=300K。此时kBT约为4.14pN·nm,外力大小为3×4.14×10/(100×1²)pN,约1.24pN。能量单位pN·nm除以长度平方,再乘位移nm,最后留下pN,单位也能对上。沿链长度L=Nb=100nm,所以这里的伸长只占轮廓长度的十分之一,处在高斯小伸长描述较适合讨论的范围。
在固定N与b的模型里,温度越高,同样构象熵损失对应的自由能代价越大;链段数越多,同一个末端位移能够分散到更多段,线性回复系数越小。使用这两句话时,需要保留“固定模型参数”这个条件。实际生物大分子的局部刚度、溶剂接触和结构也可能随温度改变。记录温度以后,研究者还要观察这些变化,才能将材料响应与单纯的热能因子联系起来。
单链恢复力与整根橡皮筋的拉力之间,还隔着许多条链怎样连接、它们如何分担变形等层次。蛋白质凝胶、柔软的糖链网络和交联橡胶都可以借用构象统计来理解一部分弹性,但各自的连接与内部结构需要另外说明。第十三节会把单链接入网络,讨论含水量与成形;这一节先把一条链的力学量定义清楚,让后续模型有一个能够逐项核对的起点。
03DNA的拉伸,为什么还需要方向记忆
如果真的想拉一条DNA,该从哪里下手?它远比手指细,端点位置与皮牛量级的力也需要专门的测量方法。一个办法是在分子两端连接可操作的对象:一端固定在表面,另一端连接微珠,通过作用在微珠上的力带动DNA,再用显微镜记录位置。宏观工具与分子之间多了一层连接,但我们仍然可以围绕“施加多大力、平均伸长多少”组织测量。
1992年,Steven Smith、Laura Finzi和Carlos Bustamante报告了利用磁珠直接测量单个DNA分子弹性的工作。他们将DNA两端分别连接到玻璃表面和磁珠,在磁力与流体作用下观察平衡位置,并比较不同盐条件下的力—伸长响应。这类实验把高分子的统计图像变成了单分子层面可以逐点测量的曲线,也让模型在哪些地方偏离观测变得具体可见。[1]
双链DNA的局部形态比自由连接模型中的铰链更有方向连续性。可以用一根柔软细绳与一段钓鱼线作比较:相同长度放在桌上,钓鱼线通常不容易在很短的距离内突然转向。分子模型中的“方向记忆”说的也是相邻位置的方向相关。沿着链走一段距离s,分别在起点与终点画出切向箭头,比较它们的方向,就可以定量描述这种相关性。
单位切向量t的长度规定为1,因此两个切向量的点积只反映夹角:同向为1,垂直为0,反向为−1。三维理想虫状链模型,简称WLC,用连续曲线表示不能沿轮廓伸长、但可以弯曲的链。它以持久长度ℓp描述方向相关沿链衰减的尺度。ℓ是小写字母ell;下标p提醒我们它与persistence,也就是持续保持方向的性质有关。
当s=0,比较的是同一处方向,相关值为1;走过一个持久长度,平均相关降到e−1,约0.368;走过两个持久长度,降到约0.135。持久长度因此是一种逐渐衰减的尺度,而非到了某个位置就突然失去方向关联。把一整条链上各处的方向贡献相加,再用这个相关关系取平均,长链极限下得到〈R²〉≈2ℓpL。它与《高分子链尺寸:末端距、回转半径与标度关系》Nb²相接时,对应的有效独立段长就是2ℓp。
1949年,Otto Kratky与Günther Porod关于溶液中线形分子的研究,与后来称作Kratky–Porod模型的连续链描述联系起来。1995年,John Marko与Eric Siggia在《Stretching DNA》中进一步用虫状链统计分析DNA拉伸。把这两段历史放在一起,可以看到模型发展的线索:先为链的局部弯曲建立描述,再把这种描述接到可测量的拉力与伸长上。[2][3]
高斯线性弹性还面临一个几何问题:只要继续增加力,它会允许末端无限远地移动。轮廓不能伸长的链却有明确上限,沿拉力方向的平均伸长z应小于L。令x=z/L,x便是0到1之间的伸长比例。这里的z是沿拉力方向的平均投影;零拉力时它可以为0,而链的均方根尺寸仍然非零。把这两个不同平均量分清,就能理解为什么“没有平均朝向”与“分子仍有大小”可以同时成立。
这条常用的Marko–Siggia插值式把长WLC的弱拉伸与强拉伸趋势接在一起。左边fℓp与kBT都是能量,比例没有单位,右边也完全由无量纲的x组成。x=0时,1/4与−1/4抵消,力为0;x靠近1时,(1−x)²越来越小,第一项迅速增大。这里的数学变化对应了一个具体几何条件:轮廓长度固定,可继续展开的弯曲越来越少。
把链拉得更接近轮廓长度
在交互图默认的ℓp=50nm、kBT=4.11pN·nm下,x=0.5时拉力约0.103pN;x=0.9时约2.108pN;进一步到0.95时约8.278pN。最后只多展开了轮廓长度的5%,所需拉力却明显上升。插值式在这里表达的是不能拉长轮廓的理想曲线。真实DNA进入更高拉力区后,还可能出现轮廓伸长、扭转变化和结构转变,分析全程数据时便要引入相应模型。
持久长度的影响值得停下来想一想。在相同x与温度下,式子给出的力与ℓp成反比:方向记忆更长的链,要达到某个伸长比例,所需拉力反而更小。这里测的是把长链的弯曲展开到指定比例,并非把一根短杆横向掰弯。方向更持久的长链原本就保持着更大的相关段,沿拉力组织这些段的过程与局部抗弯刚度属于不同的力学问题。指标、加载方式与观察尺度,要一起决定“更硬”这类日常词语的含义。
04拿到曲线以后,怎样反过来认识链
如果已知L、ℓp与温度,代入模型得到一组拉力和伸长,这是正向问题。实验中经常遇到相反的情况:我们已测到曲线,却不知道参数,这就是反演。可以把正向计算想成依据配方做出一杯饮料,反演则像依据测量结果推测配方。后者更依赖观测是否足够区分不同的可能组合;两种不同参数若产生几乎相同的曲线,仅靠这段曲线就很难将它们分开。
本节模拟1000组参数,轮廓长度在2000至4500nm之间,持久长度在25至80nm之间,采用固定热能尺度4.11pN·nm。每组参数各生成两条曲线:一条在0.01至5pN之间测24个点,另一条只在0.01至0.03pN之间测24个点。每个力值都先由单调的插值关系反求x,再乘L得到伸长,最后加入标准差10nm的独立高斯噪声。力值在每个范围中按固定的对数网格排列,测量安排没有读取待估参数。
为什么选这两个范围?在很小的x附近,把1/(1−x)²展开,开头几项为1+2x+3x²。代回插值式后,常数项消失,一次项为3x/2。于是,弱拉伸近似可以写成下面的关系。只观察几乎线性的一小段时,曲线斜率主要告诉我们两个长度参数的乘积。稍微增加L,同时减小ℓp,就可能得到很相近的预测。
例如,L=3000nm、ℓp=50nm与L=2500nm、ℓp=60nm具有相同的乘积,弱拉伸近似给出的斜率也一样。它们在更大的伸长范围里会逐渐分开,因为完整关系含有额外的非线性形状。多测一些相同低力位置,可以减小部分随机噪声;把测量延伸到能区分曲线弯曲的区域,则可能带来另一种信息。我们让两种设计都保持24个点,正是为了将点数与范围的作用分开观察。
物理拟合会对一系列候选ℓp逐个尝试。给定某个候选值,每个已知拉力对应的xj就能算出,而预测伸长是Lxj。此时只有L未知,最小化残差平方和能直接得到下面第一行。求法与线性回归相同:把Σ(Lxj−zj)²对L求导,令导数为0,再把包含L的项放到一边。对每个持久长度都重新找最佳L,可以看到另一个参数究竟能补偿多少误差。
j标记24次测量,zj是带噪伸长,σ取本次模拟设定的10nm。每个残差先除以噪声尺度再平方,相加得到没有单位的代价χ²,读作chi平方。程序在5至250nm之间考察1500个持久长度候选,选择代价最小的位置。再画出代价超过最小值多少,就得到一条误差轮廓:谷底很窄时,稍改参数便明显变差;谷底很宽时,一大片参数都能配合出接近的曲线。
AI采用另一条求解路线:先看许多已知参数的模拟曲线,学习从曲线形状直接预测参数。我们把同一组参数的宽、窄两条曲线始终放在一起,按整组划成650组训练、150组验证与200组测试。训练组用于学习权重,验证组用于选择训练过程中保留哪一次参数,测试组留到最后评价。这样,测试面对的是新的参数组合,同一对象的另一条曲线不会提前进入训练。
最简单的参照是始终猜训练参数的平均值。第二个学习模型是岭回归,把24个伸长观测作为输入;第三个是一层32个隐藏单元的神经网络,输出轮廓长度与持久长度。与《高分子链尺寸:末端距、回转半径与标度关系》类似,每一列输入只用训练组的均值和标准差缩放。两个目标先以1nm为参照取自然对数,再分别缩放,避免较大的轮廓长度数值直接压过持久长度。网络输出还原缩放后取指数,便得到两个正的长度预测。
本次隐藏单元使用tanh,即双曲正切。可以把它先理解为一条平滑的S形函数:输入接近0时响应较快,绝对值很大时逐渐接近−1或1。网络仍由输入加权、非线性变换和输出加权组成,第一层与输出层的全部参数都参与训练。其导数可以写成1−tanh²,代码将它与误差的导数逐层相乘,再用Adam更新。宽、窄两种输入各训练一个网络,最多2500步,每25步看一次验证误差,保留验证误差最小的权重。
2019年,Maziar Raissi、Paris Perdikaris与George Karniadakis发表了把物理关系纳入神经网络训练、处理正向与反向问题的研究,讨论如何从观测推断符合微分方程的状态或参数。它把“学习预测”和“检查物理关系”放进同一类问题中。本节采用更容易逐步核对的起点:学习模型从模拟曲线读出参数,物理拟合显式计算残差,两条路线都回到同一批测量上比较。[4]
理解两条路线的结果,要看它们各自拿到了什么信息。物理拟合使用曲线、噪声尺度和指定关系;网络还见过650组带参数标签的例子,学到了训练数据中常出现的参数组合。若窄范围内的几条拉伸曲线几乎重合,单靠这些测量点就很难判断哪组参数生成了它;网络则可能借助已见组合给出较稳定的估计。到训练范围之外,这份经验也可能把答案拉向熟悉的区域。因此,画参数预测图时,应把训练覆盖范围和新曲线的误差一起看:前者解释模型的经验从哪里来,后者检验这些经验在当前问题里是否合适。
05完整反演,并把方法放回真实测量
下面的代码会完成构象计数、两种测量设计、四个估计方法、导数检查与全部绘图。它依赖NumPy和Matplotlib,神经网络的前向计算、反向传播与参数更新都直接列出。固定随机种子使模拟曲线与训练结果能够复现。程序保存每条曲线的组号、划分、24个伸长观测,以及测试参数的所有预测,便于从结果图追溯到具体样本;模型权重和训练侧缩放量也一并保存。
为了把统计模型接到真实观察,本例还读取一段公开DNA拉伸测量。LUMICKS于2024年发布的数据集采用CC BY 4.0许可,原始文件中的这条曲线含1267行对齐记录。本节从距离通道与微珠总力通道提取数据,把微米换成纳米,再按时间每8行取1行并保留最后一行,得到代码中直接列出的160对数值。这些数值来自测量,模拟曲线则由前述参数化模型生成,二者各自保留来源。[5]
真实曲线的示例拟合使用其中0.2至5pN的68个点,并明确采用零距离偏移、零力偏移与kBT=4.11pN·nm的分析约定。这个热能尺度沿用公开示例的设置。程序为每个候选轮廓长度计算曲线形状,再求最佳力幅度,由幅度得到持久长度,最后选力残差最小的组合。这里最小化的是以pN计的力误差;前面的模拟任务已指定伸长含有10nm噪声,因此最小化以nm计的伸长误差。选择误差方向,应与测量及噪声模型一起说明。
真实测量数据与来源
"""Entropic elasticity and curve-to-parameter learning.

Requires NumPy and Matplotlib. The DNA numerical subset is embedded below.
Synthetic data: long-chain Marko-Siggia interpolation, kBT=4.11 pN nm.
Observed extensions have independent Gaussian noise with sigma=10 nm.
All curves for one parameter pair remain in the same data partition.
"""
from pathlib import Path
from math import comb
import json
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

OUT=Path("elasticity_outputs")
OUT.mkdir(exist_ok=True)
KT=4.11                    # pN nm, prescribed model/analysis thermal scale
SIGMA=10.0                 # nm, independent synthetic extension noise
SEED=606
COLORS=["#887a69","#cd6c47","#247b69","#304d77"]
plt.rcParams.update({"font.family":"DejaVu Sans","font.size":14,
    "axes.spines.top":False,"axes.spines.right":False,"axes.labelsize":14,
    "axes.titlesize":15,"legend.fontsize":11,"svg.hashsalt":"L06-elasticity",
    "savefig.facecolor":"#fffdf8"})

# LUMICKS (2024), DOI 10.5281/zenodo.12668419, CC BY 4.0.
# Original FD curve has 1267 time-aligned rows. Select rows 0,8,16,...,1264
# plus final row1266, in time order. Distance1: um -> nm; Trap2: total force pN.
# Values below are measurements, not generated from the teaching model.
DNA_DATA = np.array([
    [1507.554534, 0.01045498505],
    [1523.136068, 0.08885946445],
    [1535.541275, 0.1687685737],
    [1547.031289, 0.04142682294],
    [1564.944785, 0.03013699975],
    [1580.633798, 0.1710104162],
    [1599.832833, 0.2555742697],
    [1611.640918, 0.2611575828],
    [1619.359454, 0.172676309],
    [1637.234512, 0.1825457563],
    [1651.416951, 0.2767096909],
    [1663.529555, 0.09165729488],
    [1676.144339, 0.09389412018],
    [1690.963765, 0.3921573974],
    [1705.344865, 0.3151567484],
    [1719.389995, 0.2414734165],
    [1737.162577, 0.1116167701],
    [1746.686195, 0.3078744522],
    [1758.624625, 0.2281664175],
    [1773.532496, 0.2663851125],
    [1786.222186, 0.2270622483],
    [1796.577336, 0.3339478803],
    [1810.825296, 0.2413859999],
    [1825.157082, 0.2718138058],
    [1836.909443, 0.217689204],
    [1851.809182, 0.1611735374],
    [1862.406028, 0.2703681853],
    [1874.097214, 0.07652316169],
    [1886.472474, 0.2114218607],
    [1900.826269, 0.1449865622],
    [1915.830096, 0.4356262262],
    [1924.691503, 0.3071022763],
    [1937.784975, 0.1723059021],
    [1952.731717, 0.286821541],
    [1962.803235, 0.252511253],
    [1981.52594, 0.2096999973],
    [1990.67831, 0.2428496321],
    [2002.316077, 0.1494624249],
    [2019.073389, 0.2644964021],
    [2027.833499, 0.3735661086],
    [2043.104416, 0.1299659277],
    [2055.940192, 0.4409992036],
    [2070.024288, 0.3098122365],
    [2083.318213, 0.4836215197],
    [2096.116547, 0.3330418343],
    [2106.282228, 0.5648385224],
    [2119.697231, 0.3634308418],
    [2133.847631, 0.4148978598],
    [2150.500628, 0.4289832871],
    [2161.047878, 0.5170297211],
    [2174.50172, 0.5954173016],
    [2189.15149, 0.4544984685],
    [2204.392974, 0.5213618599],
    [2217.59961, 0.5820380183],
    [2229.518985, 0.6031777796],
    [2246.194418, 0.8759342631],
    [2255.860666, 0.5522027276],
    [2271.066459, 0.6739869944],
    [2282.656399, 0.7050620859],
    [2297.500535, 0.6861668245],
    [2307.963368, 0.9191275541],
    [2323.601013, 0.8673508165],
    [2337.358996, 1.019640667],
    [2352.367426, 0.9743398238],
    [2364.193478, 1.24158943],
    [2380.658924, 1.157390868],
    [2395.97708, 1.218444628],
    [2405.674579, 1.298080123],
    [2418.248302, 1.552148888],
    [2433.788794, 1.196310683],
    [2445.213539, 1.175867846],
    [2456.817424, 1.625276605],
    [2462.096883, 1.66573742],
    [2480.437948, 1.959157439],
    [2490.22269, 2.108187995],
    [2508.032596, 2.29843103],
    [2518.30837, 2.551807612],
    [2525.951681, 2.602889598],
    [2544.65005, 2.65824777],
    [2551.285402, 2.963749443],
    [2565.952081, 3.28134667],
    [2571.725021, 3.611023673],
    [2583.924447, 3.99099344],
    [2595.372515, 4.297163709],
    [2605.513594, 4.686616351],
    [2614.617598, 5.282804865],
    [2620.126816, 5.628527138],
    [2633.883887, 6.053970808],
    [2643.131742, 6.75757233],
    [2650.081229, 7.311676405],
    [2657.743555, 7.950219231],
    [2666.031066, 8.728832102],
    [2669.196243, 9.471160433],
    [2678.890608, 10.37366703],
    [2686.524497, 11.22826411],
    [2690.370437, 12.1790347],
    [2698.504033, 13.04508965],
    [2702.780681, 14.04463534],
    [2705.31928, 14.92266881],
    [2714.506998, 15.89771119],
    [2718.704968, 17.0274443],
    [2723.28215, 18.00026112],
    [2728.487208, 19.21627224],
    [2732.136944, 20.11133906],
    [2735.604938, 21.33507719],
    [2740.100266, 22.53171821],
    [2745.62744, 23.64217255],
    [2749.147666, 24.88696251],
    [2752.538689, 26.0251913],
    [2757.071741, 27.04885791],
    [2762.950896, 28.48879533],
    [2764.012533, 29.58709585],
    [2769.712702, 30.81326221],
    [2770.355888, 31.70166611],
    [2772.276864, 32.91303383],
    [2777.22185, 34.1580418],
    [2781.053545, 35.39139773],
    [2783.8933, 36.73083354],
    [2787.074834, 37.85867963],
    [2794.013887, 39.23008715],
    [2794.58562, 40.29165576],
    [2801.619321, 41.54880707],
    [2801.822473, 42.96044768],
    [2805.216603, 44.28649504],
    [2810.686538, 45.54748891],
    [2817.107268, 46.63191962],
    [2815.394326, 48.11835243],
    [2822.600217, 49.24243661],
    [2828.210121, 50.43548283],
    [2835.293831, 51.78914243],
    [2836.091015, 53.050245],
    [2842.18347, 54.15289598],
    [2852.222431, 55.36057004],
    [2852.747486, 56.49801074],
    [2860.413174, 57.25527057],
    [2866.657441, 58.42017796],
    [2874.544328, 59.28254273],
    [2880.697058, 60.22567337],
    [2895.81331, 60.59442648],
    [2902.435861, 61.522872],
    [2911.342985, 62.4946558],
    [2924.708487, 62.70705063],
    [2924.949902, 64.1106122],
    [2942.705501, 64.20267266],
    [2950.188725, 64.81263955],
    [2956.598732, 65.32539],
    [2966.673789, 63.55397612],
    [2969.825373, 63.21359917],
    [2969.453152, 63.05145617],
    [2968.777814, 63.18882922],
    [2967.418946, 63.14275629],
    [2972.776499, 63.09865436],
    [2967.329544, 63.30396642],
    [2969.016752, 63.26432442],
    [2965.801886, 63.02874795],
    [2968.625615, 63.13315603],
    [2968.800594, 63.11083838],
    [2968.625598, 62.90583761],
    [2967.675089, 63.02169566],
    [2968.452555, 63.08041695],
], dtype=float)


def phi(x):
    """Dimensionless Marko-Siggia force for fractional extension x."""
    return 1/(4*(1-x)**2)-.25+x


def extension_fraction(force, lp):
    """Invert the monotonic force relation by bounded bisection."""
    scaled=np.asarray(force)*np.asarray(lp)/KT
    lo=np.zeros_like(scaled);hi=np.ones_like(scaled)*(1-1e-9)
    for _ in range(45):
        mid=(lo+hi)/2
        below=phi(mid)<scaled
        lo=np.where(below,mid,lo);hi=np.where(below,hi,mid)
    return (lo+hi)/2


def physical_fit(observations, force, lp_grid):
    """Profile lp; solve the best L analytically at each candidate lp."""
    shape=extension_fraction(force[None,:],lp_grid[:,None])
    results=[];ranges=[];profiles=[]
    for observed in observations:
        lengths=(shape@observed)/np.sum(shape**2,axis=1)
        cost=np.sum((lengths[:,None]*shape-observed)**2,axis=1)/SIGMA**2
        best=int(np.argmin(cost));delta=cost-cost[best]
        accepted=delta<=4.0   # diagnostic cost contour, not a calibrated probability
        results.append([lengths[best],lp_grid[best]])
        ranges.append([lp_grid[accepted][0],lp_grid[accepted][-1],
                       bool(accepted[0] or accepted[-1])])
        profiles.append(delta)
    return np.array(results),np.array(ranges),np.array(profiles)


def predict(parameters,x):
    a,b,c,d=parameters
    return np.tanh(x@a+b)@c+d


def objective(parameters,x,y):
    a,b,c,d=parameters
    h=np.tanh(x@a+b);error=h@c+d-y
    derivative=2*error/error.size
    hidden=(derivative@c.T)*(1-h*h)
    return float(np.mean(error**2)),[x.T@hidden,hidden.sum(0),h.T@derivative,derivative.sum(0)]


def train_network(x,y,x_valid,y_valid,seed):
    rng=np.random.default_rng(seed)
    pars=[rng.normal(0,.13,(24,32)),np.zeros(32),
          rng.normal(0,.12,(32,2)),np.zeros(2)]
    first=[np.zeros_like(p) for p in pars];second=[p.copy() for p in first]
    best_loss=float("inf");best=None;history=[];best_step=0
    for t in range(1,2501):
        loss,grads=objective(pars,x,y)
        for j,g in enumerate(grads):
            first[j]=.9*first[j]+.1*g;second[j]=.999*second[j]+.001*g*g
            pars[j]-=.003*(first[j]/(1-.9**t))/(np.sqrt(second[j]/(1-.999**t))+1e-8)
        if t==1 or t%25==0:
            validation=float(np.mean((predict(pars,x_valid)-y_valid)**2))
            history.append([t,loss,validation])
            if validation<best_loss:
                best_loss=validation;best=[p.copy() for p in pars];best_step=t
    return best,history,best_step


def fit_real_dna():
    """Force-residual fit to the declared 0.2--5 pN measurement subset."""
    z,f=DNA_DATA.T
    keep=(f>=.2)&(f<=5)
    # At fixed L, force = a*phi(z/L), with a=kBT/lp.
    L_grid=np.linspace(max(z[keep])+1,3500,10000)
    shape=phi(z[keep][None,:]/L_grid[:,None])
    amplitude=(shape@f[keep])/np.sum(shape*shape,axis=1)
    cost=np.mean((amplitude[:,None]*shape-f[keep])**2,axis=1)
    best=int(np.argmin(cost))
    return {"L_nm":float(L_grid[best]),"lp_nm":float(KT/amplitude[best]),
        "force_rmse_pN":float(np.sqrt(cost[best])),"fit_points":int(keep.sum()),
        "force_window_pN":[.2,5.],"kBT_pN_nm":KT,"offsets":"fixed zero",
        "input_points":len(f),"doi":"10.5281/zenodo.12668419","credit":"LUMICKS (2024), CC BY 4.0"}


def verify_math():
    counts=[comb(4,j) for j in range(5)]
    assert counts==[1,4,6,4,1] and sum(counts)==16
    x=np.linspace(0,.99,200)
    assert phi(0)==0 and np.all(np.diff(phi(x))>0)
    assert abs(phi(1e-6)/1e-6-1.5)<1e-5
    inverse=extension_fraction(np.geomspace(.01,5,40),50)
    inverse_error=float(np.max(abs(KT/50*phi(inverse)-np.geomspace(.01,5,40))))
    assert inverse_error<1e-9
    # Independently perturb every weight in a tiny two-output network.
    r=np.random.default_rng(10)
    p=[r.normal(size=(3,4)),r.normal(size=4),r.normal(size=(4,2)),r.normal(size=2)]
    a=r.normal(size=(7,3));b=r.normal(size=(7,2));_,gradient=objective(p,a,b)
    grad_error=0.
    for j,parameter in enumerate(p):
        for ix in np.ndindex(parameter.shape):
            original=parameter[ix];eps=1e-6
            parameter[ix]=original+eps;up=objective(p,a,b)[0]
            parameter[ix]=original-eps;down=objective(p,a,b)[0]
            parameter[ix]=original
            grad_error=max(grad_error,abs((up-down)/(2*eps)-gradient[j][ix]))
    assert grad_error<1e-7
    return {"four_step_counts":counts,"inverse_force_max_error_pN":inverse_error,
            "gradient_max_error":grad_error,"small_extension_slope":float(phi(1e-6)/1e-6)}


def main():
    rng=np.random.default_rng(SEED)
    count=1000
    truth=np.c_[rng.uniform(2000,4500,count),rng.uniform(25,80,count)]
    order=rng.permutation(count)
    train,valid,test=order[:650],order[650:800],order[800:]
    assert not(set(train)&set(valid) or set(train)&set(test) or set(valid)&set(test))
    partitions=np.array(["test"]*count,dtype=object)
    partitions[train]="train";partitions[valid]="validation"
    log_target=np.log(truth)   # numerical ratios to1nm for both positive lengths
    ymean,ysd=log_target[train].mean(0),log_target[train].std(0)
    yt=(log_target-ymean)/ysd
    lp_grid=np.geomspace(5,250,1500)
    windows={"wide":[.01,5.],"narrow":[.01,.03]}
    all_runs={};samples=[];results={"seed":SEED,"noise_sigma_nm":SIGMA,
        "kBT_pN_nm":KT,"train_groups":650,"validation_groups":150,"test_groups":200,
        "parameter_order":["L_nm","lp_nm"],"parameter_bounds_nm":[[2000,4500],[25,80]],
        "profile_lp_search_nm":[5,250],"profile_threshold_delta_cost":4,
        "profile_interpretation":"diagnostic cost range; boundary-touching values are flagged",
        "target_standardization":{"mean":ymean.tolist(),"std":ysd.tolist()},
        "checks":verify_math(),"windows":{}}
    for name,limits in windows.items():
        force=np.geomspace(*limits,24)
        exact=truth[:,0,None]*extension_fraction(force[None,:],truth[:,1,None])
        observed=exact+rng.normal(0,SIGMA,exact.shape)
        mean,sd=observed[train].mean(0),observed[train].std(0)
        x=(observed-mean)/sd
        design=np.c_[np.ones(len(train)),x[train]]
        penalty=np.eye(25)*.01;penalty[0,0]=0
        ridge=np.linalg.solve(design.T@design/len(train)+penalty,design.T@yt[train]/len(train))
        weights,history,best_step=train_network(x[train],yt[train],x[valid],yt[valid],SEED+len(name))
        phys,ranges,profiles=physical_fit(observed[test],force,lp_grid)
        predictions={"mean":np.tile(truth[train].mean(0),(len(test),1)),
            "ridge":np.exp((np.c_[np.ones(len(test)),x[test]]@ridge)*ysd+ymean),
            "network":np.exp(predict(weights,x[test])*ysd+ymean),"physics":phys}
        metrics={}
        for model,prediction in predictions.items():
            error=100*np.abs(prediction-truth[test])/truth[test]
            metrics[model]={"median_relative_error_percent":np.median(error,axis=0).tolist(),
                "mean_absolute_error_nm":np.mean(abs(prediction-truth[test]),axis=0).tolist()}
        results['windows'][name]={"force_pN":force.tolist(),"metrics":metrics,
            "input_standardization":{"mean":mean.tolist(),"std":sd.tolist()},
            "ridge_weights":ridge.tolist(),"network_weights":[p.tolist() for p in weights],
            "network_best_step_from_validation":best_step,"history":history,
            "profile_median_width_nm":float(np.median(ranges[:,1]-ranges[:,0])),
            "profile_boundary_touch_count":int(ranges[:,2].sum())}
        test_position={int(group):j for j,group in enumerate(test)}
        for group in range(count):
            row={"group":group,"split":str(partitions[group]),"window":name,
                "L_nm":float(truth[group,0]),"lp_nm":float(truth[group,1]),
                "extensions_nm":observed[group].tolist()}
            if group in test_position:
                j=test_position[group]
                row['predictions_nm']={key:value[j].tolist() for key,value in predictions.items()}
                row['profile_lp_range_nm']=ranges[j,:2].tolist()
                row['profile_touches_search_bound']=bool(ranges[j,2])
            samples.append(row)
        all_runs[name]={'predictions':predictions,'ranges':ranges,'profiles':profiles,'force':force,'observed':observed}
    real=fit_real_dna();results['real_dna']=real
    results['checks']['no_parameter_group_overlap']=True
    (OUT/'results.json').write_text(json.dumps(results,indent=2),encoding='utf-8')
    (OUT/'samples.json').write_text(json.dumps(samples,indent=2),encoding='utf-8')
    np.savetxt(OUT/'dna_selected_data.csv',DNA_DATA,delimiter=',',header='distance_nm,total_force_trap2_pN',comments='')

    def panel(ax,key):
        if key=='counts':
            ends=np.arange(-4,5,2);counts=np.array([comb(4,j) for j in range(5)])
            ax.bar(ends,counts,width=1.2,color=COLORS[2])
            for end,c in zip(ends,counts):ax.text(end,c+.12,str(c),ha='center',fontsize=14)
            ax.set(xticks=ends,xlabel='Endpoint / segment length',ylabel='Number of conformations',
                title='A  Four steps: 16 possible paths',ylim=(0,7))
        elif key=='force_law':
            frac=np.linspace(0,.92,200)
            ax.plot(frac,1.5*frac,c=COLORS[0],ls='--',label='Small-extension limit')
            ax.plot(frac,phi(frac),c=COLORS[2],label='WLC interpolation')
            ax.set(xlabel='Extension / contour length',ylabel=r'$f\ell_p/(k_BT)$',title='B  Finite contour, rising force',ylim=(0,12))
            ax.legend(frameon=False)
        elif key=='parameters':
            for model,c in [('network',COLORS[1]),('physics',COLORS[2])]:
                ax.scatter(truth[test,1],all_runs['wide']['predictions'][model][:,1],s=19,alpha=.65,color=c,label=model)
            ax.plot([25,80],[25,80],c=COLORS[0],ls='--')
            ax.set(xlabel='True persistence length / nm',ylabel='Estimated persistence length / nm',title='C  New parameter pairs, wide window')
            ax.legend(frameon=False)
        elif key=='comparison':
            names=['mean','ridge','network','physics']
            for j,name in enumerate(windows):
                errors=[results['windows'][name]['metrics'][key2]['median_relative_error_percent'][1] for key2 in names]
                ax.bar(np.arange(4)+(j-.5)*.36,errors,width=.36,color=[COLORS[2],COLORS[1]][j],label=name+' force range')
            ax.set_xticks(range(4),['Mean','Ridge','Network','Physics'])
            ax.set(ylabel='Median persistence-length error / %',title='D  Same 24 measurements, new range')
            ax.legend(frameon=False)
        elif key=='profiles':
            for name,c in [('wide',COLORS[2]),('narrow',COLORS[1])]:
                ax.plot(lp_grid,all_runs[name]['profiles'][0],color=c,label=name)
            ax.axhline(4,color=COLORS[0],ls=':',label='Diagnostic cost rise = 4')
            ax.axvline(truth[test[0],1],color=COLORS[3],ls='--',label='Generating parameter')
            ax.set(xlabel='Candidate persistence length / nm',ylabel='Cost above minimum',title='E  How wide is the fitting valley?',ylim=(0,15),xlim=(5,140))
            ax.legend(frameon=False)
        elif key=='dna':
            z,f=DNA_DATA.T;keep=(f>=.2)&(f<=5)
            ax.scatter(z[~keep]/1000,f[~keep],s=13,color='#b6b8b1',label='Outside fit range')
            ax.scatter(z[keep]/1000,f[keep],s=19,color=COLORS[1],label='Measured: 0.2--5 pN')
            grid=np.linspace(z[keep].min(),z[keep].max(),150)
            ax.plot(grid/1000,KT/real['lp_nm']*phi(grid/real['L_nm']),color=COLORS[2],label='Specified WLC fit')
            ax.set(xlabel='Distance / micrometre',ylabel='Total force / pN',title='F  Public DNA measurements',ylim=(0,6),xlim=(1.5,2.85))
            ax.legend(frameon=False)
            ax.text(.03,.96,'LUMICKS (2024) / CC BY 4.0',transform=ax.transAxes,va='top',fontsize=10)
        ax.grid(alpha=.16)
    keys=['counts','force_law','parameters','comparison','profiles','dna']
    for key in keys:
        fig,ax=plt.subplots(figsize=(6.8,5.1),layout='constrained',facecolor='#fffdf8')
        panel(ax,key);fig.savefig(OUT/(key+'.svg'),metadata={'Date':None});plt.close(fig)
    fig,axes=plt.subplots(3,2,figsize=(16,17),layout='constrained',facecolor='#fffdf8')
    for ax,key in zip(axes.flat,keys):panel(ax,key)
    fig.savefig(OUT/'elasticity_diagnostics.svg',metadata={'Date':None})
    fig.savefig(OUT/'elasticity_diagnostics.png',dpi=150,metadata={'Software':'Matplotlib'});plt.close(fig)
    print('Parameter groups: 650 train / 150 validation / 200 test; each has both force windows.')
    for name in windows:
        print(name, 'median lp errors (%)', {key:round(v['median_relative_error_percent'][1],3) for key,v in results['windows'][name]['metrics'].items()})
        print('  selected training step:',results['windows'][name]['network_best_step_from_validation'],
              '; diagnostic range touches search bounds:',results['windows'][name]['profile_boundary_touch_count'])
    print('DNA: points used =',real['fit_points'],'; fitted lp (nm) =',round(real['lp_nm'],3),
          '; fitted L (nm) =',round(real['L_nm'],3),'; force RMSE (pN) =',round(real['force_rmse_pN'],4))
    print('Gradient check:',f"{results['checks']['gradient_max_error']:.2e}")
    print('Saved full curves, fitted models and six result panels.')


if __name__=='__main__':
    main()
本次实际运行输出
Parameter groups: 650 train / 150 validation / 200 test; each has both force windows.
wide median lp errors (%) {'mean': 27.281, 'ridge': 4.321, 'network': 0.482, 'physics': 0.454}
  selected training step: 2500 ; diagnostic range touches search bounds: 0
narrow median lp errors (%) {'mean': 27.281, 'ridge': 12.385, 'network': 6.978, 'physics': 7.571}
  selected training step: 725 ; diagnostic range touches search bounds: 30
DNA: points used = 68 ; fitted lp (nm) = 40.975 ; fitted L (nm) = 2811.321 ; force RMSE (pN) = 0.1062
Gradient check: 5.75e-10
Saved full curves, fitted models and six result panels.
一次运行 · 六幅结果图
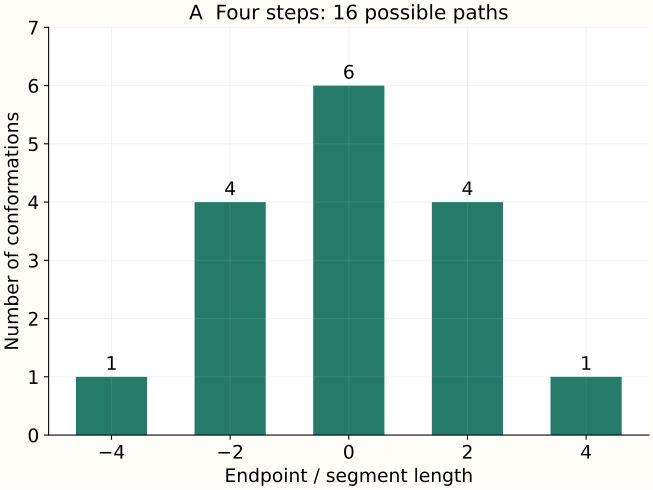
A · 一维四步链的16条路径在五个末端位置间分布,中心有6条。
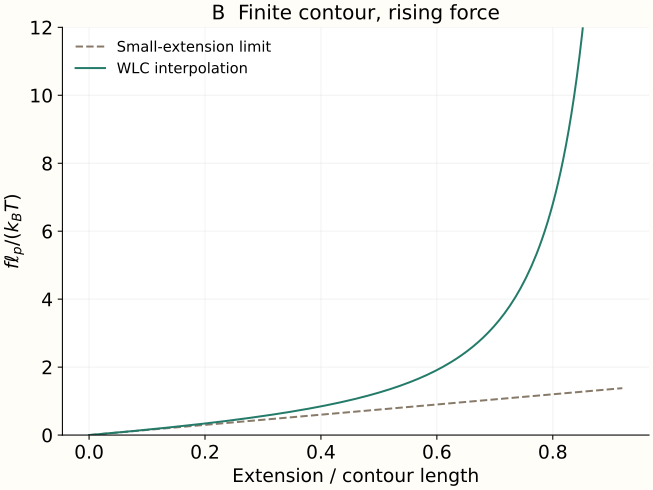
B · 小伸长极限与有限轮廓插值的比较,纵轴用kBT/lp归一化。
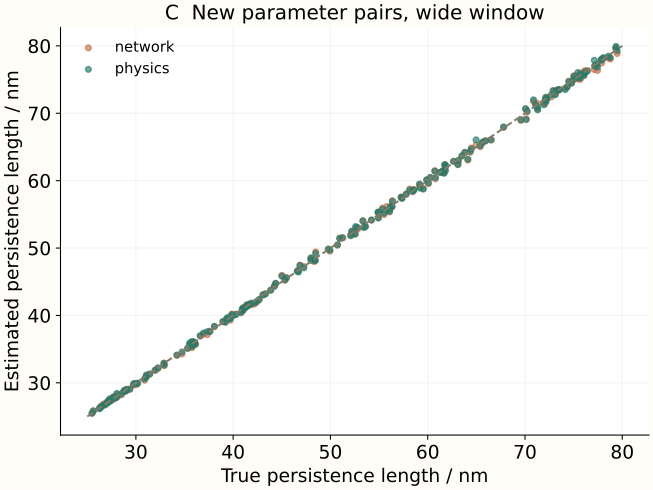
C · 宽力区间中200组未见参数的持久长度预测;虚线表示预测与生成值相等。
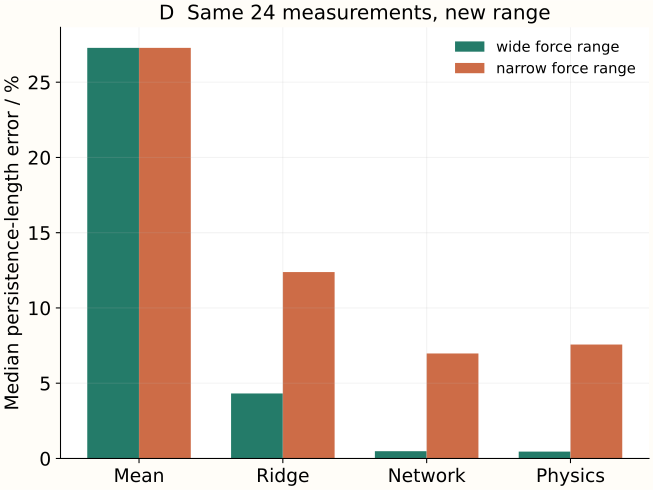
D · 四种方法在两个测量范围内的持久长度相对误差中位数;每条曲线都只有24个点。
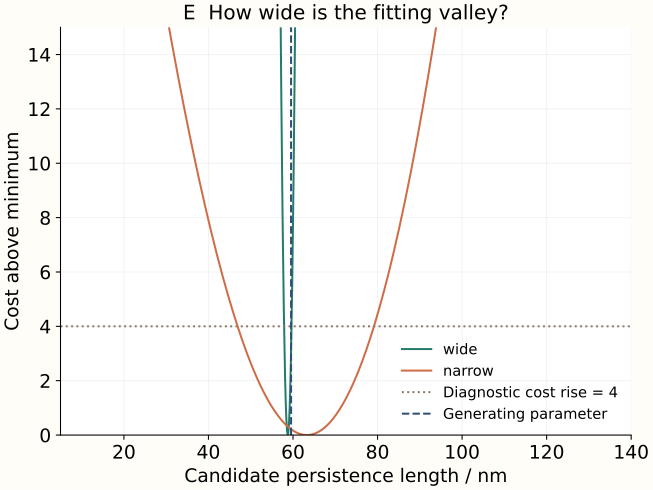
E · 同一组参数的两项反演,横线为代价增量4的诊断阈值。
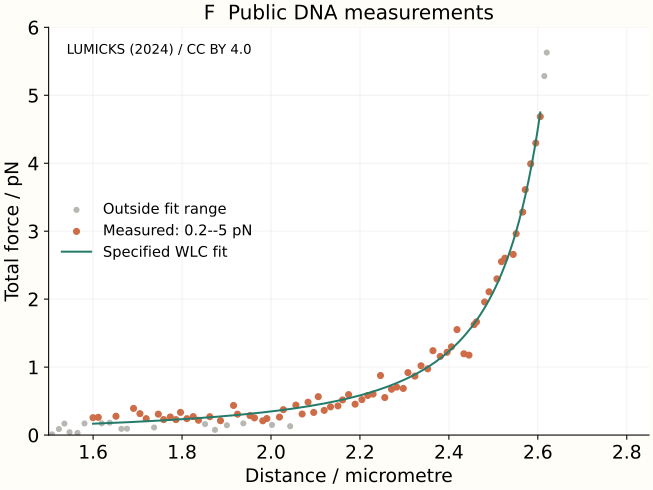
F · 公开DNA数据的0至6pN局部视图;橙色点参加0.2至5pN拟合,灰点保留邻近观测。
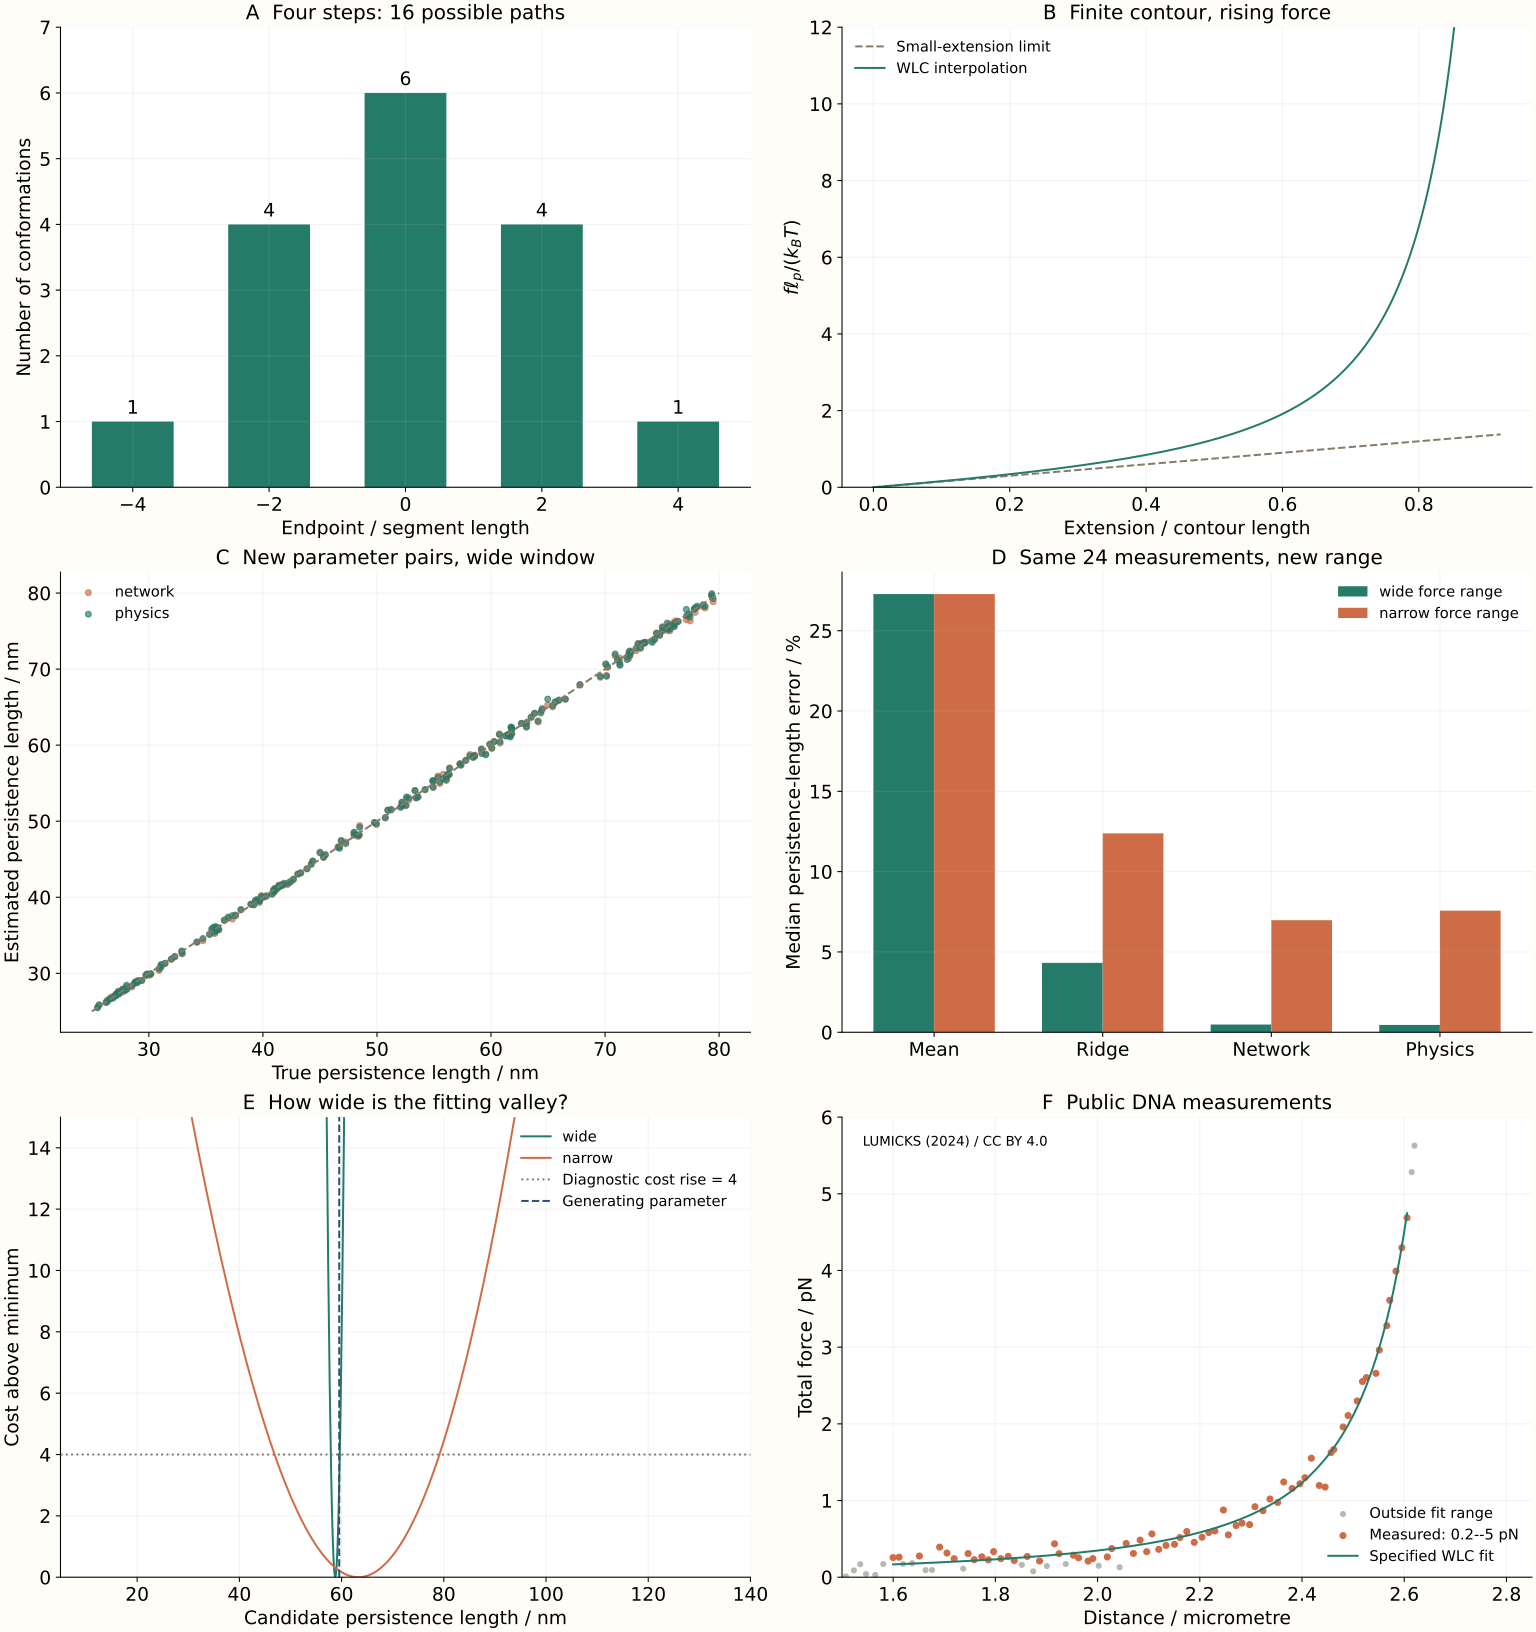
图A与图B先把物理起点放在一起。四步链的中心拥有最多路径,而把长链推近轮廓长度会使拉力迅速上升。图B中的虚线是小伸长极限,它在靠近原点时跟随完整插值式,随后逐渐分开。图中纵轴为fℓp/(kBT),因此比较的是形状关系;乘回各自的kBT/ℓp后,才能得到皮牛单位的实际拉力。
图C选取宽力区间中的200组测试参数,比较网络与物理拟合得到的持久长度。对角虚线表示预测等于生成值,点越接近它,估计越准确。本次网络的相对误差中位数为0.48%,物理拟合为0.45%。所谓相对误差,是每组预测与生成值之差的绝对值除以生成值;中位数表示将200个结果排序后处在中间的水平。图D同时放入均值与岭回归,帮助读者判断学习曲线形状带来的改善。
到了窄力区间,网络的持久长度相对误差中位数为6.98%,物理拟合为7.57%。两种方法都面对相同的24个伸长观测,但窄区间提供的非线性形状较少,两个长度参数更容易互相补偿。网络本次较小的中位误差,也包含它从训练样本学到的参数分布信息。完整结果文件还保存轮廓长度的误差,两项参数应结合起来读:只看其中一项,容易忽略另一项正在怎样配合。
图E进一步选同一组测试参数,把两种测量范围的误差轮廓画出来。横轴是试探的持久长度,每一个横坐标都已经重新求过最佳轮廓长度。绿色谷底通常更集中,橙色谷底更宽,直观显示了“许多参数都算得差不多”的情形。图中以高于最小代价4为一条统一诊断线,用于比较宽度;它的数值建立在本次10nm噪声尺度上。窄区间200组测试中,有30组的诊断范围触及5或250nm搜索边界,记录中单独标出了这些情况。
遇到延伸到搜索边界的谷底,可以先扩大参数搜索,再检查该模型下哪些范围仍与观测接近;若较宽范围始终难以区分,则将下一批测量安排到曲线分叉更明显的位置。研究步骤由此变得具体:保存误差轮廓,找出互相补偿的参数组合,计算这些组合在哪里给出不同预测,再选择新的测量条件。比起只输出一个最优数字,这种做法更能帮助实验者决定接下来该测什么。
图F展示真实DNA数据的低力局部。橙色测量点参与拟合,邻近灰点帮助保留曲线背景,绿色线按选定参数计算。本次160点子集中的指定区间拟合得到ℓp约40.98nm、L约2811.3nm,力残差均方根约0.106pN。这里报告的是这条公开曲线在所列区间与约定下的模型参数。将模型延伸到更高力区时,可以继续比较系统残差,并按照DNA的轮廓伸长或扭转响应增加相应项。公开数据原示例也沿着这条思路讨论了更复杂的链模型。[6]
从模拟走到实验,新的工作还包括核对距离零点、力的方向与标定、连接对象的几何,以及溶液条件。它们都可以写进观测模型或样本记录,逐步检查每一项怎样影响估计。若使用AI处理大量曲线,也应先保证输入包含一致的单位和测量约定,再按完整曲线或独立分子划分数据。这样,一次预测就能连接到明确的物理对象,而模型改进也能对应到具体的测量问题。
可以先把模拟噪声标准差从10nm减到5nm,保持曲线参数、力范围和点数相同,观察误差谷底怎样变化;再把窄区间的上限从0.03pN逐步提高,检查哪个范围开始明显区分两个长度参数。每次都重新生成训练与测试的相应观测,并保留完整组号划分。最后,将训练持久长度范围缩小,再评价范围外参数,看看学习到的参数分布怎样影响反演。
这一节把构象计数、自由能、拉力与参数学习接成了一条连续路径。《高分子链的舒展与塌缩:排除体积和吸引作用》将回到环境:同一条链在某些条件下舒展,在另一些条件下收缩,除了拉它,还可以怎样改变它的姿势?我们会把链自身的统计与链段之间、链和溶剂之间的接触放到一起,进一步比较条件变化下的尺寸与AI预测。
资料与延伸阅读
- Smith、Finzi与Bustamante,1992,Direct mechanical measurements of the elasticity of single DNA molecules by using magnetic beads,Science 258:1122–1126,DOI:10.1126/science.1439819。
- Kratky与Porod,1949,Röntgenuntersuchung gelöster Fadenmoleküle,Recueil des Travaux Chimiques des Pays-Bas 68:1106–1122。
- Marko与Siggia,1995,Stretching DNA,Macromolecules 28:8759–8770,DOI:10.1021/ma00130a008。
- Raissi、Perdikaris与Karniadakis,2019,Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations,Journal of Computational Physics 378:686–707;反问题的作者预印本。
- LUMICKS,2024,Pylake example: Data to fit the Twistable Worm-Like Chain Model,Zenodo公开数据,CC BY 4.0。
- LUMICKS,Twistable Worm-Like-Chain Fitting,对应数据的官方分析示例。
科学史图为本节围绕原研究问题重绘的示意。模拟结果与真实测量使用各自标注的数据来源;CSV与来源记录可在本页直接下载。