从分子姿势到可学习的尺寸
高分子链尺寸:末端距、回转半径与标度关系
把一根耳机线拉直,再松松地放进掌心,线的长度没有变,占据的空间却变了。溶液中的长链也会遇到类似的问题:一条由许多单元连接起来的分子,沿着骨架可以很长,在空间里却常常蜷成一团。要判断它怎样穿过孔道、与另一条链接触,或者在溶液中呈现怎样的整体形状,首先得说明我们打算用哪一把尺子量它。
这一节从熟悉的坐标和距离开始,逐步建立两种描述长链尺寸的量:末端距与回转半径。我们会亲手算一条很短的链,再统计许多随机生成的长链,最后让AI从链长和段长学习尺寸规律。学习实验里留出了一批更长的链,它们会帮助我们看清一个实际的研究问题:模型在已有样本附近算得准确,换到新的长度范围以后,会沿着什么规律继续预测?
01给长链准备三把尺子
先把目光放在耳机线本身。如果用软尺贴着线走,从一端沿着所有弯曲量到另一端,得到的是沿链长度。把软尺换成一把直尺,直接连接两个端点,得到的则是末端距。耳机线绕成一个大圈时,两个端点可以很近,可整圈线仍然铺开了相当大的范围。因此,还需要第三把尺子,让整条线的各个位置都参与测量。回转半径正是这样一种量,稍后我们会解释它的名字与计算方法。
在生物大分子里,这些区别经常对应不同的问题。一段柔性的蛋白质连接区要把两个结构域接起来,端点之间能隔多远就很有用;观察一条RNA在溶液里的整体舒展程度时,所有部分的空间分布更值得关注;研究一条糖链的化学组成时,又需要知道沿着骨架共有多少个单元。这些描述可以同时成立。选尺寸指标之前,先说清楚要回答的实验问题,数据表中同样写着“大小”的两列才不会被误当成同一种量。
我们暂时把长链画成一串等长的直线段,相邻线段之间可以自由改变方向,称为自由连接链。设共有N个链段,每段长度为b,那么两端与中间的连接位置合起来,共有N+1个珠子。N是计数,没有长度单位;b在本节统一用纳米nm表示。珠子从0编号到N,链段从1编号到N,这个看似细小的区别会直接进入回转半径的分母,也是短链计算中很容易出现差一项的地方。
这里的一段是一段统计模型中的长度。真实蛋白质主链、糖苷键或核酸骨架都有特定的键角和转动限制,邻近化学键的方向往往彼此相关。若希望用自由连接模型描述它们,通常要把若干微观细节合并成一个有效链段,并说明这个模型在哪种尺度上适用。可以把这件事想成看地图:步行地图保留每个路口,城市间的交通图则把一段复杂路线概括为一条连接。简化时保留什么,取决于想比较的是局部结构还是整条链的尺度。
怎样记录一段在空间里的方向?从一个珠子指向下一个珠子的箭头,称为链段向量,记作粗体bi。下标i只是第几个链段的编号。把起点放在原点,沿着链依次走完所有箭头,它们的向量和就是从起点指向终点的末端向量,记作粗体R。向量既包含“隔了多远”,也包含“朝哪个方向”;通常字体不加粗的R只表示这个箭头的长度,数值总是非负。
第一行的L等于N乘b,是沿链长度。第二行把空间中的距离写成三个坐标分量的平方和再开平方:Rx、Ry、Rz分别记录沿三个坐标方向的位移。它是勾股定理从平面到三维的延伸。例如,终点相对起点沿x方向移动3nm、沿y方向移动4nm、沿z方向没有移动,末端距就是√(9+16)=5nm。方向位移可以带负号,但平方后的距离贡献都非负,所以向左与向右同样远的两个终点具有相同末端距。
如果把链整体平移,起点与终点一起移动,它们之间的距离保持不变;如果把链整体旋转,三个坐标分量可能改变,平方和仍然不变。这是尺寸量应有的一个性质:放在哪里、从哪个方向观察,都不该改变分子的大小。将来给AI输入三维坐标时,这个要求会成为一项可直接检验的物理约束。现在的公式已经提供了一个简单办法,用平移和旋转后的同一条链检查程序是否把坐标与尺寸分清。
自由连接模型还作了一个重要约定:每段的方向独立选择,空间中没有偏爱的方向。后一条称为各向同性,可以想成球面上的任何朝向都被公平对待。模型允许不同部分相互穿过或重叠,暂时不加入真实链的体积排斥,也不加入某两处之间的吸引。这样的选择使我们能够算出明确的参照。后面改变溶剂、加入相互作用时,便能具体指出尺寸偏离这个参照的原因,而不是从一团复杂现象中同时猜测所有因素。
1936年,Werner Kuhn在关于线形分子形状与性质的论文中,讨论了长分子的空间形态怎样参与解释溶液与弹性固体中的性质。这一时期的研究让“分子是一条很长的链”进一步成为可计算的空间问题:长度相同的链能摆出哪些姿势,这些姿势合起来呈现怎样的统计尺度?我们接下来用最简模型重新走一遍这条思路,把看起来杂乱的形状转成可以验证的平均关系。[1]
02为什么典型尺寸随链长的平方根增长
假设一条链含100个链段,每段1nm,沿链长度就是100nm。它若完全伸直,末端距也达到100nm;若各段朝向不断改变,向前走的一部分会被后来向后的位移抵消。多数情况下,终点不会离起点那么远。这里说的抵消只发生在方向位移上:已经走过的路不会缩短,但最后的净位移可以减小。生活中绕着街区走一大圈又回到附近,也能体会路径长度与净位移的差别。
直接平均许多末端向量,会得到一个容易误解的结果。对于每条朝右伸出的构象,统计上也有同样可能的朝左构象;其他方向也成对抵消。因此,各向同性样本的平均末端向量趋近于零。这个零表示没有集体偏爱的朝向,而每条链仍有自己的大小。为了保留尺寸信息,我们先计算每条链的末端距平方R²,再把许多构象的结果平均,最后开平方,使单位回到长度。
这种“先平方、再平均、后开方”的操作称为均方根。角括号〈 〉表示对许多构象取平均,Rrms就是√〈R²〉。它与直接平均距离〈R〉一般不同。取一个简单的两次测量例子:距离分别为0和2nm,普通平均是1nm,均方根却是√[(0²+2²)/2]=√2nm,约1.41nm。较大的距离在平方以后占更大分量,所以这两种平均回答的是不同的统计问题;记录实验或模型目标时,应保留具体定义。
平方有什么特别的便利?先看只有两段的链。两段向量相加后再与自己作点积,等于第一段的平方、第二段的平方,再加两倍的交叉点积。点积是把两个向量的对应坐标相乘再相加;也可以写成两段长度的乘积,再乘夹角的余弦。方向相同时这项为正,方向相反时为负,垂直时为零。于是,链段之间朝向的关系被放进了一个可以相加、也可以平均的数字里。
式子里的i<j表示每一对不同链段只数一次,例如第1段与第2段计入以后,不再把第2段与第1段重复计入。前面的系数2来自展开时原本出现的两个相同交叉项。每段的长度固定为b,所以它与自己的点积都等于b²,N段合起来就是Nb²。剩下的问题只在于:不同链段之间的交叉项,平均之后留下多少?
对于独立且各向同性的两段,先固定其中一段,再看另一段的所有可能朝向。若一个方向给出正的点积,反方向就给出绝对值相同的负点积,二者出现机会相同,平均便为零。对每一对链段都这样处理,所有交叉项的平均一起消失,只留下Nb²。这个结论说的是许多构象的平均;某一条具体构象里的交叉项通常不等于零。也正因为这些项在单条链上会变化,同一个N和b才会产生许多不同的末端距。
把结果开平方,就得到本节最常用的尺寸关系。它可以用一个直观的想法帮助记忆:各段独立贡献的是“距离平方的平均”,这些贡献像一笔笔账相加,得到N倍;最后我们想读的是长度,便要开平方,于是N变成√N。若一开始就把所有段长直接相加,得到的是沿链长度,那相当于假定每一段的前进都朝着同一个方向,与随机转向的模型不同。
回到100段、每段1nm的例子,均方根末端距为10nm。把链加长到400段,沿链长度增至400nm,均方根末端距则增至20nm。链段数变为四倍,典型末端尺度变为两倍。进一步把末端尺度除以沿链长度,可以看出比例随N增大而减小:链在绝对尺度上更大,却相对于完全伸直时显得更蜷曲。这两个观察并不矛盾,因为比较所用的分母不同。
这个平方根规律来自刚才明确用过的条件。若相邻链段倾向于保持同一方向,交叉项的平均就可能为正,链会比同样段数的独立转向模型更伸展;若某些相隔很远的部分容易靠近,构象统计也会改变。读一个公式时,可以沿着推导回头找“哪一步用了什么条件”。以后研究蛋白质柔性连接区、带电糖链或RNA结构时,这样做比只记住末尾的平方根更有用,因为它告诉我们哪些变化会改变尺寸关系。
程序将按照这个模型真正生成三维构象。它先为每段生成三个独立的正态随机数,把组成的向量除以自身长度,得到单位方向,再逐段累加坐标。三个分量共同具有旋转对称性,归一化以后方向均匀分布在球面上。直接让球坐标中的两个角都均匀抽样,反而会在某些朝向堆积更多点;选取生成方法时,需要检查它是否实现了“每个朝向都被公平对待”这一物理约定。
03让所有珠子一起告诉我们链有多大
末端距只看两端。如果把四段等长的链绕成一个正方形,首尾会重合;如果让它沿着同一段直线来回走两次,首尾也会重合。两种构象的末端距都是零,珠子铺开的范围却不同。想比较这种区别,便要给每个珠子一次参与的机会。最自然的办法是先找到整条链的中心,再看各个珠子离中心多远。
在本节的等权珠子模型里,中心就是所有珠子坐标的平均。可以把一串珠子想成挂在轻线上的等重小砝码,它们的共同重心由每个位置同等贡献。若各珠质量不同,应按质量加权;若讨论散射观测,还需要根据所用散射信号的权重来建立相应联系。我们目前使用等权定义,使几何、代码与后面的精确公式保持一致。小写粗体ri表示第i个珠子的位置,与整条链的末端向量R分开使用。
先算中心rc,再把每个位置减去它,得到各珠子相对中心的位移。把这些距离平方取平均,得到Rg²;最后开平方,就是回转半径Rg。它的名字与质量围绕中心分布、转动惯量的描述有关,计算时并不需要让分子真的转起来。这里的“半径”也不是一条硬边界:有些珠子在这个尺度以内,有些可以在外面,整条链的分布共同决定它的数值。
用三颗珠子亲手算一次。把它们放在平面上的(0,0)、(1,0)、(1,1)nm处,z坐标都为0,中心就是(2/3,1/3)nm。三个珠子到中心的距离平方分别为5/9、2/9和5/9nm²,加起来是12/9nm²,再除以3,得到Rg²=4/9nm²,回转半径为2/3nm。若把每个x坐标都加10,中心的x坐标也加10,相减时这10会抵消,回转半径便保持原样。
两端回到同一点,整条链仍有不同的大小
交互图默认把四段、每段1nm的链绕成一圈,共五个珠子,首尾重合但仍分别计数,算得Rg²=0.48nm²。切换到往返两次,结果变为0.24nm²,而末端距始终为零。把段长加倍,所有相对中心的距离也加倍,因此距离平方与Rg²都变为四倍,Rg本身则变为两倍。这个操作把长度与长度平方的单位关系显示了出来,也为代码提供了一项很容易复查的缩放检查。
还有一种计算回转半径的方法:比较所有珠子对之间的距离。它的好处是无需先选择原点或求出中心,每一对相对位置直接进入计算。两种方法为何等价?把任意两珠的距离平方展开,再对所有有序珠子对求和,会得到两份“珠子数量乘坐标平方和”,减去两份“坐标总和的平方”。代入中心定义,这等于2(N+1)乘以所有珠子到中心距离平方的总和,也就是2(N+1)²Rg²。有序对中的两种次序相同,因此每对只计一次时把2约掉,再除以(N+1)²,就得到下面第一行。
第一行对任何一组等权珠子坐标都成立;从第二行开始,我们才用自由连接链的统计条件。沿链相隔s段的两颗珠子,中间就是一条含s个独立链段的小链,所以它们的平均距离平方为sb²。共有N+1颗珠子时,间隔1段的珠子对有N对,间隔2段的有N−1对,直到间隔N段只剩首尾一对。一般写成N+1−s,乘以每对的sb²,再对所有间隔相加。
这个求和可以用高中常见的两条关系算完:1到N的和为N(N+1)/2,平方和为N(N+1)(2N+1)/6。把(N+1−s)s展开成(N+1)s−s²,分别代入两条求和公式,再除以(N+1)²,就得到最后一行。我们没有把每个珠对的空间方向重新算一遍,而是借用了已经得到的小链末端距规律。这种把复杂对象拆成许多熟悉的小问题的办法,在统计物理与图算法中都很常见。
当N很大时,(N+2)/(N+1)接近1,平均回转半径平方便接近Nb²/6,也就是平均末端距平方的六分之一。若N=1,精确公式给出b²/4:两颗珠子各距中心b/2,直接计算也得到相同结果。此时若套长链近似,会得到b²/6,与几何事实不同。程序因此在验证短链时保留有限N的精确表达,并在结果图里画出近似与精确结果怎样随着链变长而靠近。
2010年,Robert Rambo与John Tainer研究RNA的小角X射线散射数据时,把样品中不同状态的混合与整体尺寸的解释联系起来。他们比较RNA样品的处理与散射分析,发现样品状态的混杂会使不同分析给出的形状判断难以一致,分离与样品检查有助于改善解释。这段研究提醒我们,回转半径一旦进入真实实验,就需要与“究竟测到了哪些分子状态”一起理解。[2]
对AI而言,尺寸标签同样需要这层说明。坐标文件算出的等权Rg、按原子质量加权的Rg,以及从某种散射信号提取的尺度,可能采用不同权重和样本平均方式。汇集数据时,应把观测定义、样品条件与计算方式写进同一条记录。这样,模型遇到两种不同数值时,研究者才能判断它是在学习结构差异,还是在试图把不同尺子的读数混成一个目标。第十七节会进一步从实验信号出发,建立这种对应关系。
04让AI学习尺寸,也让它接受新链长的检验
现在可以组织一个目标清楚的学习任务:输入链段数N与段长b,预测许多构象的均方根末端距。每一行数据对应一种N、b组合,其目标值由6000条独立构象的末端距平方平均后开方得到。它与单条构象的尺寸预测不同:同一个N和b仍会对应一整片单链距离分布,而本次学习的是这片分布的一个统计尺度。训练以前先确定这一点,模型输出的误差才有明确的参照。
数据量也要按它的生成方式理解。程序对16种N分别生成6000条构象,一共96000条;每组先使用1nm段长,再把同一组坐标按0.5、0.75、1、1.5和2nm的段长缩放。于是共有80行尺寸统计。相同N下的五行共享构象方向,彼此相关。整组放在一起划分,可以保留这种联系;把其中几行放进训练、另几行放进测试,则会让“新链长”的检查混入已经见过的几何样本。
训练使用9种链段数:8、12、16、32、40、64、80、112和128。范围内测试留出24、48和96,研究模型能否填补已覆盖区间里的空档;更长链测试使用192、256、384和512,研究模型能否越过训练上限。三个集合的N完全不重叠。测试仍使用同一组五种段长,因此这次主要改变的是链长,结论也围绕链长展开。如果要评价从未见过的段长,需要另外安排相应的留出条件。
第一个模型是简单线性回归,把N和b分别乘上可学习系数再加一个偏置。它可以随链长和段长改变预测,却只提供一个平面,而我们刚才推导的尺寸关系中有平方根以及两个量的相乘。把它放进比较,是为了看清最简单的经验关系能解释到哪里。训练与测试使用同一套单位和划分,复杂模型取得改善时,才知道改善对应的是多学到了什么变化。
第二个模型是一层含32个隐藏单元的小型神经网络。它先根据训练行的均值与标准差缩放两个输入,使数值大小更接近,再把输入送给每个隐藏单元。单元内部先加权求和,加上偏置,然后把负值置为0,正值保持原样。这个折线函数叫作ReLU。每个单元可以在不同位置开始起作用,32个单元的输出再加权相加,就能拼出比一条直线灵活得多的响应。
x1与x2是缩放后的N和b,w1j、w2j控制第j个单元对它们的响应,cj移动折线开始的位置。vj控制这个单元对最终输出的贡献,d是输出偏置。训练目标y也除以训练侧的平均尺寸,得到便于优化的无量纲数;预测完成以后再乘回这个尺度,恢复纳米。M为训练行数,式子中的平方误差对全部45行取平均,决定这组参数当前算得有多接近观测。
训练会调整第一层和输出层的全部参数。以一个样本为例,预测误差为ê=ŷ−y,平方误差对预测值的导数就是2ê;要知道某个输出权重怎样改变损失,再乘以相应的隐藏单元输出。继续向前传到第一层时,还要乘输出权重与ReLU的导数:单元激活时导数为1,未激活时为0。这就是链式法则沿计算过程逐层传回的反向传播。代码把所有样本的这些贡献平均,随后用Adam更新参数,连续执行6000步。
Adam会记住最近几步梯度的方向和大小,再为不同参数调整步幅。程序累计梯度及其平方的衰减平均,让较近的更新占较大权重,并在起步阶段作校正;本例学习率为0.003。先把训练过程理解成“算预测、比较误差、求导、改参数”的循环,再读这些步幅调节,会容易得多。导数也可以用直接计算来理解:把一个参数分别增加和减少很小的量,比较两次损失,便能估计损失对它的变化率。代码用这个办法核对反向传播;两种算法在足够小的扰动下应给出接近的结果。
第三个模型把物理问题中的尺度结构交给回归来学习。设尺寸可以写成N与b的幂次乘积,让数据决定两个指数,而不是预先把二分之一填进去。幂次关系在取对数后会成为线性关系,因此仍能用很简单的最小二乘拟合求出。对数里面的量应当没有单位:代码中的b以1nm为参照,尺寸也先除以1nm;换单位时,只要连同参照单位一致换算,关系的含义便保持清楚。
A是幅度系数,α与β分别描述链段数和段长的指数,帽子表示模型预测。这里的log采用自然对数,exp是它的反运算,拟合完成后把对数预测取指数便回到尺寸。对于本节自由连接链,解析推导给出A=1、α=1/2、β=1;回归只读取模拟统计,并不知道这些答案。若它能接近这些数值,就说明有限样本中的平均规律被恢复到了相应精度。由于五种段长来自同一批构象的严格缩放,β接近1也有其明确的数据生成原因。
2021年,Keyulu Xu等人在关于神经网络外推的研究中,分析了前馈网络与图神经网络如何面对训练范围以外的输入,并把特征或网络中所包含的任务结构与外推表现联系起来。对本节的问题而言,这提供了一个有用的观察角度:一组折线在已见区间可以很好地贴近平方根曲线,继续延伸以后,它们与平方根的差别才会逐渐显现。把尺寸问题中的幂次结构写进表示,则改变了模型延伸曲线的方式。[3]
这种思路也会进入后面的GNN章节。分子图的节点数可以变化,网络需要把局部连接的信息组合成整条链的预测。聚合采用求和还是平均、输入是否包含几何尺度、输出是否满足平移旋转不变性,都会影响它怎样处理更大的分子。我们到时会训练实际的图模型,并保留新结构与新尺寸的分组测试。本节先用两个输入把外推问题讲清楚,让之后复杂模型中的每个设计都有可以追问的科学理由。
05完整计算:从构象分布到外推曲线
下面的程序完成采样、几何计算、三种回归训练、科学检查与绘图,依赖NumPy和Matplotlib。随机生成过程固定种子,使同一份代码的结果可以重复。为了控制内存,每次生成250条链,算完末端距与回转半径后收集统计量,再生成下一批。三维链坐标由前一段坐标加上新链段得到;程序中的累加对应我们沿着链逐步走到末端的过程,中心坐标与回转半径则按前面的定义直接计算。
三次神经网络训练分别使用预先指定的11、23和37作为初值种子,训练步数、宽度与学习率保持相同。图中使用三次预测的平均,并显示它们的最小至最大范围,让读者看见初始化带来的变化。这个范围描述的是三次训练之间的差异;模拟采样的误差另由构象分布计算。程序同时保存每次网络的权重、训练侧缩放参数、每组统计和完整预测,使误差数字与生成它们的模型可以一一对应。
几何检查包含固定段长、整体旋转和平移、中心算法与珠对算法的一致性。统计检查则把模拟得到的〈R²〉和〈Rg²〉分别与精确表达式比较,并除以该平均量的抽样标准误。标准误反映有限构象数导致的平均值波动:它通常比单条链尺寸的波动小,增加独立构象数可以继续减小它。我们检查的是偏离相对于这项波动有多大,从而把正常的随机差别与明显的实现错误区分开。
"""Chain size and extrapolation. Run with Python, NumPy and Matplotlib.

N is the number of freely jointed segments; there are N+1 equal beads.
All conformations are independent equilibrium samples, not a time trajectory.
Length unit: nm. Learning targets are Monte Carlo RMS end distances.
"""
from pathlib import Path
import json
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

OUT = Path("chain_size_outputs")
OUT.mkdir(exist_ok=True)
plt.rcParams.update({"font.family": "DejaVu Sans", "font.size": 14,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.labelsize": 14, "axes.titlesize": 15, "legend.fontsize": 11.5,
    "svg.hashsalt": "L05-chain-size", "savefig.facecolor": "#fffdf8"})
COLORS = ["#8a7865", "#cf6b45", "#237a68", "#293d65"]
TRAIN_N = [8, 12, 16, 32, 40, 64, 80, 112, 128]
TEST_N = [24, 48, 96]
LONG_N = [192, 256, 384, 512]
B_VALUES = np.array([0.5, 0.75, 1.0, 1.5, 2.0])
SAMPLE_COUNT = 6000


def chains(rng, n, count):
    """Isotropic 3D unit steps from normalized independent normal vectors."""
    steps = rng.normal(size=(count, n, 3))
    steps /= np.linalg.norm(steps, axis=2, keepdims=True)
    points = np.concatenate([np.zeros((count, 1, 3)),
                             np.cumsum(steps, axis=1)], axis=1)
    center = points.mean(axis=1, keepdims=True)
    r2 = np.sum(points[:, -1] ** 2, axis=1)
    rg2 = np.mean(np.sum((points-center)**2, axis=2), axis=1)
    return points, r2, rg2


def sample_data():
    rng = np.random.default_rng(505)
    rows, diagnostics, distributions = [], [], {}
    example = None
    for n in sorted(TRAIN_N + TEST_N + LONG_N):
        r2_parts, rg2_parts = [], []
        for batch in range(SAMPLE_COUNT // 250):
            points, r2, rg2 = chains(rng, n, 250)
            r2_parts.append(r2); rg2_parts.append(rg2)
            if n == 64 and batch == 0:
                example = points[:3].copy()
        r2, rg2 = np.concatenate(r2_parts), np.concatenate(rg2_parts)
        exact_rg2 = n * (n+2) / (6*(n+1))
        se_r2 = r2.std(ddof=1)/np.sqrt(SAMPLE_COUNT)
        se_rg2 = rg2.std(ddof=1)/np.sqrt(SAMPLE_COUNT)
        diagnostics.append({"N": n, "mean_R2": float(r2.mean()),
            "mean_Rg2": float(rg2.mean()), "se_R2": float(se_r2),
            "se_Rg2": float(se_rg2), "exact_Rg2": exact_rg2,
            "z_R2": float((r2.mean()-n)/se_r2),
            "z_Rg2": float((rg2.mean()-exact_rg2)/se_rg2)})
        split = "train" if n in TRAIN_N else "in_range" if n in TEST_N else "longer"
        for b in B_VALUES:
            # Scaling the SAME samples is intentional; the full N group stays together.
            rows.append({"N": n, "b_nm": float(b), "split": split,
                "rms_R_nm": float(np.sqrt(r2.mean())*b),
                "rms_Rg_nm": float(np.sqrt(rg2.mean())*b),
                "rms_R_se_nm": float(se_r2/(2*np.sqrt(r2.mean()))*b),
                "exact_R_nm": float(np.sqrt(n)*b)})
        if n == 64:
            distributions = {"R": np.sqrt(r2).tolist(), "Rg": np.sqrt(rg2).tolist()}
    return rows, diagnostics, example, distributions


def loss_and_grad(parameters, x, y):
    w1, c1, w2, c2 = parameters
    z = x @ w1 + c1
    h = np.maximum(z, 0.0)
    error = h @ w2 + c2 - y
    d_out = 2.0 * error / len(y)
    d_hidden = (d_out @ w2.T) * (z > 0)
    grads = [x.T @ d_hidden, d_hidden.sum(axis=0),
             h.T @ d_out, d_out.sum(axis=0)]
    return float(np.mean(error**2)), grads


def network(parameters, x):
    w1, c1, w2, c2 = parameters
    return (np.maximum(x @ w1 + c1, 0) @ w2 + c2).ravel()


def train_network(x, y, seed, steps=6000):
    rng = np.random.default_rng(seed)
    parameters = [rng.normal(0, 0.5, (2, 32)), np.zeros(32),
                  rng.normal(0, 0.15, (32, 1)), np.zeros(1)]
    # Full-batch gradient descent with Adam's first/second moment estimates.
    first, second = [np.zeros_like(p) for p in parameters], [np.zeros_like(p) for p in parameters]
    history = []
    for t in range(1, steps+1):
        loss, gradients = loss_and_grad(parameters, x, y[:, None])
        for j, gradient in enumerate(gradients):
            first[j] = .9*first[j] + .1*gradient
            second[j] = .999*second[j] + .001*gradient**2
            m = first[j]/(1-.9**t); v = second[j]/(1-.999**t)
            parameters[j] -= .003*m/(np.sqrt(v)+1e-8)
        if t == 1 or t % 50 == 0:
            history.append([t, loss])
    return parameters, np.array(history)


def scientific_checks(diag, example):
    p = example[0]
    center = p.mean(axis=0)
    geometric = np.mean(np.sum((p-center)**2, axis=1))
    pair = np.sum((p[:, None]-p[None, :])**2)/(2*len(p)**2)
    q, _ = np.linalg.qr(np.random.default_rng(7).normal(size=(3, 3)))
    q[:, 0] *= np.linalg.det(q)
    moved = p @ q + [20, -5, 11]
    moved_rg2 = np.mean(np.sum((moved-moved.mean(axis=0))**2, axis=1))
    assert abs(geometric-pair) < 1e-10
    assert abs(moved_rg2-geometric) < 1e-10
    step_error = np.max(np.abs(np.linalg.norm(np.diff(example, axis=1), axis=2)-1))
    assert step_error < 1e-12
    zmax = max(abs(d[k]) for d in diag for k in ("z_R2", "z_Rg2"))
    assert zmax < 5, "Compare sampling uncertainty before trusting the simulator."
    # An independent central-difference check of actual learning derivatives.
    r = np.random.default_rng(9)
    pars = [r.normal(size=(2, 4)), r.normal(size=4),
            r.normal(size=(4, 1)), r.normal(size=1)]
    x, y = r.normal(size=(7, 2)), r.normal(size=(7, 1))
    _, gradients = loss_and_grad(pars, x, y)
    gradient_error = 0.0
    for j, par in enumerate(pars):
        for ix in np.ndindex(par.shape):
            old = par[ix]; eps = 1e-6
            par[ix] = old+eps; plus = loss_and_grad(pars, x, y)[0]
            par[ix] = old-eps; minus = loss_and_grad(pars, x, y)[0]
            par[ix] = old
            gradient_error = max(gradient_error, abs((plus-minus)/(2*eps)-gradients[j][ix]))
    assert gradient_error < 1e-7
    return {"pair_identity_error": float(abs(geometric-pair)),
        "rotation_translation_error": float(abs(moved_rg2-geometric)),
        "segment_length_error": float(step_error), "maximum_sampling_z": zmax,
        "gradient_max_error": gradient_error}


def main():
    rows, diagnostics, example, distributions = sample_data()
    x = np.array([[r["N"], r["b_nm"]] for r in rows])
    y = np.array([r["rms_R_nm"] for r in rows])
    exact = np.array([r["exact_R_nm"] for r in rows])
    split = np.array([r["split"] for r in rows])
    train = split == "train"
    # Statistics of the test groups never enter the scaling or the optimization.
    mu, sd = x[train].mean(axis=0), x[train].std(axis=0)
    yscale = y[train].mean()
    scaled = (x-mu)/sd
    linear_weights = np.linalg.lstsq(np.c_[np.ones(train.sum()), scaled[train]], y[train], rcond=None)[0]
    # b and R are numerical ratios to 1 nm, making all logarithms dimensionless.
    log_weights = np.linalg.lstsq(np.c_[np.ones(train.sum()), np.log(x[train])], np.log(y[train]), rcond=None)[0]
    models, histories = [], []
    for seed in [11, 23, 37]:
        model, history = train_network(scaled[train], y[train]/yscale, seed)
        models.append(model); histories.append(history)

    def predictions(values):
        s = (values-mu)/sd
        nn = np.stack([network(model, s)*yscale for model in models])
        return {"linear": np.c_[np.ones(len(values)), s] @ linear_weights,
            "mlp": nn.mean(axis=0),
            "scaling": np.exp(np.c_[np.ones(len(values)), np.log(values)] @ log_weights),
            "analytic": values[:, 1]*np.sqrt(values[:, 0])}, nn

    pred, all_nn = predictions(x)
    metrics = {}
    for name in ["in_range", "longer"]:
        mask = split == name
        metrics[name] = {key: {"relative_mae_percent": float(np.mean(np.abs(p[mask]-exact[mask])/exact[mask])*100),
            "mae_nm": float(np.mean(np.abs(p[mask]-exact[mask])))} for key, p in pred.items()}
        metrics[name]["mlp_individual_relative_percent"] = [float(np.mean(np.abs(p[mask]-exact[mask])/exact[mask])*100) for p in all_nn]
    checks = scientific_checks(diagnostics, example)
    assert not (set(TRAIN_N) & set(TEST_N + LONG_N))
    results = {"definition": "3D freely jointed chain, N segments, N+1 equal beads, b in nm",
        "samples_per_N": SAMPLE_COUNT, "train_N": TRAIN_N, "test_N": TEST_N, "longer_N": LONG_N,
        "learning_target": "Monte Carlo RMS R; metrics use exact RMS R",
        "units": {"N": "segment count", "b": "nm", "R": "nm"},
        "scaling_fit": {"intercept": float(log_weights[0]), "exponent_N": float(log_weights[1]), "exponent_b": float(log_weights[2])},
        "standardization": {"x_mean": mu.tolist(), "x_std": sd.tolist(), "y_scale": float(yscale)},
        "linear_weights": linear_weights.tolist(), "log_weights": log_weights.tolist(),
        "mlp_weights": [[p.tolist() for p in m] for m in models], "mlp_seeds": [11, 23, 37],
        "training_steps": 6000, "hidden_units": 32, "metrics": metrics, "checks": checks,
        "monte_carlo": diagnostics}
    for i, row in enumerate(rows):
        row["predictions_nm"] = {key: float(v[i]) for key, v in pred.items()}
    (OUT/"samples.json").write_text(json.dumps(rows, indent=2), encoding="utf-8")
    (OUT/"results.json").write_text(json.dumps(results, indent=2), encoding="utf-8")

    def panel(ax, key):
        if key == "conformations":
            for k, p in enumerate(example):
                centered = p-p.mean(axis=0)
                centered[:, 0] += 16*k
                ax.plot(centered[:, 0], centered[:, 1], color=COLORS[k], lw=1.5)
                ax.scatter([16*k], [0], marker="+", s=100, color="#202e39", zorder=4)
            ax.set(xlabel="x / nm (offset for display)", ylabel="y / nm", title="A  Three conformations, N = 64")
            ax.set_aspect("equal", adjustable="datalim")
            ax.text(.03, .96, "3D chains projected onto x-y; + = center", transform=ax.transAxes, va="top", fontsize=10)
        elif key == "distributions":
            for name, c in [("R", COLORS[1]), ("Rg", COLORS[2])]:
                ax.hist(distributions[name], bins=45, density=True, histtype="step", lw=2, color=c, label=name)
            ax.axvline(8, color=COLORS[1], ls="--", lw=1.3, label="R RMS = 8 nm")
            ax.set(xlabel="Size / nm", ylabel="Probability density / nm$^{-1}$", title="B  Size fluctuates: 6,000 chains")
            ax.legend(frameon=False)
        elif key == "finite_size":
            ns = np.arange(1, 129)
            ax.plot(ns, (ns+2)/(ns+1), c=COLORS[2], label="Exact finite-N ratio")
            ax.axhline(1, c=COLORS[0], ls="--", label="Long-chain approximation")
            ax.set(xscale="log", xlabel="N / segments", ylabel=r"$\langle R_g^2\rangle\, /\, (Nb^2/6)$", title="C  The short-chain correction")
            ax.scatter([d["N"] for d in diagnostics if d["N"] <=128], [d["mean_Rg2"]/(d["N"]/6) for d in diagnostics if d["N"] <=128], color=COLORS[1], s=22, label="Monte Carlo")
            ax.legend(frameon=False)
        elif key == "training":
            for h, seed, c in zip(histories, [11, 23, 37], COLORS):
                ax.plot(h[:, 0], h[:, 1], color=c, label=f"Seed {seed}")
            ax.set(yscale="log", xlabel="Optimization step", ylabel="Training MSE (scaled output)", title="D  Training all network weights")
            ax.legend(frameon=False)
        elif key == "extrapolation":
            ns = np.linspace(8, 512, 400); vals = np.c_[ns, np.ones(len(ns))]
            pp, pn = predictions(vals)
            ax.axvspan(128, 512, color="#f0e5d3", alpha=.7)
            labels = ["Linear", "MLP ensemble", "Log-scaling fit", "Analytic"]
            for (key2, v), label, c in zip(pp.items(), labels, COLORS):
                ax.plot(ns, v, color=c, lw=2, ls="--" if key2=="analytic" else "-", label=label)
            ax.fill_between(ns, pn.min(axis=0), pn.max(axis=0), color=COLORS[1], alpha=.15)
            ix = train & (x[:, 1] == 1)
            ax.scatter(x[ix, 0], y[ix], c="#242e37", s=18, zorder=5)
            ax.set(xlabel="N / segments", ylabel="RMS end distance / nm", title="E  New chain lengths, b = 1 nm", ylim=(0, None))
            ax.legend(frameon=False, ncol=2, loc="upper left")
        else:
            names = ["linear", "mlp", "scaling", "analytic"]
            for j, group in enumerate(["in_range", "longer"]):
                v = [metrics[group][name]["relative_mae_percent"] for name in names]
                ax.bar(np.arange(4)+(j-.5)*.36, v, width=.36, color=[COLORS[2], COLORS[1]][j], label=["Held-out N, inside range", "Longer chains"][j])
            ax.set_xticks(range(4), ["Linear", "MLP", "Scaling", "Analytic"])
            ax.set(ylabel="Mean absolute relative error / %", title="F  Test errors against exact size")
            ax.legend(frameon=False)
        ax.grid(alpha=.16)

    keys = ["conformations", "distributions", "finite_size", "training", "extrapolation", "errors"]
    for key in keys:
        fig, ax = plt.subplots(figsize=(6.4, 4.8), layout="constrained", facecolor="#fffdf8")
        panel(ax, key)
        fig.savefig(OUT/(key+".svg"), metadata={"Date": None})
        plt.close(fig)
    fig, axes = plt.subplots(3, 2, figsize=(16, 16), layout="constrained", facecolor="#fffdf8")
    for ax, key in zip(axes.flat, keys): panel(ax, key)
    fig.savefig(OUT/"chain_size_diagnostics.svg", metadata={"Date": None})
    fig.savefig(OUT/"chain_size_diagnostics.png", dpi=160, metadata={"Software": "Matplotlib"})
    plt.close(fig)
    print(f"Independent conformations: {len(diagnostics)*SAMPLE_COUNT:,}; training rows: {train.sum()}")
    print(f"Learned powers: N = {log_weights[1]:.4f}, b = {log_weights[2]:.4f}")
    for group in ["in_range", "longer"]:
        print(group+": relative MAE (%)", {key: round(metrics[group][key]["relative_mae_percent"], 3) for key in pred})
    print("Maximum sampling z:", round(checks["maximum_sampling_z"], 3))
    print("Backpropagation gradient check:", f'{checks["gradient_max_error"]:.2e}')
    print("Saved six panels, full samples, fitted weights and reproducible checks.")


if __name__ == "__main__":
    main()
本次实际运行输出
Independent conformations: 96,000; training rows: 45
Learned powers: N = 0.5026, b = 1.0000
in_range: relative MAE (%) {'linear': 16.571, 'mlp': 1.331, 'scaling': 0.143, 'analytic': 0.0}
longer: relative MAE (%) {'linear': 72.159, 'mlp': 53.823, 'scaling': 0.555, 'analytic': 0.0}
Maximum sampling z: 1.978
Backpropagation gradient check: 1.23e-10
Saved six panels, full samples, fitted weights and reproducible checks.
一次运行 · 六幅结果图
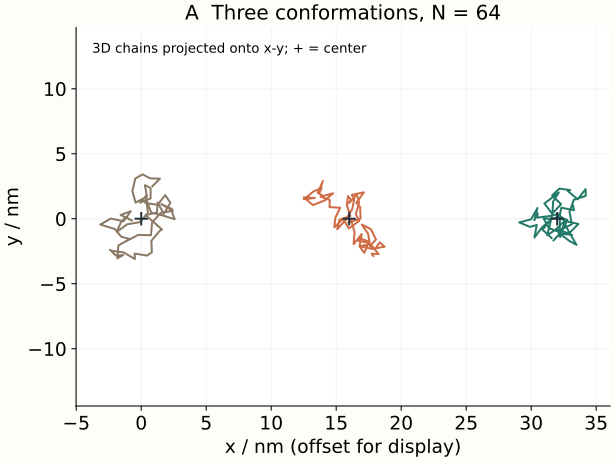
A · 三条独立的三维构象投影;加号是各自的中心,横向平移方便比较。
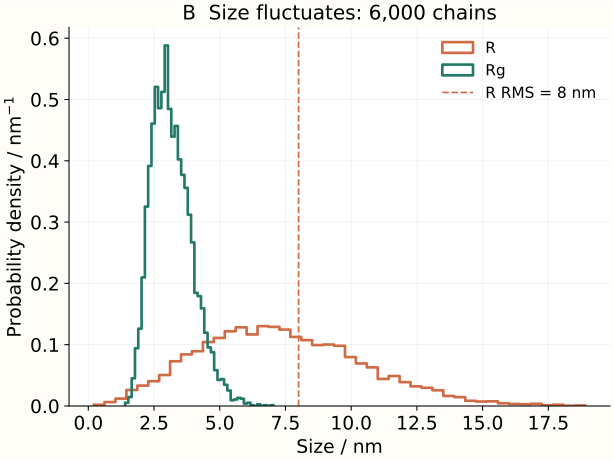
B · 固定64个链段,末端距与回转半径各有分布,虚线标出末端距的均方根。
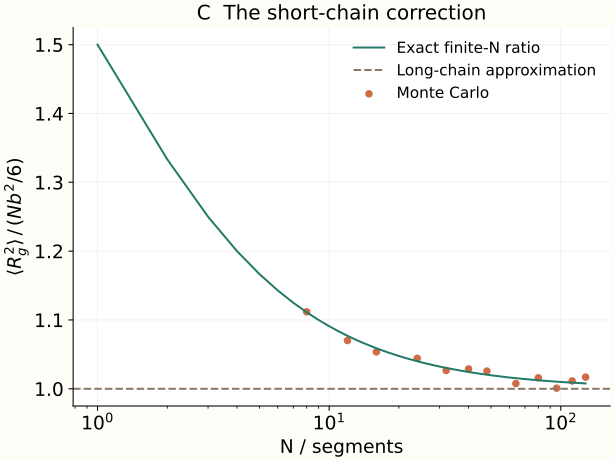
C · 精确的有限链结果与长链近似的比值;圆点来自独立模拟。
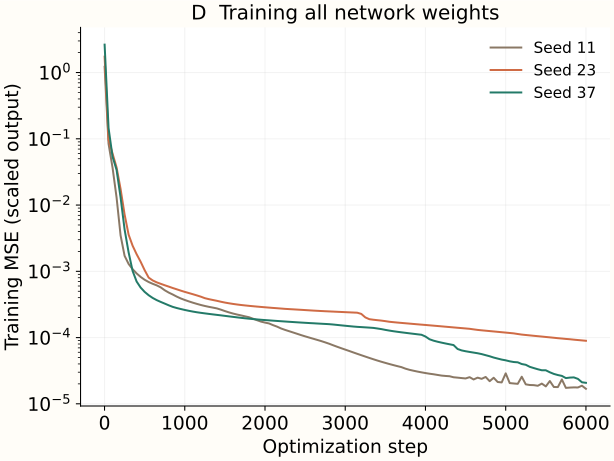
D · 三个预先指定随机初值各训练6000步,纵轴采用对数刻度。
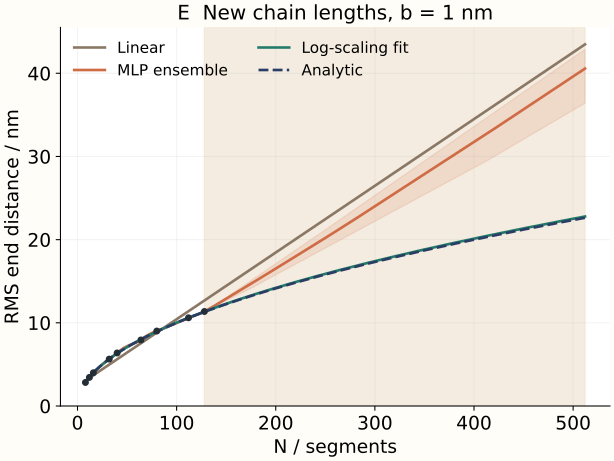
E · 固定段长1nm,从已覆盖长度向更长的链预测;阴影为三次网络预测的最小至最大值。
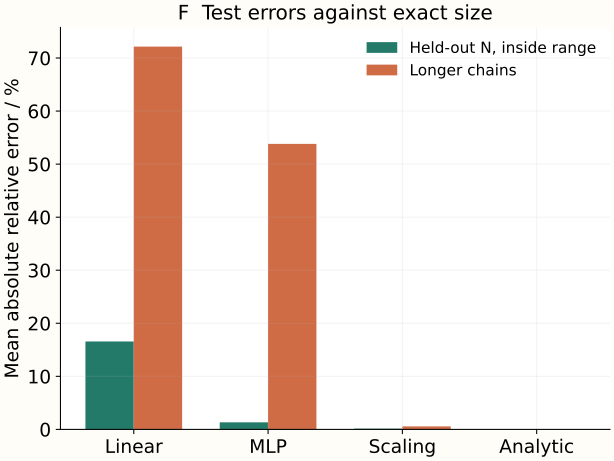
F · 按留出链长分开统计相对误差,解析关系给出本模型的参照。
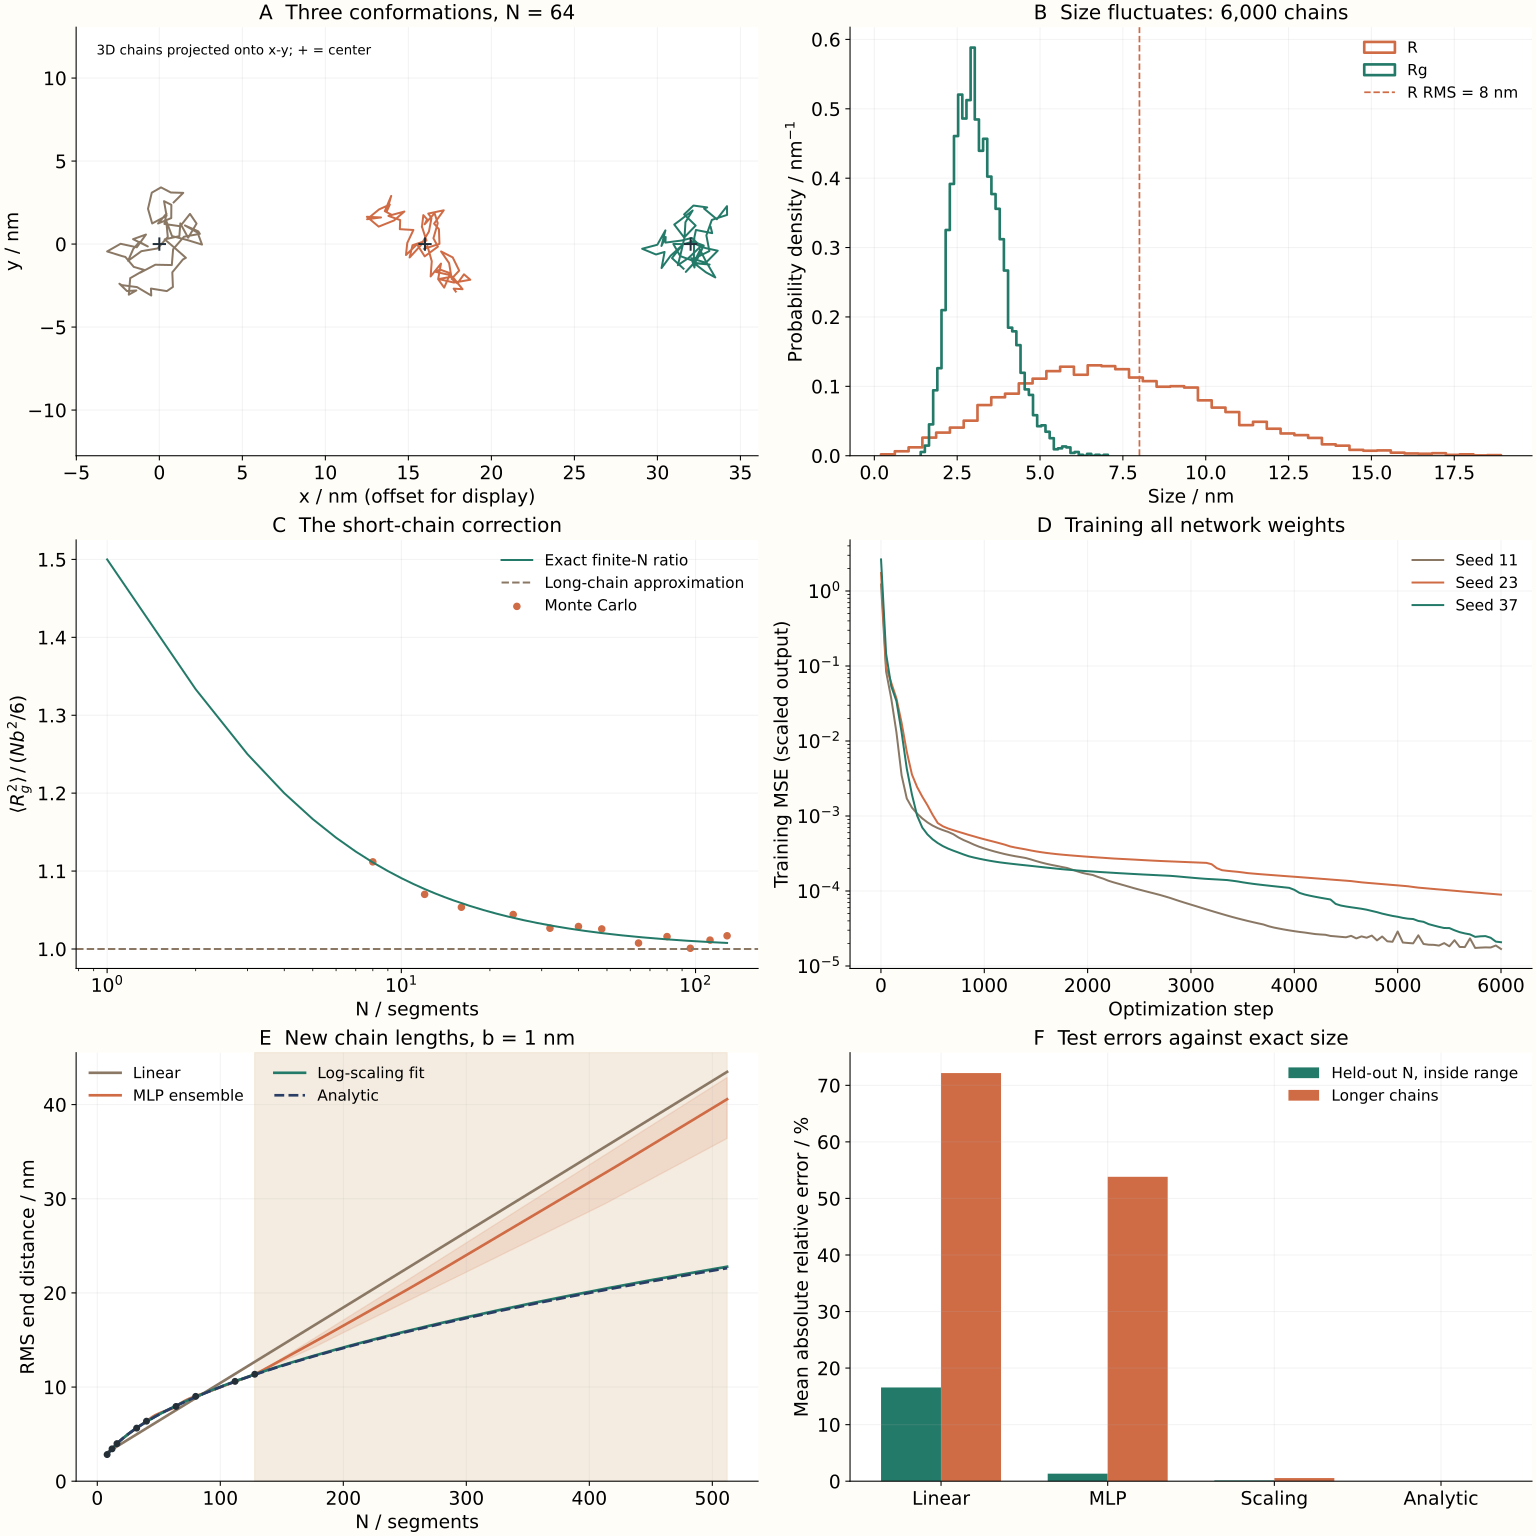
先把图A的链形与图B的分布对照着看。三条链都含64个链段,图A将它们投影到平面并横向移开,方便比较;计算距离时使用的是完整三维坐标。图B则把许多构象放在一起,显示固定N和b以后尺寸仍会波动。末端距只看首尾,回转半径统计全部珠子,所以两种直方图并不相同。末端距图中8 nm的虚线表示均方根:先将各构象的距离平方,再求平均并开方。它与出现次数最多的距离回答不同的问题。读到一条平均线时,先问它怎样计算,再观察线两边还散布着多少构象,就能避免把一个统计量误认成所有链的固定形状。
图C把有限链精确结果除以长链近似Nb²/6,纵轴是没有单位的比值。N=1时它为1.5,随着链段增多逐渐接近1。散点来自本次模拟,围绕精确曲线有小幅波动,与有限样本的统计误差相联系。这个图把两个看似相近的公式放在同一把比例尺上:长链时差别很小,短链时却需要保留具体的珠子数。验证代码时选择短链,有时反而更容易暴露被长链近似掩盖的错误。
图D记录三次网络训练的误差。纵轴使用对数刻度,因此相同的竖直距离表示相同的倍数变化,可以同时看到开始时与后期较小的误差。训练误差下降说明参数在接近训练目标,真正的新链长表现则要读图E与图F。图E固定b=1nm,把训练范围与更长链范围放在一条横轴上,米色背景从128段之后开始;黑点是训练组的模拟统计,彩色曲线显示不同模型怎样从这些点继续延伸。
在范围内留出的链长上,简单线性模型的平均绝对相对误差为16.57%,小型神经网络为1.33%。到了192至512段的更长链,神经网络三次预测平均后的误差为53.82%,图中可以看到它逐渐离开解析曲线。带幂次结构的回归在更长链上的误差为0.56%,学得链长指数为0.5026。这些误差都按每个测试组合的预测与解析均方根尺寸之差计算,再除以相应解析值,最后平均;因此较长链的大数值不会仅凭绝对量级主导结果。
解析曲线的误差为零,因为比较对象就是同一个自由连接链模型的精确关系。模拟平均含有有限采样波动,学习模型拟合的是这些带有抽样差别的统计值。这个安排使三件事各有位置:解析关系给出科学参照,模拟提供可观测的有限样本,学习方法尝试从样本恢复规律。若已经知道适用的解析关系,直接使用它很有效;面对真实分子中复杂的序列、环境和相互作用,研究者则可以保留它作为基线,再学习哪些机制使数据产生系统偏离。
要把学习任务推进到真实的生物大分子,首先要选定对象与尺寸测量方式。例如,研究一组柔性蛋白质片段时,可以记录序列、长度、溶液条件和同一定义下的尺寸,并将相关序列放在同一组中划分训练与测试。比较新长度时,还要检查它是否同时改变了电荷组成或结构倾向。这样,模型的外推误差才能对应到具体变化,接下来的实验也有明确目的:补测缺少的长度区间,或在相同长度下改变某一种化学因素。
可以先保持N和全部随机方向不变,只把b加倍,检查末端距与回转半径是否都加倍,两个平方量是否变为四倍。再保留段长,把测试N改成256、512和1024,观察解析关系、幂次回归与网络如何继续延伸。第二次改动扩大了测试长度,采样所需时间也会增加;仍应将这些新长度完整留在测试侧。最后试着只记录平均末端向量,看看它为什么逐渐趋近零,再与一直保持非零的均方根尺寸比较。
我们现在能用同一套坐标描述一条链,也能从许多姿势中得到稳定的统计尺度。接下来的问题会更接近日常手感:把这样的链拉开以后,为什么会出现回缩的趋势?第六节将继续使用本节的构象统计,把“能摆出多少种姿势”与拉伸时的力联系起来,并让模型在尺寸关系之外再接受一次物理约束的检查。
资料与延伸阅读
- Kuhn,1936,Gestalt und Eigenschaften fadenförmiger Moleküle in Lösungen (und im elastisch festen Zustande),Angewandte Chemie。线形分子的形状与性质。
- Rambo与Tainer,2010,Improving small-angle X-ray scattering data for structural analyses of the RNA world,RNA 16:638–646,DOI:10.1261/rna.1946310。
- Xu等,2021,How Neural Networks Extrapolate: From Feedforward to Graph Neural Networks,ICLR;作者公开稿首次提交于2020年。
科学史图为本节围绕原研究问题重绘的概念图。自由连接链的公式在正文中逐步推导,六幅数据结果图由页面所列Python程序实际生成。