把科学理解转成下一步研究
生物凝胶设计:物理反求与贝叶斯优化
果冻含有大量水,却能保持形状;明胶、海藻酸盐和细胞外基质中的大分子,也能通过连接形成柔软的网络。要让这种材料用于细胞培养、组织模型或其他生物研究,我们需要同时考虑吸水、力学、分子组成和细胞响应。本节从一个具体任务出发:寻找既有指定含水状态、又有合适剪切模量的凝胶条件。我们先用物理关系理解目标,再让AI从已有测量生成候选、安排实验,并把得到的答案转成可以继续开展的生物材料研究。
01从生物用途写出设计目标
想象要为细胞准备一个三维生活环境:周围需要有水,溶质需要交换,材料还要在培养和观察期间维持结构。网络连接多一些,可能提高支撑,也会改变吸水;连接松一些,分子运动和形状保持又会变化。因此,研究者要同时确定几个彼此牵连的目标,并说明它们对应什么环境和使用时间。本节先把问题缩到可计算的两个指标——体积溶胀比与小形变剪切模量,观察它们怎样随网络参数共同改变。找到符合这两个指标的候选后,再接入分子组成、传质和细胞响应的相应测量,逐步完成生物用途所需的评价。
这和挑选一双运动鞋有一点相似。只问鞋底是否够软,无法说明它是否适合长时间行走;还要考虑支撑、回弹、贴合与使用场地。凝胶也有多个彼此联系的性质。这个类比帮助我们理解为什么要同时设置目标,但具体研究仍要回到可测量的量:什么条件下的力学响应,哪一种溶胀比,哪一类细胞,以及观察多长时间。
在生物学中,材料的力学环境很早就引起了研究者的注意。Engler等在2006年的研究使用胶原包被、弹性可调的聚丙烯酰胺基底,观察间充质干细胞的形态和谱系相关标志。他们把细胞接触的基底作为一个可控制的实验因素,让“细胞生活在哪里”进入对细胞行为的解释。这为生物材料设计提供了一个具体问题:能否通过可调的材料环境,研究并影响细胞的响应?
沿着这个问题,设计任务需要同时保留材料和生物两条测量线。材料线记录组成、网络结构、含水状态和力学行为;生物线记录选定细胞在规定培养条件下的响应。两条线在样品编号和实验条件上相连。这样,当细胞形态变化时,我们能够回查对应的材料状态,也能够判断变化是否同时伴随配体呈现、降解或培养环境的改变。
本节先把材料线缩小到两个目标,便于完整展示一轮计算研究。我们规定体积溶胀比Q的中心目标为30,溶胀后的小形变剪切模量G的中心目标为12 kPa。它们是本次数值任务选定的目标,并未从某种细胞的最优培养条件推导而来。到了实际研究中,中心值应由具体用途、先导测量和相应的生物评价共同确定。
中心目标之外,还需要一圈较宽的可行范围:Q至少为20,G处在8到16 kPa之间。它表示本次搜索愿意继续考虑的条件。我们另设一圈更紧的目标范围,要求两个性质各自位于中心值除以1.2和乘以1.2之间,也就是Q为25到36,G为10到14.4 kPa。可行范围回答“是否值得保留”,目标范围回答“是否已经足够接近这次设定”。
这里用了乘法范围,而不是左右相同的加法误差。对于Q=30,乘以1.2得到36,除以1.2得到25;它们在对数坐标中与30相距一样远。生物材料性质有时跨越较大的倍数,用相对变化来比较会比较自然。后面计算目标距离时,我们也采用同一尺度,使图里的目标框、程序中的判断和文字解释互相对应。
选定指标时,还要记住它们回答的问题。Q描述整体体积中聚合物与溶剂的比例,却没有直接告诉我们某种蛋白质能以多快的速度穿过网络;G描述规定状态下的小形变剪切响应,也没有直接给出材料抵抗裂纹扩展的能力。若研究用途涉及药物释放或反复拉伸,就应把扩散、释放、耗散或断裂测量加入目标记录,而不是让已有两列数据代替全部性质。
一份可用的研究起点,因此可以写成一段完整的话:我们选择某一种明确组成的生物凝胶,在规定介质、温度与平衡条件下,寻找满足Q与G目标的条件,再对保留下来的样品评价指定生物响应。材料名称、测试条件、目标和后续测量都能从这句话展开。AI接手的是其中的候选比较与实验安排,每一个预测最后都能指向一份实际记录。
02把吸水与力学连成一张可以计算的图
先从一张浸水的弹性网想起。水进入网线之间,整体体积增大,网线也随之展开。网络变形与水的进入共同改变体系的自由能,平衡时得到一个稳定的含水状态。第十九节已经用这种联系计算溶胀;现在我们再加上同一状态下的剪切模量,把两项性质放进一个一致的模型。这样可以检查一次设计推荐是否同时满足吸水和力学要求。
把聚合物本身占据的体积记为Vp,凝胶总体积记为Vgel,聚合物体积分数φ就是两者之比。假设聚合物体积保持不变,且聚合物与水的体积可以相加,那么Q=1/φ,水体积分数为1−φ。Q=30对应φ=1/30,水占总体积约96.67%。这一步把“水很多”变成了一个具有明确定义的数,也让我们知道后来计算的是体积比例。
式中的νe是按干网络参考体积计算的有效弹性链摩尔密度,单位为mol/m³。R是气体常数,T是绝对温度;本例取R=8.314462618 J/(mol·K)、T=298 K。将νe与RT相乘,得到J/m³,它与Pa等价;φ的三分之一次方没有单位,因此G的单位就是Pa。程序展示kPa时再除以1000,目标12 kPa代入反求式时则要先写成12000 Pa。
为什么这里会出现φ的三分之一次方?体积均匀增加Q倍时,每个方向的长度增加Q的三分之一次方。我们采用按干态定义的高斯链网络,让网络先各向同性地溶胀,再叠加一个小剪切变形。前者改变链的伸展和当前体积,后者用于计算响应。把所选网络自由能对剪切量求二阶变化,并换到溶胀后的体积,便得到νeRTφ的三分之一次方这一关系。
这个参考状态十分关键。如果把有效链密度改为按当前湿体积计数,却仍原样使用干参考公式,同一个符号就会对应不同的数量。类似地,实验给出的压缩杨氏模量E也需要与本节的剪切模量G分开记录。在线性、各向同性且近似不可压缩的条件下,可以得到E约等于3G;采用这一换算时,应同时保留这些条件以及测试状态。前述细胞基底研究中的模量,不能只因为也使用kPa就直接放进本节G这一列。
要确定φ,继续使用一个中性、均匀、具有高斯链弹性的网络模型。χ是描述聚合物与溶剂混合作用的无量纲参数,vs是溶剂摩尔体积,本例固定为18×10−6 m³/mol。下面的平衡式把混合作用和网络回缩合在一起。νe与vs相乘后没有单位,因此各项能放在同一个式子中相加。
给定νe和χ以后,计算机在0与1之间寻找使表达式等于零的φ,再依次得到Q和G。可以把求根理解成逐渐缩小一个夹住答案的区间:如果一端的表达式为正、另一端为负,连续变化的表达式会在中间经过零。程序使用数值求根完成这一步。它每次接收一个参数条件,返回两项物理性质,因此能够充当本节的虚拟实验设备。
这种把混合与弹性联系起来的思路,承接了Flory与Rehner关于交联网络溶胀的统计力学研究。真实生物凝胶的结构则可能更加丰富。例如海藻酸盐具有带电基团,其含水状态会受到离子环境与交联方式影响;明胶来源、化学改性和网络缺陷也会改变材料响应。实际研究可以从简单模型出发,再通过测量判断哪些附加机制需要纳入。
Sun等在2012年报道的海藻酸盐—聚丙烯酰胺凝胶展示了结构设计的另一条思路:将离子交联网络与共价网络结合,使承载和能量耗散由不同结构共同参与。材料的抗裂与大变形表现,需要沿这些结构机制来理解。这段研究史提醒我们,当目标从“小形变时有多硬”扩展到“拉伸时怎样消耗能量、裂纹怎样推进”时,模型和测量也要随问题一起扩展。
回到当前两项目标,完整物理方程已经写出,最直接的办法就是反过来求参数。先由目标Q得到φ,再用模量公式求νe,最后把它们代回平衡式求χ。每一步都只是在使用已有关系,研究者应当先完成这份计算。它能给出一个清楚的参照:在这个已知模型里,什么样的条件可以精确达到目标。
代入Q=30、G=12000 Pa后,Q的三分之一次方约为3.107,RT约为2477.71 J/mol,所以νe约为12000×3.107/2477.71,也就是15.0489 mol/m³。接着代入溶胀方程,得到χ约为0.4370。两项参数都落在本例允许搜索的范围内:νe为2到60 mol/m³,χ为0.2到0.55。把结果重新输入正向模型,会回到Q=30与G=12 kPa。
改变目标,查看需要怎样的网络参数
浅绿色带表示8≤G≤16 kPa,并以Q≥20为另一项可行条件。较深矩形表示固定研究目标周围的范围:Q为25到36,G为10到14.4 kPa。移动点表示当前滑块目标,反求参数按本节物理模型实时计算。
交互图可以帮助我们理解两种目标之间的联系。保持G不变而提高Q时,网络含水更多,但为了维持指定的剪切响应,所需干参考有效链密度也随Q的三分之一次方增加。与之相配的χ由溶胀平衡重新确定。滑块同时显示这些变化,比单独记忆几个公式更容易看出:一个设计目标通常会牵动多个参数,最终必须一起检查。
既然能够直接反求,AI为什么还要参与?在这个计算例子里,物理反求已经解决了理想模型的参数选择,后面会保留它的结果。AI实验练习处理另一种信息条件:每次只获得选定条件的带噪读数,通过这些读数逐渐寻找目标。到了实际生物凝胶中,我们往往能够操作浓度、改性程度和制备条件,却尚未掌握它们到有效参数或最终性质的完整关系;代理模型和逐次实验就可以用于学习这段关系。
因此,“需要νe=15.0489 mol/m³”还要接上一条实验路径,才能变成可制备的条件。研究者可以测量一组已知配方的平衡溶胀和力学响应,结合适当模型估计有效网络参数,再拟合配方到参数的对应关系。也可以直接学习配方到Q与G的关系,保留物理量作为辅助解释。无论采用哪条路径,配方记录和性质测量都是连接计算与材料的关键数据。
03让模型生成有方向的候选
可以把设计搜索想成在一张尚未画完的地图上寻找合用的地点。横向和纵向分别表示两个可调条件,地图上的每一个位置都对应一对性质。已有测量帮助我们填上一部分信息,代理模型估计其他位置的表现,候选生成器则决定下一批重点查看哪里。三者各有一份工作:数据提供观察,模型给出预测,生成器安排要比较的条件。
为了让比较有统一尺度,先定义一个目标距离L。分别计算Q与30的比值、G与12 kPa的比值,取自然对数,再除以ln1.2。两个归一化偏差分别平方并相加,就得到L。平方使偏高与偏低都会产生正的距离,两个性质在本次目标中的相对重要程度也由这个归一化规则明确下来。
例如Q=36而G仍为12 kPa时,第一项的对数比值为ln1.2,除以ln1.2后等于1,第二项等于0,因此L=1。若G也达到14.4 kPa,两个归一化偏差都是1,L=2。目标中心的两个偏差都是0,L也为0。这样的手算让我们知道损失函数怎样评价一个条件,而不只是把它当成程序里一个越小越好的数字。
接下来,把距离转成0到1之间的效用U。在可行范围内使用exp(−L/2),目标中心的U为1,L=1时U约为0.607,L=2时约为0.368;一旦条件超出较宽的可行范围,U就记为0。有界效用便于比较不同候选,也能把目标与条件限制写在同一个评价规则里。最后仍单独记录是否落入目标框,因为相同效用可以由不同方向的偏差组成。
AI看到的是已有条件的带噪观察。Q和G分别转成无量纲的对数目标,程序用两个高斯过程建立预测。对每个新条件,每个模型都给出一个均值和一个潜在标准差。均值表示当前估计的位置,标准差表示数据和所选模型下仍存在的分散程度。第十九节已经推导了这个更新过程,这里把它用于两种性质,并进一步计算设计价值。
下标j区分两种性质,上标m区分从模型中抽取的第几种可能结果。ξ是均值为0、标准差为1的正态随机数,乘以s以后,就具有模型给出的分散程度;再加上μ,便移到当前预测附近。我们对两个性质采用独立高斯过程,因此这个抽样步骤把两项潜在预测视为独立。物理方程中的Q与G仍然相互联系,新增测量会持续提供这种联系在各个输入位置上的信息。
完整代码使用平方指数核,固定幅度为1.5,两个输入方向的相关长度分别为0.6与0.35,两个性质的先验均值分别为3.5与2.5。这些设置在搜索开始前确定,延续《主动学习:用高斯过程选择下一次实验》的性质尺度与参数范围。拟合已有数据时,模型把读数噪声计入观测;比较新候选时,则抽取其潜在性质,也就是去掉下一次随机测量波动后的平均响应。可以把它想成挑选一把尺子要看长期测量表现,而不是挑出偶然读得偏高的那一次。这样,候选的得分对应材料条件本身的目标匹配程度,后面的重复确认再检查实际读数是否支持这个推荐。
选择下一次测量时,既要考虑候选可能靠近目标,也要考虑它还有多大改进空间。Jones、Schonlau与Welch在1998年的高效全局优化研究将代理预测与期望改进联系起来,用少量昂贵的函数评价推进搜索。原研究中的优化对象与本节不同,但其中一个容易理解的想法可以沿用:把“可能改善多少”与“这种改善有多大可能”一起考虑。
我们先用当前模型重新预测所有已测条件,找到这些预测均值对应的最大效用,记为Ubest。对一个新候选,从预测分布抽取许多对可能的Q与G,分别算出效用。若某次抽样的效用高于Ubest,就保留高出的部分;若没有超过,则把这次改进记为0。所有改进量的平均值,就是用抽样近似的期望改进。
做一个三次抽样的手算。假设已有最好效用为0.4,新条件的三种可能效用分别是0.2、0.6和0.9,那么改进量为0、0.2和0.5,平均约为0.233。一个预测均值不错、但结果几乎都在0.4以下的条件,可能得到更低的改进值;一个仍有分散、却可能接近目标的条件,也有机会被选中。规则如何利用不确定性,可以从这些具体数字看出来。
代码在每个候选上使用128个潜在性质样本:先生成64组标准正态数,再加入它们的相反数。对称抽样帮助抵消部分随机起伏,同一次决策的所有候选使用同一组随机数,使候选间的比较较为稳定。128是一次计算安排,增加它能改变近似精度,也会增加代理计算量;它并不增加实际材料测量的次数。
接着需要在二维参数域中寻找期望改进较大的位置。如果只固定一张很粗的网格,合用区域可能落在格点之间。这里采用一个逐步调整的候选分布:先生成一批条件,评估后保留较好的部分,再让下一批更集中地覆盖这些位置。这就是生成与评价相互配合的一种简单形式,读者可以直接检查分布如何变化。
Rubinstein在1999年讨论的交叉熵优化方法,把反复抽样和分布参数更新组织成搜索过程。其后由de Boer等撰写的教程进一步说明了精英样本与分布估计的联系。所谓精英样本,就是当前评价中排在前面的一部分候选。这个名称描述候选在某轮规则下的排名,后续仍要通过新测量检验它们的性质。
为了保证候选处在允许范围,程序先在无限实数空间生成二维向量t,再使用一个平滑映射,将每个分量压到0与1之间。t=0时,映射后的x=0.5;t为ln3时,x=0.75;t为−ln3时,x=0.25。这样,高斯分布可以在方便的坐标中更新,最后得到的x始终能对应到规定的材料参数范围。
x1控制有效链密度的对数变化,x2控制χ的线性变化。前者从0到1时,νe从2增加到60 mol/m³;后者从0到1时,χ从0.2增加到0.55。正态分布的均值m决定候选大致集中在哪里,协方差矩阵S决定云团在两个方向上有多宽、是否倾斜。倾斜意味着两个坐标在抽样时会一起变化,有助于沿狭长的有用区域提出条件。
每一代共有128个候选,其中96个来自当前高斯分布,另外32个在x空间均匀生成,继续查看其他区域。程序按期望改进排名,保留最好的26个,再在t空间估计它们的均值与协方差。这里协方差除以26,是拟合高斯分布时使用的最大似然估计;它与用于无偏估计总体方差、分母为样本数减一的统计问题有所区别。
更新时,新估计占70%,旧分布保留30%,让搜索方向逐步改变。协方差还加上0.08²乘以单位矩阵,为两个方向保留一定采样宽度。比如旧均值为0,精英均值为1,新均值就是0.7,而不是立即跳到1。这些具体安排让候选生成既能向高分区域靠近,又保留继续探索的空间;每代仍加入均匀候选,也是出于同一目的。
生成器连续运行五代,每代比较128个候选,所以一次真实选样前会完成640次代理候选评价。最终只选其中排名最高的一个条件交给虚拟实验设备。图中的候选云展示的是模型计算过的位置,实际测量点则另外标出。分清这两种数量,就能理解为什么代理模型有价值:它允许先在计算中比较很多可能,再把测量次数集中到少数条件。
04把推荐、测量和确认安排成一轮完整实验
一个选样方法是否有用,要看它从起点到终点怎样使用测量预算。本例给随机策略和AI策略相同的八个初始条件。初始位置使用拉丁超立方抽样:将每个坐标划成八个区间,各取一个位置,再打乱两个方向之间的配对。它让起点在每个坐标方向上都有覆盖,同时保留随机性,适合作为两种策略共同出发的一小批数据。
两种策略接下来都新增十六个条件,总共得到二十四轮搜索测量。随机策略在允许域内均匀选点,AI策略根据当前模型生成并评估候选。每次读数到达后,两种策略都重新拟合相同的代理模型,以相同方式形成最终推荐。这样,比较主要落在“在哪里收集数据”上,而不是让一方同时使用更复杂的最终预测器。
一次虚拟测量返回一对对数读数:ln Q和ln[G/(1 kPa)],分别加入标准差0.04与0.05的独立正态噪声。回到原始尺度,0.04个对数单位相当于乘以约1.041,0.05相当于乘以约1.051。它们规定了这台虚拟设备的波动水平。两种策略按测量序号使用相同的随机误差,帮助我们在配对比较中控制不相关的随机差异。
当几个候选的期望改进相同,代码优先选择两项潜在方差之和更大的位置;距离已有条件小于归一化坐标0.02的候选,则暂不用于新增搜索。这些规则在运行前就固定。搜索后期尤其需要看清平分处理:效用上限为1,已有条件接近目标时,一批有限抽样可能没有出现更高效用,多个候选的估计改进都会成为0。
本次十二轮AI实验共作出192次新增条件选择,其中85次所选候选的抽样改进值为0,随后由预先规定的不确定性规则区分候选。这个数字解释了程序在接近目标后仍然怎样行动。有限抽样没有看到改进,和物理上不存在任何更好条件,是两件不同的事。保留选择时的改进值、方差和候选记录,可以让研究者查明每一步决定来自哪条规则。
搜索结束后,最终模型对已经测过的二十四个条件重新评分,选出首选和备选。首选按预测均值对应的效用排名,效用相同时再比较目标距离;备选优先与首选保持至少0.03的归一化距离。两者都从已测条件中产生,使新增确认围绕已有材料证据展开。首选顺序在确认前固定,后面的评价也始终保留这一身份。
接下来,为首选与备选各增加三次新的配对读数,总共六轮确认。三次读数可以帮助我们观察推荐附近的测量起伏,也能发现搜索时恰巧出现的偏高或偏低观察。程序生成独立的新噪声,保留全部确认值,并按已固定的首选报告结果。如果要用确认数据再次更新模型和选择材料,那应记为后续研究阶段,并相应增加实验预算。
每种方法的一轮完整流程因此使用三十轮配对测量:二十四轮搜索加六轮确认,共六十个标量读数。实际凝胶研究中,溶胀与力学测试可能需要同一批次的不同匹配样品,甚至分别采用破坏性和非破坏性测试。记录成本时,应把“条件数”“独立制备样品数”和“仪器读数数”分列,而不是看到程序返回两个数,就默认实验中也只需要一份样品或一次操作。
我们重复十二轮完整流程,每轮使用不同的初始位置与噪声,并将相同种子下的两种策略成对比较。学习曲线在八、十二、十六、二十和二十四轮搜索测量后,记录已测条件中最好的物理效用。物理真值在这个可计算环境里可供评价,候选生成器则只接收已测观察和模型预测。图上的学习曲线由此能回答:给定相同搜索次数,究竟找到了多接近目标的条件。
最终评价还要看首选条件本身。我们记录它是否满足较宽可行范围、是否落入较紧目标框,以及目标距离有多大。学习曲线的“已测条件里最好值”与最终首选的值可能不同,因为模型需要从带噪数据中判断哪一个最好。这点差异很有实际意义:找到一个好样品之后,研究流程还需要能够识别并稳定地推荐它。
除了测量噪声,配方与网络参数也可能波动。为理解这种变化,我们对预先固定的第2000号实验首选条件增加一项情景计算:有效链密度承受对数标准差0.05的乘法扰动,χ承受标准差0.01的加法扰动,每种策略使用相同的一千组扰动。所有变化条件重新代入物理方程,查看Q与G怎样一起移动。
δν为0时,链密度保持原值;若它为0.05,链密度乘以e0.05,约增加5.1%。δχ直接加在χ上,因此它的标准差0.01是绝对变化量。这里给定的两种扰动相互独立,产生的Q与G却会因物理耦合形成倾斜的点云。图中的方向和宽度,帮助我们看见一个目标附近的参数变化会怎样传到性质上。
这项计算使用的是明确指定的变化情景。研究真实制备稳定性时,可以先用独立批次测量估计各参数或可操作配方的波动,再把相应分布接入同一个分析步骤。若浓度和交联程度在制备中会共同变化,扰动模型也应加入它们的相关性。这样得到的范围,才能对应研究中实际会遇到的批次差异。
05运行完整代码,再把它接到生物凝胶研究
下面的程序可以从头运行。它先定义物理设备、目标和代理模型,再执行十二轮配对实验,最后生成六幅图与完整结果文件。需要安装NumPy、SciPy和Matplotlib。读代码时,可以先找到三个相互连接的函数:physical负责从条件得到性质,generate_candidate负责根据已测数据提出下一条件,campaign负责完整记录一次搜索与确认。这样读,能先看清研究流程,再逐行理解数值实现。
程序中的真实物理标签和带噪观察值分开保存。physical_truth用于画学习曲线和最终评价,observations交给高斯过程;confirmation_log另外保存新增确认读数。初始条件、每一步选择、预测方差、候选分布更新和推荐编号也都保留在输出中。复现一轮研究时,这些记录能把“得到一个好结果”展开成“在哪些条件上得到什么观察,随后作出什么决定”。
"""Generate and verify gel parameter candidates with two property targets.
All measurements come from a stated physical virtual laboratory.
Run: python example.py; requires NumPy, SciPy and Matplotlib.
"""
from pathlib import Path
import json,os
os.environ.setdefault('OPENBLAS_NUM_THREADS','1');os.environ.setdefault('OMP_NUM_THREADS','1')
import numpy as np
from scipy.optimize import brentq
from scipy.linalg import cho_factor,cho_solve,solve_triangular
from scipy.special import expit,logit
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

OUT=Path('design_outputs');OUT.mkdir(exist_ok=True)
NOISE=np.array([.04,.05]);PRIOR=np.array([3.5,2.5]);LENGTH=np.array([.6,.35])
TARGET=np.log([30.,12.]);SCALE=np.log(1.2);SEEDS=list(range(2000,2012));BUDGETS=[8,12,16,20,24]
def physical(x):
    x=np.atleast_2d(x);nu=2*30**x[:,0];chi=.2+.35*x[:,1];p=[]
    for n,c in zip(nu,chi):
        def balance(v):return np.log1p(-v)+v+c*v*v+n*18e-6*(v**(1/3)-v/2)
        p.append(brentq(balance,1e-7,1-1e-10,xtol=1e-14))
    p=np.array(p);return np.column_stack([-np.log(p),np.log(nu*8.314462618*298*p**(1/3)/1000)])
def feasible(z):return (z[...,0]>=np.log(20))&(z[...,1]>=np.log(8))&(z[...,1]<=np.log(16))
def target_loss(z):return np.sum(((z-TARGET)/SCALE)**2,axis=-1)
def utility(z):return np.exp(-.5*target_loss(z))*feasible(z)
def target_hit(z):return np.all(abs(z-TARGET)<=SCALE,axis=-1)
def kernel(a,b):return 2.25*np.exp(-.5*np.sum(((a[:,None,:]-b[None,:,:])/LENGTH)**2,axis=2))
class GP:
    def __init__(self,x,y):
        self.x=x.copy();self.models=[]
        for j in range(2):
            factor=cho_factor(kernel(x,x)+(NOISE[j]**2+1e-10)*np.eye(len(x)),lower=True)
            self.models.append((factor,cho_solve(factor,y[:,j]-PRIOR[j])))
    def predict(self,q):
        cross=kernel(self.x,q);mean=[];variance=[]
        for j,(factor,alpha) in enumerate(self.models):
            v=solve_triangular(factor[0],cross,lower=True)
            mean.append(PRIOR[j]+cross.T@alpha);variance.append(np.maximum(0,2.25-np.sum(v*v,axis=0)))
        return np.array(mean).T,np.array(variance).T

def generate_candidate(model,x,seed,keep_cloud=False):
    rng=np.random.default_rng(seed);normal=rng.normal(size=(64,2));normal=np.vstack([normal,-normal])
    incumbent=float(np.max(utility(model.predict(x)[0])))
    location=np.zeros(2);covariance=np.eye(2)*4;best=None;cloud=[]
    for iteration in range(5):
        latent=np.vstack([rng.multivariate_normal(location,covariance,96),logit(rng.uniform(1e-6,1-1e-6,(32,2)))])
        candidates=expit(latent);mean,var=model.predict(candidates)
        draws=mean[:,None,:]+np.sqrt(var[:,None,:])*normal[None,:,:]
        acquisition=np.maximum(utility(draws)-incumbent,0).mean(axis=1)
        uncertainty=var.sum(axis=1)
        available=np.min(np.sum((candidates[:,None,:]-x[None,:,:])**2,axis=2),axis=1)>=.02**2
        acquisition[~available]=-np.inf
        order=np.lexsort((uncertainty,acquisition));valid=order[np.isfinite(acquisition[order])]
        assert len(valid)>=26,'Candidate population exhausted'
        chosen=int(valid[-1]);key=(float(acquisition[chosen]),float(uncertainty[chosen]))
        if best is None or key>best[0]:best=(key,candidates[chosen].copy())
        elite=latent[valid[-26:]];center=elite.mean(0);delta=elite-center
        location=.3*location+.7*center
        covariance=.3*covariance+.7*(delta.T@delta/len(elite))+.08**2*np.eye(2)
        item=dict(iteration=iteration+1,best_acquisition=best[0][0],logit_mean=location.tolist(),logit_cov=covariance.tolist())
        if keep_cloud:item.update(x=candidates.tolist(),acquisition=np.where(np.isfinite(acquisition),acquisition,-1).tolist(),elite_indices=valid[-26:].tolist())
        cloud.append(item)
    return best[1],dict(incumbent=incumbent,selected_acquisition=best[0][0],selected_variance=best[0][1],history=cloud)

def recommend(model,x):
    mean,var=model.predict(x);order=np.lexsort((-target_loss(mean),utility(mean)))[::-1]
    first=int(order[0]);second=next((int(i) for i in order[1:] if np.linalg.norm(x[i]-x[first])>=.03),int(order[1]))
    return [first,second],mean,var

def campaign(seed):
    rng=np.random.default_rng(seed)
    initial=np.column_stack([(rng.permutation(8)+rng.random(8))/8 for _ in range(2)])
    random_tail=rng.random((16,2));noise=np.random.default_rng(20000+seed).normal(size=(24,2))*NOISE
    confirm_noise=np.random.default_rng(30000+seed).normal(size=(2,3,2))*NOISE;runs={}
    for strategy in ['random','surrogate_ei_cem']:
        x=initial.copy();truth=physical(x);y=truth+noise[:8];curve=[];steps=[]
        for n in range(8,25):
            model=GP(x,y)
            if n in BUDGETS:curve.append(float(np.max(utility(truth))))
            if n==24:break
            if strategy=='random':new=random_tail[n-8];details=None
            else:new,details=generate_candidate(model,x,40000+seed*100+n,keep_cloud=(seed==SEEDS[0] and n==8))
            true_new=physical(new)[0];x=np.vstack([x,new]);truth=np.vstack([truth,true_new]);y=np.vstack([y,true_new+noise[n]])
            steps.append(dict(budget=n+1,x=new.tolist(),selection=details))
        ids,mean,var=recommend(model,x);confirm=truth[ids,None,:]+confirm_noise
        runs[strategy]=dict(x=x.tolist(),observations=y.tolist(),physical_truth=truth.tolist(),learning_best_utility=curve,steps=steps,
            recommendation_indices=ids,recommendation_predicted_log=mean[ids].tolist(),recommendation_variance=var[ids].tolist(),
            recommendation_true_log=truth[ids].tolist(),confirmation_log=confirm.tolist(),
            final_target_loss=float(target_loss(truth[ids[0]])),final_utility=float(utility(truth[ids[0]])),
            final_feasible=bool(feasible(truth[ids[0]])),final_target_hit=bool(target_hit(truth[ids[0]])))
        if seed==SEEDS[0]:
            perturb=np.random.default_rng(50000+seed).normal(size=(1000,2))*[.05,.01]
            base=x[ids[0]];new=base+perturb/[np.log(30),.35];z=physical(new)
            runs[strategy]['perturbation']=dict(x=new.tolist(),true_log=z.tolist(),feasible_fraction=float(np.mean(feasible(z))),target_fraction=float(np.mean(target_hit(z))))
    return dict(seed=seed,initial=initial.tolist(),runs=runs)

campaigns=[]
for seed in SEEDS:
    campaigns.append(campaign(seed));print('Completed design comparison',seed,flush=True)
summary={}
for name in ['random','surrogate_ei_cem']:
    rows=[c['runs'][name] for c in campaigns];curves=np.array([r['learning_best_utility'] for r in rows])
    summary[name]=dict(learning_mean=curves.mean(0).tolist(),learning_min=curves.min(0).tolist(),learning_max=curves.max(0).tolist(),
        recommended_loss_each=[r['final_target_loss'] for r in rows],recommended_loss_median=float(np.median([r['final_target_loss'] for r in rows])),
        recommended_utility_mean=float(np.mean([r['final_utility'] for r in rows])),feasible_count=sum(r['final_feasible'] for r in rows),target_hit_count=sum(r['final_target_hit'] for r in rows))
Q=30.;G=12000.;phi=1/Q;nu=G*Q**(1/3)/(8.314462618*298)
chi=-(np.log1p(-phi)+phi+nu*18e-6*(phi**(1/3)-phi/2))/phi**2
inverse_x=np.array([np.log(nu/2)/np.log(30),(chi-.2)/.35]);inverse_truth=physical(inverse_x)[0]
axis=np.linspace(0,1,41);grid=np.array([(a,b) for b in axis for a in axis]);grid_truth=physical(grid)
results=dict(task='Effective gel parameters in an explicit virtual model; biological formulation translation requires measured mapping',
    seeds=SEEDS,budgets=BUDGETS,targets=dict(Q=30,G_kPa=12,minimum_Q=20,G_range_kPa=[8,16],target_factor=1.2),
    model=dict(prior=PRIOR.tolist(),noise_sd=NOISE.tolist(),lengthscales=LENGTH.tolist(),amplitude=1.5,jitter=1e-10),
    analytic_inverse=dict(nu=nu,chi=chi,x=inverse_x.tolist(),predicted_physical_log=inverse_truth.tolist(),target_loss=float(target_loss(inverse_truth))),
    grid=dict(x=grid.tolist(),physical_log=grid_truth.tolist()),cost=dict(search_rounds=24,confirmation_rounds=6,total_paired_rounds=30,scalar_readouts=60,surrogate_candidates_per_query=640,latent_draws_per_candidate=128),
    summary=summary,campaigns=campaigns)
(OUT/'results.json').write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
(OUT/'samples.json').write_text(json.dumps(dict(campaigns=campaigns,grid=results['grid']),ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
for name,row in summary.items():
    print(f"{name}: target hits {row['target_hit_count']}/12; feasible {row['feasible_count']}/12; median target loss {row['recommended_loss_median']:.6f}")
print(f'Exact inverse: nu={nu:.6f} mol/m3, chi={chi:.6f}; loss={results["analytic_inverse"]["target_loss"]:.3g}')
print('Per campaign: 24 search + 6 confirmation rounds = 60 scalar readouts')


plt.rcParams.update({'font.family':'DejaVu Sans','font.size':10,'axes.spines.top':False,'axes.spines.right':False,'axes.labelcolor':'#30453f','text.color':'#243d35','axes.edgecolor':'#bac7c0','xtick.color':'#53675e','ytick.color':'#53675e','svg.hashsalt':'L20-design','figure.facecolor':'#fffef9','axes.facecolor':'#fffef9'})
NAMES=['random','surrogate_ei_cem'];LABELS=['Random','AI-guided'];COLORS=['#b18b61','#267b69'];first=campaigns[0]['runs']
def decorate(ax,title,x='',y=''):
    ax.set_title(title,loc='left',fontweight='bold',pad=15);ax.set_xlabel(x);ax.set_ylabel(y);ax.grid(color='#e5eae1',lw=.6);ax.set_axisbelow(True)
def target_region(ax):
    from matplotlib.patches import Rectangle
    ax.axhspan(8,16,color='#e9eee1',alpha=.6);ax.axvline(20,color='#a6b4a1',ls=':',lw=1)
    ax.add_patch(Rectangle((25,10),11,4.4,facecolor='#c0d9c8',edgecolor='#559574',alpha=.55))
    ax.scatter([30],[12],marker='*',s=170,c='#25433a',edgecolor='white',lw=.8,zorder=7,label='Exact inverse')
def draw(i,fig,spec):
    if i==4:
        sub=spec.subgridspec(2,1,hspace=.04)
        for j,(unit,target) in enumerate([('Q / target Q',30),('G / target G',12)]):
            ax=fig.add_subplot(sub[j]);ax.axhspan(1/1.2,1.2,color='#e4eddf');ax.axhline(1,c='#899b87',ls='--',lw=1)
            for k,(name,c) in enumerate(zip(NAMES,COLORS)):
                z=np.exp(np.array(first[name]['confirmation_log']))[:,:,j]/target;actual=np.exp(np.array(first[name]['recommendation_true_log']))[:,j]/target
                for r in range(2):
                    x=k*3+r;ax.scatter(x+np.array([-.14,0,.14]),z[r],c=c,s=35,zorder=4);ax.plot([x-.2,x+.2],[actual[r]]*2,c='#253f35',lw=2)
            ax.set_xticks([0,1,3,4],['Random #1','#2','AI #1','#2']);ax.set_xlim(-.6,4.6)
            decorate(ax,'E  Fresh readings after recommendations are locked' if j==0 else '',y=unit)
            ax.text(.02,.92,'3 fresh paired readings per condition · seed 2000' if j==0 else 'Black marks: model truth; pale band: target range',transform=ax.transAxes,va='top',fontsize=8);ax.set_ylim(.65,1.75)
        return
    ax=fig.add_subplot(spec)
    if i==0:
        im=ax.imshow(utility(grid_truth).reshape(41,41),origin='lower',extent=[0,1,0,1],aspect='auto',cmap='YlGnBu',vmin=0,vmax=1)
        ax.contour(axis,axis,feasible(grid_truth).reshape(41,41).astype(float),levels=[.5],colors=['#a6b4a1'],linewidths=1)
        for name,label,c in zip(NAMES,LABELS,COLORS):
            xy=np.array(first[name]['x'])[8:];ax.scatter(xy[:,0],xy[:,1],s=26,c=c,edgecolor='white',lw=.6,label=label)
        xy=np.array(campaigns[0]['initial']);ax.scatter(*xy.T,marker='+',c='#47667a',s=65,label='8 shared starts');ax.scatter(*inverse_x,marker='*',s=170,c='#e2b35e',edgecolor='white',lw=.8,label='Exact inverse',zorder=5)
        decorate(ax,'A  A physical target inside the parameter domain','Normalized log strand density x₁','Normalized solvent parameter x₂');ax.grid(False);ax.legend(frameon=True,fontsize=8,loc='lower left');fig.colorbar(im,ax=ax,label='True constrained utility',shrink=.8)
    elif i==1:
        clouds=first[NAMES[1]]['steps'][0]['selection']['history']
        for row,c,label,alpha in [(clouds[0],'#b8b5a2','Generation 1',.45),(clouds[-1],'#267b69','Generation 5',.65)]:
            xy=np.array(row['x']);ax.scatter(*xy.T,s=17,c=c,alpha=alpha,label=label)
        row=clouds[-1];xy=np.array(row['x'])[row['elite_indices']];ax.scatter(*xy.T,s=38,facecolors='none',edgecolors='#b47943',lw=1,label='Final elite set')
        xy=first[NAMES[1]]['steps'][0]['x'];ax.scatter(*xy,s=150,marker='*',c='#243f36',zorder=5,label='One selected query');ax.set(xlim=(0,1),ylim=(0,1))
        decorate(ax,'B  Generate many proposals, measure one condition','Normalized log strand density x₁','Normalized solvent parameter x₂');ax.legend(fontsize=8,frameon=False,loc='lower left');ax.text(.03,.95,'First decision · 5 × 128 surrogate proposals',transform=ax.transAxes,va='top',fontsize=9)
    elif i==2:
        for name,label,c in zip(NAMES,LABELS,COLORS):
            r=summary[name];ax.plot(BUDGETS,r['learning_mean'],'o-',c=c,label=label,ms=5);ax.fill_between(BUDGETS,r['learning_min'],r['learning_max'],color=c,alpha=.12)
        ax.axhline(1,c='#647c6b',ls=':',label='Exact physical inverse');ax.set(ylim=(-.03,1.12),xticks=BUDGETS)
        decorate(ax,'C  Best physical utility among queried conditions','Search measurement rounds','Utility (higher is better)');ax.legend(frameon=False,fontsize=9,loc='lower right');ax.text(.03,.52,'Mean and full range of 12 paired campaigns\nTruth used for auditing, never for acquisition',transform=ax.transAxes,fontsize=9)
    elif i==3:
        target_region(ax)
        for name,label,c in zip(NAMES,LABELS,COLORS):
            z=np.exp([r['runs'][name]['recommendation_true_log'][0] for r in campaigns]);ax.scatter(*z.T,s=43,c=c,alpha=.8,edgecolors='white',lw=.7,label=f'{label}: {summary[name]["target_hit_count"]}/12 in target box',zorder=4)
        ax.set(xlim=(18,55),ylim=(6.5,18));decorate(ax,'D  Keep all 24 final recommendations','Volume swelling ratio Q','Swollen-state shear modulus G (kPa)');ax.legend(frameon=False,fontsize=8,loc='upper right');ax.text(.03,.04,'All recommendations meet Q ≥ 20 and 8 ≤ G ≤ 16 kPa',transform=ax.transAxes,fontsize=8)
    else:
        target_region(ax)
        for name,label,c in zip(NAMES,LABELS,COLORS):
            r=first[name]['perturbation'];z=np.exp(r['true_log']);ax.scatter(*z.T,s=7,c=c,alpha=.18,label=f'{label}: {r["target_fraction"]:.1%} in target box')
        ax.set(xlim=(20,60),ylim=(6.5,22));decorate(ax,'F  A specified parameter-variation scenario','Volume swelling ratio Q','Swollen-state shear modulus G (kPa)');ax.legend(frameon=False,fontsize=8,loc='upper right');ax.text(.03,.04,'Seed 2000 · 1,000 perturbations per recommendation\nSD(log ν) = 0.05; SD(χ) = 0.01',transform=ax.transAxes,fontsize=9)
keys=['domain','generation','learning','recommendations','confirmation','variation']
for i,key in enumerate(keys):
    fig=plt.figure(figsize=(8.6,5.5),layout='constrained');draw(i,fig,fig.add_gridspec(1,1)[0]);fig.savefig(OUT/f'{key}.svg',metadata={'Date':None});plt.close(fig)
fig=plt.figure(figsize=(18,16.5),layout='constrained');grid_spec=fig.add_gridspec(3,2,hspace=.12,wspace=.1)
for i in range(6):draw(i,fig,grid_spec[i//2,i%2])
fig.savefig(OUT/'gel_design.svg',metadata={'Date':None});fig.savefig(OUT/'gel_design.png',dpi=160,metadata={'Software':'L20 reproducible example'});plt.close(fig)
print('Full proposals, confirmation data and six figures: design_outputs/')
本次实际运行输出
Completed design comparison 2000
Completed design comparison 2001
Completed design comparison 2002
Completed design comparison 2003
Completed design comparison 2004
Completed design comparison 2005
Completed design comparison 2006
Completed design comparison 2007
Completed design comparison 2008
Completed design comparison 2009
Completed design comparison 2010
Completed design comparison 2011
random: target hits 2/12; feasible 12/12; median target loss 2.506299
surrogate_ei_cem: target hits 12/12; feasible 12/12; median target loss 0.047552
Exact inverse: nu=15.048893 mol/m3, chi=0.437000; loss=1.16e-26
Per campaign: 24 search + 6 confirmation rounds = 60 scalar readouts
Full proposals, confirmation data and six figures: design_outputs/
一次运行 · 六幅结果图
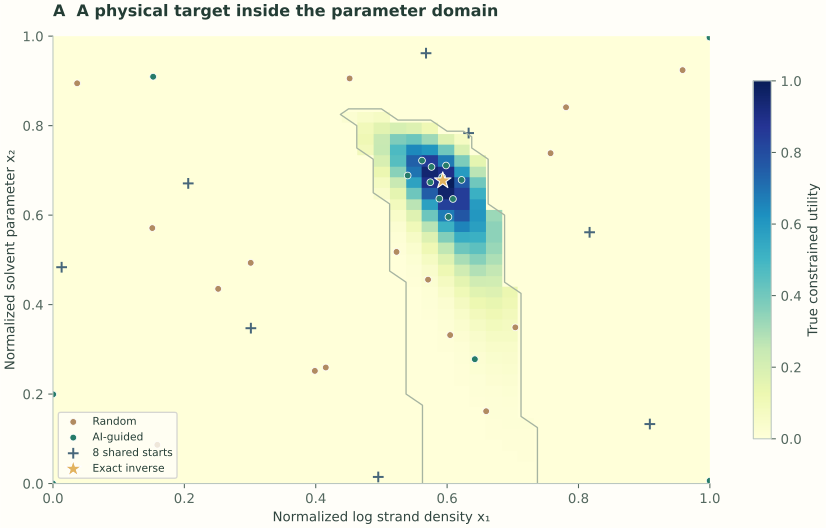
A|明确定义的凝胶模型及目标效用;星号为直接物理反求,点为固定第2000号实验的测量条件。
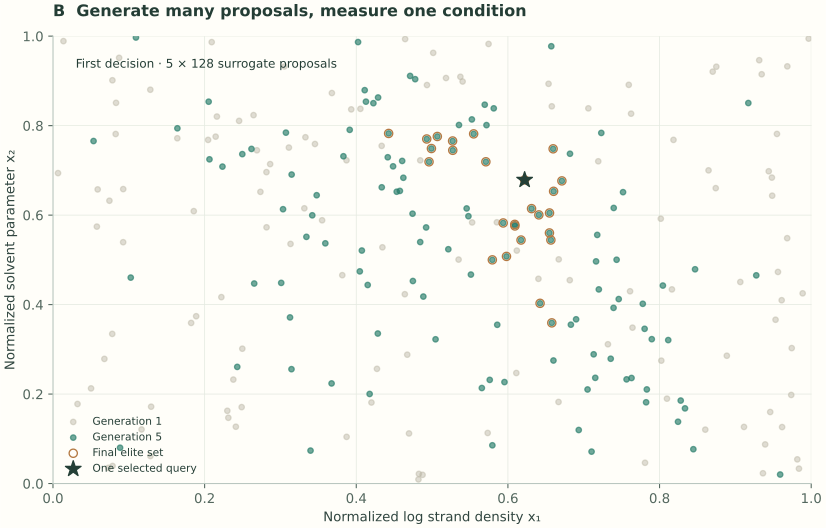
B|第一次AI决策的第1代与第5代候选分布。每次比较640个代理模型候选,只新增1次物理测量。
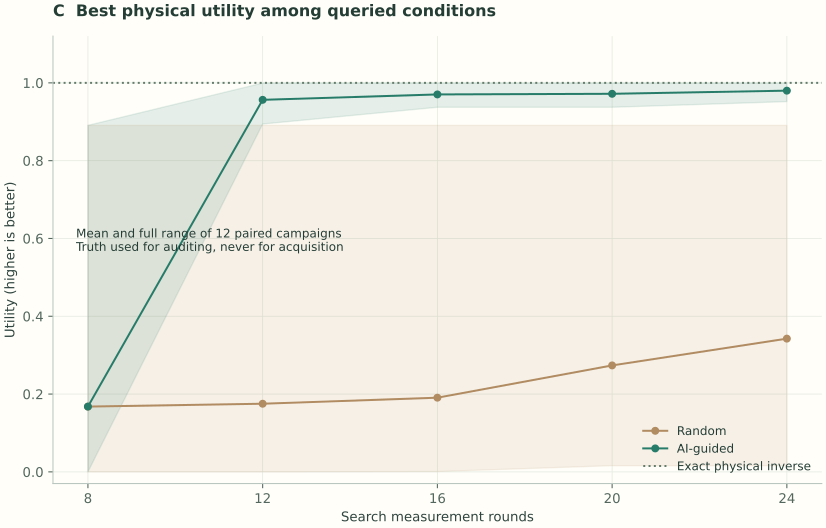
C|12轮配对实验中,已测条件的最佳物理效用;曲线为平均,阴影为全部范围。真值只用于事后评价。
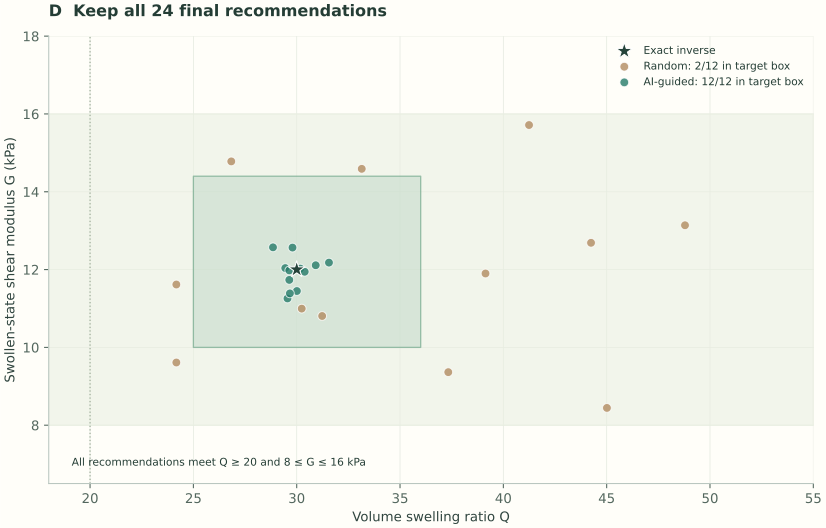
D|保留两种方法全部12轮最终首选条件,绿色矩形为目标范围;较宽浅色带与Q≥20共同定义可行条件。
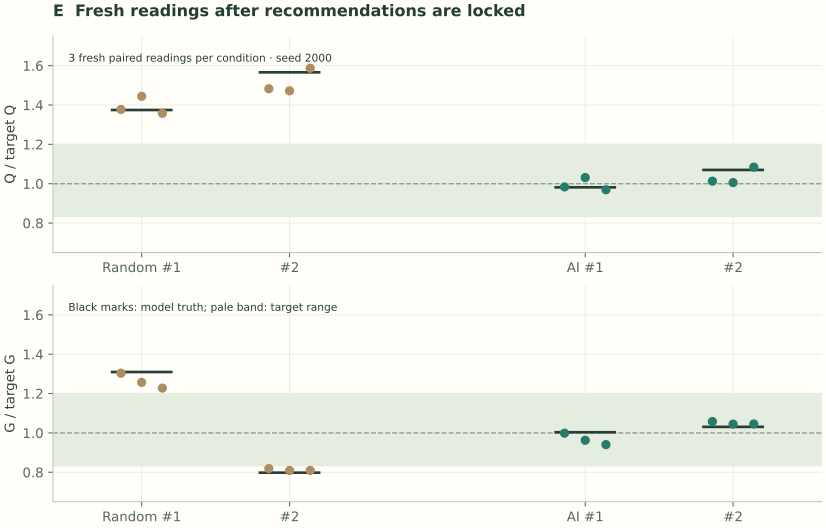
E|固定展示第2000号实验,每种方法的首选和备选各有3次新增配对读数,推荐顺序在确认前固定。
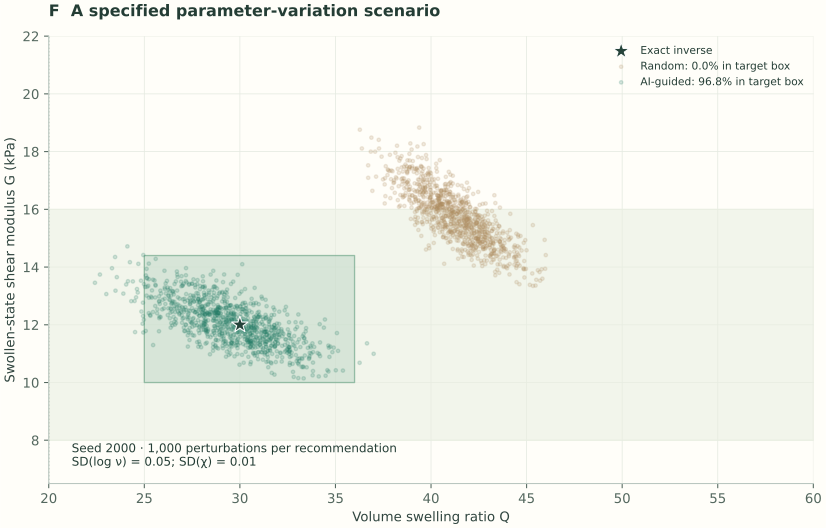
F|给首选条件施加1000次规定的参数扰动,查看目标范围内的比例;这是一项参数变化情景计算。
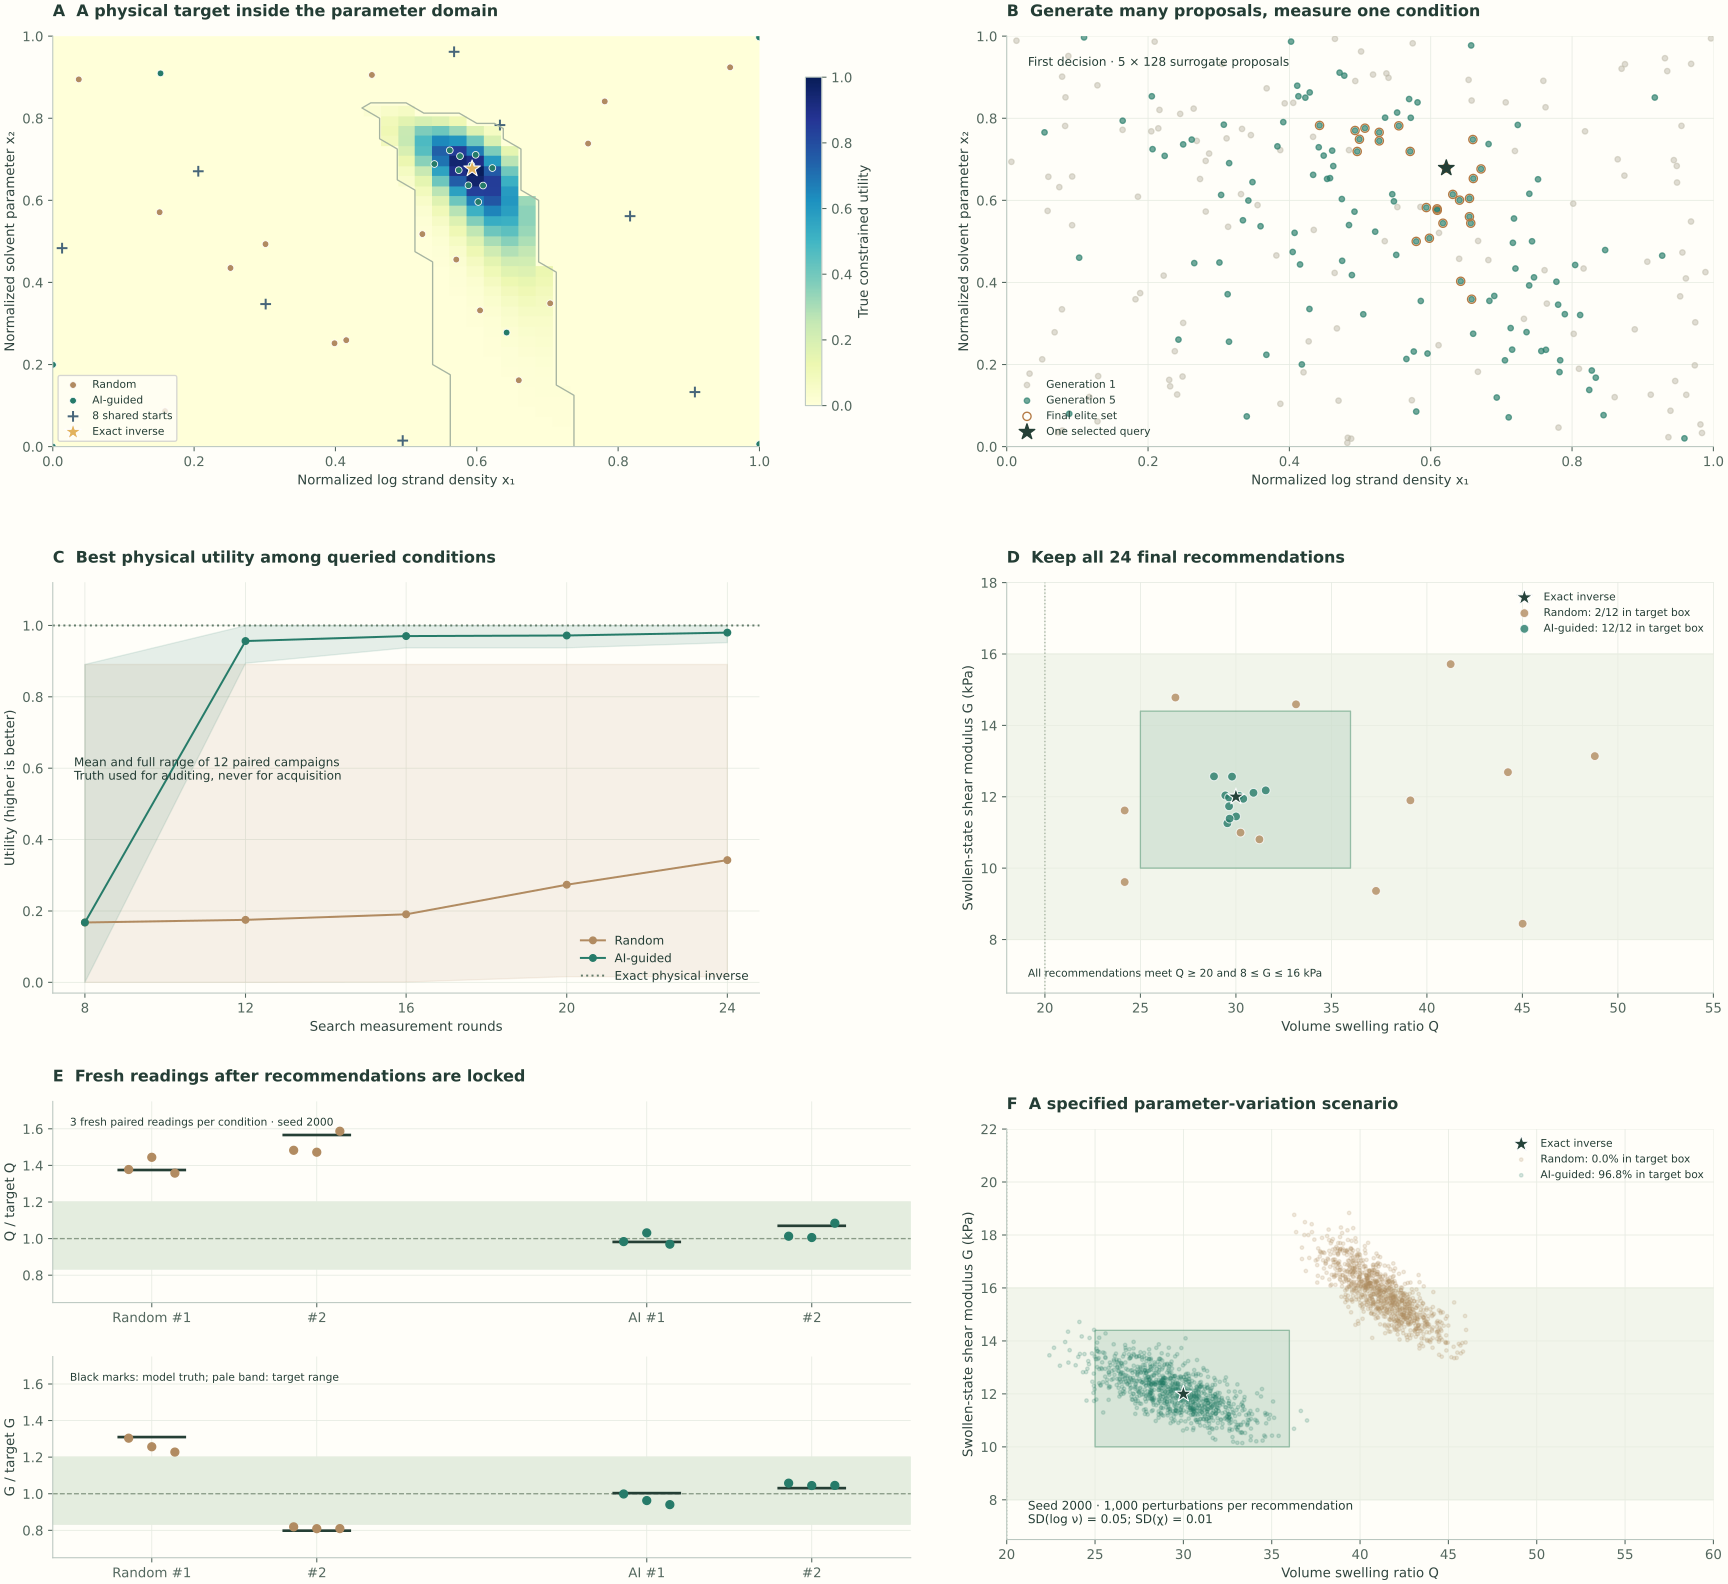
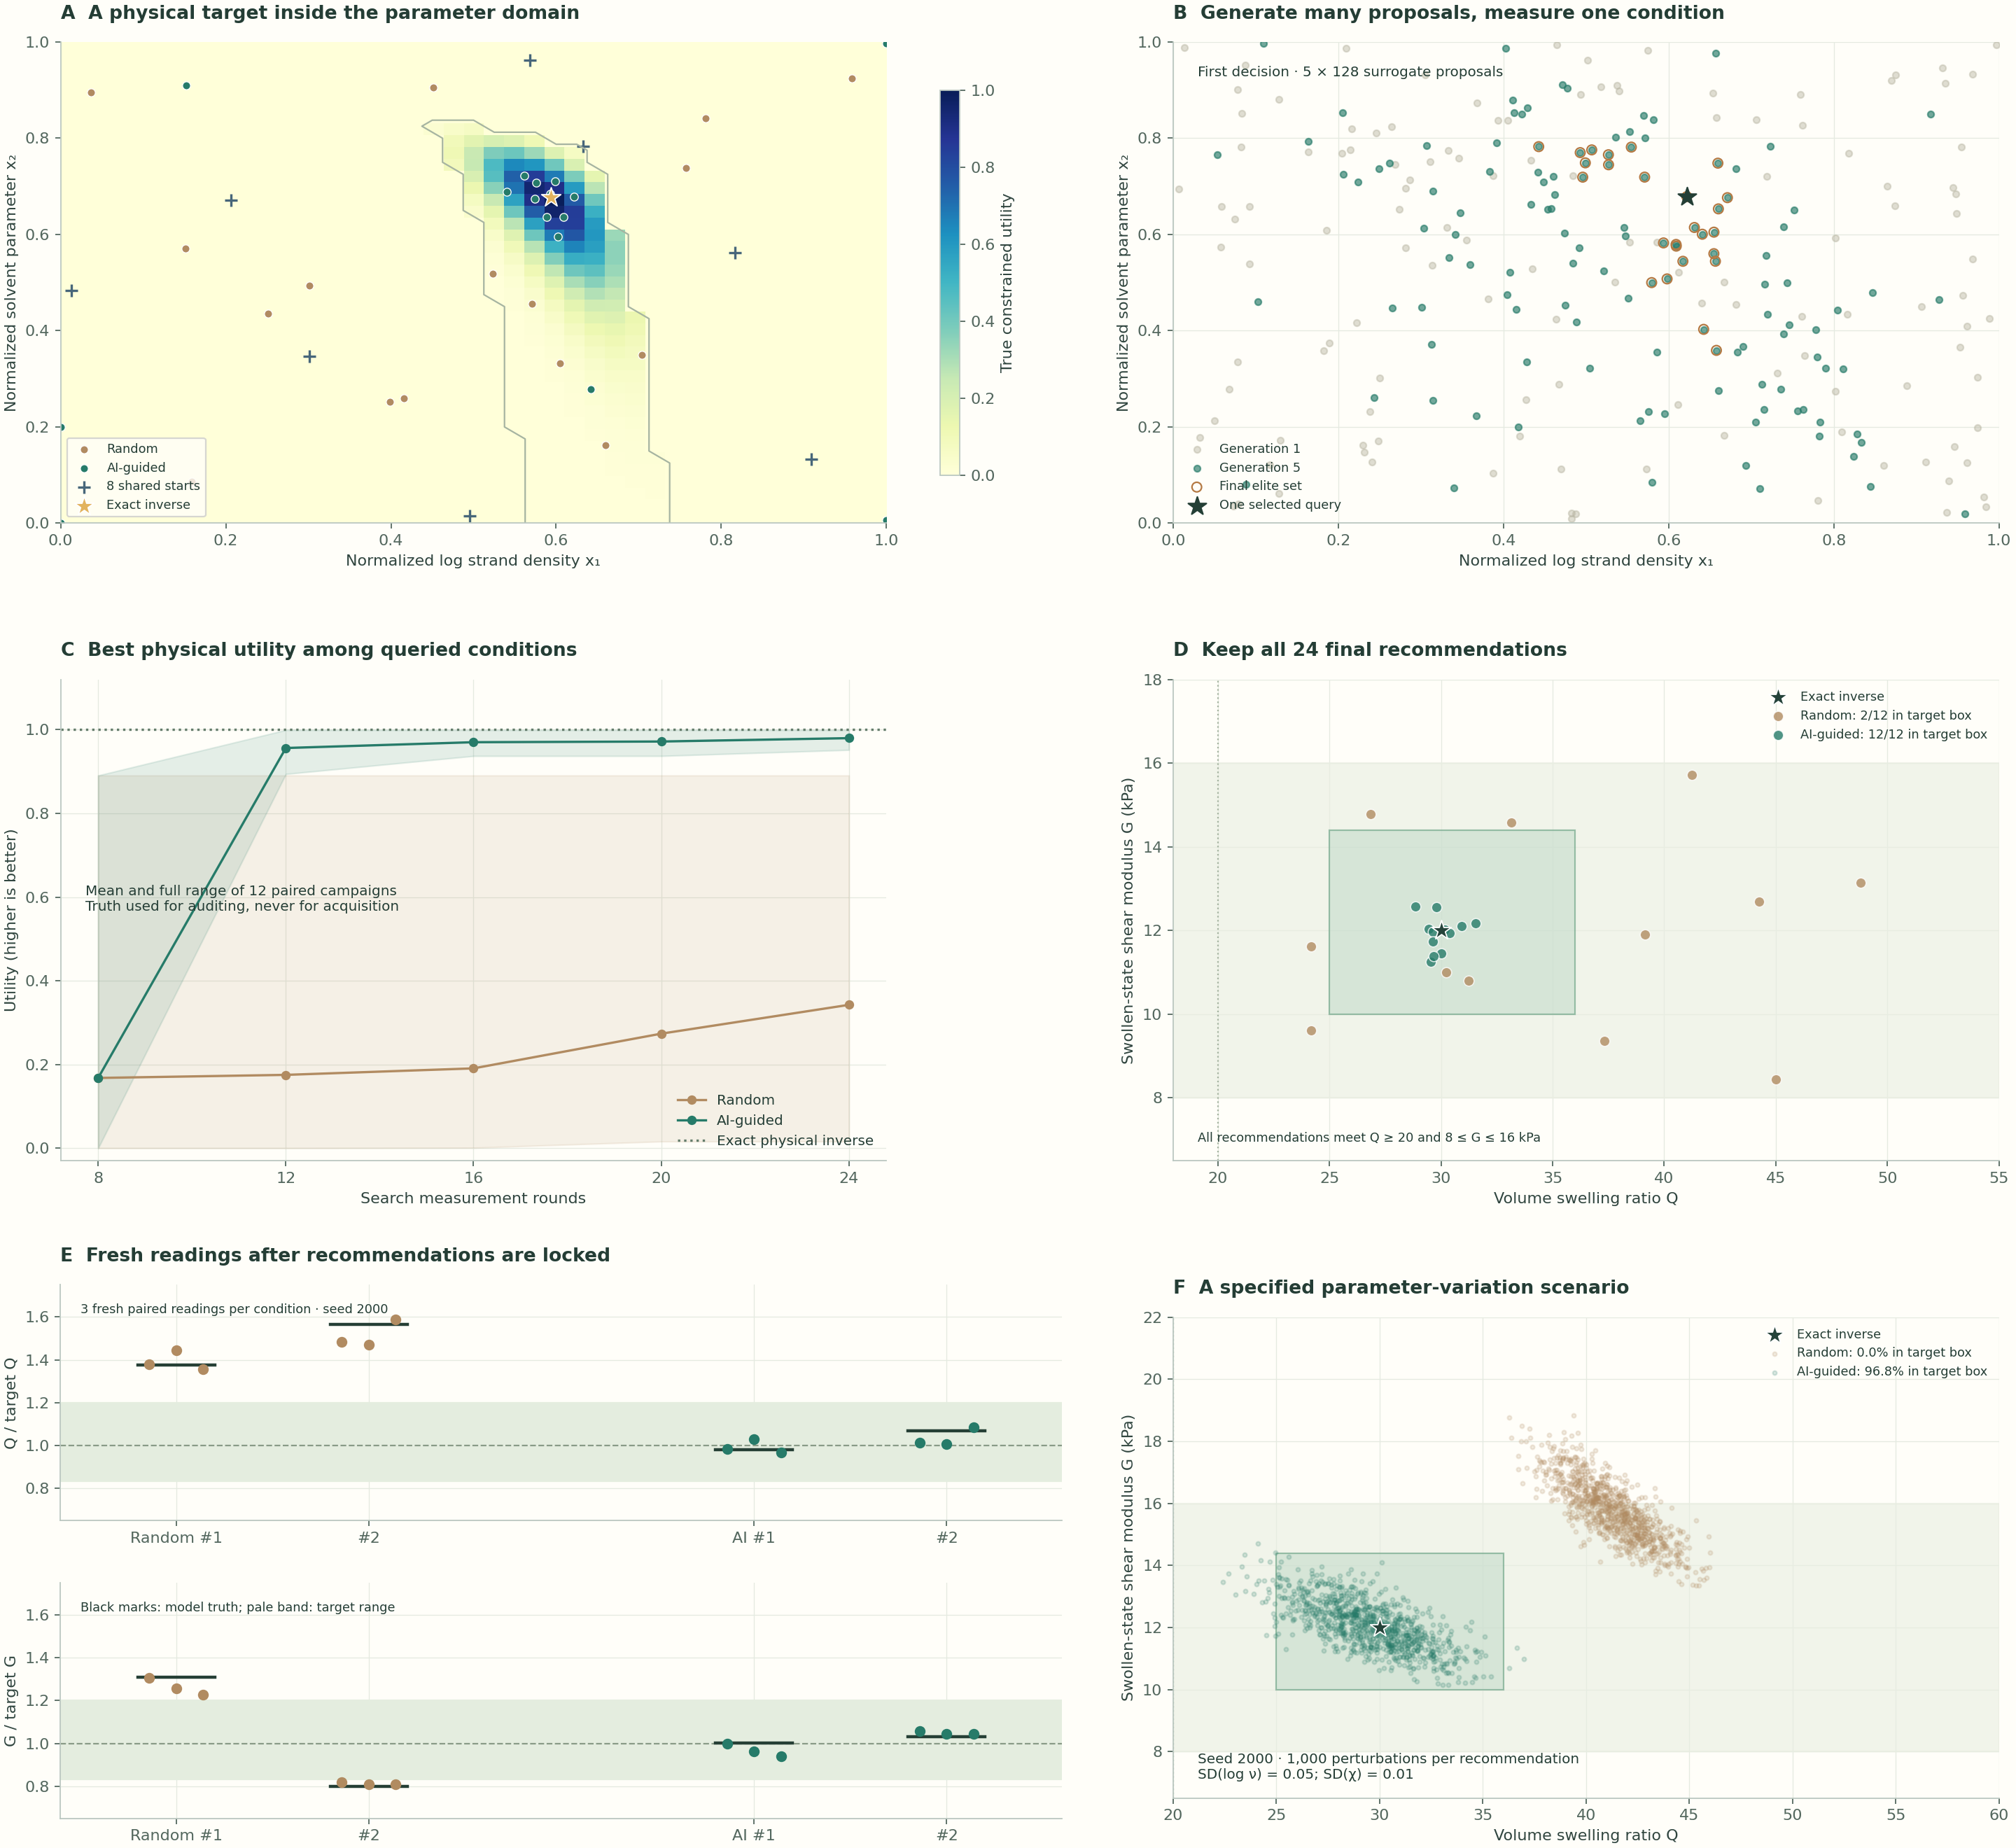
先看目标参数域和候选生成图。直接反求的星号位于一小片高效用区域中,AI的测量点逐渐向附近聚集。第一次决策的候选图则保留了生成分布调整前后的样子:后期候选在有用区域更集中,同时还能看到均匀候选散布在其他位置。图里的这种集中来自代理评价与精英更新,最终只会转成一次新增测量,然后再用得到的读数修正模型。
十二轮实验全部保留后,AI策略的最终首选有12轮落入较紧目标框,随机策略有2轮;两种策略的全部首选都满足较宽可行条件。首选目标距离L的中位数分别约为0.04755和2.50630,平均物理效用分别约为0.97498和0.34224。这里同时报告可行性、目标命中与距离,让“找到可用条件”和“找到接近指定中心的条件”各自有清楚的数字。
学习曲线还提供了过程信息。两种策略在八个共享起点上的平均最佳效用相同,约为0.16777。到二十四轮搜索测量时,AI策略为0.97989,随机策略为0.34248。阴影展示十二轮中的完整范围,因此能够看见不同起点与噪声带来的变化。学习曲线略高于最终首选的平均效用,也符合前面所说的区别:已测样品中最好的条件,有时需要进一步数据才能被模型准确识别。
完整物理反求的目标距离接近数值精度下的零,效用为1。这个结果放在同一组图里,告诉我们已有科学关系能发挥多直接的作用。本次AI策略相对于随机选样更快找到目标附近;已知方程的直接反求则提供精确解。实际研究可以据此分配工作:先利用已有理论缩小问题,再将数据收集和模型学习用于尚未建立完整关系的部分。
确认图固定展示第2000号实验,首选和备选各有三次新增读数。每个点对应一次新观察,短横线对应该条件的物理真值。AI首选的观察集中在目标附近,随机首选的Q与G则分别偏离中心。保留备选能让研究者同时查看相邻方案的特点,但图中不会在看到确认结果后悄悄交换“首选”的身份。比较方法时,推荐形成的时间点与后续读取的数据同样需要记录。
同一轮的参数扰动图进一步显示,AI首选周围的一千组规定变化中,96.8%落入目标框,100%满足较宽可行条件;随机首选对应的比例为0和60.1%。这组比例回答的是前面写明的参数变化情景。若希望将它用于判断真实配方的制备稳定性,下一步应收集独立批次的波动数据,再用实际分布重新计算,尤其检查网络参数之间是否存在共同变化。
现在把这个流程接到一种具体材料上。以GelMA为例,可以把研究对象写成具有明确来源、改性程度和批次记录的甲基丙烯酰化明胶。Nichol等关于GelMA的研究已展示材料浓度、改性与力学、溶胀和细胞观察之间的联系。接下来的一项研究可以据此选择可操作因素,先在同一种基础材料内建立数据,再逐渐增加结构差异。
第一步是准备一份条件表。每行对应一个明确制备条件,记录材料批次、聚合物浓度、改性程度的测定方法、成胶处理以及所用介质。温度、平衡判定、几何尺寸和测试程序进入测量记录。若某些因素在这一阶段固定,也应给出固定值。这样,当模型把两个样品判断为“很近”时,这个距离对应的是清楚的实验条件,而非几个来历不同的数字。
第二步是为同一条件制备可追踪的匹配样品,分别完成溶胀和力学测量。称量得到的是质量溶胀指标时,先保留湿质量、干质量和所用定义;若要换算成体积比,再记录密度与体积可加近似。力学测量应说明使用剪切、压缩还是其他加载方式,动态测量还要记录频率和应变幅度。原始观察保留下来,后续便能重新计算标签或检查异常,而不必只依赖一列已经处理过的最终数字。
第三步是选择模型的输入和输出。对固定GelMA体系、少量连续配方变量,可以先比较均值预测、线性或简单非线性模型,再使用高斯过程处理小样本预测与实验选择。如果主要困难在于配方到有效网络参数的对应关系,就把表征得到的参数作为中间层;若这些参数暂时难以可靠估计,也可以先学习配方到可测性质的关系,再用科学理解检查模型趋势。
当研究扩展到不同侧链、交联分子或生物大分子结构时,第十八节的图神经网络就有了更具体的入口:把分子连接、键或连接类型以及相关结构特征送入编码器,再与浓度、介质和测试条件合并,预测材料响应。训练与评价要按研究问题分组,例如留出完整分子家族或独立批次,检查模型能否迁移到新对象。对于结构始终相同、只有两个配方数值变化的任务,先把简单模型和实验设计做扎实,通常更容易查明数据在教会模型什么。
第四步是把模型用于新的材料选择。先固定目标、允许的制备范围、选样规则与总预算,再提出少量新条件并测量。将每轮新增读数接回数据表,更新模型,保留每次推荐的依据。若某些配方已经能通过物理关系直接排除或确定,就把这些判断前置,减少没有必要的搜索。实验成本较高时,还可以为不同测试设置不同费用,比较在相同时间或材料消耗下获得的结果。
第五步进入生物评价。对于希望研究细胞微环境的凝胶,需要选定细胞模型、培养条件、观察时间和具体终点,例如存活情况、形态、黏附或某种谱系相关标志。材料性质与这些观察通过样品和批次相连。把网络刚度改变的同时,配体密度、降解或传质是否也发生变化,是值得安排对照和补充测量的问题。每增加一个生物目标,研究就多了一条需要观察和解释的关系。
如果几个目标之间存在明显冲突,可以把结果画成性质平面,保留那些无法在所有指标上同时被另一方案超过的候选。这就是多目标设计中常说的帕累托思路。它允许研究者结合用途选择折中条件,而不是过早把所有指标压成一个分数。本节为了完整演示一轮选择,预先固定了中心目标和效用;更复杂的研究可以在同样清楚的记录方式上扩展评价规则。
到这里,一轮研究应当留下几份相互对应的成果:明确的用途和目标、带测量定义的条件表、可复现的模型与选择过程、独立确认的候选,以及与材料状态对应的生物观察。它们能够支持下一次实验,也让其他研究者接着使用已有工作。AI参与的深度,体现在它是否帮助提出了可检验的问题、节省了有价值的测量,并让新的观察继续改善理解。
回望这二十节,最初的一条链已经连接到了构象、溶液、网络、蛋白质、核酸、糖链和材料测量;模型也从简单的数值关系走向序列、图结构和逐次实验选择。研究可以从其中任何一个具体问题继续展开:先认清对象与测量,再选取合适表示,建立比较基准,依据结果设计下一步。科学知识让我们知道该问什么,AI方法帮助我们从数据中学习并安排行动,新的实验则把两者继续接在一起。
资料与延伸阅读
- Engler A. J., Sen S., Sweeney H. L., Discher D. E.(2006),Matrix Elasticity Directs Stem Cell Lineage Specification,Cell 126:677–689。基质弹性与间充质干细胞响应的研究。
- Flory P. J., Rehner J.(1943),Statistical Mechanics of Cross-Linked Polymer Networks II. Swelling。网络混合与弹性的历史理论框架;本节采用正文明确给出的模型及参考状态。
- Sun J.-Y.等(2012),Highly stretchable and tough hydrogels,Nature 489:133–136。海藻酸盐与聚丙烯酰胺网络的结构及韧性研究。
- Jones D. R., Schonlau M., Welch W. J.(1998),Efficient Global Optimization of Expensive Black-Box Functions。代理模型与期望改进的原始研究。
- Rubinstein R. Y.(1999),The Cross-Entropy Method for Combinatorial and Continuous Optimization。通过调整采样分布进行优化。
- de Boer P.-T., Kroese D. P., Mannor S., Rubinstein R. Y.,A Tutorial on the Cross-Entropy Method,2003年9月2日稿。候选抽样、精英样本与分布更新的系统说明。
- Nichol J. W.等(2010),Cell-laden microengineered gelatin methacrylate hydrogels。连接GelMA组成、材料测量和细胞研究。
- Rasmussen C. E., Williams C. K. I.(2006),Gaussian Processes for Machine Learning,第2章。高斯过程回归的均值、协方差与带噪观察。