让模型参与下一次实验的选择
主动学习:用高斯过程选择下一次实验
调一碗面糊时,水多一点、面粉少一点,流动和成形的表现就会改变。研究生物凝胶也会遇到类似选择:改变浓度、连接程度或周围溶液后,材料会吸多少水,又会变得多软?可尝试的组合很多,测量却需要时间与样品。本节把AI放到这个选择发生的位置。模型除了预测性质,还要说明哪些地方了解得较少,并根据已经测得的结果,建议下一次去哪里取数据。我们会亲自运行三种选样策略,比较完整实验的误差、测量成本和预测区间。
01一次测量能回答什么,先于模型怎样选择
假设正在研究一种吸水后仍能保持形状的凝胶。桌上已有几种配方:有的吸水多但支撑较弱,有的比较结实却吸水较少。现在只能再做几个样品,很自然会想到两种安排。一种是在已有表现较好的配方附近细调,争取尽快找到合用材料;另一种是补测资料稀少的条件,让我们更清楚整个体系怎样变化。两种安排都有研究价值,适合的选择规则却会有所不同。
前一种安排更接近优化,关心的是能否找到满足目标的候选;后一种安排更接近主动学习,关心的是新增数据能否改善对性质规律的认识。本节先练习第二种任务:用有限次数的测量,学会预测一片参数范围中的溶胀表现。《生物凝胶设计:物理反求与贝叶斯优化》再把研究目标收紧到材料设计。这样安排以后,读者可以分别判断一个模型是否“学得更清楚”,以及它是否“找到了更合适的样品”。
这种区分在生物材料中尤其实际。设想一个供细胞生长的凝胶环境,我们可能同时关心细胞能否附着、材料能否保持结构,以及水和溶质怎样进入其中。某个单一指标数值最高,不一定对应整体最合用的条件。实验设计需要先写清用途,再决定要收集哪些性质,最后才轮到算法计算下一步。用途给测量提供方向,也决定了模型的输入与评价方式。
Nichol等在2010年的GelMA研究把这些问题联系了起来。GelMA由明胶经过化学改性得到;明胶来自胶原,保留了与细胞相互作用有关的分子结构。研究者改变材料浓度与改性程度,测量力学和溶胀表现,并观察细胞在材料上的附着与形态。这段研究史提供了一个具体起点:可以调节的化学条件,最终要通过测量与生物学表现建立联系。
当可调因素增加时,把所有组合都试一遍很快会变得费力。三个因素各取五档,就有125种组合;每种组合再做三份独立样品,便需要375份。若还要改变温度、盐条件或制备批次,数量会继续增加。这里的乘法提醒我们,数据收集本身也是研究方法的一部分。选择有信息的样品,有机会在同样的测量次数内得到更完整的认识。
不过,“有信息”需要一个明确对象。若想知道某个条件下的平均溶胀比,重复测量同一条件就有价值;若想知道两种配方之间是否存在转折,就需要在它们之间补点;若想了解从未出现过的化学修饰,沿旧配方反复细调则提供不了相应证据。AI参与实验选择时,首先要把这些不同目的转成可以比较的量,而不是笼统地把所有未知都叫作同一种不确定性。
本节把问题限定为两个连续输入下的一项材料性质。这样,读者既能在平面图上看见已有样品在哪里,也能逐步追踪“预测—选择—测量—更新”的过程。完整代码中的标签由一个明确的物理方程生成,允许我们随时检查模型预测与方程真值的差别。前面章节中的真实糖链、丝素和流变数据说明了实验记录的复杂性;这里可计算的环境则帮助我们集中观察选样规则本身。
这套环境中,物理计算扮演实验设备的角色:算法提出一个条件,它才获得该条件的一条读数。用于最终评价的其他条件始终留在评价端。实际程序为了节省运行时间,会预先生成一张潜在读数表;选样函数每一步只能使用已经选中的行。读者可以直接检查输入索引,确认模型没有提前读到待测条件的结果。这是理解主动学习时很有用的一条线索:先看信息在什么时候被交给谁。
02建立一个能逐项解释的凝胶虚拟实验
把一块干燥网络放入溶剂后,溶剂进入链之间的空间,网络整体膨胀。链与溶剂混合会改变自由能,交联后的链段被拉开也会改变自由能。前面讨论过的混合与弹性,在这里需要共同决定同一个平衡状态。理解这种联系,可以想象一张能够吸入水的细密弹性网:进入的水改变内部环境,网线伸展又产生回缩趋势,最后停在两种作用相互平衡的大小。
先给“吸了多少水”一个清楚定义。把聚合物本身占据的体积记为Vp,吸水后凝胶总体积记为Vgel,它们的比值φ就是聚合物体积分数。若聚合物体积保持不变,凝胶总体积与干聚合物体积的比值QV便等于1/φ。比如φ=0.05,表示总体积中5%由聚合物占据,对应QV=20,溶剂体积分数为95%。
实验里更容易称质量,所以还常见质量溶胀比Qm,它等于湿样品质量除以干聚合物质量。把多出来的溶剂质量除以溶剂密度ρs,把聚合物质量除以聚合物密度ρp,就能在体积可加的近似下得到上式。假设Qm=10、聚合物与溶剂的密度比为1.3,则QV=1+9×1.3=12.7。两者都描述溶胀,但直接拿10与12.7比较,会把定义差别当成材料差别。
这也是阅读生物材料论文时值得养成的习惯。前述GelMA研究记录了湿质量与干质量,其溶胀指标属于质量比。我们接下来生成的数值则属于体积比。把符号、称量方式和参考状态一并记下来,后续模型才知道不同来源的数据是否能放到同一列。第十七节处理散射信号时强调过单位与测量定义,这里同样需要先完成这一步。
Flory与Rehner在1943年研究交联网络的溶胀,将溶剂混合和网络弹性放进同一统计力学框架。我们可以沿着这条思路,先选定一个便于计算的中性、均匀、具有高斯链弹性的网络模型。下式规定本节虚拟实验中的平衡关系;给定网络链密度与溶剂参数后,程序寻找0到1之间使左右平衡的φ,再算出QV。
ln表示自然对数,χ读作“卡”,是这里描述聚合物与溶剂混合作用的无量纲参数。前三项来自所选混合模型,最后一项来自网络弹性。νe表示按干参考体积计算的有效弹性链摩尔密度,单位为mol/m³;vs表示溶剂摩尔体积,单位为m³/mol。两者相乘后单位消去,因此式中每一项都无量纲,可以相加。指数1/3与三维均匀体积变化对应的线性尺度有关。
这里的链密度描述参与弹性响应的有效链,和把交联剂加了多少并非同一份记录。环、悬垂链、未反应基团以及制备时的状态,都会影响从化学配方到有效网络的对应关系。本节先把νe与χ当作已经定义好的模型输入,观察AI怎样从有限的输入—输出对学习规律。到了真实材料研究中,还需要通过表征,把可操作的配方条件与这些有效参数联系起来。
求φ时通常不能像解一次方程那样直接移项得到答案,但可以试探哪个数使表达式接近零。若一个φ值给出正数,另一个给出负数,而中间函数连续,就能逐渐缩小夹住零点的区间。代码使用的求根算法正是在利用这种信息。它找到的是给定方程的平衡解;数学上的求解步骤和物理上为什么采用这个方程,各自都有可以检查的依据。
以νe=10 mol/m³、χ=0.4、vs=18×10−6 m³/mol为例,程序得到φ约0.02113,因此QV约47.32。这个数的意思是,平衡凝胶体积约为所选干聚合物参考体积的47倍。若把χ改为0.55,其他输入保持相同,QV约为6.94。两个结果来自同一个方程,展示了改变溶剂相互作用参数怎样改变平衡状态。
完整实验让νe在2到60 mol/m³之间变化,让χ在0.2到0.55之间变化。为了比较两个方向的距离,先把它们都转成0到1之间的坐标。链密度采用对数坐标,因此按相同倍数变化会产生相同的坐标间隔;溶剂参数采用线性坐标。这里用对数坐标是一个明确的建模选择,意味着我们将“增加一倍链密度”视为比“增加同一个绝对数值”更均匀的变化尺度。
x1和x2合在一起,就是模型接收的二维输入。νe除以2 mol/m³以后得到无量纲比值,才能放入对数;当νe从2增加到60时,这个比值从1变成30,x1也就从0变成1。χ从0.2增加到0.55时,x2同样从0变成1。把坐标写清楚,后面的“附近”“较远”才有统一含义。
预测目标f采用ln QV,因为溶胀比在所选范围内跨越了较大的倍数。自然对数会把乘法变化变成加法变化:若预测值比真值高0.04个对数单位,回到QV尺度就是乘以e0.04,约增加4.1%。这让不同大小的溶胀比可以在相对变化的尺度上比较,也让测量波动的大小更容易解释。
虚拟设备每次返回y=f+ε,其中ε独立地从均值为0、标准差为0.04的正态分布中抽取。也就是说,同一个物理状态有明确的平均关系,而一次观察会在它附近波动。后面我们会分别评价模型对f的预测误差,以及新观察值y落入区间的比例。把这两种量分开,能够避免将仪器读数的起伏与模型对平均规律的认识混为一谈。
03让模型同时给出预测和把握程度
如果已经测过某个条件,附近条件通常比远处条件更容易估计。比如在温度和配方都接近时,一块凝胶的吸水表现往往可以给另一块提供线索。高斯过程把这种“附近应该有关联”的想法写成一个概率模型。它考虑一族可能的性质曲面,已有数据逐步改变哪些曲面更符合观察,由此得到一个预测均值,以及各个位置剩余的分散程度。
高斯过程可以先理解为一张带有相关关系的预测表:每个格子对应一个输入条件,格子里的函数值还没有完全确定,附近条件的结果会彼此提供线索。测得几个格子以后,模型更新其他格子的预测均值和不确定程度。“高斯”指的是任取有限多个输入位置时,用多元正态分布描述这些函数值的联合变化。它规定的是预测之间怎样一起波动,材料性质随输入变化的曲线本身可以弯曲、上升或下降。这个区分能帮助我们把平均响应曲线与其周围的预测范围分开阅读。
关联有多强,由一个称为核函数的规则决定。我们选用平方指数核,它根据两个输入之间的距离给出协方差。两个位置完全相同时,距离为0,关联达到a²;随着距离变大,指数项逐渐减小,两个位置的函数值就更能各自变化。这里的协方差是概率模型中的共同变化量,所用单位也来自目标f,而不是一种新的材料性质。
ℓ读作“艾尔”,称为相关长度。两个坐标各有自己的ℓ,先用它除以坐标差,再把两个方向的平方加起来。若某个方向的ℓ较大,沿该方向移动一小段仍会被视为很近;若ℓ较小,同样的移动就使关联明显减弱。完整代码中链密度方向的ℓ固定为0.6,溶剂方向则考虑0.15、0.35和0.7三种可能,分别允许较快、中等和较慢的变化。
幅度a控制在尚未看到数据时,函数围绕先验均值能够变化多大。完整例子使用先验均值3.5、幅度1.5,这些数在选样实验运行前已经固定。先验可以理解为开始测量前对性质尺度的安排:它给模型一个出发点,后续读数再修正这个出发点。研究者可以依据量纲、已有独立资料或先导实验选择先验,同时记清这些信息来自哪一阶段。
有了核函数,就能将已测位置之间的协方差排成矩阵K。K的第i行、第j列,说明第i个与第j个条件的潜在函数值怎样相关。测量误差另外进入对角线,因为本例规定不同观察的噪声相互独立。对角线上加入σε²,也使模型知道一条读数带有波动,不能要求预测曲线毫无偏差地穿过每一个观察点。
式中的m是先验均值,y是已有读数排成的列向量,1表示每个位置都为1的向量。k*列出新位置与所有已测位置的协方差,k**则是新位置自身的先验方差。右上角T表示转置,用来把列转成行,使矩阵乘法的形状相配。μ*是预测均值,s*²是潜在函数值的预测方差;星号只标记“正在预测的新位置”。
C−1看起来最陌生,它表示逆矩阵。可以先从一个数的倒数理解:乘以2以后,乘以1/2能够还原;矩阵的逆则处理多个相互关联的量。在预测式中,它帮助权衡读数之间的重复信息和测量波动。代码实际通过线性方程求解来完成这一步,避免显式计算整个逆矩阵。初学者先掌握它承担的作用,之后再深入线性代数细节。
只有一个读数时,矩阵会退化成普通数字,整个过程可以手算。设先验均值为0、幅度为1,在x=0.4处测得y=1,相关长度为0.2,噪声标准差为0.2。现在预测x=0.6,两点的标准化距离是1,协方差便为e−1/2≈0.6065。原位置自身的方差为1,加上噪声方差0.04,得到C=1.04。
于是新位置的预测均值为0.6065÷1.04≈0.5832,潜在方差为1−0.6065²÷1.04≈0.6463。预测既受到y=1的影响,又保留了先验均值0的作用,因为新位置与已测位置相隔了一段距离。若还要预测该位置下一次实际读数,就再加上测量噪声方差,得到标准差约0.8284。下面的交互图初始设置正对应这个例子,可以逐个改变条件。
只有一条读数时,下一次去哪里测量?
绿色为预测均值,浅色带为当前单个高斯过程的新读数90%模型区间。此处初始读数为1,后续演示读数由cos[2π(x−0.4)]给出;噪声滑块规定模型对每个读数的信任程度。演示最多加入8个条件。
试着把相关长度调大,会发现一个读数的影响扩展到更远位置;把噪声调大,模型则对同一个读数保留更多余地。再点击测量按钮,模型会在尚未测过的位置中寻找潜在方差最大的一处,取得演示读数,再重新计算整条曲线。绿色线与浅色带的变化,分别对应“预测中心改变”和“可能范围改变”,两者可以同时发生,也可以变化幅度很不相同。
交互图采用一个固定核,完整实验则让三个相关长度不同的模型共同参与。三个模型都看到同一批读数,各自计算预测,并根据这些读数在各模型下出现的概率更新权重。这个概率称为边际似然,它既关注数据与预测的匹配,也考虑模型允许的函数变化范围。因此,更新权重时使用的是当前已测数据,而没有借用最终测试样品的答案。
Mr表示第r个候选模型,wr是它的权重,三个权重之和为1。本例给它们相同的初始机会,随后按边际似然归一化。混合均值就是三个均值的加权平均,类似把三位估计者的意见按已有表现合在一起。不过,合并不确定性还要多想一步:既要保留每位估计者自己认为可能有的波动,也要保留他们彼此意见不一致的部分。
因此,混合方差里有sr²,也有(μr−μ̄)²。假设两位估计者各占一半权重,分别预测1和3,而且各自的方差都为0.25,合并后的均值是2,方差则为0.25+1=1.25。若只平均两个0.25,就会漏掉他们对中心位置的明显分歧。这个简单例子解释了为什么模型集成中的“意见分散”能成为不确定性的一部分。
MacKay在1992年讨论主动数据选择时,把测量前预计能够获得多少信息作为目标,并指出不同的信息对象会导向不同选择。对刚开始接触AI的读者,这段历史说明了一件很具体的事:学习算法可以参与决定数据从哪里来。它需要先说明自己关心的未知量,再把候选测量与这个未知量联系起来。
本节选择一个便于直接计算的规则:测量尚未测过、混合潜在方差最大的位置。这里使用的是对平均函数的未知程度。若改用观察值方差,其中还包含测量噪声;在不同条件噪声大小不同的实验里,盯着观察方差最大的位置,可能反复选择最难测准的样品。本例把噪声标准差设为相同,所以两种排序一致,但区分它们的含义仍然有助于将方法移到真实实验。
相关长度也提醒我们,不确定性总是连着某个模型。模型认为附近应该平滑,读数便会在附近传播影响;若真实体系突然出现结构转变,原先的平滑安排就需要重新检查。研究者可以通过补测转折附近的条件、比较重复样品、增加新的结构表征来更新认识。学习模型提供的是一套可计算的判断,实验结果则持续检验这套判断是否适合当前体系。
04选择测量以后,还要校准对新样品的判断
知道哪里不确定以后,就可以安排下一次测量,但还需要一个公平的比较对象。最直观的基线是随机选样:从未测条件中抽取一个。另一种很实用的办法是尽量填补空间中的空白,每次选择离已有样品最远的位置。它不使用已测性质的数值,只根据输入坐标安排覆盖,因此适合帮助判断复杂的选样计算究竟比均匀探索增加了多少作用。
U表示尚未测量的候选集合,D表示已经测量的输入位置。arg max读作“使后面的量最大的位置”,它返回一个条件,而不是返回那个最大数值。第二条规则先计算候选与每个已有样品的距离,再取其中最小值;这个最小值越大,说明它离最近的已知位置也很远。两条规则都在测量后更新,区别在于一种使用模型方差,另一种使用几何距离。
代码把两个输入方向各分为25档,共得到625个候选条件。每轮实验先随机取得8个起点,三种策略共享这8条读数,再各自补选28个不同条件,使训练测量数都达到36。共享起点有助于控制比较:一轮实验碰巧有较好的初始覆盖时,三种策略都获得同样的起点,而不会把起点差别误记为策略差别。
我们还让同一轮中的同一个候选拥有相同的潜在噪声读数。这样,如果两种策略后来选到同一条件,就会读取同一份虚拟观察;它们的差别主要来自测量位置怎样安排。实际实验中,可以通过共享初始数据、控制制备批次和随机安排测试顺序来减少无关差异。这里用固定随机数种子把这些比较条件保存下来,使读者能够重复整个过程。
King等在2004年的机器人科学家研究将假设生成、实验选择、实际执行和结果解释接成循环,并在酵母基因功能问题中进行了研究。它把“下一次实验”的价值放进科学推理本身。本节用可计算的凝胶环境展开这一循环:每次得到新读数以后,更新模型,再决定下一次测什么。
模型给出的区间,还需要用独立观察来检查。第十七节已经介绍了校准的基本想法:取一组没有参加拟合的数据,看看预测通常偏离实际多少,再据此设置区间。本节沿用这个思路,但将残差除以模型给出的观察标准差。这样,模型认为更难预测的位置可以获得更宽的区间,校准数据则帮助调整这个宽度整体应该放大到什么程度。
ri是第i个校准样品的标准化残差。分子取绝对值,表示偏差大小;分母把潜在方差与测量噪声方差相加,再开平方,得到新读数的预测标准差。若一条观察偏差0.12,模型给出的标准差为0.06,则分数为2,表示它离预测中心有两个这样的标准差。将所有校准分数排好序,就能选择一个统一的放大倍数q。
本例有40个独立校准样品,希望构造名义覆盖水平90%的区间,所以α=0.1。符号⌈ ⌉表示向上取整,41×0.9=36.9向上取为37,于是使用从小到大排列后的第37个分数。假设某次得到q=2,而新位置的观察标准差为0.05,那么区间在均值左右各延伸0.10。这里使用40加1的次序规则,与有限样本下的覆盖性质有关。
这类拆分共形预测将拟合和校准分开。在模型已经由训练阶段固定、校准对象与未来对象来自相同抽样机制的条件下,分数的排列提供边际覆盖保证。边际的意思是对这样抽到的新对象整体而言,不等于每一种配方、每一个局部区域都恰好有90%的覆盖率。一轮有限测试中,实际比例也会在目标附近上下波动。
主动选出的训练点可以很不均匀,但本例的40个校准点另外独立抽取,均匀覆盖定义的输入域;它们与同域测试对象采用相同的抽样规则。拟合期间既不用校准分数调整核,也不用它们决定下一次测量。这样,就把主动学习负责的模型建立阶段,与独立校准负责的区间调整阶段清楚连接起来。读者复现时,应当一起保留这份数据使用顺序。
测量成本也要完整计算。三种策略各使用36次训练测量,加上40次独立校准,总共76次;图中的学习曲线横轴只画前36次,图注会同时说明校准开销。校准样本数在这个教学例子中占比不小,是为了让有限样本的分数排序容易检查。真正安排实验时,可以根据既有独立数据和总体预算确定校准规模,再将费用、时间与重复测量一起计入计划。
为了检查新环境,我们另外生成χ在0.55到0.65之间的对象,链密度范围保持相同。这个溶剂参数区间超出了训练和校准范围,所以它回答的是另一个问题:模型走出熟悉区域后,误差和区间怎样变化?同域校准建立的抽样条件在这里已经改变,因此需要直接查看这组结果,并根据新的使用环境补充相应测量。这个动作本身也可以成为下一轮实验选择的起点。
05运行完整实验,再从图里决定下一步
下面的Python从平衡方程开始生成数据,随后运行随机、空间覆盖和不确定性三种策略。为了观察起点与噪声带来的变化,每种策略都完成12轮实验;每轮固定36个训练条件,并保留每次新增条件、对应读数、三个核的权重以及独立校准分数。程序只需要NumPy、SciPy和Matplotlib。
阅读代码时,可以先寻找三个核心部分。physical负责把条件转换成物理真值,MixtureGP负责根据当前数据计算预测,campaign负责按选样规则逐次增加数据。把这三部分分开以后,便能看见物理知识和学习算法各自承担什么:方程定义本例的材料响应,模型从有限读数逼近这个响应,策略决定哪些读数进入模型。换成真实实验时,主要需要替换取得新读数的接口,并继续保存测量条件。
"""Sequential measurements in a defined neutral-gel virtual laboratory.
Run: python example.py
Requires NumPy, SciPy, Matplotlib; all data are generated by explicit equations.
The physical oracle generates labels. Selection sees queried labels only.
"""
from pathlib import Path
import json, os
os.environ.setdefault('OPENBLAS_NUM_THREADS','1')
os.environ.setdefault('OMP_NUM_THREADS','1')
import numpy as np
from scipy.optimize import brentq
from scipy.linalg import cho_factor, cho_solve, solve_triangular
from scipy.special import logsumexp
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D

OUT=Path('active_outputs');OUT.mkdir(exist_ok=True)
NOISE=.04;AMP=1.5;PRIOR=3.5;JITTER=1e-10
LENGTHS=np.array([[.6,.15],[.6,.35],[.6,.7]])
SEEDS=list(range(1900,1912));BUDGETS=[8,12,16,20,24,28,32,36]
STRATEGIES=['random','maximin','uncertainty']
axis=np.linspace(0,1,25)
POOL=np.array([(a,b) for b in axis for a in axis])

def physical(x):
    """Return ln(volume swelling), polymer fraction and shear scale in kPa."""
    x=np.atleast_2d(x);nu=2*np.exp(np.log(30)*x[:,0]);chi=.2+.35*x[:,1]
    phi=[]
    for n,c in zip(nu,chi):
        def equation(p):return np.log1p(-p)+p+c*p*p+n*18e-6*(p**(1/3)-p/2)
        phi.append(brentq(equation,1e-7,1-1e-10,xtol=1e-14))
    phi=np.array(phi)
    return -np.log(phi),phi,nu*8.314462618*298*phi**(1/3)/1000

def kernel(a,b,length):
    d=(a[:,None,:]-b[None,:,:])/length
    return AMP**2*np.exp(-.5*np.sum(d*d,axis=2))

class MixtureGP:
    """Exact conditioning in each kernel, followed by Bayesian model averaging."""
    def __init__(self,x,y):
        self.x=x.copy();self.y=y.copy();self.components=[];evidence=[]
        for length in LENGTHS:
            K=kernel(x,x,length)+(NOISE**2+JITTER)*np.eye(len(x))
            factor=cho_factor(K,lower=True);alpha=cho_solve(factor,y-PRIOR)
            ll=-.5*((y-PRIOR)@alpha)-np.log(np.diag(factor[0])).sum()-.5*len(x)*np.log(2*np.pi)
            evidence.append(ll);self.components.append((length,factor,alpha))
        self.log_evidence=np.array(evidence)
        self.weights=np.exp(self.log_evidence-logsumexp(self.log_evidence))
    def predict(self,q):
        means=[];variances=[]
        for length,factor,alpha in self.components:
            cross=kernel(self.x,q,length)
            projected=solve_triangular(factor[0],cross,lower=True)
            means.append(PRIOR+cross.T@alpha)
            variances.append(np.maximum(0,AMP**2-np.sum(projected**2,axis=0)))
        means=np.array(means);variances=np.array(variances)
        mean=self.weights@means
        variance=self.weights@(variances+means**2)-mean**2
        return mean,np.maximum(variance,0)

def assess(model,x,truth):
    mean,var=model.predict(x)
    return float(np.sqrt(np.mean((mean-truth)**2)))

def campaign(seed):
    rng=np.random.default_rng(seed)
    initial=rng.choice(len(POOL),8,replace=False).tolist()
    # Potential outcomes couple comparisons; the selector receives only queried values.
    pool_truth,_,_=physical(POOL);pool_y=pool_truth+rng.normal(0,NOISE,len(POOL))
    cal_x=rng.random((40,2));test_x=rng.random((256,2));shift_x=rng.random((128,2))
    shift_x[:,1]=1+shift_x[:,1]*(.1/.35)
    cal_truth=physical(cal_x)[0];test_truth=physical(test_x)[0];shift_truth=physical(shift_x)[0]
    cal_y=cal_truth+rng.normal(0,NOISE,40)
    test_y=test_truth+rng.normal(0,NOISE,256);shift_y=shift_truth+rng.normal(0,NOISE,128)
    random_order=rng.permutation(len(POOL)).tolist()
    runs={}
    for strategy in STRATEGIES:
        chosen=initial.copy();curve=[];acquired=[];weight_history=[]
        for n in range(8,37):
            model=MixtureGP(POOL[chosen],pool_y[chosen])
            weight_history.append(model.weights.tolist())
            if n in BUDGETS:curve.append(assess(model,test_x,test_truth))
            if n==36:break
            if strategy=='random':idx=next(i for i in random_order if i not in chosen);score=None
            else:
                if strategy=='maximin':scores=np.min(np.sum((POOL[:,None,:]-POOL[chosen][None,:,:])**2,axis=2),axis=1)
                else:scores=model.predict(POOL)[1]
                scores[chosen]=-np.inf;idx=int(np.argmax(scores));score=float(scores[idx])
            chosen.append(idx);acquired.append(dict(index=idx,score=score))
        cm,cv=model.predict(cal_x);scores=abs(cal_y-cm)/np.sqrt(cv+NOISE**2)
        rank=int(np.ceil((len(scores)+1)*.9));qhat=float(np.sort(scores)[rank-1])
        tests={}
        for key,xx,tt,yy in [('nominal',test_x,test_truth,test_y),('shifted',shift_x,shift_truth,shift_y)]:
            mean,var=model.predict(xx);half=qhat*np.sqrt(var+NOISE**2)
            tests[key]=dict(RMSE_logQ=float(np.sqrt(np.mean((mean-tt)**2))),
                coverage=float(np.mean(abs(yy-mean)<=half)),mean_interval_width_logQ=float(np.mean(2*half)),
                x=xx.tolist(),truth=tt.tolist(),observation=yy.tolist(),mean=mean.tolist(),variance=var.tolist(),half_width=half.tolist())
        runs[strategy]=dict(chosen=chosen,observations=pool_y[chosen].tolist(),learning_RMSE=curve,
            acquisitions=acquired,kernel_weights=model.weights.tolist(),weight_history=weight_history,
            calibration_scores=scores.tolist(),calibration_rank=rank,qhat=qhat,tests=tests)
        if seed==SEEDS[0]:
            grid_mean,grid_var=model.predict(POOL)
            runs[strategy]['grid_mean']=grid_mean.tolist();runs[strategy]['grid_variance']=grid_var.tolist()
            slice_x=np.column_stack([np.full(120,.5),np.linspace(0,1+.1/.35,120)])
            sm,sv=model.predict(slice_x)
            runs[strategy]['slice']=dict(x=slice_x.tolist(),truth=physical(slice_x)[0].tolist(),mean=sm.tolist(),half_width=(qhat*np.sqrt(sv+NOISE**2)).tolist())
    return dict(seed=seed,initial=initial,cal_x=cal_x.tolist(),cal_y=cal_y.tolist(),runs=runs)

campaigns=[]
for seed in SEEDS:
    campaigns.append(campaign(seed));print('Completed paired campaign',seed,flush=True)
summary={}
for strategy in STRATEGIES:
    curves=np.array([c['runs'][strategy]['learning_RMSE'] for c in campaigns])
    summary[strategy]=dict(learning_mean=curves.mean(0).tolist(),learning_min=curves.min(0).tolist(),learning_max=curves.max(0).tolist(),
        final_RMSE_each=curves[:,-1].tolist(),final_RMSE_mean=float(curves[:,-1].mean()),final_RMSE_sd=float(curves[:,-1].std(ddof=1)))
    for key in ['nominal','shifted']:
        summary[strategy][key]={m:float(np.mean([c['runs'][strategy]['tests'][key][m] for c in campaigns])) for m in ['coverage','RMSE_logQ','mean_interval_width_logQ']}
truth,phi,G=physical(POOL)
results=dict(task='Explicit neutral-gel virtual laboratory, not fitted experimental formulations',seeds=SEEDS,budgets=BUDGETS,
    model=dict(lengthscales=LENGTHS.tolist(),prior_mean=PRIOR,amplitude_sd=AMP,noise_sd=NOISE,jitter=JITTER),
    costs=dict(training_queries=36,independent_calibration=40,total_per_campaign=76,nominal_test_audit=256,shifted_test_audit=128),
    pool=POOL.tolist(),pool_truth=truth.tolist(),pool_phi=phi.tolist(),pool_G_kPa=G.tolist(),summary=summary,campaigns=campaigns)
(OUT/'results.json').write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
(OUT/'samples.json').write_text(json.dumps(dict(pool=results['pool'],truth=results['pool_truth'],campaigns=campaigns),ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
for name,row in summary.items():
    print(f"{name:12s} final latent RMSE={row['final_RMSE_mean']:.5f}; nominal coverage={row['nominal']['coverage']:.3f}; shifted coverage={row['shifted']['coverage']:.3f}")
print('Each campaign: 36 training measurements + 40 independent calibration measurements')
print('All 12 paired campaigns retained; independent audit: 256 nominal + 128 shifted objects')

plt.rcParams.update({'font.family':'DejaVu Sans','font.size':10,'axes.spines.top':False,'axes.spines.right':False,
    'axes.labelcolor':'#30453f','text.color':'#243d35','axes.edgecolor':'#bac7c0','xtick.color':'#53675e',
    'ytick.color':'#53675e','svg.hashsalt':'L19-active','figure.facecolor':'#fffef9','axes.facecolor':'#fffef9'})
COLORS=['#a79883','#3f8297','#267b69'];LABELS=['Random','Space filling','Uncertainty']
first=campaigns[0]['runs']
def decorate(ax,title,x='',y=''):
    ax.set_title(title,loc='left',fontweight='bold',pad=14);ax.set_xlabel(x);ax.set_ylabel(y)
    ax.grid(axis='y',color='#e5eae1',lw=.7);ax.set_axisbelow(True)
def draw(i,fig,spec):
    if i==4:
        grid=spec.subgridspec(2,1,hspace=.04);axes=[fig.add_subplot(grid[j,0]) for j in range(2)]
        for j,(key,ylab) in enumerate([('coverage','Fraction covered'),('mean_interval_width_logQ','Mean full width (log Q)')]):
            ax=axes[j]
            for k,(name,c) in enumerate(zip(STRATEGIES,COLORS)):
                values=[summary[name][domain][key] for domain in ['nominal','shifted']]
                ax.bar(np.arange(2)+(k-1)*.23,values,.21,color=c,label=LABELS[k])
                for x,y in zip(np.arange(2)+(k-1)*.23,values):ax.text(x,y+.015,f'{y:.3f}',ha='center',fontsize=8)
            ax.set_xticks([0,1],['Same parameter domain','New solvent range'])
            decorate(ax,'E  Read coverage together with interval width' if j==0 else '',y=ylab)
            if j==0:ax.axhline(.9,color='#ba8452',ls='--',lw=1);ax.set_ylim(0,1.15);ax.legend(frameon=False,ncol=3,fontsize=8,loc='lower left')
            else:ax.set_ylim(0,1.4)
        return
    ax=fig.add_subplot(spec)
    if i==0:
        im=ax.imshow(truth.reshape(25,25),origin='lower',extent=[0,1,.2,.55],aspect='auto',cmap='YlGnBu')
        ids=first['uncertainty']['chosen'];xy=POOL[ids]
        ax.scatter(xy[8:,0],.2+.35*xy[8:,1],s=25,facecolors='#d19a5c',edgecolors='white',lw=.8,label='28 sequential choices')
        ax.scatter(xy[:8,0],.2+.35*xy[:8,1],s=60,marker='+',c='white',lw=1.8,label='8 shared initial points')
        ax.set_xticks([0,.5,1],['2',f'{2*np.sqrt(30):.2f}','60'])
        decorate(ax,'A  Learn a swelling surface with 36 measurements','Dry-reference strand density (mol / m³; log scale)','Solvent interaction parameter χ')
        ax.grid(False);ax.legend(frameon=True,facecolor='#244d56',labelcolor='white',fontsize=8,loc='lower right')
        fig.colorbar(im,ax=ax,label='Physical ln Q',shrink=.8)
    elif i==1:
        for name,label,c in zip(STRATEGIES,LABELS,COLORS):
            row=summary[name];ax.plot(BUDGETS,row['learning_mean'],'o-',c=c,label=label,ms=4)
            ax.fill_between(BUDGETS,row['learning_min'],row['learning_max'],color=c,alpha=.09)
        ax.set_yscale('log');ax.set_xticks(BUDGETS)
        decorate(ax,'B  Compare complete learning campaigns','Training measurements','Latent-function RMSE (log Q)')
        ax.legend(frameon=False);ax.text(.03,.04,'Line: mean of 12 campaigns · band: full range',transform=ax.transAxes,fontsize=9)
    elif i==2:
        vals=np.array([summary[s]['final_RMSE_each'] for s in STRATEGIES]).T
        for row in vals:ax.plot(range(3),row,color='#b5beb2',lw=.8,alpha=.7,zorder=1)
        for k,(label,c) in enumerate(zip(LABELS,COLORS)):
            ax.scatter(np.full(12,k),vals[:,k],s=26,c=c,alpha=.65,zorder=2)
            ax.plot([k-.17,k+.17],[vals[:,k].mean()]*2,c=c,lw=4,zorder=3)
            ax.text(k,vals[:,k].max()+.012,f'mean {vals[:,k].mean():.4f}',ha='center',fontsize=9)
        ax.set_xticks(range(3),LABELS);ax.set_xlim(-.45,2.45);ax.set_ylim(0,.19)
        decorate(ax,'C  Keep every paired repeat at the final budget',y='RMSE after 36 measurements (log Q)')
        ax.text(.04,.92,'Each thin line connects the same campaign seed',transform=ax.transAxes,fontsize=9)
    elif i==3:
        t=first['uncertainty']['tests']['nominal'];obs=np.array(t['observation']);mean=np.array(t['mean']);half=np.array(t['half_width'])
        ax.errorbar(obs,mean,yerr=half,fmt='none',ecolor='#a6bb9d',alpha=.45,lw=.6)
        ax.scatter(obs,mean,s=15,c=COLORS[2],alpha=.7);ax.plot([1.5,5.6],[1.5,5.6],c='#b78351',ls='--',lw=1)
        ax.set(xlim=(1.5,5.6),ylim=(1.5,5.6));decorate(ax,'D  Check new observations and their intervals','New observed ln Q','Predicted ln Q with calibrated interval')
        ax.text(.04,.92,f"Seed 1900 · 256 held-out observations\nCoverage {t['coverage']:.1%}",transform=ax.transAxes,fontsize=9)
    else:
        row=first['uncertainty'];s=row['slice'];x=np.array(s['x']);chi=.2+.35*x[:,1];mu=np.array(s['mean']);half=np.array(s['half_width'])
        ax.axvspan(.55,.65,color='#ece2cc',alpha=.6,label='Beyond sampled solvent range')
        ax.fill_between(chi,mu-half,mu+half,color='#90b29d',alpha=.45,label='Calibrated observation interval')
        ax.plot(chi,s['truth'],c='#354a43',lw=2,label='Physical oracle');ax.plot(chi,mu,c='#267b69',ls='--',lw=2,label='GP mixture mean')
        ax.axvline(.55,color='#b78351',ls=':',lw=1)
        decorate(ax,'F  Follow one slice into a new solvent range','χ at ν = 10.95 mol / m³','ln Q')
        ax.legend(frameon=False,fontsize=8,loc='upper right')
        ax.text(.03,.04,'Final kernel weights (short / medium / long):\n'+ ' / '.join(f'{v:.3f}' for v in row['kernel_weights']),transform=ax.transAxes,fontsize=8)
keys=['surface','learning','paired','intervals','coverage','slice']
for i,key in enumerate(keys):
    fig=plt.figure(figsize=(8.6,5.5),layout='constrained');draw(i,fig,fig.add_gridspec(1,1)[0]);fig.savefig(OUT/f'{key}.svg',metadata={'Date':None});plt.close(fig)
fig=plt.figure(figsize=(18,16.5),layout='constrained');grid=fig.add_gridspec(3,2,hspace=.12,wspace=.1)
for i in range(6):draw(i,fig,grid[i//2,i%2])
fig.savefig(OUT/'active_learning.svg',metadata={'Date':None});fig.savefig(OUT/'active_learning.png',dpi=160,metadata={'Software':'L19 reproducible example'});plt.close(fig)
print('Full campaigns, calibration scores and six figures: active_outputs/')
本次实际运行输出
Completed paired campaign 1900
Completed paired campaign 1901
Completed paired campaign 1902
Completed paired campaign 1903
Completed paired campaign 1904
Completed paired campaign 1905
Completed paired campaign 1906
Completed paired campaign 1907
Completed paired campaign 1908
Completed paired campaign 1909
Completed paired campaign 1910
Completed paired campaign 1911
random       final latent RMSE=0.07603; nominal coverage=0.871; shifted coverage=0.919
maximin      final latent RMSE=0.03647; nominal coverage=0.901; shifted coverage=0.725
uncertainty  final latent RMSE=0.03641; nominal coverage=0.901; shifted coverage=0.744
Each campaign: 36 training measurements + 40 independent calibration measurements
All 12 paired campaigns retained; independent audit: 256 nominal + 128 shifted objects
Full campaigns, calibration scores and six figures: active_outputs/
一次运行 · 六幅结果图
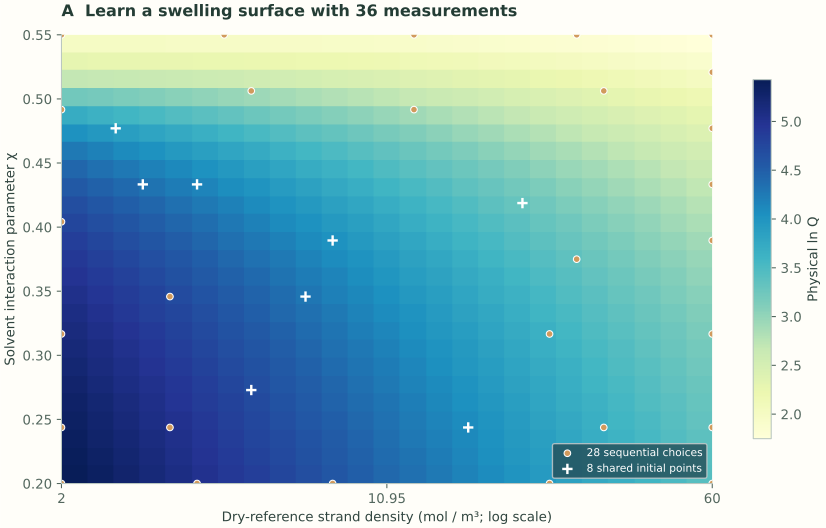
A|定义的中性网络溶胀曲面;十字为8个共享起点,圆点为第1900号实验中依次选择的28个条件。
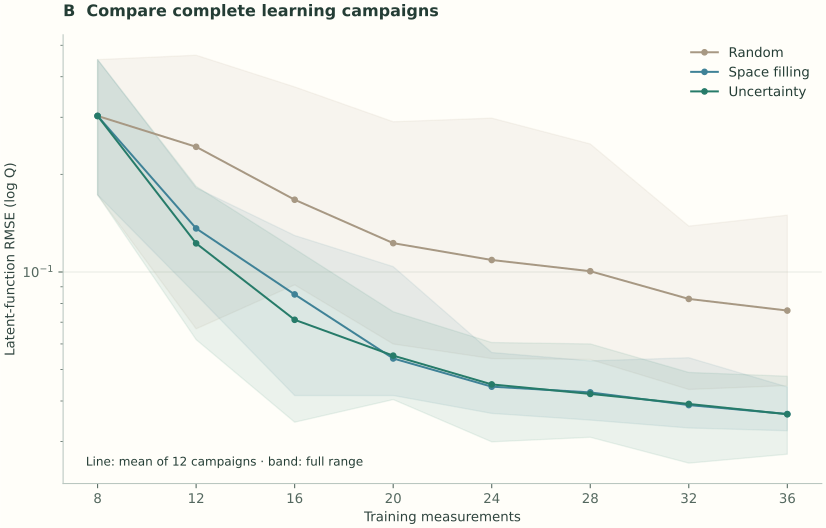
B|12轮完整实验的平均学习曲线与最小—最大范围,横轴只计用于拟合的测量,每种策略另有40次独立校准。
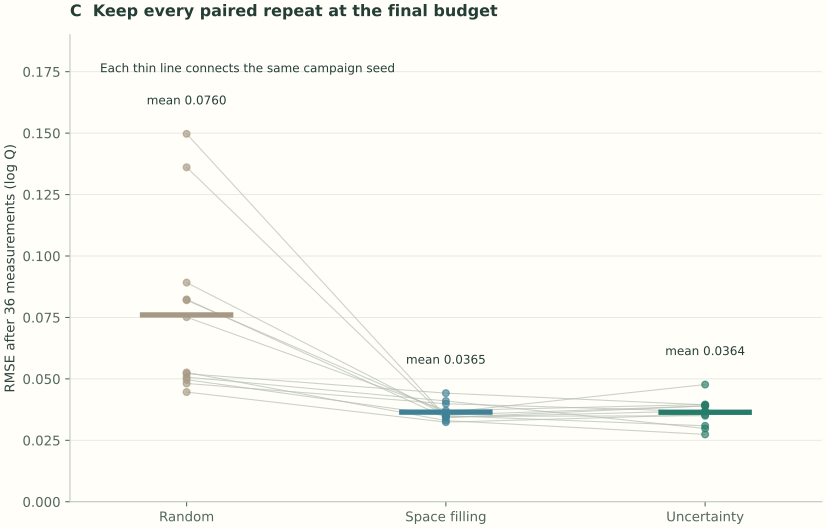
C|相同种子的三种结果连在一起,保留全部12轮;粗短横线为平均误差。
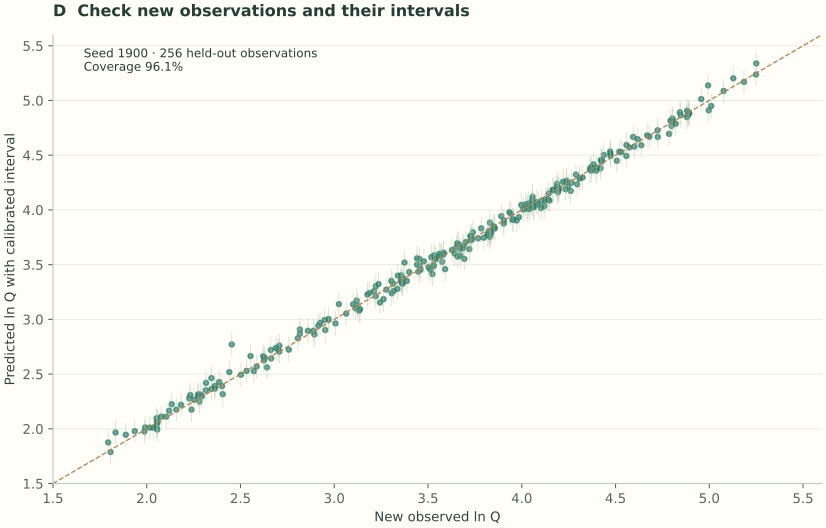
D|固定展示第一轮不确定性选样模型的256个新观察值与校准区间,虚线为预测等于观察。
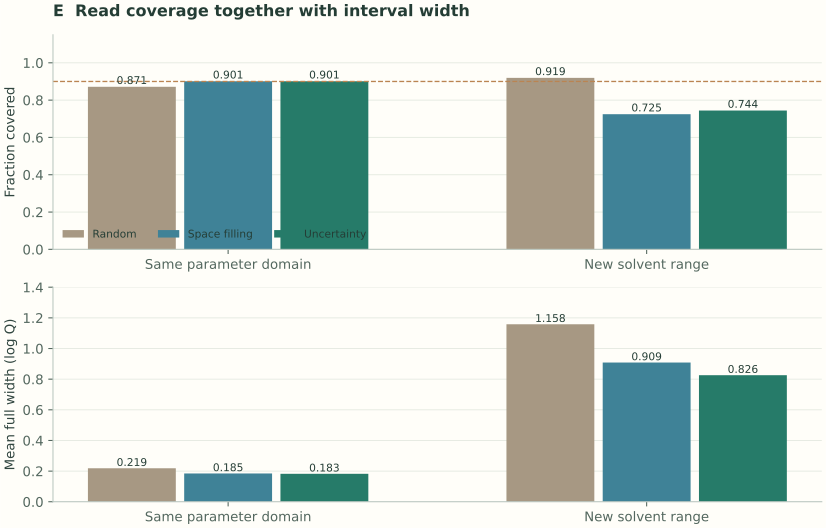
E|把区间覆盖率与平均全宽一起读;上方虚线为90%目标。参数域改变后,宽度和覆盖率也会改变。
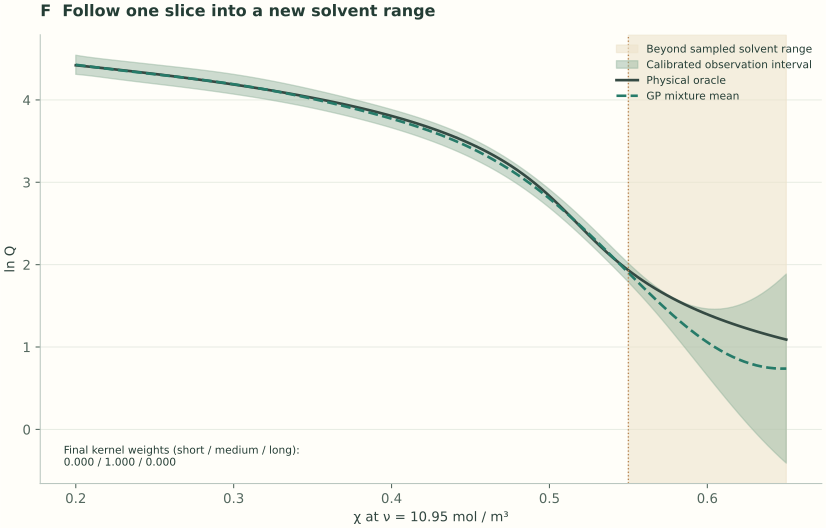
F|固定链密度,沿溶剂参数查看物理真值、模型均值和区间;浅色区超出已测范围,图内列出本轮三个核的最终权重。
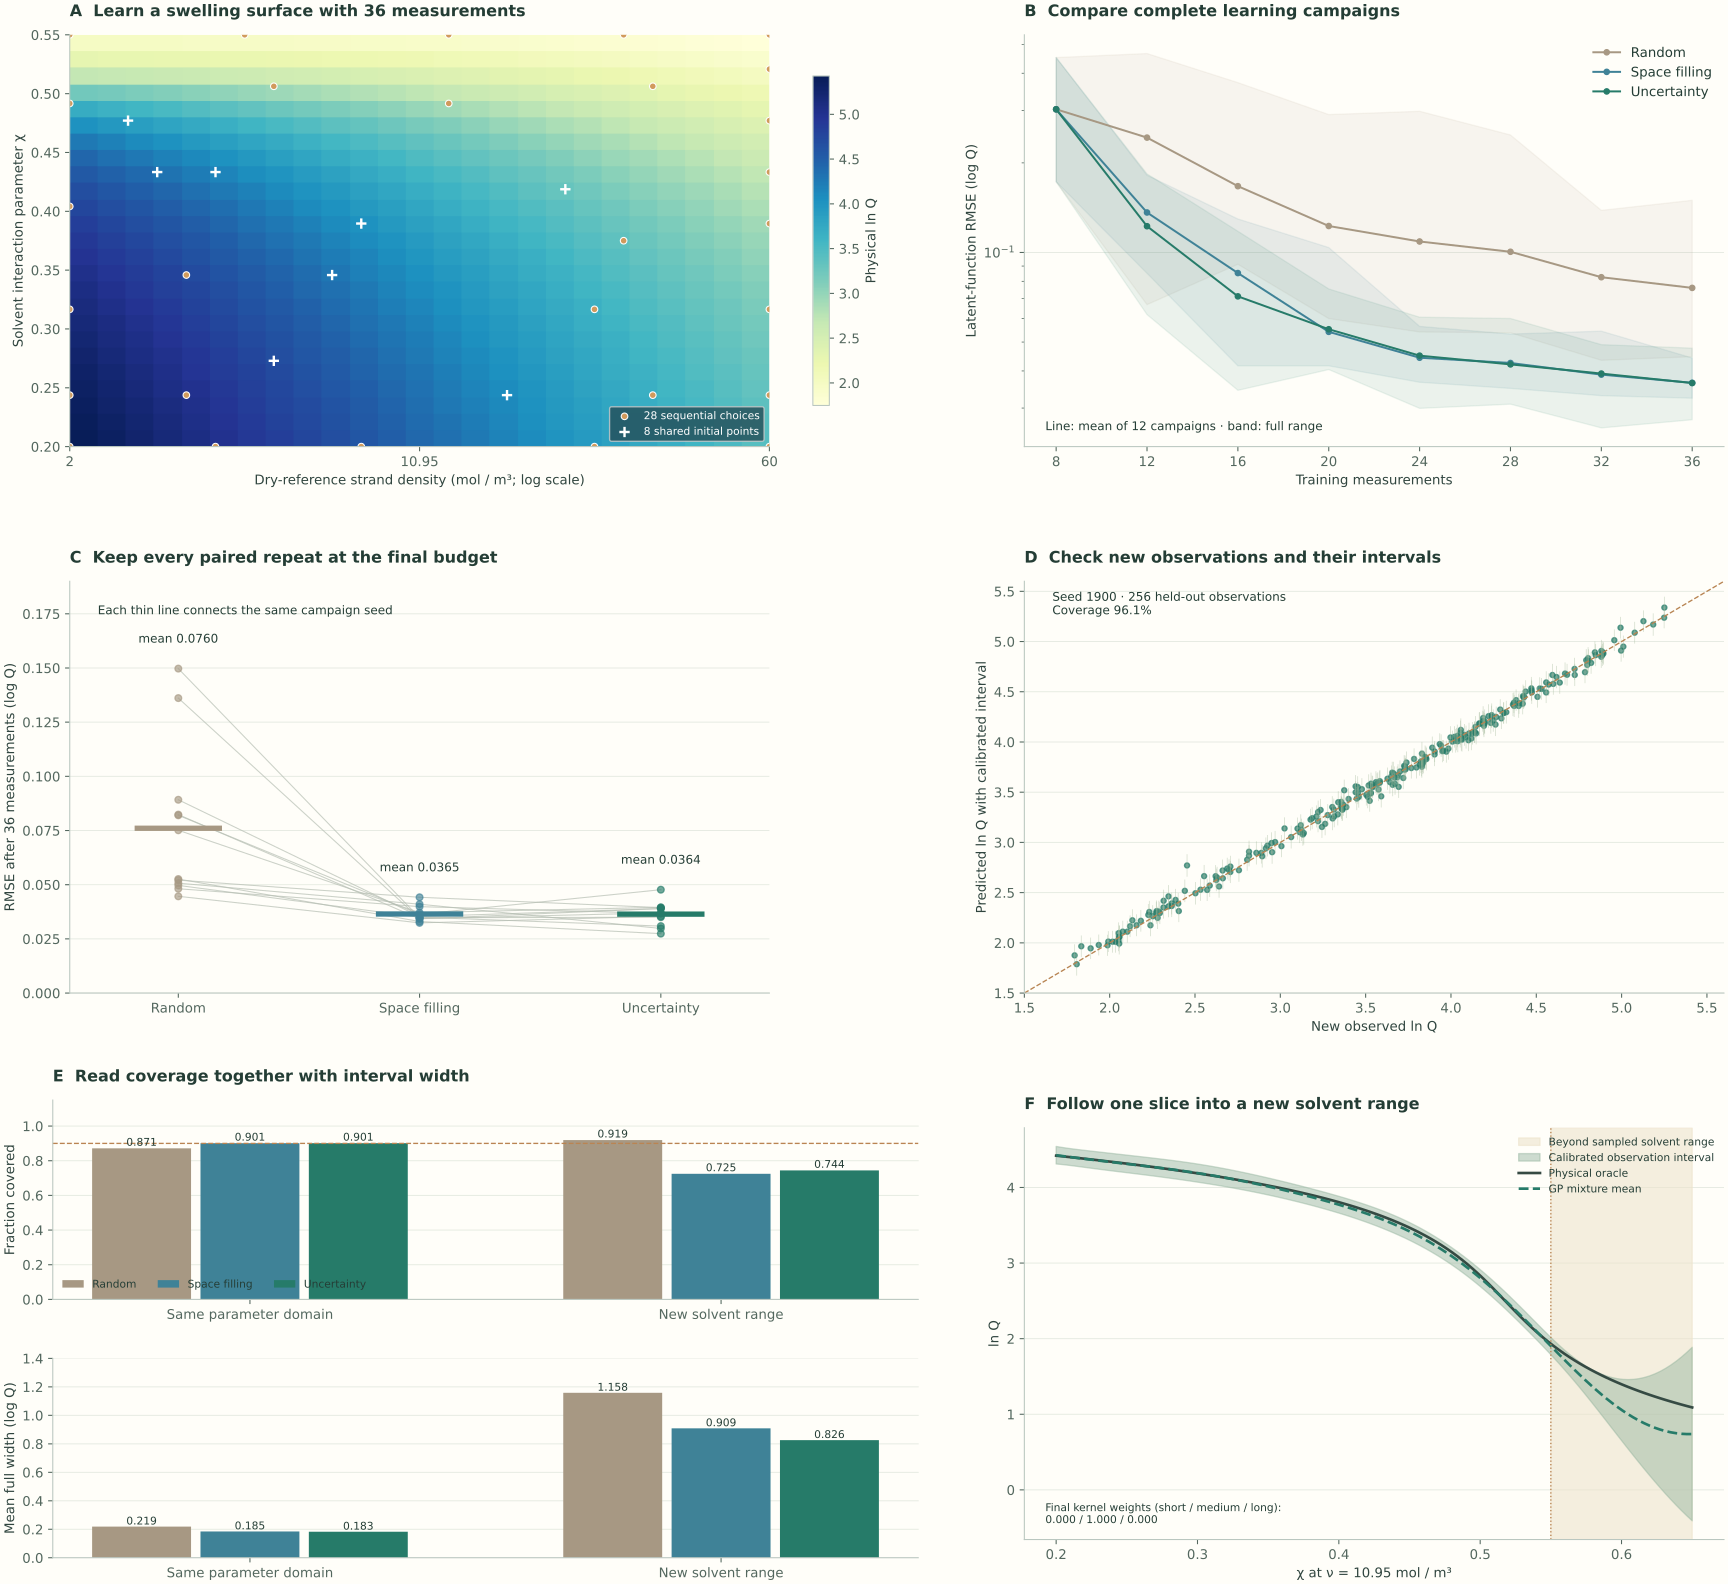
图A先展示整个虚拟溶胀曲面,再叠加第一轮不确定性策略实际选中的位置。白色十字是共享的8个起点,后续28个条件用圆点表示。模型选择了不少边缘位置,这是因为边缘缺少从另一侧传来的邻近信息,常保留较大方差。图里的底色供读者事后理解物理曲面,选样程序并没有把这张完整真值图当作输入。
图B将12轮实验放到一起看。横轴是用于拟合的测量数,纵轴是对独立测试条件的潜在函数预测误差;每条线表示12轮平均,浅色带表示其中最小到最大的范围。三种策略从完全相同的平均起点出发,随着测量增加,误差总体降低。个别轮次仍可能出现局部起伏,因为新增读数会改变预测和模型权重,测试误差并没有逐步单调下降的要求。
RMSE先将每个预测与物理真值的差平方,再平均和开方,因此对较大的偏差更敏感。下标f强调这里比较的是无噪声的平均函数,单位为ln Q的变化量。覆盖率则比较实际带噪读数y是否落在区间内,大括号里的条件成立记1,否则记0,最后求平均。由于虚拟实验同时保存了f与y,我们能够清楚地把“学到了多少规律”和“能否包住新读数”分别画出来。
36次训练测量以后,随机策略的平均RMSE约0.0760,空间覆盖约0.0365,不确定性策略约0.0364。后两者在本例中接近,均约为随机策略的一半。这个结果说明,在二维、相对平滑、测量成本相同的参数域里,有计划地覆盖空间已经能获得很好的效果;模型方差提供了另一种有明确概率含义的选择方式,可以随读数与模型权重更新。
图C保留全部12轮的最终误差,每条细线连接同一轮中的三种策略,便于按相同起始样本作成对比较。空间覆盖与不确定性策略的平均值相差约0.00006,各轮结果又互有高低;因此,选择实际方案时,应把注意力放到这种相近精度需要付出的代价上。比如比较计算与操作是否方便、各条件的测量费用怎样变化,以及候选配方能否连续调节。换到新的材料体系后,再用相同的成对设计重复比较,就能判断哪种安排更适合那组条件,而不是让平均值末位的差别替代研究决策。
图D放大第一轮不确定性策略对256个新观察值的预测。大多数点靠近对角线,竖线表示相应的校准区间;这轮的实际覆盖率约96.1%。图示轮次在运行前固定为种子1900,便于逐条追查,而整体表现仍应结合全部12轮查看。这样,一幅细节图负责帮助理解预测长什么样,跨轮次统计负责说明这次实验结果怎样波动。
图E同时展示覆盖率和区间全宽。在原输入范围中,空间覆盖与不确定性策略的平均覆盖率都约90.1%,平均全宽分别约0.185和0.183个对数单位;随机策略的平均覆盖率约87.1%,全宽约0.219。有限的12轮校准与测试会产生抽样波动,名义90%并不要求这12轮的平均值恰好达到某个固定数字。观察覆盖率时,还应当一起看样本数量与区间宽度。
进入新溶剂参数范围后,不确定性策略的平均覆盖率约74.4%,潜在函数RMSE约0.359;空间覆盖策略的覆盖率约72.5%,RMSE约0.365。随机策略在这一区域的覆盖率约91.9%,但它给出的区间也更宽,平均全宽约1.158,另外两种分别约0.909和0.826。较高覆盖率与较准确、较有用的预测需要一起评价,单看一根覆盖率柱子容易漏掉区间实际提供的信息量。
图F固定链密度,只沿χ方向观察一条截面。训练范围内,预测均值跟随物理曲线;越过χ=0.55以后,两者逐渐分开,区间也开始张开。这时可以提出具体的下一轮实验:在新溶剂范围安排覆盖点,保留重复测量,更新模型,再从同一新使用范围另取独立校准对象。原来的曲线帮助我们找到值得补测的地方,新读数则决定后续如何修正。
将这种方法用于蛋白质、核酸、多糖或复合凝胶时,可选择的对象不一定排成规则网格。它们可能是序列、分支结构或加工方案,第十八节介绍的图表示便能用于描述结构差异。选样规则仍然需要明确目标、可行候选与评价范围;不确定性的计算则可以结合适合该任务的概率模型或模型集成,再用独立实验检查。一个结构预测分数,只有进入清楚的数据收集安排,才真正开始影响研究的下一步。
本节已经完成了一次从物理问题到数据选择的全过程:定义溶胀读数,用有限测量建立预测,再用独立数据检查区间,并据结果提出下一轮补测。在《生物凝胶设计:物理反求与贝叶斯优化》,我们会把目标进一步具体化,要求候选凝胶同时满足给定的含水与力学条件。那时,模型除了帮助填补未知,还要参与搜索满足要求的条件,最后交回物理计算与实验计划逐项核对。
资料与延伸阅读
Flory与Rehner,1943,交联网络的溶胀;MacKay,1992,主动数据选择的信息目标;King等,2004,机器人科学家与实验选择;Rasmussen与Williams,2006,高斯过程回归;Nichol等,2010,GelMA的性质与细胞环境;Angelopoulos与Bates,共形预测入门。本节计算标签由正文给定的物理模型生成,原始论文用于历史背景、测量定义与方法依据。