让结构信息进入模型的每一步计算
图神经网络:分子连接的表示与性质预测
搭积木时,盒子里有哪些零件固然重要,零件怎样连接同样重要。相同数量的积木可以搭成桥,也可以围成一个框;相同组成的糖链,也可能因为连接位置和构型不同,表现出不同的分子识别。前面的章节已经用组成、局部结构特征和凝胶网络做过预测。本节把图神经网络的计算过程展开:先保存节点与连接,再让邻居交换信息,最后从整张图得到预测。我们会在真实糖链阵列数据上训练模型,并进一步讨论空间形状和物理对称性怎样帮助选择合适的表示。
01识别一种分子,需要把哪些信息交给模型
假设把两把钥匙放在秤上,它们的质量、材料和齿的数量都一样,却可能打不开同一把锁。原因在于齿的位置与排列也参与了配合。这个生活经验提供了一个很自然的研究问题:当我们用几个数字描述一个物体时,哪些影响作用的差别已经被保留下来,哪些差别在描述时消失了?模型能够利用的信息,首先取决于我们给它什么。
分子中的识别比金属钥匙复杂得多。接触部位的形状、氢键、电荷、溶剂以及分子本身的柔性都会参与相互作用。前面讲过,蛋白质的氨基酸顺序影响折叠,糖链的连接位置影响局部结构,核酸序列影响配对可能性。因此,选择输入特征时,可以沿着具体作用过程追问:模型需要区分的是组成、顺序、分支、空间接触,还是这些信息的组合?
Fischer在1894年研究糖构型对酶作用的影响时,就比较了不同糖苷与酶之间的反应差异,并用锁与钥匙的配合帮助解释分子几何的重要性。这个类比把抽象的构型问题变得可想象:改变一个局部的空间安排,可以改变分子之间接近和反应的方式。今天研究糖链识别时,仍然需要把这种局部差别写进数据,只是我们还会进一步考虑动态构象与环境。
本节沿用第十节的糖链阵列实验。阵列上呈现不同糖链探针,加入能够与糖链相互作用的凝集素CMA1,再通过荧光检测形成读数。这里研究的是结合与检测条件共同形成的实验响应;凝集素的结合任务与前面酶催化反应的任务各有定义,但两者都说明了分子识别对结构细节的敏感性。把问题收敛到同一实验体系,便于比较不同结构表示带来的变化。
先看一个只有两个残基的例子:Gal与GlcNAc。Gal表示半乳糖残基,GlcNAc表示N-乙酰葡糖胺残基。它们之间可以有不同的连接,写作Gal(β1-4)GlcNAc时,β说明供体端的异头构型,1和4说明相连的位点。把β改成α,或者把受体位置4改成3,组成计数仍然是一个Gal加一个GlcNAc,连接描述却已经改变。
如果模型的输入只有“Gal数量为1、GlcNAc数量为1”,这几种结构会被写成同一个向量。无论后面的模型有多少层,同一个确定输入都会得到相同预测。这个结论来自输入定义本身,不需要等待训练结果。要让模型有机会区分这些连接,先要把相应差别加入表示,再检验学到的预测是否与实验相符。
同一个原则也适用于高分子材料。一份表格可能记下单体比例,却没有记下它们是随机分布、交替排列还是形成嵌段;可能记下交联点数量,却没有区分这些连接是否形成有效贯通、悬垂支链或小环。第十三节的网络例子已经显示,连接数量接近的样品仍可能产生不同响应。科学知识帮助我们决定哪些结构差别值得保留,学习模型再从这些差别中寻找与目标相关的规律。
本节希望完成两种互相配合的检查。第一种是表示检查:改变连接类型以后,输入与预测是否有机会发生变化;仅仅改变编号以后,预测是否保持相同。第二种是实验预测检查:在没有参与训练的结构组上,误差究竟是多少。前一种检查帮助发现模型是否按预想使用了信息,后一种检查则需要真实标签与清楚的数据划分。接下来从图的存储方式开始,把这两种检查落实到计算中。
02把连接写成图,也把化学含义一起保存
这里的“图”指由节点和边组成的数学对象。节点可以代表一个原子、一个糖残基、一段粗粒化链,或者材料中的一个连接点;边说明所选节点之间有什么关系。像地铁图中站点与线路各有含义,分子图也需要先定义粒度。本节把一个单糖残基作为一个节点,把残基之间明确的糖苷连接作为边;这种粒度能够直接承接已经整理好的糖链结构。
V是节点的集合,E是边的集合,G是整张图。A称为邻接矩阵,可以把它看成一张“是否相连”的方格表:第i行、第j列为1,表示这两个节点相连;为0则表示没有这条连接。若三个节点依次连接成1—2—3,第1行只有第2列为1,第2行的第1、3列为1,第3行只有第2列为1。节点2有两个邻居,从这一行就能读出来。
这张0和1的表还没有保存全部化学含义。Gal与GlcNAc的区别放在节点特征中,α与β、供体与受体位置的区别放在边特征中。将这些信息分开存储有一个好处:连接关系可以保持相同,同时单独改变某一种特征,观察预测受到怎样的影响。代码中的无类型对照就沿用相同连接,只去掉边上的化学类型信息。
给残基种类编码时,本节使用独热向量。假设词表暂时只有Gal、GlcNAc和Fuc三种残基,可以分别写成[1,0,0]、[0,1,0]和[0,0,1]。数字1表示“属于这一类”,不是说Gal比另一种糖多一单位某种物理性质。网络的第一层会把这些类别向量变成可学习的内部表示,使不同种类在后续计算中以适合任务的方式参与组合。
完整例子的词表只从训练对象中建立,包含27种出现过的残基标签,再加一个未知类别。验证与测试里遇到新标签时,先映射到未知类别,并保留原来的结构记录。这样,程序能够清楚统计新结构带来了多少未见过的化学种类。后续扩展数据时,可以进一步把残基拆成糖骨架、修饰位置和电荷相关特征,让模型利用这些组成信息处理新的组合。
边特征采用15个数。前两个位置表示α或β,接着两个位置表示供体位点1或2,再接九个位置表示受体位点1到9,最后两个位置表示消息沿“子节点到父节点”还是反向流动。比如β1-4连接的相关位置就填入1,其余填0。这种拆分把连接的几个方面分别保存,也方便检查去掉哪一部分信息后,模型失去了什么区分能力。
一条化学连接在代码中会产生两条有向消息边,因为两个节点都需要读取对方的信息。消息方向服务于计算,也保留糖链朝向还原端的关系;它不表示真实分子里有某种物质在沿箭头单向流动。给化学结构加上计算用箭头以后,我们仍然可以清楚区分“原来有什么连接”和“网络这一轮怎样读取连接”。
Flory在1941年的三维聚合物统计研究中,从局部支化和连接机会出发讨论分子尺寸分布。第十三节已经借助这类思路认识凝胶形成;在这里,可以再向前看一步:局部联系怎样影响较远处能够到达的范围?图的邻居关系恰好把这个问题写得很直接。沿一条边走一步,看到近邻;再沿近邻的边继续走,就逐渐接触到更大的结构环境。
例如,从一条支链的末端出发,第一步只能看到与自己直接相连的残基,第二步才可能到达分支点,第三步才看到另一支链上的残基。网络层数与能够汇集的信息范围因此有关。对于非常长的链,只有几轮局部交换时,每个节点接收到的仍主要是附近结构;若目标明显依赖远距离联系,就需要相应增加信息通路、层次结构或全局特征。
还有一个很基础的要求:给节点重新编号,不能改变分子本身。假设把原来的1、2、3号改叫7、4、9号,只要残基身份和连接一起移动,仍然是同一张结构图。模型若因为输入文件的排列顺序不同而改变整图预测,就把存储习惯误当成了结构性质。用矩阵写,这个要求可以概括成下面的重排关系。
X的每一行保存一个节点的特征。P是置换矩阵,它的作用就是重新安排行的顺序;右上角T表示转置,把行列方向交换。邻接矩阵的行和列都对应节点,所以要同时重排,写成PAPT。边端点与边特征也随之调整。最后的f(G′)=f(G)说的是,整张图的标量预测保持相同。理解时只要抓住“所有与节点有关的记录同步搬家”,就能读懂这个式子的意思。
相反,真正改变连接位置或类型时,模型应当能够作出不同表示。重新编号和改变结构看起来都涉及修改一张表,却对应完全不同的科学操作。前者检验计算是否尊重同一对象的不同写法,后者检验表示是否保留了关心的结构差别。下面的交互演示会同时提供这两个操作,可以直接观察它们带来的不同结果。
03从邻居的消息,走到可以训练的整图预测
可以把每个节点想成一张不断更新的小卡片。起初只记自己的残基种类;交换一轮消息后,卡片还汇集直接邻居的种类和连接方式;第二轮再接收邻居更新过的卡片,就能间接获得两跳范围内的信息。卡片中的一串数字叫隐藏状态,也叫节点表示。训练时,模型调整计算这些数字的参数,让最终预测更贴近实验标签;单个数字通常没有预先规定的物理名称。解释模型时,可以先检查改变哪种连接会影响这些表示,再观察这种变化是否进入整图预测,而不是逐个把隐藏数值命名成一种材料性质。
Gilmer等在2017年提出的消息传递神经网络框架,把多种分子图学习方法概括为消息传递和读出两个阶段。先让节点按照连接交换信息,再把更新后的状态汇集为分子性质预测。这个框架便于比较不同实现:消息可以怎样计算,邻居信息怎样汇集,节点怎样更新,以及最终怎样得到整图输出,都是可以明确选择并检验的部分。
本节采用下面这一套计算。hj(t)表示第t层时节点j的状态,ej→i表示从j到i这条消息边的特征。先用两个权重矩阵分别处理邻居状态与边特征,再加一个偏置,通过tanh得到消息。接着,把所有邻居的消息相加,最后将这个总消息与节点自己的旧状态组合,产生下一层状态。
𝒩(i)表示节点i的邻居集合,求和符号说明把这些邻居逐个发来的消息加起来。Ws处理发送者状态,We处理连接特征,Wh处理自己的旧状态,Wa处理汇总消息;b是相应偏置。上标t说明不同层可以有不同参数。完整程序中每个节点有32个状态数值,消息也有32个数,因此求和与更新在相同维度中进行。
tanh是一个平滑函数,输入接近零时变化较明显,输入很大或很小时逐渐接近1或−1。它使多层组合能够表达非线性关系,同时让本例的节点状态保持在有限范围。比如tanh(0.3)约为0.2913,tanh(0.5)约为0.4621。读代码时可以把它理解成“先把几项信息相加,再经过一个平滑的弯曲变换”。
先缩成一个数来手算。设当前节点状态为0.4,两个邻居状态分别为0.2和0.6;第一条边特征为1,第二条为0。消息规则暂取tanh(0.5×邻居状态+0.2×边特征),两个邻居发来的消息都为tanh(0.3),约0.2913。相加得到0.5826,再用tanh(0.5×旧状态+0.25×消息总和)更新,得到tanh(0.34565),约0.3325。每一步都能对应到上面公式中的一项。
所有节点在同一层使用相同的权重,是图网络的重要安排。像一套阅读连接关系的规则,在不同位置重复使用;它学到“这一类邻居通过这一类连接出现时怎样组合信息”,就有机会把规则应用到新的结构位置。参数共享也减少了需要逐节点记忆的内容,使不同大小的图能够使用同一个模型。
更新时还要同时读取旧状态。假设先算节点1,再算节点2,若节点2立刻使用节点1刚更新的数值,就会引入人为遍历顺序。本节每一层先保存全部旧状态,计算所有消息,再统一得到下一层状态。邻居的求和也不依赖谁先排在列表中,所以节点重编号以后,状态只会跟着节点一起重排,最后的整图汇总保持相同。
站在一个节点上,看信息怎样一轮轮传来
初始状态:Gal为0.2,GlcNAc为0.6,Fuc为0.4。消息为tanh(0.5×邻居状态+0.2×连接特征),新状态为tanh(0.5×旧状态+0.25×消息之和);β特征为1,α为0。
先把传递轮数设为0,看到的就是五种位置上的初始状态。逐渐增加到1、2、3轮,观察不同节点怎样因为邻居不同而分化。再切换右上连接的α/β:使用边特征时,改变会从相邻节点开始影响后续状态;关闭α/β特征以后,这项改动不再进入计算。最后重新编号,节点上的数字标签换了,整图平均状态保持相同。
实际网络的32维计算沿用这个过程,只是每张卡片更丰富,权重也由数据学习。三层以后,需要把不同大小的图汇集成一个固定长度的输入。本节同时使用节点状态的平均与总和:平均描述常见局部环境,总和还携带节点数量及各类环境出现次数的信息。再拼上实验展示方式的标记,便得到整图表示zG。
方括号中的分号表示拼接,不是把这些向量直接相加。32维平均加32维总和,再加两维展示特征,共66个数。两维展示特征cG表示记录中明确标出的AO展示形式与其他形式,并乘以0.25;它作为实验条件信息,所有学习模型都可以使用。读出层先把66维变成32维,再得到一个标准化输出,最后用训练目标均值μy和标准差sy还原数值尺度。
为什么把平均与总和都留下?若某个状态分量在3个节点上分别为0.2、0.4、0.6,平均是0.4,总和是1.2;再复制一组相同局部环境,平均仍为0.4,总和变成2.4。对某些性质,局部环境的比例更重要;对另一些性质,数量也会参与。让读出层同时接收这两种汇总,能够在明确保留规模信息的前提下学习它们与目标的关系。
训练从预测与实验标签之间的差开始。给定一张图,网络按照当前权重算出预测,和对应目标相减、平方,再在训练记录中取平均。反向传播根据链式法则,计算每个参数怎样影响这笔误差。下面第二行用最基础的梯度下降说明方向:若增加某个参数会让损失增大,就朝相反方向调整;完整代码使用Adam,根据梯度历史进一步调整各参数的步长。
𝓛是损失,Ntrain是训练记录数,ϑ表示任意一个可学习参数,η是学习率。带波浪号的目标表示已经标准化,帽子表示预测。以最简单的预测ŷ=ϑx为例,只有一条记录x=2、目标为1,当前ϑ=0.2,则预测0.4,平方误差0.36;损失对ϑ的导数为2×(0.4−1)×2=−2.4。若学习率为0.1,更新后的ϑ=0.44,下一次预测变为0.88,误差明显减小。
图网络只是把这条计算链延长了:一个权重可能影响某些消息,消息改变节点状态,状态经过读出产生预测,预测再影响损失。程序为每个参数自动求导,也可以用一个小检查核对:把参数增加和减少一个很小的量,分别计算损失,用两次差值估计斜率。本例对嵌入、消息、更新和读出中的参数作了这样的核查,确保学习步骤与写出的计算关系一致。
04连接之外,还需要哪些几何信息与评价条件
到这里,图已经保存了残基身份、连接位置和异头构型,却还没有保存所有节点在空间中的坐标。可以用一条三颗珠子的链说明区别:两段连接长度都为1纳米,把它摆直,或者把中间关节弯成直角,连接表完全相同,各点到中心的分布却发生了变化。第二节讨论过同一条链需要许多构象;图表示与空间构象也需要在这里接起来。
ri是第i个节点的空间位置,dij是两点之间的距离,双竖线表示向量的长度。等权点的回转半径还可以通过所有点对距离计算:把dij²对i和j全部求和,再除以2N²。这个关系可以通过展开两个位置差的平方得到,其中关于中心的交叉项相互抵消。它提供了一个有用的连接:只要有足够的相对距离信息,就能够计算这个整体尺度。
三颗珠子摆直时,三对不同珠子的距离是1、1和2纳米。公式对i、j都求和,所以每对会算两次,得到Rg²=2×(1+1+4)/(2×9)=2/3,Rg约0.816纳米。弯成直角后,距离变成1、1和√2,Rg²=4/9,Rg=2/3纳米。两段键长与化学连接相同,非邻居之间的距离改变了整体形状。
因此,预测明显依赖构象的性质时,可以让图模型同时读取空间距离、角度或经过定义的接触关系。构建空间邻居也要说明规则:是在一定距离以内连接,还是把所有点对都提供给模型?一个蛋白质的序列近邻与空间接触近邻通常不同,折叠可以把序列上很远的残基放到一起。把两类边分别标记,能够让模型同时利用链上连接和空间接触。
坐标还带来一个新的要求。把整个分子在桌面上平移,或者转一个方向,它的回转半径和内部能量不应因为坐标原点或朝向改变。若预测的是某个原子受到的力,力的数值大小可以保持相同,方向却应该随着分子一起旋转。前一种称为不变性,后一种称为等变性。它们都在要求模型正确处理同一个物体的不同观察方式。
这里Q表示一个正常旋转,t表示整体平移,花括号表示全部节点的位置。第一行说,标量输出f在变换以后保持相同;第二行说,向量输出Fi要随Q一起旋转。可以想象一支箭头画在玩具分子上:转动玩具以后,箭头也转过去,而尺子量出的分子尺寸保持原值。用这种关系组织模型,可以减少它从数据中重新学习坐标约定的负担。
Satorras等在2021年的E(n)等变图网络研究展示了一种实现方式:消息利用相对距离等标量,坐标更新则沿相对位置向量的加权和进行。距离在整体旋转下不变,相对位置向量会随旋转改变方向,因而两者分别承担适合的角色。本节的阵列数据只有明确的连接结构,学习实验据此使用连接图;后续接入可信构象时,可以沿这个方向加入几何计算。
镜像需要再多想一步。左手和右手之间,许多对应点的距离相同,却不能仅靠正常旋转完全重合。具有手性的生物环境可能对两种镜像结构产生不同作用,所以不能只因距离相同,就把所有生物性质都规定为相同。代码用四个带固定身份的空间点检查:旋转、平移与反射都保持成对距离,反射却改变有向体积的符号。这个符号记录了点的空间定向,也提示我们根据任务保留手性信息。
从几何回到实验,本节预测的标签是CMA1阵列的相对荧光读数RFU。为处理较宽的数值范围,先取下面的自然对数变换。分母1 RFU提供参考单位,使对数内部没有单位;加1让原表报告的零读数也可以进入计算。读数0被映射为0,读数99被映射为ln 100,约4.605。之后再用训练组均值和标准差标准化,便于神经网络优化。
RFU对应特定的探针展示、蛋白浓度、孵育和检测条件。这里沿用同一份CMA1实验,保留原表的零与正读数,学习目标也始终是这个实验响应。403条符合结构与单次展示筛选条件的记录中,86条为正读数,其余317条报告为0。了解这种分布很重要,因为一个偏向预测较小值的模型,可能在许多记录上误差较小,却错过少数较强的响应。
数据仍按第十节的组成组划分:相同残基组成的结构归到同一组,265组分成159组训练、53组验证和53组测试,对应258、81和64条记录。这样,测试对象的整组组成没有参与训练。相似的局部片段仍可能在不同组中出现,这正是模型可以学习并迁移的结构信息。若研究目标进一步要求推广到全新糖链骨架或另一种凝集素,还需要另外按相应结构族或蛋白对象划分评价。
这份数据划分已经用于前面的表示比较,本节继续沿用它,便于核对新模型带来了什么变化。三个神经网络版本分别只读取节点、不读取边的化学类型、以及读取完整边类型;每个版本训练三个随机种子,最多240轮,学习率0.003,权重衰减为0.0001。每5轮根据验证组成组等权RMSE选择保存状态,模型与训练设置保持固定,再统一报告测试结果。
节点模型保留三层逐节点计算,却不交换邻居消息;另两个模型使用相同的三层消息框架,无类型版本把13个化学边特征置零,保留两维方向信息。这样既有组成层面的非线性参照,也有去掉连接类型的直接对照。按实际参与预测的参数计算,三种版本分别有6273、12705和13953个参数,计算量也有所差别;共同的训练轮数、数据与选择规则使比较条件清楚可查。
Burkholz等在2021年提出的SweetNet,将图表示用于糖链相关的生物预测任务,显式保留糖链的分支结构。原方法把单糖与连接都作为节点,本节则把连接类型放在边上。两种安排体现了同一个设计问题:怎样把重要的生物结构信息变成模型能够读取的对象。节点、边与特征的定义需要服从研究问题,也需要在实际数据上检验。
05运行完整GNN,再把预测放回实验问题中
下面的完整程序从公开原始工作簿开始,重新解析糖链并复现第十节的数据筛选与基线,随后训练九个神经网络。源文件约90千字节,首次运行下载,之后核对本地文件的校验值。训练后保存节点词表、分组、模型权重、每个种子的结果和全部预测,并绘制六幅图。几何例子也由同一程序直接计算,因此结构、学习与物理检查都能追溯到具体数值。
可以沿着pack、GraphModel和graph_predict三个位置阅读代码。pack把不同大小的图拼成一批记录,同时保存每个节点属于哪张图;GraphModel按照公式完成消息与读出;graph_predict载入保存的三组权重,给新输入产生平均预测。批量处理时,边始终连接同一张图内部的节点,汇总时再按图的编号分别求和,因而多张样品可以共同计算而不交换彼此的信息。
"""L18: train message-passing models on published CMA1 glycan-array records.
Install: python -m pip install numpy scipy matplotlib openpyxl requests torch
Data: Lundstrøm et al. (2024), doi:10.3762/bjoc.20.31, CC BY 4.0.
The 403-row cohort is selected by structure and presentation occurrence, not RFU.
"""
from pathlib import Path
from collections import Counter
import hashlib
import json
import re
import io
import requests
import openpyxl
import numpy as np
from scipy.stats import spearmanr
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

OUT=Path('graph_outputs');OUT.mkdir(exist_ok=True)
URL='https://www.beilstein-journals.org/bjoc/content/supplementary/1860-5397-20-31-S1.xlsx'
SHA='403d65ebe15cef6d05a92fa0a231fb81ea681fcdd2184a65b526ce3bf40e391a'
cache=OUT/'cma1_arrays.xlsx'
if not cache.exists():
    response=requests.get(URL,timeout=60);response.raise_for_status()
    cache.write_bytes(response.content)
raw=cache.read_bytes()
assert hashlib.sha256(raw).hexdigest()==SHA,'Source file differs from the published example'
book=openpyxl.load_workbook(io.BytesIO(raw),read_only=True,data_only=True)
values=list(book['imperial'].values);headers=values[0]
source_rows=[dict(zip(headers,row)) for row in values[1:]]
book.close()

BASES=['GlcNAc','GalNAc','Neu5Ac','Neu5Gc','GlcNS','GlcN','GlcA','IdoA','GalA','ManA','GulA','ManNAc','Glc','Gal','Man','Fuc','Xyl','Ara','Rha','Fru']
MONOMER=re.compile('(?:'+'|'.join(sorted(BASES,key=len,reverse=True))+r')(?:[1-9][SP])*$')

def parse(sequence):
    # Exact token coverage: no silent stripping of placeholders or unknown linkages.
    tokens=re.findall(r'\[|\]|\([ab][12]-[1-9]\)|[A-Za-z0-9]+',sequence)
    if ''.join(tokens)!=sequence:raise ValueError('unsupported_or_incomplete_notation')
    nodes=[];edges=[];pos=len(tokens)-1
    def chain(parent=None,branch=False):
        nonlocal pos
        current=parent;first=None
        while pos>=0 and tokens[pos]!='[':
            token=tokens[pos]
            if token==']':
                if current is None:raise ValueError('branch_without_parent')
                pos-=1;chain(current,True)
                if pos<0 or tokens[pos]!='[':raise ValueError('unbalanced_branch')
                pos-=1;continue
            if token.startswith('('):
                if current is None:raise ValueError('dangling_link')
                link=token[1:-1];pos-=1
                if pos<0 or not MONOMER.fullmatch(tokens[pos]):raise ValueError('unknown_residue')
                node=len(nodes);nodes.append(tokens[pos]);edges.append({'child':node,'parent':current,'link':link})
                current=node;pos-=1
            else:
                if current is not None or not MONOMER.fullmatch(token):raise ValueError('unknown_residue_or_missing_link')
                current=len(nodes);nodes.append(token);pos-=1
            if first is None:first=current
        return first
    root=chain()
    if pos!=-1 or not nodes or len(edges)!=len(nodes)-1:raise ValueError('not_a_complete_tree')
    children={i:[] for i in range(len(nodes))}
    for e in edges:children[e['parent']].append((e['link'],e['child']))
    for values in children.values():
        acceptor=[link.split('-')[1] for link,_ in values]
        if len(acceptor)!=len(set(acceptor)):raise ValueError('duplicate_acceptor_site')
    def canonical(i):return nodes[i]+'{'+','.join(link+':'+canonical(c) for link,c in sorted(children[i],key=lambda q:(q[0],canonical(q[1]))))+'}'
    return {'nodes':nodes,'edges':edges,'root':root,'canonical':canonical(root)}


accepted=[];excluded=[]
for index,row in enumerate(source_rows):
    try: accepted.append(row|{'row':index+2,'graph':parse(row['glycan'])})
    except ValueError as error:
        excluded.append({'row':index+2,'reason':str(error),'glycan':row['glycan']})
parsed={'accepted':accepted,'excluded':excluded}
assert len(source_rows)==866 and len(accepted)==649
counts=Counter(r['graph']['canonical'] for r in parsed['accepted'])
rows=[r for r in parsed['accepted'] if counts[r['graph']['canonical']]==1]
rows.sort(key=lambda r:r['graph']['canonical'])
families=sorted({json.dumps(sorted(Counter(r['graph']['nodes']).items())) for r in rows})
order=np.random.default_rng(1010).permutation(len(families))
partition={families[int(j)]:('train' if i<int(.6*len(order)) else 'validation' if i<int(.8*len(order)) else 'test') for i,j in enumerate(order)}
for r in rows:
    r['composition_group']=json.dumps(sorted(Counter(r['graph']['nodes']).items()))
    r['split']=partition[r['composition_group']]
    r['AO_label']=int(bool(re.search(r'[-.]AO(?:\b|\*)',r['original_notation'])))
    r['id']=f"ICL-{r['row']:04d}"
groups={s:np.array([i for i,r in enumerate(rows) if r['split']==s]) for s in ['train','validation','test']}
y=np.log1p([r['RFU'] for r in rows]);tr,va,te=[groups[s] for s in groups]

def descriptors(graph,depth,typed=True):
    labels=list(graph['nodes']);out=Counter('0:'+x for x in labels)
    adjacency=[[] for _ in labels]
    for edge in graph['edges']:
        i,j=edge['child'],edge['parent'];link=edge['link'] if typed else '*'
        adjacency[i].append(('to-parent:'+link,j));adjacency[j].append(('to-child:'+link,i))
    for level in range(1,depth+1):
        labels=[json.dumps([labels[i],sorted((edge,labels[j]) for edge,j in neighbors)],separators=(',',':'))
                for i,neighbors in enumerate(adjacency)]
        out.update(str(level)+':'+label for label in labels)
    return dict(out)

def matrix(dicts):
    # Feature vocabulary from training structures only; unseen motifs contribute zero.
    vocabulary=sorted({k for i in tr for k in dicts[i]});index={k:j for j,k in enumerate(vocabulary)}
    x=np.zeros((len(dicts),len(vocabulary)),dtype=float)
    for i,d in enumerate(dicts):
        for key,value in d.items():
            if key in index:x[i,index[key]]=value
    # Include unseen motif counts in the norm: they are orthogonal features,
    # not a reason to inflate the similarity of the remaining known motifs.
    norm=np.array([np.sqrt(sum(v*v for v in d.values())) for d in dicts])[:,None]
    x=np.divide(x,norm,out=np.zeros_like(x),where=norm>0)
    # Observed AO notation is an assay-presentation covariate, shared by every learned model.
    presentation=np.array([[int(r['AO_label']==0),r['AO_label']] for r in rows],float)
    return np.hstack([x,.25*presentation]),vocabulary

def metrics(pred,indices):
    loss=(pred[indices]-y[indices])**2
    unique=sorted({rows[i]['composition_group'] for i in indices})
    per=[float(np.mean([loss[j] for j,i in enumerate(indices) if rows[i]['composition_group']==f])) for f in unique]
    return {'RMSE_log':float(np.sqrt(loss.mean())),'MAE_log':float(np.mean(abs(pred[indices]-y[indices]))),
            'R2_log':float(1-loss.sum()/np.sum((y[indices]-y[indices].mean())**2)),
            'group_equal_RMSE_log':float(np.sqrt(np.mean(per))),
            'spearman':float(spearmanr(pred[indices],y[indices]).statistic) if np.std(pred[indices])>1e-12 else None}

predictions={'train_mean':np.full(len(rows),y[tr].mean())};models={}
for name,depths,typed in [('composition',[0],True),('untyped_graph',[1,2],False),('typed_graph',[1,2],True)]:
    mean=float(y[tr].mean());choices=[];best=None
    for depth in depths:
        dictionaries=[descriptors(r['graph'],depth,typed) for r in rows];x,vocabulary=matrix(dictionaries)
        kernel=x@x.T
        for reg in [1e-4,1e-3,.01,.1,1.,10.]:
            alpha=np.linalg.solve(kernel[np.ix_(tr,tr)]+reg*np.eye(len(tr)),y[tr]-mean)
            prediction=mean+kernel[:,tr]@alpha
            value=metrics(prediction,va)['group_equal_RMSE_log']
            choices.append({'depth':depth,'regularization':reg,'validation_group_RMSE':value})
            if best is None or value<best[0]:best=(value,reg,alpha,prediction,depth,x,vocabulary)
    value,reg,alpha,prediction,depth,x,vocabulary=best;predictions[name]=prediction
    models[name]={'depth':depth,'typed_edges':typed,'vocabulary':vocabulary,'alpha':alpha.tolist(),
        'train_mean':mean,'selected_regularization':reg,'choices':choices,'features':x.tolist()}
    print('baseline',name,'lambda',reg,'validation',round(value,3),flush=True)
results={'data_source_doi':'10.3762/bjoc.20.31','source_sheet':'imperial','source_sha256':'403d65ebe15cef6d05a92fa0a231fb81ea681fcdd2184a65b526ce3bf40e391a',
 'selection':'Explicit parsed glycan tree with one occurrence among the structurally eligible source rows; no response-based selection',
 'rows':len(rows),'composition_groups':len(families),'split_seed':1010,
 'split':{s:{'indices':ids.tolist(),'rows':len(ids),'groups':len({rows[i]['composition_group'] for i in ids}),
             'positive_reported_RFU':sum(rows[i]['RFU']>0 for i in ids)} for s,ids in groups.items()},
 'transform':'natural_log(1+RFU/1RFU)','models':models,'test_metrics':{k:metrics(p,te) for k,p in predictions.items()}}


# Learn messages on the same glycan records and split used above.
import copy
import torch
from torch import nn
torch.set_num_threads(2)
torch.use_deterministic_algorithms(True)
vocabulary=['<UNK>']+sorted({token for i in tr for token in rows[i]['graph']['nodes']})
node_index={v:i for i,v in enumerate(vocabulary)}
target_mean=float(y[tr].mean());target_scale=float(y[tr].std())
def pack(graphs,ao):
    types=[];send=[];receive=[];edge_features=[];membership=[];offset=0
    for k,g in enumerate(graphs):
        types.extend(node_index.get(t,0) for t in g['nodes']);membership.extend([k]*len(g['nodes']))
        for e in g['edges']:
            link=e['link'];anomer=0 if link[0]=='a' else 1;donor=int(link[1])-1;acceptor=int(link[3:])-1
            for direction,(a,b) in enumerate([(e['child'],e['parent']),(e['parent'],e['child'])]):
                f=np.zeros(15);f[anomer]=1;f[2+donor]=1;f[4+acceptor]=1;f[13+direction]=1
                send.append(offset+a);receive.append(offset+b);edge_features.append(f)
        offset+=len(g['nodes'])
    return dict(x=torch.eye(len(vocabulary))[types],sender=torch.tensor(send,dtype=torch.long),
        receiver=torch.tensor(receive,dtype=torch.long),edge=torch.tensor(np.array(edge_features).reshape(-1,15),dtype=torch.float32),
        group=torch.tensor(membership,dtype=torch.long),size=torch.tensor([len(g['nodes']) for g in graphs],dtype=torch.float32),
        ao=.25*torch.tensor([[1-a,a] for a in ao],dtype=torch.float32))
graphs=[r['graph'] for r in rows];ao=[r['AO_label'] for r in rows]
packed={s:pack([graphs[i] for i in ids],[ao[i] for i in ids]) for s,ids in groups.items()};all_graphs=pack(graphs,ao)
class GraphModel(nn.Module):
    def __init__(self,mode):
        super().__init__();self.mode=mode;self.embed=nn.Linear(len(vocabulary),32)
        self.sender=nn.ModuleList([nn.Linear(32,32,bias=False) for _ in range(3)])
        self.edge=nn.ModuleList([nn.Linear(15,32) for _ in range(3)])
        self.self_update=nn.ModuleList([nn.Linear(32,32) for _ in range(3)])
        self.aggregate=nn.ModuleList([nn.Linear(32,32,bias=False) for _ in range(3)])
        self.readout=nn.Sequential(nn.Linear(66,32),nn.Tanh(),nn.Linear(32,1))
    def forward(self,data):
        h=torch.tanh(self.embed(data['x']));e=data['edge']
        if self.mode=='untyped':e=torch.cat([torch.zeros_like(e[:,:13]),e[:,13:]],dim=1)
        for k in range(3):
            if self.mode=='bag':h=torch.tanh(self.self_update[k](h))
            else:
                message=torch.tanh(self.sender[k](h[data['sender']])+self.edge[k](e))
                total=torch.zeros_like(h).index_add(0,data['receiver'],message)
                h=torch.tanh(self.self_update[k](h)+self.aggregate[k](total))
        pooled=torch.zeros((len(data['size']),32),dtype=h.dtype).index_add(0,data['group'],h)
        out=torch.cat([pooled/data['size'][:,None],pooled,data['ao']],dim=1)
        return self.readout(out).squeeze(-1)
gnn_models={};gnn_curves={};seed_metrics={};gnn_predictions={}
validation_groups=sorted({rows[i]['composition_group'] for i in va})
vgroup=[np.array([j for j,i in enumerate(va) if rows[i]['composition_group']==g]) for g in validation_groups]
train_target=torch.tensor((y[tr]-target_mean)/target_scale,dtype=torch.float32)
for mode in ['bag','untyped','typed']:
    saved=[];histories=[];outputs=[];individual=[]
    for seed in [18,28,38]:
        torch.manual_seed(seed);model=GraphModel(mode);opt=torch.optim.Adam(model.parameters(),lr=.003,weight_decay=1e-4)
        best=float('inf');best_epoch=0;best_state=None;history=[]
        for epoch in range(1,241):
            model.train();opt.zero_grad();loss=((model(packed['train'])-train_target)**2).mean();loss.backward();opt.step()
            if epoch%5==0:
                model.eval()
                with torch.no_grad():vp=model(packed['validation']).numpy()*target_scale+target_mean
                vl=float(np.sqrt(np.mean([np.mean((vp[g]-y[va][g])**2) for g in vgroup])))
                history.append([epoch,float(loss.detach()),vl])
                if vl<best:best=vl;best_epoch=epoch;best_state=copy.deepcopy(model.state_dict())
        model.load_state_dict(best_state);model.eval()
        with torch.no_grad():prediction=model(all_graphs).numpy()*target_scale+target_mean
        active=sum(p.numel() for name,p in model.named_parameters() if mode!='bag' or not name.startswith(('sender.','edge.','aggregate.')))
        if mode=='untyped':active-=3*32*13  # Zero chemical-edge columns never affect a prediction.
        saved.append(dict(seed=seed,epoch=best_epoch,validation_group_RMSE=best,allocated_parameters=sum(p.numel() for p in model.parameters()),active_parameters=active,
            weights={k:v.tolist() for k,v in best_state.items()}))
        histories.append(history);outputs.append(prediction);individual.append(metrics(prediction,te))
        print('GNN',mode,'seed',seed,'epoch',best_epoch,'validation_group_RMSE',round(best,4),flush=True)
    gnn_models[mode]=saved;gnn_curves[mode]=histories;seed_metrics[mode]=individual;gnn_predictions[mode]=outputs
    predictions['gnn_'+mode]=np.mean(outputs,axis=0)
def graph_predict(mode,graphs,ao):
    data=pack(graphs,ao);out=[]
    for item in gnn_models[mode]:
        model=GraphModel(mode);model.load_state_dict({k:torch.tensor(v) for k,v in item['weights'].items()});model.eval()
        with torch.no_grad():out.append(model(data).numpy()*target_scale+target_mean)
    return np.mean(out,axis=0)
toy_names=['Gal(a1-3)GlcNAc','Gal(b1-3)GlcNAc','Gal(a1-4)GlcNAc','Gal(b1-4)GlcNAc']
toy_graphs=[parse(s) for s in toy_names]
toy_predictions={mode:graph_predict(mode,toy_graphs,[0]*4).tolist() for mode in gnn_models}
assert np.ptp(toy_predictions['bag'])<1e-6 and np.ptp(toy_predictions['untyped'])<1e-6
def geometry(x):
    x=np.array(x,float);d=np.linalg.norm(x[:,None]-x[None,:],axis=-1)
    return dict(points=x.tolist(),distances=d.tolist(),Rg=float(np.sqrt(np.mean(np.sum((x-x.mean(0))**2,axis=1)))),
        signed_volume=float(np.linalg.det((x[1:]-x[0]).T)/6) if len(x)==4 else None)
straight=geometry([[0,0,0],[1,0,0],[2,0,0]]);bent=geometry([[0,0,0],[1,0,0],[1,1,0]])
x=np.array([[0,0,0],[1,0,0],[.2,1.1,0],[.1,.3,.8]])
theta=.7;rotation=np.array([[np.cos(theta),-np.sin(theta),0],[np.sin(theta),np.cos(theta),0],[0,0,1]])
spatial={name:geometry(v) for name,v in dict(original=x,rotated_translated=x@rotation.T+[3,-2,.4],reflected=x*[-1,1,1]).items()}
results.update(gnn=dict(vocabulary=vocabulary,target_mean=target_mean,target_scale=target_scale,models=gnn_models,
    training_curves=gnn_curves,seed_test_metrics=seed_metrics,unknown_nodes={s:sum(t not in node_index for i in ids for t in graphs[i]['nodes']) for s,ids in groups.items()},
    toy_names=toy_names,toy_predictions=toy_predictions),geometry=dict(straight=straight,bent=bent,rigid=spatial),
    test_metrics={k:metrics(p,te) for k,p in predictions.items()},validation_metrics={k:metrics(p,va) for k,p in predictions.items()})
samples={'rows':[dict(id=r['id'],source_row=r['row'],glycan=r['glycan'],graph=r['graph'],RFU=r['RFU'],
    log_RFU=float(y[i]),AO_label=r['AO_label'],composition_group=r['composition_group'],split=r['split'],
    predictions={k:float(v[i]) for k,v in predictions.items()}) for i,r in enumerate(rows)],'source_doi':'10.3762/bjoc.20.31','license':'CC BY 4.0'}
(OUT/'results.json').write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
(OUT/'samples.json').write_text(json.dumps(samples,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
np.savez_compressed(OUT/'predictions.npz',target=y,**predictions,**{'seeds_'+k:np.array(v) for k,v in gnn_predictions.items()})
for name,p in predictions.items():print(name,metrics(p,te),flush=True)


# Computed diagnostics and figures; no additional model selection.
conditional={}
for name,p in predictions.items():
    conditional[name]={}
    for positive in [False,True]:
        ids=np.array([i for i in te if (rows[i]['RFU']>0)==positive]);err=p[ids]-y[ids]
        conditional[name]['positive' if positive else 'reported_zero']=dict(n=len(ids),MAE_log=float(np.mean(abs(err))),RMSE_log=float(np.sqrt(np.mean(err**2))))
results['conditional_test_metrics']=conditional
(OUT/'results.json').write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
plt.rcParams.update({'font.family':'DejaVu Sans','font.size':10,'axes.spines.top':False,'axes.spines.right':False,
    'axes.labelcolor':'#30453f','text.color':'#243d35','axes.edgecolor':'#bac7c0','xtick.color':'#53675e',
    'ytick.color':'#53675e','svg.hashsalt':'L18-messages','figure.facecolor':'#fffef9','axes.facecolor':'#fffef9'})
names=['train_mean','composition','untyped_graph','typed_graph','gnn_bag','gnn_untyped','gnn_typed']
labels=['Training mean','Composition ridge','Untyped graph kernel','Typed graph kernel','Node-only neural model','GNN: no chemical edge type','GNN: typed edges']
colors=['#a39780','#7d94a1','#9dabb4','#387e94','#bfa777','#bb8153','#267b69']
def style(ax,title,x='',y=''):
    ax.set_title(title,loc='left',fontweight='bold',pad=15);ax.set_xlabel(x);ax.set_ylabel(y);ax.grid(axis='y',color='#e9ede5',lw=.7);ax.set_axisbelow(True)
def panel(i,fig,spec):
    if i==5:
        grid=spec.subgridspec(1,2,wspace=.35);axes=[fig.add_subplot(grid[0,j]) for j in range(2)]
        for j,(name,g) in enumerate([('Straight chain',results['geometry']['straight']),('Bent chain',results['geometry']['bent'])]):
            ax=axes[j];xy=np.array(g['points'])[:,:2];center=xy.mean(0)
            ax.plot(*xy.T,color='#93a894',lw=3,zorder=1);ax.scatter(*xy.T,s=150,c=['#b78351','#287b63','#387e94'],edgecolor='white',zorder=3)
            ax.scatter(*center,marker='+',s=100,color='#4d5e51',zorder=4)
            for k,p in enumerate(xy):ax.text(p[0],p[1]+.17,str(k+1),ha='center',fontsize=10)
            for p in xy:ax.plot([center[0],p[0]],[center[1],p[1]],color='#b6b9a8',ls=':',lw=1)
            ax.set(xlim=(-.25,2.25),ylim=(-.45,1.55),xlabel=f'x (nm)\n{name} · Rg = {g["Rg"]:.3f} nm',ylabel='y (nm)',aspect='equal')
            ax.set_title(('F  Same graph, different geometry' if j==0 else 'Same two bond lengths'),loc='left',fontsize=11,fontweight='bold',pad=18)
        return
    ax=fig.add_subplot(spec)
    if i==0:
        xx=np.arange(4)
        for mode,label,c in [('bag','Node-only',colors[4]),('untyped','No chemical edge type',colors[5]),('typed','Typed-edge GNN',colors[6])]:
            ax.plot(xx,results['gnn']['toy_predictions'][mode],'o-',label=label,color=c,lw=2,ms=6)
        ax.set_xticks(xx,['α1–3','β1–3','α1–4','β1–4']);ax.set_ylim(-.5,9.5)
        style(ax,'A  What changes when a linkage changes?','Gal(linkage)GlcNAc','Predicted ln(1 + RFU / 1 RFU)')
        ax.legend(frameon=False,fontsize=9,loc='upper left');ax.text(.03,.04,'Three-seed means · AO flag = 0\nModel sensitivity probe; no measured labels shown',transform=ax.transAxes,fontsize=9)
    elif i==1:
        for mode,label,c in [('bag','Node-only',colors[4]),('untyped','GNN: no chemical edge type',colors[5]),('typed','GNN: typed edges',colors[6])]:
            curves=np.array(results['gnn']['training_curves'][mode]);epochs=curves[0,:,0];values=curves[:,:,2]
            ax.fill_between(epochs,values.min(0),values.max(0),color=c,alpha=.13)
            ax.plot(epochs,values.mean(0),color=c,lw=2,label=label)
            for m in results['gnn']['models'][mode]:ax.scatter(m['epoch'],m['validation_group_RMSE'],color=c,s=25,zorder=3)
        style(ax,'B  Select checkpoints on validation groups','Training epoch','Equal-group validation RMSE (log response)')
        ax.legend(frameon=False,fontsize=8,loc='upper right');ax.text(.03,.05,'Line: mean of three seeds\nBand: seed range · dots: selected checkpoints',transform=ax.transAxes,fontsize=9)
    elif i==2:
        for j,(name,c) in enumerate(zip(names,colors)):
            mae=results['test_metrics'][name]['MAE_log'];rmse=results['test_metrics'][name]['RMSE_log']
            ax.plot([mae,rmse],[j,j],color=c,lw=3,alpha=.5);ax.scatter(mae,j,color=c,s=60,marker='o');ax.scatter(rmse,j,color=c,s=60,marker='D')
            ax.text(mae-.07,j,f'{mae:.2f}',ha='right',va='center',fontsize=9);ax.text(rmse+.07,j,f'{rmse:.2f}',ha='left',va='center',fontsize=9)
        ax.set_yticks(range(7),labels,fontsize=9);ax.invert_yaxis();ax.set_xlim(.9,3.7)
        style(ax,'C  Compare the same 64 test probes','Error in log response')
        ax.scatter([],[],c='#526658',marker='o',label='MAE');ax.scatter([],[],c='#526658',marker='D',label='RMSE');ax.legend(frameon=False,loc='lower right',ncol=2,fontsize=9)
    elif i==3:
        p=predictions['gnn_typed'][te];positive=y[te]>0
        ax.scatter(y[te][~positive],p[~positive],s=38,c='#9eafa1',alpha=.7,label='Reported zero (57)')
        ax.scatter(y[te][positive],p[positive],s=68,c='#b78351',edgecolor='white',label='Reported positive (7)')
        ax.plot([0,11],[0,11],c='#a5b5a6',ls='--');ax.axhline(target_mean,c='#9f947b',ls=':',lw=1)
        ax.set(xlim=(-.4,11),ylim=(min(-.5,p.min()-.3),max(11,p.max()+.3)))
        style(ax,'D  Typed GNN: inspect each prediction','Observed ln(1 + RFU / 1 RFU)','Predicted log response');ax.legend(frameon=False,loc='upper left',fontsize=9)
    else:
        selected=['train_mean','typed_graph','gnn_bag','gnn_untyped','gnn_typed'];xx=np.arange(5)
        zero=[conditional[k]['reported_zero']['RMSE_log'] for k in selected];pos=[conditional[k]['positive']['RMSE_log'] for k in selected]
        ax.bar(xx-.18,zero,.33,color='#93ac9b',label='Reported zero: 57 probes');ax.bar(xx+.18,pos,.33,color='#ba8559',label='Reported positive: 7 probes')
        ax.set_xticks(xx,['Mean','Typed\nkernel','Node-only','Untyped\nGNN','Typed\nGNN']);ax.set_ylim(0,8.5)
        style(ax,'E  Locate the errors by observed response','','RMSE in log response');ax.legend(frameon=False,loc='upper left',fontsize=9)
keys=['linkage','training','metrics','prediction','subgroups','geometry']
for i,key in enumerate(keys):
    fig=plt.figure(figsize=(8.6,5.3),layout='constrained');panel(i,fig,fig.add_gridspec(1,1)[0]);fig.savefig(OUT/f'{key}.svg',metadata={'Date':None});plt.close(fig)
fig=plt.figure(figsize=(18,16.2),layout='constrained');grid=fig.add_gridspec(3,2,hspace=.12,wspace=.1)
for i in range(6):panel(i,fig,grid[i//2,i%2])
fig.savefig(OUT/'graph_learning.svg',metadata={'Date':None});fig.savefig(OUT/'graph_learning.png',dpi=160,metadata={'Software':'L18 reproducible example'});plt.close(fig)
print('Source: 403 CMA1 probes, 265 composition groups; same L10 split 258/81/64')
print('Nine trained networks: three representations x three seeds; each budget 240 epochs')
print('Unknown residues in validation/test:',results['gnn']['unknown_nodes'])
print('Geometry example: identical two bonds, Rg',round(straight['Rg'],6),'vs',round(bent['Rg'],6),'nm')
print('Full observations, learned weights, predictions and six figures: graph_outputs/')
本次实际运行输出
baseline composition lambda 1.0 validation 3.131
baseline untyped_graph lambda 0.01 validation 2.113
baseline typed_graph lambda 0.1 validation 2.307
GNN bag seed 18 epoch 225 validation_group_RMSE 2.9109
GNN bag seed 28 epoch 225 validation_group_RMSE 2.9522
GNN bag seed 38 epoch 240 validation_group_RMSE 2.9616
GNN untyped seed 18 epoch 215 validation_group_RMSE 2.7911
GNN untyped seed 28 epoch 240 validation_group_RMSE 2.7291
GNN untyped seed 38 epoch 235 validation_group_RMSE 2.8241
GNN typed seed 18 epoch 240 validation_group_RMSE 2.668
GNN typed seed 28 epoch 240 validation_group_RMSE 2.6822
GNN typed seed 38 epoch 95 validation_group_RMSE 2.6263
train_mean {'RMSE_log': 2.4035798433067335, 'MAE_log': 2.055609867701193, 'R2_log': -0.15390450628146568, 'group_equal_RMSE_log': 2.390403340816057, 'spearman': None}
composition {'RMSE_log': 2.5180997811870185, 'MAE_log': 1.8576954221857684, 'R2_log': -0.26648086739097177, 'group_equal_RMSE_log': 2.5768225901938404, 'spearman': 0.29427119201512697}
untyped_graph {'RMSE_log': 3.04591624886402, 'MAE_log': 1.6879143514232147, 'R2_log': -0.8530565723303392, 'group_equal_RMSE_log': 3.2672519487554483, 'spearman': 0.24026943787176566}
typed_graph {'RMSE_log': 2.4682108425624634, 'MAE_log': 1.5610383992964285, 'R2_log': -0.2167946017650808, 'group_equal_RMSE_log': 2.589012334628697, 'spearman': 0.33531160899799173}
gnn_bag {'RMSE_log': 2.978828970414517, 'MAE_log': 1.6738114293102373, 'R2_log': -0.7723271913188345, 'group_equal_RMSE_log': 3.1056912486591433, 'spearman': 0.16978589542187028}
gnn_untyped {'RMSE_log': 3.007569213127222, 'MAE_log': 1.603621038650974, 'R2_log': -0.8066915936200179, 'group_equal_RMSE_log': 3.125289661740281, 'spearman': 0.0768211109732126}
gnn_typed {'RMSE_log': 2.6661110211507992, 'MAE_log': 1.4508746526471188, 'R2_log': -0.4197413230286702, 'group_equal_RMSE_log': 2.8022611914735496, 'spearman': 0.28317268189321326}
Source: 403 CMA1 probes, 265 composition groups; same L10 split 258/81/64
Nine trained networks: three representations x three seeds; each budget 240 epochs
Unknown residues in validation/test: {'train': 0, 'validation': 6, 'test': 7}
Geometry example: identical two bonds, Rg 0.816497 vs 0.666667 nm
Full observations, learned weights, predictions and six figures: graph_outputs/
图A先检查模型能否读出连接差别。四个输入都含Gal与GlcNAc两个残基,展示标记相同,只改变α/β和连接位置。节点模型给出几乎相同的结果,无类型GNN也给出相同结果;带类型GNN则能产生不同预测。这四个结构组成一组表示探针,用来检查化学边特征是否进入了计算,没有在此配上实验标签。接着看留出的实验记录,才回答这些不同预测是否更接近实测信号。把表示检查与误差评价接在一起,就能同时判断“模型有没有看见差别”和“看见以后有没有学对”。
一次运行 · 六幅结果图
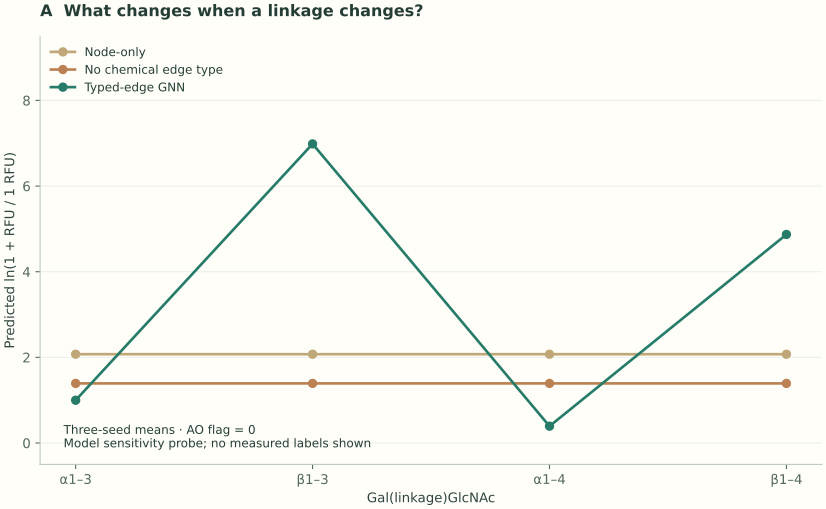
A|固定两个残基与展示标记,仅改变α/β和连接位置,检查三类神经网络的预测怎样变化;这是表示敏感性检查,未给这四个输入配实验真值。
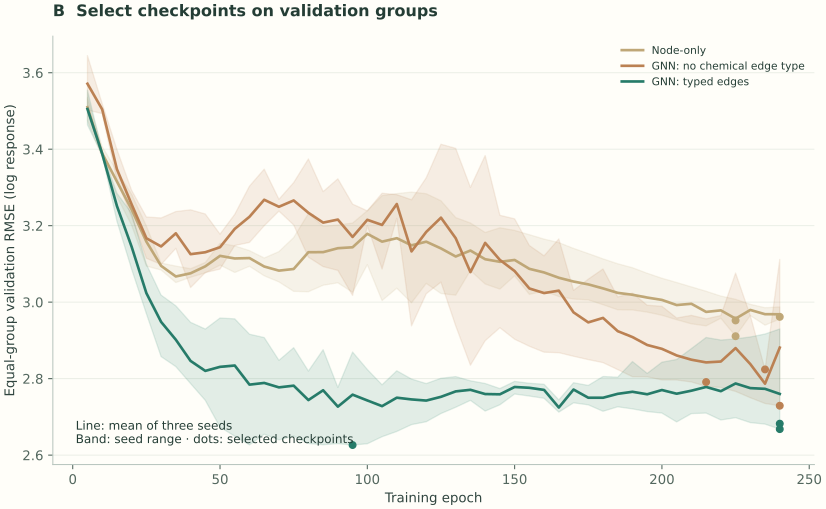
B|三类网络各训练三个种子,曲线为验证组成组等权RMSE的种子平均,阴影为范围,圆点为各自选中的训练轮次。
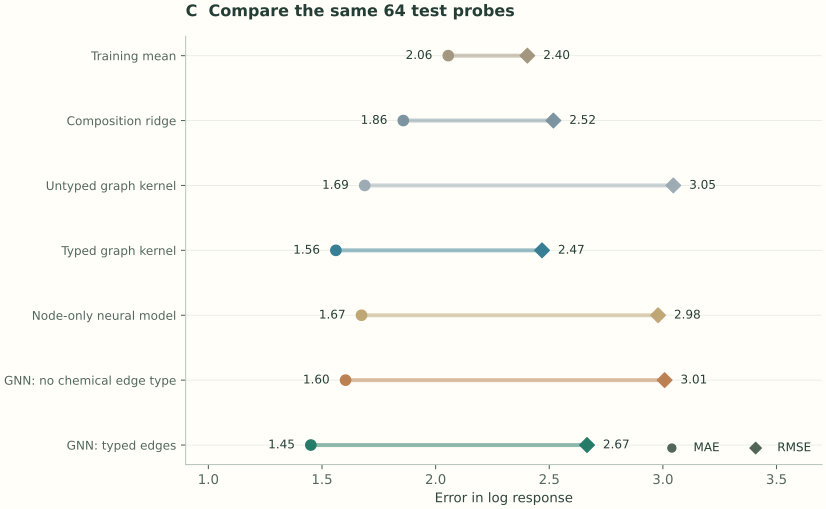
C|同一64条测试记录上的MAE与RMSE,比较均值、组成回归、两类图核与三类神经网络。
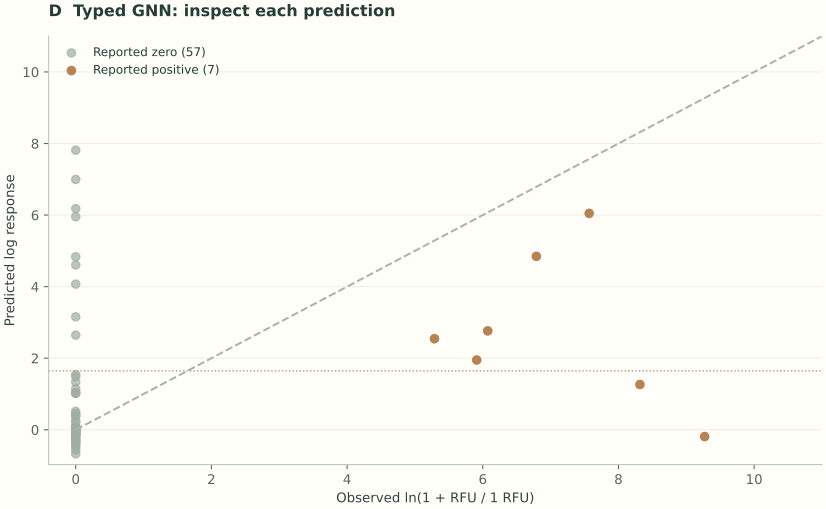
D|带类型GNN的三种子平均预测;57条报告零读数与7条正读数分别显示,虚线为预测等于观察。
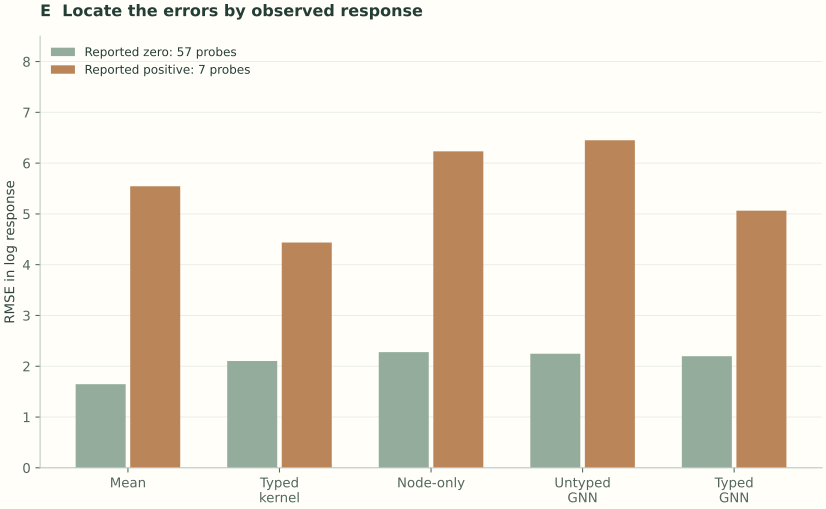
E|按观察读数分组后重新计算RMSE,显示较大偏差来自哪些记录;组别用于分析结果,预测时并不预先提供。
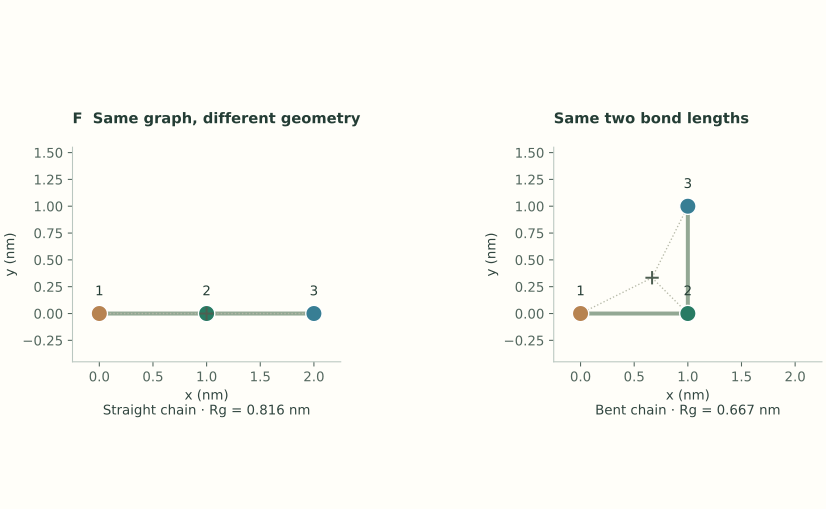
F|两个1纳米连接组成的直链与直角链,图连接相同,回转半径分别约0.816与0.667纳米;十字标出等权几何中心。
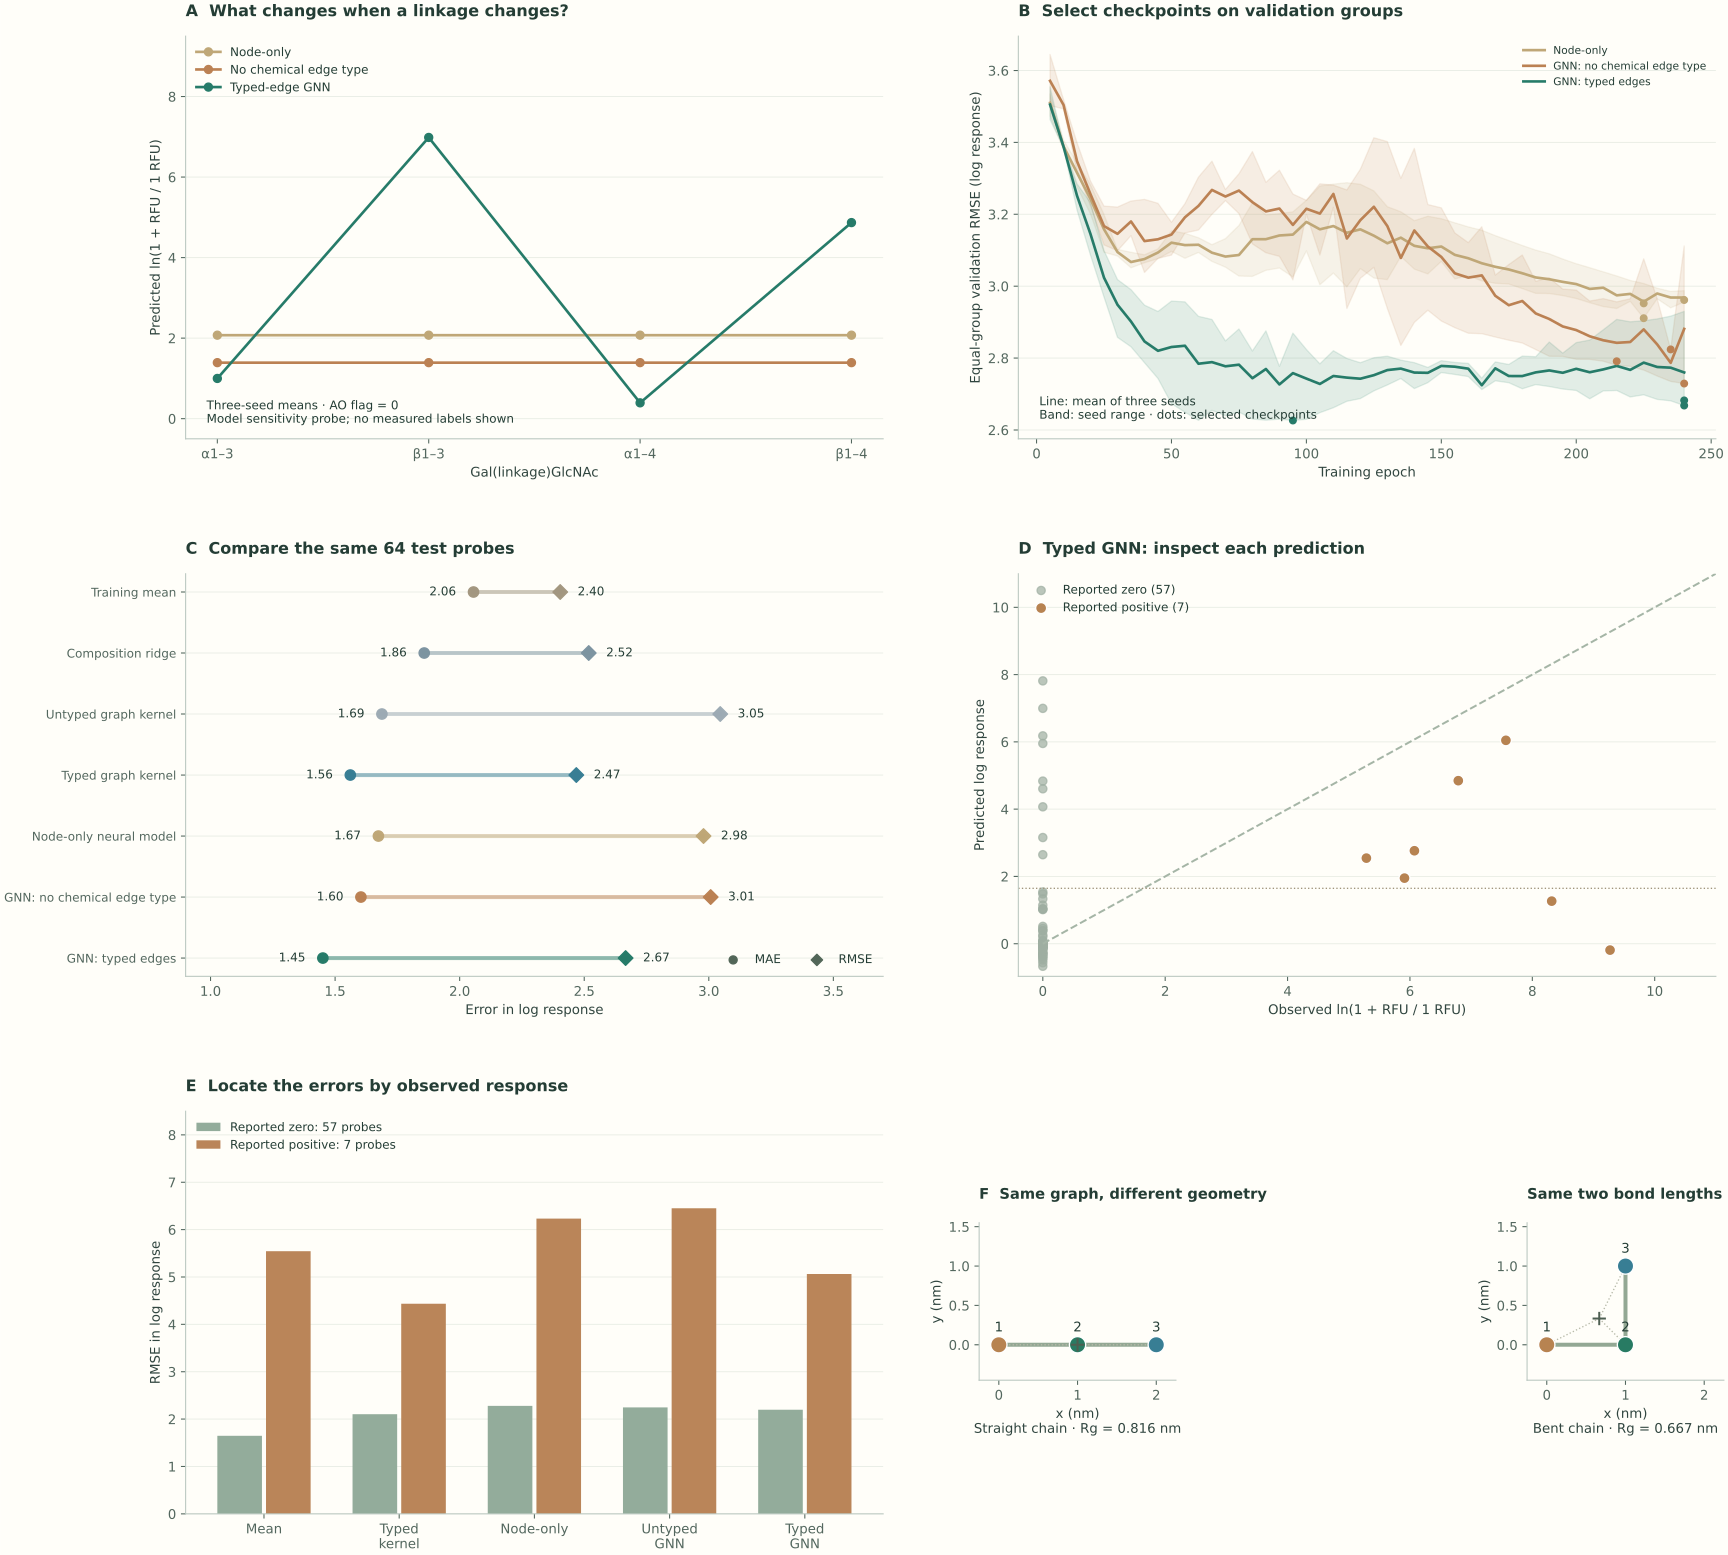
图B展示训练中的验证表现。曲线是三个种子的平均,浅色范围表示它们之间的差异,圆点表示各次训练保存的最佳轮次。带类型GNN的三个种子分别保存第240、240和95轮,说明初始化不同,验证表现最好的时刻也可能不同。最终预测使用三次结果的平均;选择轮次时使用验证组,测试组负责最后的统一比较。
图C同时给出MAE与RMSE。M=64表示同一组测试探针,y与ŷ都在自然对数响应尺度上。MAE直接平均误差的绝对值,RMSE先平方,所以对较大偏差更敏感。例如四次误差为0、0、0、4,MAE为1,RMSE为2;若四次都偏差1,两项指标都为1。这个小例子说明,两种指标可以帮助识别不同的误差分布。
在本次测试中,训练均值基线的MAE约2.056,带类型图核约1.561,带类型GNN约1.451,后者在这项指标上最低。只读取节点的神经网络约1.674,不读取化学边类型的GNN约1.604。将连接类型加入本例的消息计算,改善了这组测试记录的平均绝对误差;与前面已经实现的图核比较,也能看见不同学习方式怎样使用同一份结构信息。
RMSE的排列却不同:均值基线约2.404,带类型图核约2.468,带类型GNN约2.666,只读取节点与无类型GNN分别约2.979和3.008。带类型GNN在许多记录上接近观察值,仍有一些较大的偏差抬高了平方误差。评价模型时,把这两种现象同时讲清楚,才能判断它更适合帮助筛查常见响应,还是已经能够准确找出较强的候选。
图D把64条预测逐个画出来,灰绿色点对应原表报告的57条零读数,棕色点对应7条正读数。多数零读数附近的预测较低,仍有若干点被明显高估;一些正读数则被低估。沿着这些点可以继续查回糖链结构、残基种类、展示标记和相似训练对象,把一项平均误差拆成可以研究的具体问题。
图E按观察读数重新分组。带类型GNN在零读数组中的RMSE约2.198,在正读数组中约5.064;带类型图核分别约2.103与4.436。这个分组用于理解结果,预测新样品时并不会事先告诉模型它属于哪一组。若研究目标是寻找强结合候选,后续就需要特别关注强响应结构的覆盖、实验重复与排序表现,并在新的独立数据上检验改进。
原表中的零与正读数还提示了数据收集的方向。可以为预测明显偏离的结构补充重复检测,记录背景与检测范围,并补充化学组成相近、连接方式不同的成对探针。这样既能区分测量波动与稳定结构效应,也能直接检验网络是否学到了关心的连接差异。训练数据越能围绕科学问题形成对照,学习结果越容易解释。
词表检查也提供了具体信息:验证图中有6个节点、测试图中有7个节点使用了训练词表未见过的残基标签,代码将它们映射到未知类别。保留这些计数和原结构,有助于判断误差是否与新化学种类有关。下一步可以增加相关残基的测量,或者改用能够拆分修饰的特征表示,再按相同评价规则检查变化。
图F回到三珠链的几何计算。节点与连接相同,两种构象的回转半径不同,因此仅靠本节的连接图模型,它们会得到相同输入;加入足够的空间距离后,这个差别才进入表示。代码还验证了整体旋转和平移保持距离与回转半径。把这些确切可算的例子放在实验预测旁边,可以帮助我们判断一项困难究竟来自输入信息不足,还是来自已经提供的信息尚未被模型充分利用。
节点重编号检查覆盖了全部403张图,并同时改变边的存储顺序;九个模型的预测变化最大约为2.2×10⁻⁶,处于本例单精度数值求和的微小差异范围。独立的逐图计算也复核了网络前向过程。这里的检查直接对应开头提出的要求:表示相同分子的不同文件写法,应该给出相同的科学判断。
从糖链扩展到蛋白质、核酸或凝胶网络时,可以沿用这套研究过程:先定义节点与边的物理意义,再保存与目标有关的序列、连接、环境和几何信息,训练合适的消息传递模型,最后在真正独立的对象或条件上评价。经过本节,预测模型已经能够接收结构并给出可核查结果。《主动学习:用高斯过程选择下一次实验》将把目光转向研究决策:当经费和时间只够再做几个样品时,应该优先测哪一个,才能更快解决尚不清楚的问题?
资料与延伸阅读
Fischer,1894:Einfluss der Configuration auf die Wirkung der Enzyme,原论文公开存档。Flory,1941:Molecular Size Distribution in Three Dimensional Polymers. I. Gelation,用于联系局部支化与整体分子结构。
Gilmer等,2017:Neural Message Passing for Quantum Chemistry。Burkholz等,2021:Using graph convolutional neural networks to learn a representation for glycans。Satorras等,2021:E(n) Equivariant Graph Neural Networks。
阵列数据沿用Lundstrøm等,2024:Elucidating the glycan-binding specificity and structure of Cucumis melo agglutinin, a new R-type lectin,公开原始工作簿采用CC BY 4.0许可。本节使用imperial工作表中同一CMA1实验的结构与读数;样品条件和筛选步骤承接第十节。四组科学史插图为原创概念图,六幅结果图由本页完整代码生成。