从仪器记录走向可以检验的结构判断
小角度散射数据分析:回转半径、噪声与预测
把一杯蛋白质溶液放在面前,我们很难凭颜色判断里面的分子是舒展开了,还是聚到了一起。实验仪器可以把肉眼看不见的变化变成峰、斑点和曲线,AI又可以从这些记录中学习结构信息。但从“仪器给出一个数”到“知道分子发生了什么”,中间还隔着单位、背景、误差和模型。本节以溶菌酶的小角度X射线散射为线索,走过这段过程:先理解信号为什么携带尺寸信息,再整理真实记录,最后训练预测模型,看看测量条件变化时,哪些判断仍然可靠,哪些地方值得重新采集数据。
01先问清楚,信号究竟测到了什么
认识一件东西,常常需要几种互相配合的观察。买一件衣服时,标签告诉我们纤维成分,尺子告诉我们尺寸,拉伸则让我们感受到弹性。三种信息可以相互联系,却不能互相替代。研究生物大分子也如此:序列描述连接的顺序,质谱帮助辨认分子质量,散射反映空间分布,力学曲线记录受力响应。选择仪器的第一步,是把想知道的性质写成一个清楚的问题。
例如,前面讨论过蛋白质折叠,也讨论过链在溶液中的舒展与收缩。现在想研究“盐浓度改变以后,蛋白质的平均尺寸是否变化”,最直接需要的是能对溶液中结构尺度敏感的信号。若同时担心分子已经断裂,还需要检查质量或序列组成;若怀疑形成聚集体,则需要观察样品组成和不同尺度的结构。一个研究问题可以由几种测量共同回答,每种测量承担其中一部分。
这里的溶菌酶是一种能够作用于细菌细胞壁成分的蛋白质,在鸡蛋清中就可以找到。选它来理解散射有两个方便之处:分子尺度适合用低角度信号研究,也积累了可公开查阅的结构与实验资料。我们将读入一条真实的溶菌酶曲线,估计它的回转半径。后面还会生成尺寸已知的几何对象,用它们训练AI;两个环节分别回答“实际记录怎样分析”和“预测方法能否找回已知答案”。
回想蛋白质序列中的氨基酸,一个个残基的化学组成影响总质量,但同一条链可以形成不同构象。像把同一根绳子团起来或铺开,秤上的读数几乎不变,占据空间的范围却明显不同。因此,知道质量以后,仍然可以继续问它怎样分布在空间中。反过来,两个分子的空间尺寸接近,也可能由不同的序列、连接方式和水合状态形成。
Fenn等在1989年的电喷雾质谱论文展示了大生物分子质量测量的重要进展。溶液被喷成带电液滴,经过液滴缩小等过程,使带电的大分子进入气相,仪器再按照质荷比区分离子。这里“荷”指电荷数量:同一种分子带上不同数量的电荷,可以出现在不同的峰位置。把这组峰之间的关系读懂,才能从峰的位置推回分子质量。
可以把质荷比暂时理解成“质量由多少份电荷分担”。质量相同,所带电荷越多,质荷比越小。实际计算还要计入质子或其他加合物的质量,并判断电荷态。这个例子说明,仪器横轴并不总是我们最终想报告的量;读峰之前需要知道峰怎样产生,读峰以后还需要完成相应换算。散射曲线的横轴也有类似的一层关系:它由波长与角度决定,之后才与空间尺度联系起来。
蛋白质样品的“纯”也需要放在测量方法中理解。一条色谱曲线里只有一个显著峰,说明在所选分离条件和检测方式下,主要信号集中在一个位置;迁移或响应相近的成分仍可能重合。研究者因此常把分离、质量与结构测量结合起来。对糖链尤其如此:相同单糖组成可能对应不同连接与分支,仅有总质量往往还需要补充能够辨认连接关系的信息。
荧光实验提供了另一个容易联系生活的例子。某些染料进入特定分子环境后会变亮,就像一个对周围环境敏感的小指示灯。亮度变化可以帮助追踪组装过程,但也受到染料浓度、结合方式和仪器设置的影响。若要用它研究蛋白质纤维形成,可以把荧光随时间的变化与显微图像、散射或力学结果放在一起,逐步连接“局部环境变化”和“材料结构变化”。
这些例子给数据整理提供了一个起点:每列数值旁边,都应能回答“测的是哪个对象、什么响应、怎样得到”。AI能够利用稳定的统计关系,却不会自动知道表格中一列叫作“大小”的数来自显微图、散射拟合还是质量换算。如果把定义不同的标签直接合并,模型会同时学习几种测量规则。先确定同一研究目标,再记录各个标签的形成方式,后面的训练与比较才有共同含义。
02从一束X射线,理解空间尺寸怎样进入曲线
光经过水面的细小波纹,会在不同方向形成明暗变化。X射线遇到分子中的电子,也会产生向不同方向传播的散射波。分子各个位置产生的波彼此叠加,传播路程的差别改变相位,从而使某些方向上的强度增加,另一些方向上减弱。仪器记录这些方向上的强度,就把分子内部的空间分布转成了可测的信号。
这里可以借助两个人一起拍手的声音理解“相位”:若声音的振动到达某处时配合得上,总振幅会增强;若配合不同,增强程度就会改变。分子内部有很多散射位置,所有成对位置之间的距离都参与这种叠加。实验测到的是强度,且溶液中的分子不断改变方向,因此最终曲线包含许多位置和取向共同作用后的结果。它通常比一张逐个原子标出位置的照片更间接,也正因为如此,需要模型帮助解释。
散射实验常用q作为横轴,读作“q值”,称为散射矢量的大小。它把角度与入射波长放在同一个量中,便于比较不同装置的测量。若入射方向与散射方向之间的夹角写成2θ,那么公式里使用的是它的一半θ。波长λ表示同一列波中相邻波峰之间的距离,π就是圆周率。
假设波长为0.1纳米,整个散射夹角2θ为0.2度,则θ为0.1度,代入得到q约0.219每纳米。三角函数计算时要留意程序通常接收弧度,0.1度要先乘π/180。q的单位是长度的倒数:λ用纳米,q就用每纳米,写作nm⁻¹。较小的角度对应较小的q,这也是“小角度散射”名称的由来。
q可以理解为空间变化的快慢。一种空间起伏的典型尺度常与2π/q联系起来,因此小q有助于观察较大尺度的信息。这个关系像听声音时用频率辨认快慢,但分子曲线由许多距离共同产生,某个q点通常不对应分子内部唯一的一段距离。对整条曲线作物理分析,才能把这些混合在一起的信息整理成尺寸、形状或分布特征。
前面认识过回转半径Rg:它描述各部分围绕中心分布得有多开。现在从散射角度重新看这个量。先把物体想成N个等权的小散射点,每个点有位置向量ri;向量包含三个方向的位置。先求这些位置的平均,得到中心rc,再把各点到中心的距离平方取平均,最后开平方,便得到Rg。
若只有两个等权点,相距4纳米,中心就在它们之间,各点离中心都是2纳米,回转半径就是2纳米。若一条连续细杆长6纳米、沿长度均匀分布,它的回转半径是6/√12,约1.73纳米。它们都可以用同一个量描述,但这个量没有把物体强行变成球。真实X射线散射还要考虑物体相对于溶剂的电子密度差,因而所测尺度与散射对比有关;本节几何模型采用均匀对比,便于把计算与形状直接联系。
Guinier在1939年发表的小角度X射线衍射研究,为从低角度信号提取结构尺度提供了经典方法。它抓住一个有用的近似:当q足够小,分子内部不同位置造成的相位差也较小,强度起初怎样下降主要由空间分布的二阶尺度决定。今天分析溶液中的蛋白质或高分子时,这个低q关系仍然是很常用的起点。
为什么会出现“距离的平方”?对很小的相位差,波叠加中的余弦可以近似写成1减去相位差平方的一半。相位差又与q和两点之间的距离有关,因此平均强度中会出现q²乘以距离平方的平均。在随机取向下,三个空间方向等价,某一个方向上的均方分量占总均方距离的三分之一;再把所有点对的均方距离换成围绕中心的均方距离,就得到与Rg²/3有关的低q项。
把这一低q展开写成指数形式,就得到下面的Guinier近似。它把强度曲线开头的一小段与回转半径联系起来。I(0)表示向零角度外推的强度,实验中直接入射的强光通常需要挡住,因此它往往通过拟合估计。指数里的q²Rg²没有单位:每纳米的平方与纳米的平方相乘,正好抵消。指数函数的输入需要是这样的无量纲数。
自然对数ln是指数函数的反函数,取对数以后,指数中的乘积就变成一条直线的斜率。把横轴改成q²,纵轴改成ln I,截距a等于ln I(0),斜率b等于−Rg²/3。若拟合得到b=−0.75平方纳米,便有Rg²=2.25平方纳米,开平方得到1.5纳米。负号来自强度起初随q增加而下降;当拟合斜率变成正数时,这套关系就无法给出实数回转半径,需要检查信号与所选窗口。
也可以从已知尺寸向前算一次。设Rg=1.5纳米,在q=0.5每纳米时,q²Rg²/3=0.1875,于是I(q)/I(0)约为exp(−0.1875),即0.829。这个比值说明强度降到零角度外推值的约83%。尺寸较大的物体在同一个q处累积更明显的相位差,低q强度下降也更快,因此对数曲线更陡。
近似的使用范围可以通过qRg来检查。两者相乘反映相位差的典型量级,越小越接近低q展开的条件。对于紧凑粒子,qRg约1.3常被用作选择上限的参考,还要结合形状、残差与样品状态判断。非常柔性的链、聚集体或存在明显粒子间相互作用的溶液,需要相应调整。把更多高q点放入直线拟合虽然增加了点数,也可能把真实曲率当成尺寸信息。
尺寸与残余背景,怎样改变读出的回转半径?
深绿色曲线是均匀球形模型。增加残余背景,再比较低q斜率与估计尺寸。
先保持交互图的背景为零,改变真实回转半径,观察上方曲线下降的快慢与下方直线斜率。再固定尺寸,逐渐增加残余背景:强度整体被抬高,取对数后的相对下降会变缓,读出的尺寸随之减小。最后扩大拟合窗口,看看偏离低q直线的弯曲怎样影响结果。三个操作分别对应结构变化、测量处理偏差和拟合选择,它们都能改变最终数字,研究时需要分开追踪。
03把背景、单位和误差一起带入数据记录
真实蛋白质溶液装在样品池中,X射线遇到的不只有蛋白质,还有水、缓冲盐、样品池窗口与其他环境。为了提取溶质相关的信号,通常还要测量相应的空白,再把样品与空白按可比较的标度归一化。像在嘈杂房间里录下一段声音,想知道某个声源的贡献,就需要了解环境本身产生了什么;环境测得不准,会直接影响提取出来的信号。
这里用一个简化的计数模型理解扣除。Cs是样品观测的计数,Cb是空白计数;Ns和Nb把不同曝光或通量下的计数换到同一强度标度,α表示空白还需要乘的比例。它们的具体来源随仪器处理流程而变。对独立的Poisson计数,方差近似等于平均计数,可以用观测计数来估计;两次独立测量相减,随机偏差的方差则相加。
为什么减去了背景,误差还要相加?想象样品计数恰好偏高一点,而空白计数恰好偏低一点,相减后的结果会偏得更多;反过来的组合也会发生。正负随机偏差长期平均可以抵消,它们的平方却一直贡献波动。独立条件使两次偏差的交叉平均为零,留下各自方差之和。若样品与空白共享某些归一化误差,还要把相应相关性一起建模。
例如,两次测量都取归一化系数12000,样品得到12960个计数,空白得到960个计数,α=1。相减并归一化后,强度为1;标准误差约为√13920/12000,即0.00983。若把两次曝光都延长到原来的4倍,期望计数同时增大4倍,归一化系数也增大4倍,最终强度基本不变,而计数标准误差大约减半。这说明增加采集量如何改善随机噪声。
背景偏差则需要另一种处理。假设空白浓度或样品池条件不匹配,扣除后留下一个稳定的正值,即使反复测量很多次,它仍然可能留在那里。增加曝光能使曲线更平滑,却不会自动修正这个偏差。交互图已经显示,低q尺寸拟合会受到正背景影响。因此,研究记录既要有“测了多久、计数多少”,也要有“空白是什么、怎样匹配和缩放”。
接下来使用的SASBDB记录SASDPT4是一条经过处理的溶菌酶共识散射曲线,已包含溶剂扣除。它来自Trewhella等在2022年发表的多设施比较研究,用于研究生物大分子散射数据的可重复性与基准曲线。选用这种公开记录,可以把读图、单位换算和拟合写成别人能够重做的过程。
所谓共识曲线,是把经过比较和处理的多组测量信息汇集到统一的曲线上。这里的溶菌酶记录有10组贡献曲线,来自相应的独立测量集合;它们研究的是同一种蛋白质,并不等于10种独立蛋白质样本。这一区别在训练AI时很重要:重复测量能帮助研究误差和可重复性,分子种类的增加则扩展结构与化学空间,二者解决的问题不同。
下载文件中有200行数值,每行依次是q、相对强度和标准误差,还包含文字说明。程序逐行辨认三个数值列,保留原始文件,并核对文件的校验值。校验值相同,表示读入的字节与本例使用的文件一致。这样,后续有人重新运行时,能够先确定自己读的是哪一份数据,再比较拟合与绘图差异,而不必猜测文件是否已经更新。
这份文件还藏着一个很常见的单位问题:原始q列用的是Å⁻¹,数据库网页展示时采用nm⁻¹。1埃等于0.1纳米,所以1每埃等于10每纳米;程序需要把q乘以10。原研究注明的溶菌酶均匀间隔为0.005每埃,也与文件逐点间隔对应。如果漏掉换算,横轴数值会小10倍,为了拟合同样的强度下降,推回的长度就会大10倍。一个看起来拟合很好的直线,也可能携带这样的单位错误。
本节取q从0.1到0.8每纳米的15个点作加权Guinier拟合。各点的误差不同,同样偏离直线0.02,对精度高的点与精度低的点并不意味着同样大的偏差。因此,先把强度的标准误差换到对数尺度,再用对数残差除以相应误差,比较“偏离了几个标准误差”。这样得到的标准化残差没有单位。式中j逐个编号观测点,m是拟合点数,a和b是待估的截距与斜率;程序寻找使这些标准化残差平方和最小的一条线。
对数误差为什么近似等于sI/I?在某个正强度附近,ln I的变化率是1/I,因此一个小的强度偏差乘以1/I,就得到对应的对数偏差。例如I=0.8、标准误差0.008时,对数标准误差约为0.01。若某点的对数残差为0.02,它偏离拟合线约两个这样的标准误差。加权拟合把这些标准化残差的平方加起来,并寻找使总和最小的直线。
约化χ²读作“约化卡方”,分母m−2表示在m个数据点中拟合了截距与斜率两个参数。在所用模型合适、点误差估计合理且相关性可忽略等条件下,它应当在1附近波动。这里的值约为7.09,提醒我们进一步看残差:有些点相对于给出的点误差,偏离比直线图上看起来更明显。曲线很平滑、点误差很小的时候,近似关系的细微弯曲或其他测量因素也会被放大出来。
拟合得到的Rg约为1.4545纳米,I(0)约为1.0541,窗口上限对应qRg约1.164。由该加权拟合的协方差计算,Rg的条件标准误差约为0.00165纳米。这个误差回答的是:沿用所给点误差和独立性近似,直线参数在局部拟合中有多敏感。真实研究还要结合窗口选择、背景处理和不同测量之间的变化,形成更完整的尺寸判断。
因此,代码同时改变窗口上限来检查结果:保持下限0.1每纳米,上限取0.4、0.5、0.6、0.7、0.8、0.85和0.9时,回转半径依次约为1.510、1.479、1.456、1.458、1.455、1.464和1.464纳米。很窄的窗口曲率信息较少,较宽的窗口又逐渐引入近似之外的变化。这组数值让“结果对分析选择有多敏感”变成可以直接查看的证据,也帮助决定下一步应检查哪段信号。
04让AI学习曲线到结构,先准备能检验的答案
从尺寸和形状计算散射曲线,叫作正向问题;从曲线推回尺寸和形状,叫作反问题。正向计算像按照一个给定模具投影,反向推断则像看着投影猜模具。不同物体可能给出相近投影,噪声还会遮住细节,因此反问题需要明确“允许哪些物体”“测到哪些信息”和“最终想估计什么”。本节把目标收敛为一个数:均匀旋转椭球的回转半径。
旋转椭球可以从一个椭圆绕轴旋转得到,像一颗被拉长或压扁的球。设两个相同的赤道半轴为a,极向半轴为c;c比a大时形状较长,比a小时较扁。这里的a表示几何半轴,与前面Guinier直线的截距属于不同公式中的局部符号。给定a和c,便能算出已知的几何回转半径,也能在指定散射条件下计算曲线。
先读这组式子的结构。F(z)是均匀球对应的归一化散射振幅函数,z没有单位;z趋近于零时F趋近于1,代码在极小z处用展开式避免两个相近数相减造成精度损失。椭球沿不同方向有不同的有效长度r,所以要把q与r相乘再放进F。取平方是从振幅得到强度,最后对取向求平均,得到归一化形状因子P(q)。
u是椭球极轴与q方向夹角的余弦。随机取向在球面上均匀分布时,按角度平均会带有正弦权重;改用余弦u作变量,可以把这个权重吸收到积分中,再利用椭球的前后对称,只需从0积到1。积分符号可以理解成“把各种方向的贡献连续相加”。程序用80个适当选择的方向点和权重近似这次平均,避免对每个可能角度逐一计算。
回转半径的式子则来自椭球内部均匀分布的几何平均。三个方向的均方位置分别为a²/5、a²/5和c²/5,相加得到(2a²+c²)/5。若a=c=2纳米,就回到均匀球,Rg=√(12/5),约1.549纳米;若a=2、c=4纳米,Rg=√(24/5),约2.191纳米。这样的标签直接由已知几何计算,适合检查曲线反演是否找回了原先设置的尺寸。
程序生成480个独立几何对象,回转半径分布在1.2到3.2纳米,长宽比c/a分布在0.5到2.5。每个对象在0.05到1.2每纳米的96个q点上产生一条理论曲线,再叠加背景并生成样品与空白的Poisson计数。相减后得到含噪观测,每个对象重复两次。这样,我们同时拥有干净的几何答案、产生信号的机制、实际交给模型的观测,以及每次观测的误差估计。
这里的椭球是具有均匀散射对比的受控几何模型,随机取向,并忽略粒子之间的干涉。用它们能够明确检查尺寸学习,也能单独改变背景和计数。真实蛋白质还可能包含内部密度变化、水合层、柔性运动和多种状态;将学习任务推进到蛋白质时,可以逐步把这些因素加入正向模型,并用有独立结构依据的实验记录检验。受控数据的价值,就在于让每一步增加了什么复杂性都说得清楚。
划分数据时,以整个几何对象为单位:240个用于训练,80个用于验证,80个用于区间校准,最后80个留作测试。同一对象的两次测量始终放在同一组。若把它们随机拆开,训练时已经见过的形状可能再次出现在测试里,得到的是对重复观测的表现;目前想知道的是面对新几何对象时怎样预测,因此需要按对象分组。
先设三个容易解释的参照。第一个始终预测训练对象的平均回转半径,看看完全不读曲线时能做到什么程度。第二个在固定低q窗口0.05到0.30每纳米内作加权Guinier拟合,直接使用物理关系。第三个把整条曲线输入岭回归,以带正则化的线性组合预测尺寸。前面几节已经认识过岭回归限制系数过度变化的作用,这里它为神经网络提供一个充分利用曲线的简单学习基线。
神经网络进一步学习非线性的曲线组合。它不是先规定某一个q点对应某一种形状,而是通过多层计算,把96个观测值组合成适合预测尺寸的内部表示。Rumelhart、Hinton和Williams在1986年的论文展示了通过反向传播误差学习内部表示的方法:预测误差沿计算关系向前面的层传递,使各个权重得到相应调整。这个思路今天可以用于图像、序列,也可以用于这里的一维实验曲线。
在输入网络前,每条曲线先除以前4个q点强度的平均值,减弱整体强度倍数的影响。随后用训练组在各个q位置的均值和标准差进行标准化。可以把它理解成先对齐曲线的整体音量,再比较不同位置的起伏。测试组沿用训练时保存的变换,校准组和验证组也相同;这让模型在遇到新曲线时使用与学习阶段一致的数值尺度。
x是标准化后的96维输入向量。W1和W2是两层权重矩阵,b1和b2是偏置;第一次计算得到64个隐藏数值,第二次得到32个。tanh把数值平滑压到−1与1之间,使网络能够表达非线性关系。最后用向量w3与这32个数作加权和,再加偏置b3,得到标准化的尺寸预测。
μR与sR分别是训练目标的均值和标准差,最后一行把预测重新变回纳米。比如训练均值若为2.2纳米、标准差为0.6纳米,网络的标准化输出为−0.5,实际预测就是2.2−0.3=1.9纳米。网络训练时最小化标准化尺寸的均方误差,使用学习率0.003,训练300轮,每5轮查看验证组并保存当前较好的模型;测试组一直保留到这些选择结束。
相同训练设置分别从三个随机种子开始运行,最终取三个模型预测的平均。种子改变初始权重,能够帮助观察结果是否过分依赖某一次初始化;预测平均则让多个学到的映射共同给出结果。这里三个模型都在第300轮达到各自保存的最佳验证结果。它们仍然使用同一批训练对象,不能把三个模型当成三批独立实验样品。
除了预测一个尺寸,还希望给出有数据依据的区间。专门留下的80个校准对象负责这件事:每个对象有两次观测,先算两次预测的绝对误差,再取较大者作为这个对象的分数。这样安排,是希望区间同时覆盖同一对象的两次预测。把80个分数从小到大排序,取下面公式规定的位置,得到统一的半宽Q。
这里α=0.1,表示设计的未覆盖比例为10%;它与前面空白缩放公式中的α分别属于两个局部定义。⌈ ⌉表示向上取整,n=80时,(80+1)×0.9=72.9,向上取整为73,所以Q取排序后的第73个分数。某次预测若为2.0纳米,Q为0.04纳米,给出的区间就是1.96到2.04纳米。对校准与未来对象遵循相同抽样机制的情况,这种分组校准为区间覆盖提供了统计依据;后面改变测量条件时,则直接检查覆盖率会怎样变化。
05运行完整例子,沿着误差找到下一步实验
下面的程序把本节两条线索连接起来:读取公开溶菌酶记录,完成单位换算、加权拟合与窗口检查;另外生成480个受控对象,训练四类预测方法,校准区间,并改变测试测量条件。首次运行会下载约10千字节的原始数据文件,之后使用校验通过的本地副本。安装代码开头列出的依赖即可运行。
读程序时可以先找三个函数。formfactor从几何计算理论曲线,observe把理论强度变成带计数波动的观测,guinier根据低q关系反推尺寸。网络训练和区间校准在它们之后进行。输出目录保存完整观测、对象编号、分组、标准化参数、模型权重和评价结果,因此既能追踪某个点来自哪里,也能检查训练和测试是否使用了不同对象。
"""L17: scattering measurements, inverse prediction, and calibrated intervals.
Install: numpy scipy scikit-learn torch matplotlib requests
Run: python example.py
Experimental source: SASBDB SASDPT4; synthetic ellipsoids supply known targets.
"""
from pathlib import Path
import json,copy
import numpy as np
from numpy.polynomial.legendre import leggauss
from sklearn.linear_model import Ridge
from sklearn.preprocessing import StandardScaler
import torch
from torch import nn
torch.set_num_threads(2)
HERE=Path.cwd()
OUT=HERE/"scattering_outputs";OUT.mkdir(exist_ok=True)
rng=np.random.default_rng(1717);q=np.linspace(.05,1.2,96)
rg=rng.uniform(1.2,3.2,480);aspect=np.exp(rng.uniform(np.log(.5),np.log(2.5),480))
axes_a=rg*np.sqrt(5/(2+aspect**2));axes_c=axes_a*aspect
def formfactor(q,a,c,n=80):
    x,w=leggauss(n);u=(x+1)/2;w=w/2
    R=np.sqrt(a[:,None]**2*(1-u*u)+c[:,None]**2*u*u)
    z=q[None,:,None]*R[:,None,:]
    amp=np.where(abs(z)<1e-3,1-z*z/10+z**4/280,3*(np.sin(z)-z*np.cos(z))/np.where(z==0,1,z)**3)
    return np.sum(amp*amp*w,axis=2)
P=formfactor(q,axes_a,axes_c)
assert abs(formfactor(np.array([0.]),axes_a,axes_c)-1).max()<1e-14
amplitude=rng.uniform(.8,1.2,(480,2));exposure=rng.uniform(20000,80000,(480,2))
buffer=.08+.02*q*q
def observe(exposure):
    sample=rng.poisson(exposure[:,:,None]*(amplitude[:,:,None]*P[:,None,:]+buffer))
    blank=rng.poisson(exposure[:,:,None]*buffer)
    return (sample-blank)/exposure[:,:,None],np.sqrt(sample+blank)/exposure[:,:,None],sample,blank
y,sd,sample_counts,blank_counts=observe(exposure)
order=rng.permutation(480);groups=dict(train=order[:240],validation=order[240:320],calibration=order[320:400],test=order[400:])
rows={k:np.array([2*i+j for i in v for j in range(2)]) for k,v in groups.items()}
Y=np.repeat(rg,2);raw=y.reshape(-1,96);uncertainty=sd.reshape(-1,96)
def features(v):return v/v[:,:4].mean(1,keepdims=True)
scaler=StandardScaler().fit(features(raw)[rows['train']]);X=scaler.transform(features(raw))
target_mean=Y[rows['train']].mean();target_sd=Y[rows['train']].std()
ridge=Ridge(alpha=1.).fit(X[rows['train']],Y[rows['train']])
def guinier(v,s,available=None):
    if available is None:available=np.ones(96,dtype=bool)
    preds=[];ses=[]
    for yy,ss in zip(v,s):
        mask=(q>=.05)&(q<=.3)&available&(yy>0)&(ss>0)
        A=np.column_stack([np.ones(mask.sum()),q[mask]**2]);err=ss[mask]/yy[mask]
        Aw=A/err[:,None];cov=np.linalg.inv(Aw.T@Aw);coef=cov@(Aw.T@(np.log(yy[mask])/err))
        value=np.sqrt(-3*coef[1]) if coef[1]<0 else np.nan
        preds.append(value);ses.append(3*np.sqrt(cov[1,1])/(2*value))
    return np.array(preds),np.array(ses)
physics,physics_se=guinier(raw,uncertainty)
class Network(nn.Module):
    def __init__(self):
        super().__init__();self.layers=nn.Sequential(nn.Linear(96,64),nn.Tanh(),nn.Linear(64,32),nn.Tanh(),nn.Linear(32,1))
    def forward(self,x):return self.layers(x).squeeze(-1)
xt=torch.tensor(X,dtype=torch.float32);yt=torch.tensor((Y-target_mean)/target_sd,dtype=torch.float32)
models=[];curves=[];seed_preds=[]
for seed in [17,27,37]:
    torch.manual_seed(seed);model=Network();optimizer=torch.optim.Adam(model.parameters(),lr=.003)
    best=float('inf');best_state=None;curve=[];best_epoch=0
    for epoch in range(1,301):
        model.train();optimizer.zero_grad();pred=model(xt[rows['train']]);loss=((pred-yt[rows['train']])**2).mean();loss.backward();optimizer.step()
        if epoch%5==0:
            model.eval()
            with torch.no_grad():v=float(((model(xt[rows['validation']])-yt[rows['validation']])**2).mean())
            curve.append([epoch,float(loss.detach()),v])
            if v<best:best=v;best_state=copy.deepcopy(model.state_dict());best_epoch=epoch
    model.load_state_dict(best_state);model.eval()
    with torch.no_grad():seed_preds.append(model(xt).numpy()*target_sd+target_mean)
    models.append(dict(seed=seed,epoch=best_epoch,validation_mse_scaled=best,parameters=sum(p.numel() for p in model.parameters()),weights={k:v.tolist() for k,v in best_state.items()}))
    curves.append(curve);print('seed',seed,'epoch',best_epoch,'validationRMSEnm',best**.5*target_sd,flush=True)
nominal=dict(mean=np.full(960,target_mean),guinier=physics,ridge=ridge.predict(X),mlp=np.mean(seed_preds,axis=0))
def mlp_predict(features):
    x=torch.tensor(features,dtype=torch.float32);out=[]
    for item in models:
        model=Network();model.load_state_dict({k:torch.tensor(v) for k,v in item['weights'].items()});model.eval()
        with torch.no_grad():out.append(model(x).numpy()*target_sd+target_mean)
    return np.mean(out,axis=0)
test=rows['test'];gtest=groups['test'];variants={}
noisy,noisy_sd,_,_=observe(exposure/9)
variant_raw={'nominal':raw[test],'noise3x':noisy.reshape(-1,96)[test],
    'background':raw[test]+.04*amplitude.reshape(-1)[test,None]}
variant_sd={'nominal':uncertainty[test],'noise3x':noisy_sd.reshape(-1,96)[test],'background':uncertainty[test]}
cropped=raw[test].copy();first=int(np.flatnonzero(q>=.25)[0]);cropped[:,:first]=cropped[:,first,None]
variant_raw['missing_lowq']=cropped;variant_sd['missing_lowq']=uncertainty[test]
for variant,v in variant_raw.items():
    x=scaler.transform(features(v));available=q>=.25 if variant=='missing_lowq' else None
    phys,se=guinier(v,variant_sd[variant],available)
    variants[variant]=dict(mean=np.full(len(test),target_mean),guinier=phys,ridge=ridge.predict(x),mlp=mlp_predict(x))
widths={};scores={};coverage={}
for name,pred in nominal.items():
    calerr=abs(pred[rows['calibration']]-Y[rows['calibration']]).reshape(-1,2).max(1)
    widths[name]=float(np.sort(calerr)[72]);scores[name]={};coverage[name]={}
    for variant,preds in variants.items():
        p=preds[name];valid=np.isfinite(p);err=abs(p-Y[test]).reshape(-1,2)
        scores[name][variant]=dict(RMSE_nm=float(np.sqrt(np.mean((p[valid]-Y[test][valid])**2))),
            MAE_nm=float(np.mean(abs(p[valid]-Y[test][valid]))),valid_predictions=int(valid.sum()),total=len(p))
        coverage[name][variant]=dict(simultaneous_object_coverage=float(np.mean(np.all(err<=widths[name],axis=1))),
            marginal_record_coverage=float(np.mean(err<=widths[name])),interval_width_nm=2*widths[name])
result=dict(seed=1717,groups={k:v.tolist() for k,v in groups.items()},rows={k:v.tolist() for k,v in rows.items()},
    q_nm_inverse=q.tolist(),geometry=dict(Rg_nm=rg.tolist(),aspect=aspect.tolist(),a_nm=axes_a.tolist(),c_nm=axes_c.tolist()),
    input_scaler=dict(mean=scaler.mean_.tolist(),scale=scaler.scale_.tolist()),target_scaler=dict(mean=target_mean,scale=target_sd),
    ridge=dict(coef=ridge.coef_.tolist(),intercept=float(ridge.intercept_)),models=models,training_curves=curves,
    conformal_halfwidth_nm=widths,scores=scores,coverage=coverage)

np.savez_compressed(OUT/'predictions.npz',q=q,Rg=Y,y=raw,sigma=uncertainty,formfactor=P,amplitude=amplitude,exposure=exposure,
    sample_counts=sample_counts,blank_counts=blank_counts,guinier_se=physics_se,**{'full_'+k:v for k,v in nominal.items()},
    **{variant+'_'+name:p for variant,preds in variants.items() for name,p in preds.items()},
    **{variant+'_raw':v for variant,v in variant_raw.items()},**{variant+'_sigma':v for variant,v in variant_sd.items()})


# The experimental file is a processed consensus profile; q is originally A^-1.
import hashlib,requests
SOURCE='https://www.sasbdb.org/media/intensities_files/SASDPT4.dat'
SOURCE_SHA='391686994c1c9ba5e85514962addbd169298cb6c4a288c644c370641ca3dfedb'
path=HERE/'SASDPT4.dat'
if not path.exists():
    response=requests.get(SOURCE,timeout=(15,45));response.raise_for_status();path.write_bytes(response.content)
assert hashlib.sha256(path.read_bytes()).hexdigest()==SOURCE_SHA
data=[]
for line in path.read_text().splitlines():
    parts=line.split()
    if len(parts)==3:
        try:data.append(list(map(float,parts)))
        except ValueError:pass
data=np.array(data);assert data.shape==(200,3) and np.all(data[:,1:]>0)
qe=data[:,0]*10;Ie=data[:,1];se=data[:,2]
def experimental_fit(qmax):
    mask=(qe>=.1)&(qe<=qmax+1e-12);A=np.column_stack([np.ones(mask.sum()),qe[mask]**2])
    logI=np.log(Ie[mask]);error=se[mask]/Ie[mask];Aw=A/error[:,None]
    cov=np.linalg.inv(Aw.T@Aw);coef=cov@(Aw.T@(logI/error))
    R=np.sqrt(-3*coef[1]);residual=(logI-A@coef)/error
    return dict(qmin=.1,qmax=qmax,n=int(mask.sum()),Rg_nm=float(R),I0=float(np.exp(coef[0])),
        conditional_Rg_se_nm=float(3*np.sqrt(cov[1,1])/(2*R)),
        reduced_chi2=float(residual@residual/(mask.sum()-2)),qmaxRg=float(qmax*R),
        intercept=float(coef[0]),slope_nm2=float(coef[1]),residual=residual.tolist())
fits=[experimental_fit(qmax) for qmax in [.4,.5,.6,.7,.8,.85,.9]];fit=fits[4]
result['experiment']=dict(entry='SASDPT4',doi='10.1107/S2059798322009184',source_url=SOURCE,sha256=SOURCE_SHA,
    rows=200,original_q_unit='angstrom^-1',analysis_q_unit='nm^-1',conversion=10,
    intensity='relative consensus intensity; solvent already subtracted',main_fit=fit,window_sensitivity=fits,
    uncertainty='Conditional WLS covariance using propagated point errors; residual and window sensitivity reported separately')
result['data_definition']=dict(objects=480,repeats=2,train_objects=240,validation_objects=80,calibration_objects=80,test_objects=80,
    calibration='73rd of80 objectmaxscores; twoobservations treated as one exchangeableobject',
    perturbations='Pairedheldoutobjects; N/9counts, +0.04*I0residualbackground, missingq<0.25nm^-1',
    missing_policy='Constant prefixfill forfixedgridlearners; excludeunobservedpointsfromGuinier; 1invalidGuinierslope retainedasNaN inNPZ and counteduncovered')
(OUT/'results.json').write_text(json.dumps(result,indent=2)+'\n',encoding='utf-8')
samples=dict(object_id=np.repeat(np.arange(480),2).tolist(),repeat=np.tile([0,1],480).tolist(),groups=result['groups'],
    q_nm_inverse=q.tolist(),Rg_true_nm=Y.tolist(),observed_intensity=raw.tolist(),standard_error=uncertainty.tolist(),
    amplitude=amplitude.tolist(),exposure=exposure.tolist(),sample_counts=sample_counts.tolist(),blank_counts=blank_counts.tolist())
(OUT/'samples.json').write_text(json.dumps(samples,separators=(',',':'))+'\n',encoding='utf-8')
(OUT/'experimental.json').write_text(json.dumps(dict(q_nm_inverse=qe.tolist(),intensity=Ie.tolist(),standard_error=se.tolist()),indent=2)+'\n',encoding='utf-8')

import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
plt.rcParams.update({'font.family':'DejaVu Sans','font.size':10,'axes.spines.top':False,'axes.spines.right':False,
    'axes.labelcolor':'#30453f','text.color':'#243d35','axes.edgecolor':'#bac7c0','xtick.color':'#53675e',
    'ytick.color':'#53675e','svg.hashsalt':'L17-scattering','figure.facecolor':'#fffef9','axes.facecolor':'#fffef9'})
names=['mean','guinier','ridge','mlp'];labels=['Training mean','Guinier fit','Ridge curve map','MLP curve map']
colors=['#a69b86','#b78150','#367e9d','#287b63']
def style(ax,title,xlabel,ylabel):
    ax.set_title(title,loc='left',fontsize=12,pad=13,weight='bold');ax.set_xlabel(xlabel);ax.set_ylabel(ylabel)
    ax.grid(axis='y',alpha=.18);ax.set_axisbelow(True)
def panel(i,fig,spec):
    if i==1:
        grid=spec.subgridspec(2,1,height_ratios=[2,1],hspace=.08)
        ax=fig.add_subplot(grid[0]);res=fig.add_subplot(grid[1]);mask=(qe>=.1)&(qe<=.8+1e-12)
        show=qe<=1.2;outside=show&~mask
        ax.errorbar(qe[mask]**2,np.log(Ie[mask]),yerr=se[mask]/Ie[mask],fmt='o',ms=4,color='#287b63',capsize=2,label='Fitted window')
        ax.scatter(qe[outside]**2,np.log(Ie[outside]),facecolor='white',edgecolor='#a0b3a6',s=22,label='Displayed, not fitted')
        gridq=np.linspace(0,1.2,180);ax.plot(gridq**2,fit['intercept']+fit['slope_nm2']*gridq**2,color='#b78150',lw=1.5)
        style(ax,'B  Low-angle fit and residuals','','ln I(q)');ax.legend(frameon=False,fontsize=8,loc='upper right')
        ax.text(.03,.05,f"Rg = {fit['Rg_nm']:.4f} nm\nConditional SE = {fit['conditional_Rg_se_nm']:.4f} nm",transform=ax.transAxes,fontsize=9)
        res.axhline(0,color='#a7b9ad',lw=1);res.axhspan(-2,2,color='#e9eee4');res.plot(qe[mask]**2,fit['residual'],'o-',ms=4,color='#287b63')
        style(res,'','q² (nm⁻²)','Residual / SE');ax.tick_params(labelbottom=False)
        ax.set_xlim(0,1.5);res.set_xlim(0,1.5)
        return
    ax=fig.add_subplot(spec)
    if i==0:
        ax.errorbar(qe,Ie,yerr=se,fmt='.',ms=3,color='#287b63',ecolor='#9db9a9',lw=.7)
        ax.axvspan(.1,.8,color='#ede5d4',alpha=.65,zorder=0);ax.set_xscale('log');ax.set_yscale('log')
        style(ax,'A  Lysozyme consensus: measured profile','q (nm⁻¹, log scale)','Relative intensity (log scale)')
        ax.text(.97,.94,'SASDPT4\n200 observed points\nShading: Guinier fit window',transform=ax.transAxes,ha='right',va='top',fontsize=9)
    elif i==2:
        k=int(test[0]);obj=k//2;rep=k%2;N=exposure[obj,rep]
        ax.plot(q,sample_counts[obj,rep]/N,color='#788b99',lw=1.1,label='Sample + buffer counts / N')
        ax.plot(q,blank_counts[obj,rep]/N,color='#b78150',lw=1.1,label='Buffer counts / N')
        ax.errorbar(q,raw[k],yerr=uncertainty[k],fmt='.',ms=3,elinewidth=.5,color='#287b63',label='Subtracted observation')
        ax.plot(q,amplitude[obj,rep]*P[obj],color='#223c35',ls='--',lw=1.5,label='Known synthetic signal')
        style(ax,'C  A controlled measurement','q (nm⁻¹)','Relative intensity');ax.legend(frameon=False,fontsize=8,loc='upper right')
        ax.text(.03,.19,f'Object {obj}, repeat {rep+1}\nRg = {Y[k]:.3f} nm',transform=ax.transAxes,fontsize=9)
    elif i==3:
        ax.plot([1.1,3.3],[1.1,3.3],color='#a3b5a8',lw=1.2)
        for name,label,color in zip(names[1:],labels[1:],colors[1:]):
            ax.scatter(Y[test],variants['nominal'][name],s=19,color=color,alpha=.55,label=label)
        style(ax,'D  Held-out sizes from curves','True synthetic Rg (nm)','Predicted Rg (nm)');ax.set(xlim=(1.1,3.3),ylim=(1.1,3.3))
        ax.legend(frameon=False,fontsize=9,loc='upper left');ax.text(.97,.04,'80 objects × 2 observations',transform=ax.transAxes,ha='right',fontsize=9)
    elif i==4:
        xx=np.arange(4);families=['nominal','noise3x','background','missing_lowq']
        for j,(name,label,color) in enumerate(zip(names,labels,colors)):
            values=[scores[name][s]['RMSE_nm'] for s in families]
            ax.bar(xx+(j-1.5)*.18,values,.16,color=color,label=label)
        ax.set_xticks(xx,['Nominal','Noise ×3','Background','Missing low q']);ax.set_yscale('log');ax.set_ylim(.01,1.5)
        style(ax,'E  Change the measurement conditions','','Rg RMSE (nm, log scale)')
        ax.legend(frameon=False,fontsize=8,ncol=2,loc='upper left')
        ax.text(.02,.03,'Missing q: Guinier 159 valid / 160 total',transform=ax.transAxes,fontsize=8,bbox=dict(facecolor='#fffef9',edgecolor='none',alpha=.9,pad=3))
    else:
        xx=np.arange(4);families=['nominal','noise3x','background','missing_lowq']
        ax.axhline(.9,color='#a7b6aa',ls='--',lw=1.2)
        for name,label,color in zip(names[1:],labels[1:],colors[1:]):
            values=[coverage[name][s]['simultaneous_object_coverage'] for s in families]
            ax.plot(xx,values,'o-',lw=1.5,ms=5,color=color,label=f'{label}: width {2*widths[name]:.3f} nm')
        ax.set_xticks(xx,['Nominal','Noise ×3','Background','Missing low q']);ax.set_ylim(-.04,1.2)
        style(ax,'F  Keep the calibrated intervals fixed','','Both repeats covered / object')
        ax.legend(frameon=False,fontsize=8,loc='upper right');ax.text(.02,.04,'90% target · 80 calibration objects\nPaired shifts use the same 80 test objects',transform=ax.transAxes,fontsize=8)
keys=['real_curve','guinier','measurement','prediction','shifts','coverage']
for i,key in enumerate(keys):
    fig=plt.figure(figsize=(8.2,5.1),layout='constrained');panel(i,fig,fig.add_gridspec(1,1)[0])
    fig.savefig(OUT/f'{key}.svg',metadata={'Date':None});plt.close(fig)
fig=plt.figure(figsize=(16.4,15.3),layout='constrained');grid=fig.add_gridspec(3,2,hspace=.09,wspace=.05)
for i in range(6):panel(i,fig,grid[i//2,i%2])
fig.savefig(OUT/'scattering_learning.svg',metadata={'Date':None})
fig.savefig(OUT/'scattering_learning.png',dpi=160,metadata={'Software':'L17 reproducible example'});plt.close(fig)
print(f"SASDPT4: 200 measured points; original q in A^-1 converted to nm^-1")
print(f"Fixed experimental window0.1–0.8nm^-1: Rg {fit['Rg_nm']:.6f}nm; conditional SE {fit['conditional_Rg_se_nm']:.6f}nm; reduced chi2 {fit['reduced_chi2']:.3f}")
print('Synthetic objects: 240train / 80validation / 80calibration / 80test; 2observations each')
for name,label in zip(names,labels):
    print(f"{label:20s}: nominal RMSE {scores[name]['nominal']['RMSE_nm']:.6f}nm; joint coverage {coverage[name]['nominal']['simultaneous_object_coverage']:.3f}")
print('Missing low q: 1of160Guinier slopes is positive; invalidestimate retained andcountedasuncovered')
print('Six figures, full generated observations and model weights: scattering_outputs/')
本次实际运行输出
seed 17 epoch 300 validationRMSEnm 0.024335942030751002
seed 27 epoch 300 validationRMSEnm 0.022239234707207005
seed 37 epoch 300 validationRMSEnm 0.018637651863738697
SASDPT4: 200 measured points; original q in A^-1 converted to nm^-1
Fixed experimental window0.1–0.8nm^-1: Rg 1.454507nm; conditional SE 0.001649nm; reduced chi2 7.094
Synthetic objects: 240train / 80validation / 80calibration / 80test; 2observations each
Training mean       : nominal RMSE 0.610350nm; joint coverage 0.850
Guinier fit         : nominal RMSE 0.036926nm; joint coverage 0.900
Ridge curve map     : nominal RMSE 0.023683nm; joint coverage 0.938
MLP curve map       : nominal RMSE 0.018221nm; joint coverage 0.950
Missing low q: 1of160Guinier slopes is positive; invalidestimate retained andcountedasuncovered
Six figures, full generated observations and model weights: scattering_outputs/
图A先展示真实溶菌酶记录。横纵轴采用对数尺度,便于把较宽q范围和逐渐变小的强度放在同一幅图中;阴影标出本节选择的拟合窗口。整条曲线包含200个点,其中只有15个进入当前Guinier拟合。把窗口清楚画出来,可以避免读者误以为某个尺寸是对全部q范围作同一种近似得到的。
一次运行 · 六幅结果图
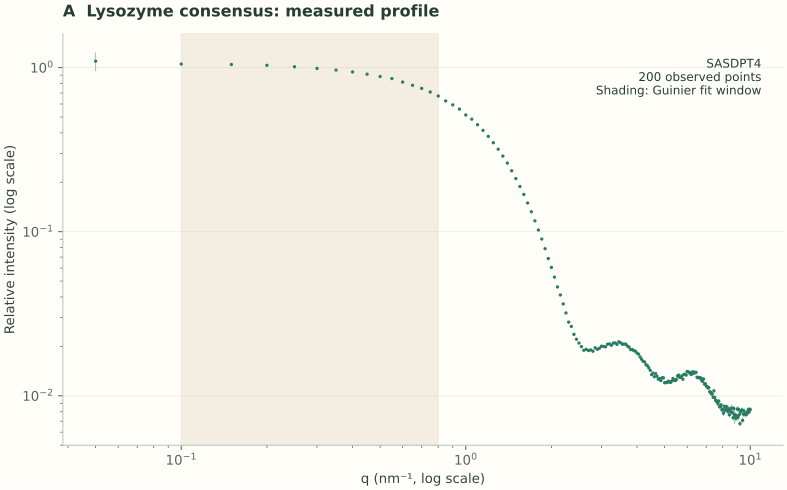
A|SASDPT4溶菌酶共识散射曲线,共200个测量汇总点;原文件Å⁻¹已换算为nm⁻¹,阴影为本节选用的低角度拟合窗口。
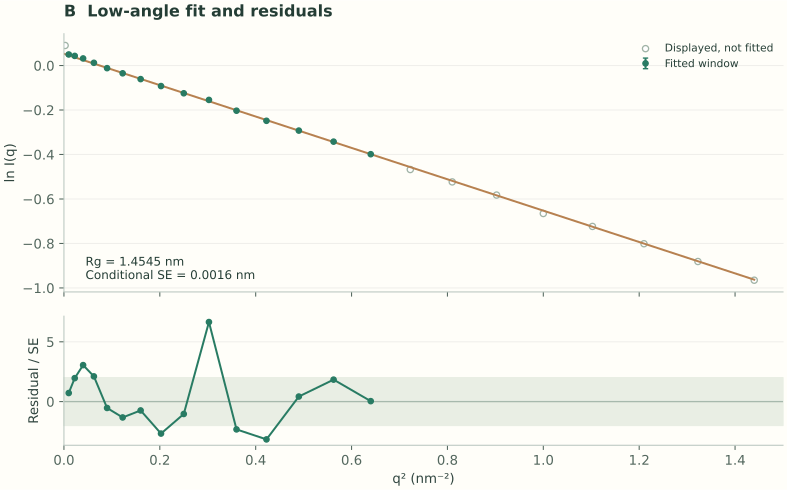
B|15个窗口内数据点的加权Guinier拟合与标准误差归一化残差;空心点显示窗口之外的观测。
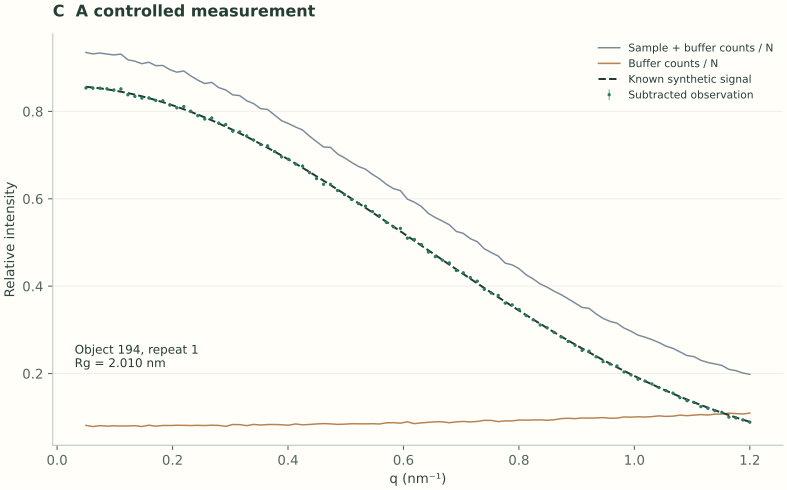
C|已知椭球信号经过样品与空白计数,形成扣除后的含噪观察;这幅图来自受控模拟。
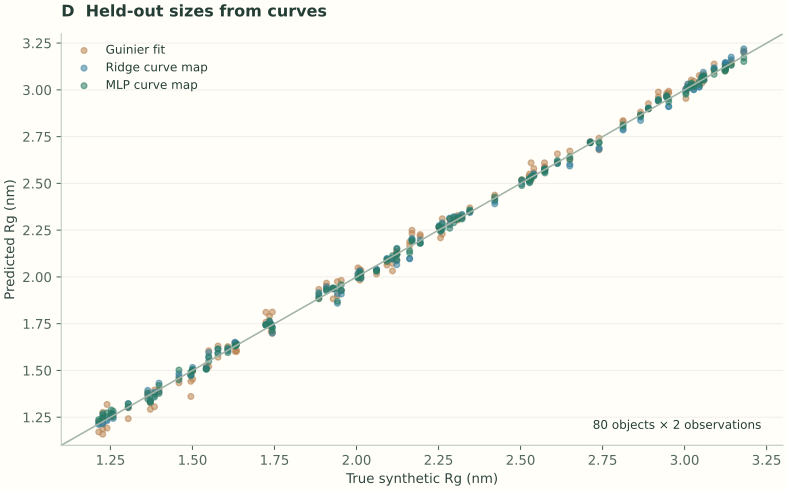
D|80个留出几何对象各有两次独立观测,比较Guinier、岭回归与三种子神经网络平均预测。
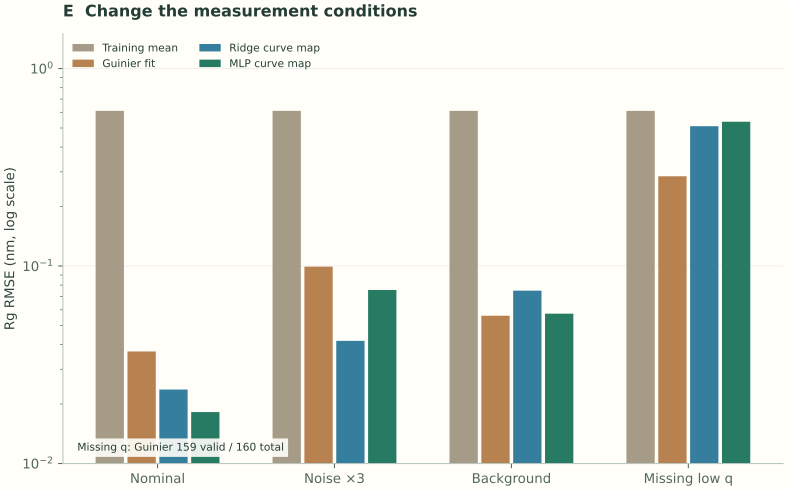
E|同一组测试对象在常规、约三倍噪声、残余背景及缺少低q条件下的误差;缺少低q时Guinier有159/160条有效结果。
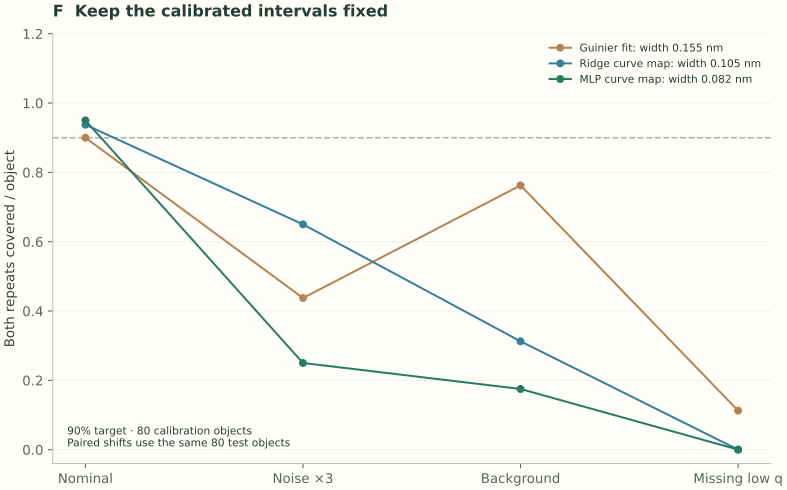
F|区间宽度由80个独立校准对象确定后保持不变,统计同一对象两次观测均落入区间的比例;虚线为90%设计目标。
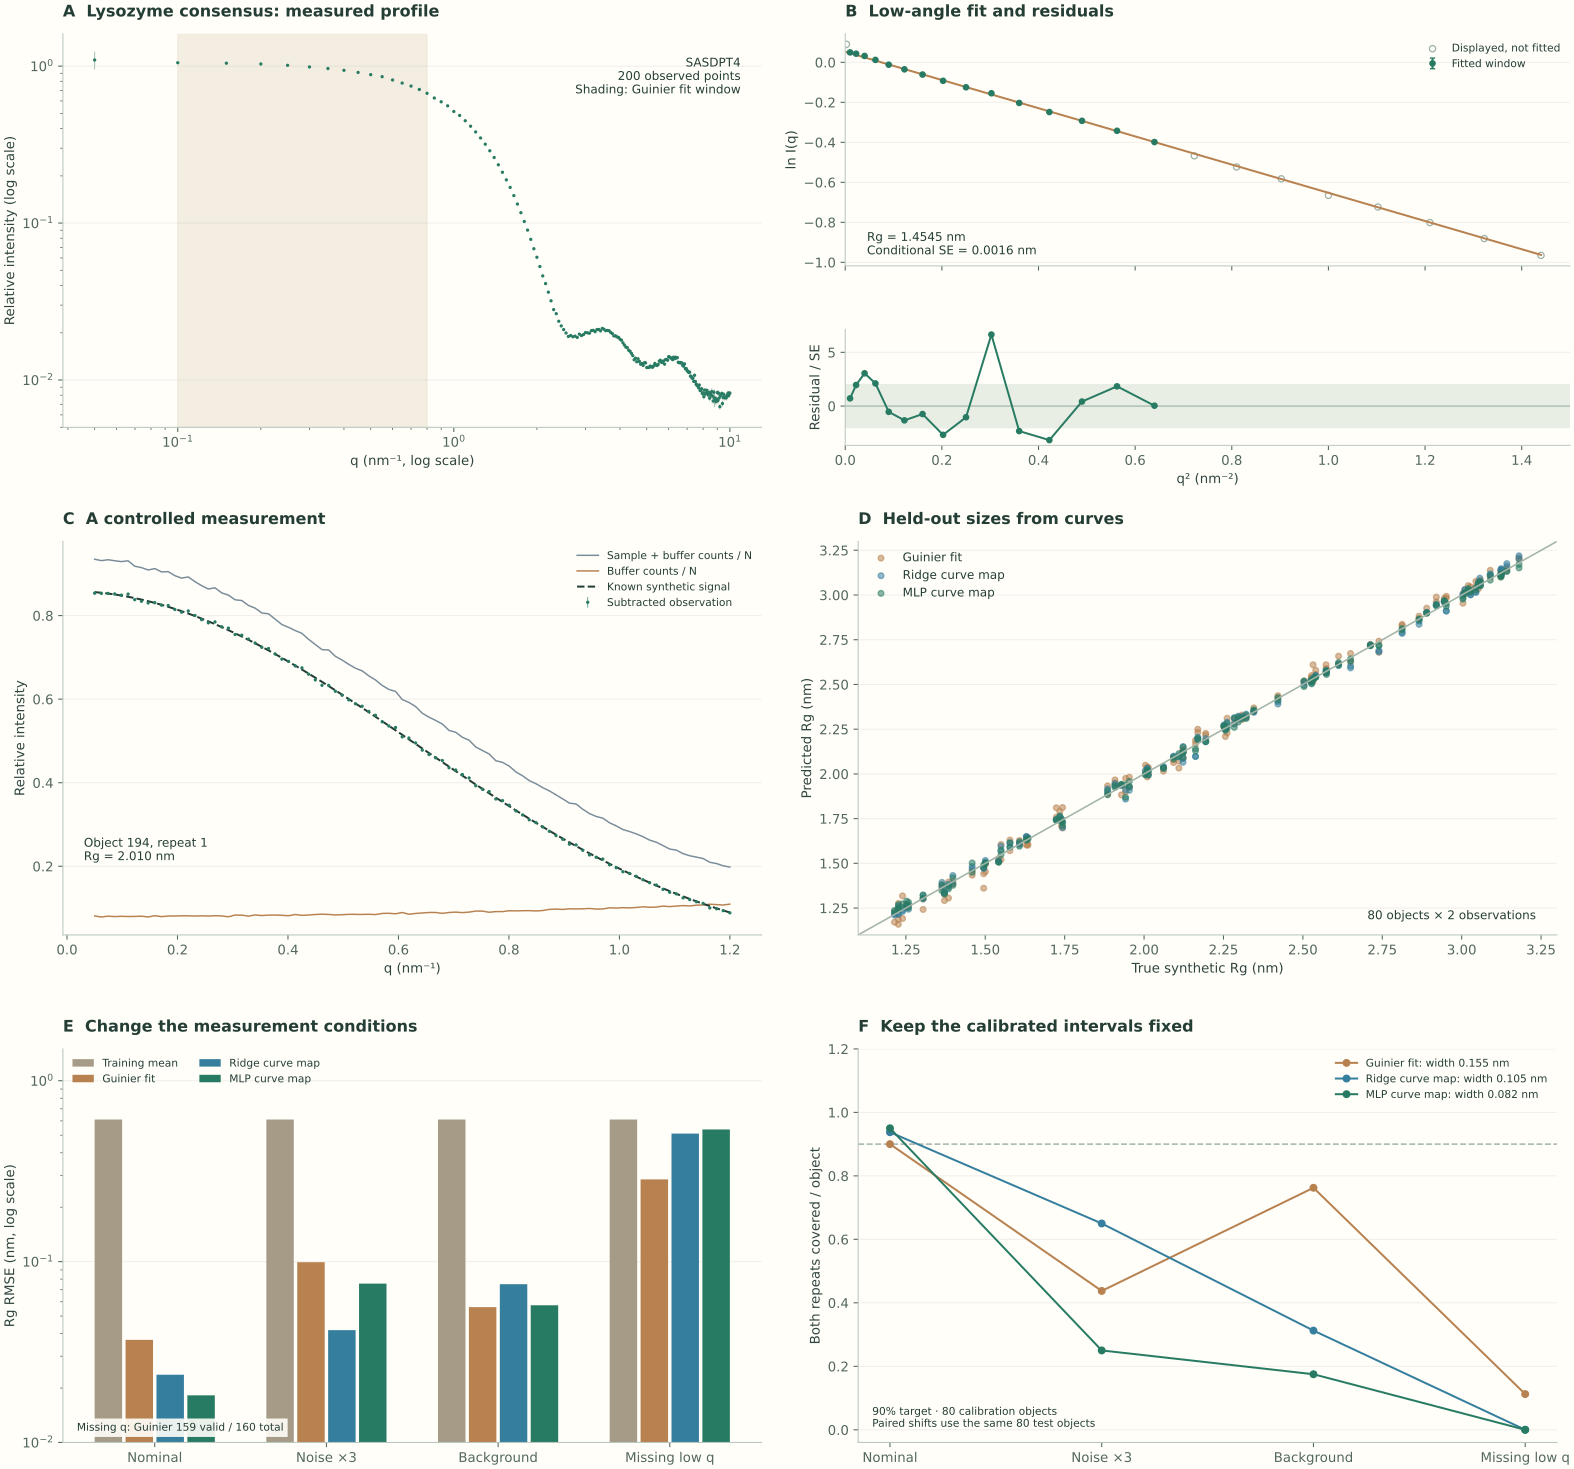
图B把拟合窗口放大,上方以q²为横轴、ln I为纵轴,下方用同一组点画标准化残差。先看上方,判断整体下降能否近似写成直线;再看下方,寻找误差是否连续偏正、连续偏负,或集中在窗口的一端。直线图容易显示总体趋势,残差图则把细微偏离放大,两者合起来帮助判断下一步该换窗口、检查背景,还是补充结构模型。本例得到的回转半径为1.4545 nm,对应所选数据窗口和处理方法;前面给出的窗口敏感性与误差定义,进一步说明哪些改变会影响这个估计。
图C转到受控测量。样品计数包含几何对象与缓冲背景,空白计数提供背景估计,两者相减以后得到模型实际接收的观测。已知理论曲线用虚线标出,可以直接看见随机波动从哪里进入。这个对照也解释了为什么保存原始计数与扣除后曲线都很有用:前者帮助重建噪声过程,后者用于具体反演;只有处理后的曲线时,就要从文件提供的误差和方法信息接着分析。
尺寸误差用RMSE表示,单位仍是纳米。帽子标记预测值,Ri是生成对象时已经知道的几何答案,M是有效预测数。先把每次误差平方,再求平均并开平方,可以让正负偏差都计入,也让较大的错误更显著。常规测试有80个独立对象,每个两次观测,共160条预测;独立对象数和记录条数同时保留,便于理解这些数字来自多大范围的结构变化。
图D中,靠近对角线表示预测接近已知尺寸。训练均值基线的RMSE约为0.6104纳米,Guinier拟合约0.0369纳米,岭回归约0.0237纳米,神经网络平均预测约0.0182纳米。神经网络在这组常规观测上表现最好,说明它学到的曲线组合能够利用超出固定低q直线的信息。误差下降对应的是本节规定的椭球、取向和计数分布,接下来就检查改变观测过程以后会发生什么。
图E首先把计数规模降到原来的九分之一,重新生成独立的样品与空白计数。按前面的平方根关系,相同归一化强度下的噪声约变为3倍。此时岭回归RMSE约0.0418纳米,神经网络约0.0756纳米,Guinier约0.0993纳米。岭回归超过神经网络,说明常规条件下的排名没有固定下来;网络也许利用了在低噪声时有帮助、在高噪声时较易扰动的曲线细节,可以通过增加不同计数条件的训练与评价继续研究。
第二种改变在扣除后曲线上加上相当于粒子零角度强度4%的正背景。此时Guinier、岭回归和神经网络的误差分别约为0.0560、0.0750和0.0574纳米。这个操作保持几何对象相同,专门改变测量处理,因此可以把误差变化与背景联系起来。改进路径也很具体:检查空白匹配,加入背景参数,或者让训练数据覆盖合理的残余背景范围,再用独立实验考察这些安排是否有效。
第三种改变去掉q小于0.25每纳米的观测。Guinier拟合只使用剩下的可用点;固定96维输入的学习模型,则把缺少的前缀暂时填成第一个可用强度,再按原流程归一化。填充值是这次数据处理的选择,原始观测位置仍用掩码区分。低q形状信息变少,加上输入尺度受填充影响,岭回归和神经网络的误差分别增大到约0.5104与0.5377纳米。更合适的下一步是显式输入缺失位置,训练适应不同q范围的模型,并评估恢复低角度测量带来的收益。
这一条件下Guinier也遇到了问题:160条记录中,有1条拟合出正斜率,无法得到实数回转半径。程序把它保留为失败记录,剩余159条有效预测的RMSE约0.2848纳米;覆盖率统计中,这个失败仍计作未覆盖。若只报一个平均误差,却省略有效结果数量,就会掩盖方法在弱信号或窄窗口下可能无法输出答案的情形。把失败位置保留下来,才能回到相应曲线寻找原因。
图F进一步检查预测区间。校准后固定的总宽度,Guinier约0.1554纳米,岭回归约0.1050纳米,神经网络约0.0821纳米。在常规80个测试对象上,要求同一对象两次观测都被覆盖时,比例分别为90%、93.75%和95%。神经网络在这次试验中同时给出较窄区间和较高覆盖;实际比例来自有限的80个对象,会随新抽样波动。
保持区间宽度不变,改为约3倍噪声后,神经网络的共同覆盖率降到25%;加入背景时为17.5%,缺少低q时为0。这里改变了校准数据原先代表的测量条件,预测误差增大而区间没有随之加宽。研究上可以据此增加按测量条件分层的校准数据,把计数与背景信息纳入预测,或者先检测新曲线是否落在已经验证的范围。区间是否有用,需要和它所覆盖的样品与采集条件一起判断。
回到最初的蛋白质研究,数据工作的终点是一条可以重走的推断路径:样品身份与环境对应原始文件,文件对应处理与单位,曲线对应拟合条件,模型对应训练对象与留出评价。发现误差后,沿这条路径能够判断应该补充空白、增加曝光、恢复低角度信息,还是扩展结构模型。《图神经网络:分子连接的表示与性质预测》将进一步讨论怎样把分子的连接和材料结构直接交给AI,让实验曲线、化学连接与空间关系共同参与研究。
资料与延伸阅读
Fenn等,1989:Electrospray Ionization for Mass Spectrometry of Large Biomolecules。Guinier,1939:La diffraction des rayons X aux très petits angles。相关散射分析条件与报告方法可参见Trewhella等的2017年生物小角度散射数据建模指南。
本节实验曲线来自Trewhella等,2022:A round-robin approach provides a detailed assessment of biomolecular small-angle scattering data reproducibility and yields consensus curves for benchmarking;数据入口为SASBDB SASDPT4,原始数据文件保留q、强度与误差。椭球散射模型可对照SasView的ellipsoid模型文档。
Rumelhart、Hinton与Williams,1986:Learning representations by back-propagating errors。预测区间的校准思路参见Angelopoulos与Bates:A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification。本节四组科学史图为根据相关问题绘制的原创原理示意,实验图与模型图分别由注明的数据和完整代码生成。