把分子、加工与样品放进同一个研究问题
从分子到样品:制备、加工与层级结构
同一团面,揉、擀、拉以后可以变成不同的形状;做好的面条再经过煮制和晾干,手感又会变化。原料给出了可能形成哪些结构的基础,加工决定其中哪些结构得以形成和保留。生物大分子材料也有这样的特点:知道一根丝线由什么蛋白质组成,还需要知道它怎样从含水原液变成纤维。本节沿着这条成形路线,认识牵伸、水分、时间尺度和层级结构,再用公开的丝纤维实验数据训练模型,比较制备前的工艺信息与制备后的结构信息分别能帮助我们预测什么。
01从含水原液到丝线,中间发生了什么
《纤维网络的承载机制:取向、拉伸与弯曲》从已经形成的纤维出发,研究方向和连接怎样影响网络承载。这一节把时间往前拨:纤维最初怎样形成,为什么同一种蛋白质可以得到不同的纤维?这对研究有直接用途。假如目标是一种能承受拉力又能适度伸长的丝线,我们可以改变蛋白质设计,也可以改变纺丝和后处理。要让AI帮助选择下一步实验,就要把这些可以调整的变量放回各自的位置,理解每一次调整可能影响的结构层级。
先从“溶液中有长链”想起。链并非一根根静止的细棒,它们在水中改变构象,与水分子和其他链相互作用。浓度提高以后,链彼此接近,运动也越来越受到邻近链的影响。进入一个狭窄的加工通道时,流动又使不同位置的材料以不同速度移动,这种速度差能够牵动链和已有的聚集体。与此同时,水含量、离子环境或酸碱条件的变化,会改变哪些分子接触更容易形成、哪些接触能够维持。
想象把一盆松散的细绳送入狭长的通道。细绳会逐渐沿通道排列,但只靠排列,还未必能形成取出后保持形状的一束绳。还需要绳与绳之间建立适当的联系,并让这些联系在离开通道后保留下来。这个比喻对应了纺丝中两个相互关联的问题:链怎样被组织起来,形成的组织怎样稳定下来。真实蛋白质靠分子间相互作用参与这些过程,流动和环境变化则影响接触发生的时机与位置。
第三节介绍过多肽主链,第九节讨论过蛋白质的局部结构。这里再次遇到β折叠:相邻的链段以特定的空间关系排列,并通过主链之间的氢键联系。它可以出现在同一条链的不同部分之间,也可以涉及不同分子的链段。理解丝蛋白时,重要的是把“局部链段形成什么结构”与“这些结构在整根纤维里怎样分布”接起来。一处局部有序区域的形成,并不自动规定整根纤维都沿同一方向排列。
Pauling与Corey在1951年提出β折叠结构模型,把多肽链的几何约束与氢键排列放到同一个模型中。读这段历史,可以先抓住一个朴素的问题:链段靠近以后,怎样摆放才同时满足键的几何和相互作用?局部结构的解释让我们能够进一步追问,许多这样的结构如何组成纤维中的有序区域,又如何与较柔顺的部分共同变形。科学问题就这样从分子尺度向材料尺度延伸。
在一根纤维中,有序区域可以提供较稳定的联系,较柔顺的区域则通过构象改变参与伸长。想象一串短硬节由柔性连接串起来:硬节都朝一个方向,还是交错排列;连接较短,还是较长;不同部分是否牢固相连,都会改变整串结构的受力。真实丝纤维还包含更连续、更多层次的组织,但这个比喻指出了几项可以测量的信息:有序区域的含量、尺寸、方向与分布。仅有含量相同,其他安排仍可能不同;后面的工艺比较就要追问,加工改变了其中哪些部分。
同样需要区分的是原料的来历。直接从天然来源取得、尽量保留原有状态的蛋白质原液,与经历溶解和再生过程的丝蛋白原液,可能在链的完整性和初始聚集状态上不同。两者都被称为丝蛋白,并不意味着加工起点相同。把它们放入数据表时,除了材料名称,还应记录取得原料与制备溶液的方法。否则,模型可能把原液本身的差异归到后来调整的某一个纺丝参数上。
Vollrath与Knight在2001年关于蜘蛛丝纺丝的研究,把含水蛋白质原液、流动中的结构变化和最终纤维联系起来。这条思路适合贯穿本节:成形是沿路径发生的一系列变化,最终样品保留了其中一部分历史。蜘蛛丝与蚕丝具有各自的蛋白质组成和成形过程;后面的数据例子使用蚕丝来源原液,具体条件按那项实验解释。这里借助历史研究建立的是“沿过程理解结构”的方法。
这也解释了为什么材料研究经常需要同时看几种图。显微图像可能让我们看见纤维和原纤维的形貌,光谱提供局部结构的线索,拉伸曲线则记录整根试样怎样响应载荷。它们像是从不同距离拍摄同一个成形结果:远景显示整体形状,近景显示局部组织,各自回答一个尺度上的问题。把这些信息连起来,才能提出有针对性的加工调整,例如改变牵伸时机,或在结构固定以前给链更多重排时间。
02把“拉得更快、干得更多”写成可比较的过程
“这次拉得比较多”是直观描述,放进实验记录和模型时还要再明确一步:在哪一段拉,入口与出口各有多快?连续纺丝常用牵伸比描述两个位置之间的速度关系。若材料进入这一区域时较慢,离开时较快,后面的一段便持续把前面的材料拉开。可以想象两组传送轮夹着同一段柔软材料,后轮转得更快,于是这段材料在向前移动的同时被拉长。
λd读作“lambda下标d”,这里是一个没有单位的比值。vin和vout分别表示入口与出口的材料线速度,可以都用毫米每秒,也可以都用米每分钟。假设入口每秒送入2毫米,出口每秒带走8毫米,则λd=8/2=4。使用辊面速度作为材料速度时,还需要材料与辊之间没有明显滑移;若发生打滑,设备显示的转速与材料实际经历的牵伸就需要分开记录。
对一段固定质量、均匀变形的材料,也可以比较拉伸后的长度与原长。连续工艺中的速度比和这类长度比在相应稳态条件下相联系,但记录时最好保留测量方式,因为湿纤维可能同时失水、收缩或在不同区域继续变形。一个“4倍”的数字只有配上起点和终点才完整:是在凝固浴里比较,还是在离开浴液以后比较,或者指最终干燥样品相对于某个初始状态的长度?这些定义会影响模型怎样合并不同实验。
再看截面。把一段体积不变的橡皮泥拉长,横截面就会缩小,因此容易得到“速度快4倍,面积变成四分之一”的直觉。含水纺丝还多了一件事:水可以离开材料。流过入口与出口的总混合物质量未必相同,聚合物质量在没有流失时却应当守恒。计算时先选对守恒对象,就能把拉长造成的变细与浓缩造成的变细放到同一个式子里。
式中的上点表示单位时间的流量,ṁp是每秒通过截面的聚合物质量。w是聚合物质量分数,例如10%写成0.10;ρ是聚合物与水组成的混合物密度;A是截面积;v是截面平均轴向速度。ρ乘A再乘v,单位为千克每秒,给出混合物的质量流率,再乘w便得到其中聚合物的部分。把入口和出口的wρAv设为相等,移项以后,就得到面积比的表达式。
做一个便于心算的例子:入口与出口密度相同,聚合物质量分数从10%增加到20%,速度比为4。那么面积比等于0.10除以0.20,再除以4,结果是1/8。若入口面积是800平方微米,出口面积就是100平方微米。这里没有假定截面一定是圆形,面积关系对其他截面形状也成立。若想再换算直径,便要额外说明圆形近似;对于扁带或弯月形截面,直接使用面积更清楚。
出口更快,水更少,截面会怎样变化?
入口聚合物质量分数设为10%,出口为20%,两端混合物密度相同;速度比4,对应截面积比1/8。
上面的交互图把两端密度设为相同,便于单独观察速度与浓度的作用。调整滑块时,可以检查出口面积缩小多少,再把面积比、速度比和质量分数比相乘,结果始终为1。真实工艺可以把密度变化也填进同一式子。若实测流率对不上,则沿着进料、溶剂交换、聚合物流失或截面测量逐项检查,守恒关系就成为整理实验记录的工具,而不仅是一道代数题。
加工还涉及快慢。想象慢慢拉开一团缠在一起的细绳,绳之间可能来得及滑动和重新安排;突然拉动时,原有缠绕更容易暂时保留下来。分子链的调整也需要时间。第八节中的松弛时间τ描述某一种结构偏离原状态以后恢复的快慢;加工中的局部伸长速率则描述流动改变形状的快慢。比较两者,可以判断结构重排与外部牵动哪一个过程更急。
Wi称为Weissenberg数。τ以秒计,伸长速率ε̇以每秒计,两者相乘后没有单位。若某种结构的松弛时间为0.2秒,局部伸长速率为每秒10,则流动时间为0.1秒,Wi=2;若速率降到每秒0.5,流动时间变成2秒,Wi=0.1。前一种情况下,流动改变形状比这项结构松弛更快;后一种情况下,结构在流动发生时有更多时间调整。链和聚集体可能各有不同的松弛时间,因此需要说明比较的是哪一种过程。
牵伸比给出前后状态的速度关系,Wi帮助描述沿途的快慢,两者互相补充。两条工艺都能达到相同的速度比,却可以通过不同的加工区长度与速度分布实现,也就可能给分子不同的调整时间。后面的公开数据提供四档牵伸比,我们据此比较工艺条件;若要建立更细的加工模型,下一步可以补入局部速度分布、停留时间和原液的松弛测量,使输入逐渐接近分子实际经历的过程。
03从丝纤维走向生物复合材料:排列和界面也在传力
分子形成局部结构,局部结构组成原纤维,原纤维再组成更粗的纤维,这种逐级组织称为层级结构。层级增加以后,会出现新的几何和连接问题。分子尺度上的氢键与纤维之间的接触当然不同,但两者都影响力怎样从一个部分传到另一个部分。研究时可以先问:外力从哪里进入样品,经过哪些结构,在哪些位置需要跨越界面?这个问题能够把显微图像中的形状与加载实验中的变化联系起来。
珍珠层提供了一个便于观察的生物复合材料例子。它包含矿物片层和有机组分,硬的部分与较柔顺的部分以特定方式组织在一起。把它画成砖块与砖缝,有助于理解片层之间需要传力;继续放大,“砖缝”本身也有结构。这里的有机大分子参与组织界面,因而研究对象从单一蛋白质纤维延伸到有机—无机复合体系,原来关于分子相互作用和层级连接的问题仍然适用。
Yao等在2008年在线发表的红鲍珍珠层研究,结合成像和局部力学测量,观察到有机界面内部的多层结构及其响应差别。这使“矿物之间夹着一层有机物”的概括变得更具体:界面可以包含不同的层,接触位置和局部性质值得分别研究。我们因此获得一个适用于材料建模的问题:当一个较厚的结构被简化成一道界面时,哪些内部差别需要保留为模型变量?
先用一个理想的力学例子理解排列为什么重要。把两种线弹性材料想成两类弹簧,一种较硬,一种较软。如果让它们并排连接在同一对刚性夹板之间,两者经历相同的伸长比例,硬的部分会承担较多的力。如果把它们沿拉伸方向首尾连接,传过两者的力相同,较软的一段就会贡献较多的伸长。同样的成分比例,因为传力路径不同,整体响应便会改变。
Eh和Es分别是硬相与软相的模量,模量可以理解为在线性小变形范围内产生单位应变所需的应力。φ是硬相体积分数,所以软相的比例是1−φ。第一式对应等应变的并联模型:总力是各部分所受力之和,因此按各自所占比例平均模量。第二式对应等应力的串联模型:各段伸长相加,所以平均的是模量的倒数,最后再取倒数得到整体模量。
假设两相模量分别为10吉帕和1吉帕,硬相占80%。并联结果为0.8×10+0.2×1=8.2吉帕;串联结果为1/(0.8/10+0.2/1),约3.57吉帕。两个结果使用完全相同的成分。这个算例暂时忽略横向变形的耦合、界面滑移和损伤,目的在于分清等应变和等应力这两种连接方式。实际珍珠层中,片层的长宽、错位、界面剪切和局部变形还会进一步影响响应。
对AI来说,这个例子给出了一个很实用的输入检查。如果两份样品的成分比例相同,却具有不同的排列,而模型只能读到成分,那么它收到的两行输入完全一样,自然也只能给出一样的预测。增加数据行数无法自动补回从未记录的结构差别。需要先把排列、界面或加工路径转成可区分的输入,再讨论使用线性模型、树模型还是神经网络。《纤维网络的承载机制:取向、拉伸与弯曲》从图像提取取向,正是补充这类信息的一种办法。
水也应放在结构与环境的连接处理解。它可以改变链段活动的难易,参与氢键环境,并影响不同部分之间的接触。对含水生物材料,测试前怎样调湿、调湿多久、纤维两端是否允许收缩,都会改变实际测量的状态。可以把“刚制成的材料”和“放在某种湿度下达到测试状态的材料”看成过程中的两个节点,在数据表中分别记录,便于研究制备和使用环境各自的作用。
Greco等在2021年研究仿生蜘蛛丝中的酪氨酸残基与湿度响应,比较了明确的蛋白质序列变体,并区分纤维能够自由收缩与两端受约束的实验安排。这种设计帮助我们理解,序列、环境和边界条件需要一起描述。读到某种丝纤维吸湿后改变长度时,应继续追问它在什么状态下改变,以及随后怎样测量。把这些条件接入模型,才能让预测对应一个能够重复的研究步骤。
回到本节的主线,层级结构为“为什么同样的原料得到不同样品”提供了中间环节。工艺改变链的组织与接触,组织又影响力怎样传递;表征实验让其中一些环节变成可测量的数据。我们可以沿这条关系安排AI任务:制备前根据可设置的条件选择候选,制备后根据已经测得的结构筛选样品,再把性能结果反馈到下一轮工艺设计。每一步可获得的信息不同,模型的输入也就应当随之改变。
04AI在什么时候得到信息,就在什么时候帮助研究
现在把问题落到一组真实数据。Frydrych等2019年的丝纤维研究,使用蚕丝来源的蛋白质原液,在四档后牵伸条件下制备纤维。我们读取作者公开工作簿中的断裂记录,并把论文独立测得的结构比例接进分析。这样可以比较两种有实际用途的预测:只知道计划采用的牵伸条件时,预计会得到怎样的性能;样品制成并完成结构表征后,预测又如何变化。
先把目标定义清楚。拉伸仪记录的是力和位移,材料研究常将它们除以初始尺寸,转成工程应力与工程应变。应力帮助比较不同粗细的试样,应变帮助比较不同初始长度的试样。这一步像把购物时的总价换算成每千克价格:除去数量以后,比较的问题更明确。但换算使用的尺寸本身也是一次测量,其来源需要保存在数据里。
F是拉力,A0是初始截面积;L0是两处测量标记之间的初始距离,也叫标距,L是拉伸后的对应长度。假设0.03牛的力作用在100平方微米的截面上,先把面积换成10−10平方米,得到应力3×10⁸帕,即300兆帕。若10毫米的标距拉到12毫米,应变为(12−10)/10=0.2,以百分数表示就是20%。这两种工程量都以初始尺寸作为分母。
本例的测试在50%相对湿度、室温下进行,初始标距为10毫米,工程应变率为每分钟20%。原研究使用各工艺条件的平均截面积计算应力,所以面积测量与应力数值之间已经存在换算关系。我们将平均面积画出来帮助理解样品,却把AI的输入限定为牵伸比,以及另一组实验独立测得的β折叠比例。这样,读者能够逐项看清新增输入到底提供了什么信息。
工作簿中的四档牵伸比分别为7.5、10、12.5和15,每档有27条可读取的断裂记录,共108条;模型目标按这些记录计算。论文表1给出的力学样本数为每档28,正文与附件的记录口径在这里分别保留。长长的代表性拉伸曲线则有数千个采样点,它们描述同一次测试随伸长的变化。把一条曲线采得更密,会增加对这次过程的观察细节,独立工艺条件仍是原来的那一档。
本节以“预测一档没有参与训练的工艺条件”为问题,因此先将每档的断裂记录求平均,得到四行学习数据。每次取三档训练,留下完整的一档测试,轮流做四次。这样,某一档条件中的27条记录始终待在一起。若把同一档的部分试样放进训练,另一部分放进测试,回答的会更接近“已见工艺下新试样的表现”,它与现在的问题各有用途,需要按研究目的选择。
最简单的参照模型只知道原料身份。在这组数据中,原料身份没有随四档工艺改变,因此它给留出条件的预测,就是其余三档的目标平均值。这个参照有明确作用:它告诉我们,只把样品登记为同一种丝蛋白,会丢掉多少工艺相关的信息。随后加入牵伸比,使用岭回归预测;再加入β折叠比例,仍使用同一类回归。比较过程中,输入信息如何变化便清楚可见。
xij是第i个条件的第j项输入,μj和sj是当前训练条件中这一项的均值和标准差。减去均值、再除以标准差以后,得到没有单位的zij。例如三档训练牵伸比为7.5、10、12.5,均值是10,按三个数的平方偏差平均计算,标准差约2.04;待预测的15倍条件便转换成(15−10)/2.04≈2.45。均值和标准差从训练数据计算,随后原样用于留出的条件。
预测式中的b是截距,aⱼ是各项输入的系数。训练要在两件事之间取得平衡:预测贴近测量,同时避免靠很大的正、负系数相互抵消来适配少量数据。损失的第一项把训练误差平方后相加,第二项把各系数平方后相加并乘α;系数越大,第二项的代价越高,这就是岭回归的正则化。本节固定α=1,截距不受这项惩罚。两个目标分别用兆帕和百分数拟合,对应系数保留各自的目标单位,报告误差时也分别回到这两个单位。这样读到误差数字,才能知道它相当于多大的强度或伸长差别。
Hoerl与Kennard在1970年的岭回归论文讨论了输入之间相关时估计不稳定的问题。本例正好提供直观联系:牵伸比增加的同时,β折叠比例也增加,两个输入带有重叠的信息。若一条预测关系写成“较大的正系数乘第一项,再减去较大的第二项”,两项可以互相抵消而贴近少数观测,输入稍有变化却会引起较大差别。惩罚系数幅度,便是在拟合过程中加入一种稳定约束。
另一个模型是随机森林。可以把一棵回归树想成连续的分组判断:牵伸比是否小于某个阈值,若是走左边,若否走右边,最后在一个叶子上用其中训练条件的目标均值作预测。阈值由训练数据选取。Breiman在2001年系统讨论随机森林,将多棵带有随机性的树组合起来。本节用不同的自助抽样构建树,让读者比较分段预测与线性趋势在新条件处的行为。
Tm(x)表示第m棵树对输入x的输出,M是树的数量;粗体y表示这里同时输出强度和应变两个数。每个随机种子训练100棵最大深度为2的树,三个种子的结果再平均。每棵树从三档训练条件中有放回地抽取三行,所以可能重复抽到某一档。由于输入只有牵伸比一项,随机性来自抽样;树的联合平方误差保留兆帕与百分数的数值尺度,强度对分裂选择的影响较大。
树的叶子输出训练目标的均值,因此这种回归树及其平均结果落在训练目标范围内。若新工艺延续着上升趋势,却已经走到训练范围之外,树也会沿已有分支落入某个叶子,预测不会自动沿趋势继续升高。岭回归的直线可以延伸到范围之外,但延伸是否合理还需要测量检验。两种行为都能在结果图中直接看见,比只记住某个模型“更强”更有助于安排下一轮实验。
β折叠比例的加入还改变了任务发生的时间。准备制备15倍牵伸样品时,牵伸比已经可以写进计划,实际结构比例则要等样品制成并测量以后才知道。因此,双输入模型适合结构表征后的性能筛选;单输入模型适合比较已有范围附近的工艺候选。若希望制备前就利用结构信息,可以进一步建立“工艺到结构”的模型,再将其输出接入性能预测,并在留出条件上检验这整条预测链。
05运行完整例子,读懂四档工艺留下的证据
下面的代码从作者公开的数据地址取得工作簿,并核对文件内容的SHA-256值。它读取断裂点和代表性曲线,计算每档的均值与试样标准差,执行四次整档留出,最后绘制六幅图。第一次运行需要下载数据;把同一份Data.xlsx放在运行目录中以后,代码便会直接读取它。
读代码时可以顺着数据走:observations保存108条断裂记录,groups保存四档条件的统计,X包含牵伸比和结构比例,Y包含两个性能目标。每次循环先确定留下哪一档,再用另外三档计算标准化参数和训练模型。代码另用线性方程的直接求解复算岭回归,检查它与软件模型给出的预测相同。这样,公式、模型调用和最终图中的数值能够相互对应。
"""Silk processing: reproduce a four-condition, group-held-out experiment.

Install: pip install numpy matplotlib openpyxl requests scikit-learn
Source: Frydrych et al. (2019), doi:10.1038/s41598-019-51589-9.
Original workbook: doi:10.5281/zenodo.3457387 (read without modifying it).
"""
from pathlib import Path
import hashlib
import json
import numpy as np
import requests
from openpyxl import load_workbook
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
from sklearn.ensemble import RandomForestRegressor
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

OUT = Path("silk_outputs")
OUT.mkdir(exist_ok=True)
DATA = Path("Data.xlsx")
URL = "https://zenodo.org/records/3457387/files/Data.xlsx?download=1"
SHA = "ae467d3711b0e4c78a1c66c368ebb1d94a9c64070f1f60c87f7a57e0e44456f6"
if not DATA.exists():
    response = requests.get(URL, timeout=90)
    response.raise_for_status()
    assert hashlib.sha256(response.content).hexdigest() == SHA
    DATA.write_bytes(response.content)
assert hashlib.sha256(DATA.read_bytes()).hexdigest() == SHA

# One row of the learning table is one complete processing condition.
# Point clouds contain 27 records per condition in the supplied workbook.
wb = load_workbook(DATA, read_only=True, data_only=True)
sheet = wb["Figure 5A - Tensile"]
rows = list(sheet.iter_rows(values_only=True))
draw = np.array([7.5, 10., 12.5, 15.])
beta = np.array([.29, .33, .35, .36])  # independent FTIR, paper Table 1
area = np.array([586., 311., 186., 102.])  # um², descriptive only
observations, curves, groups = [], [], []
for k in range(4):
    points, curve = [], []
    for row_number, row in enumerate(rows[2:], 3):
        strain, stress = row[4*k+2:4*k+4]
        if isinstance(strain, (int, float)) and isinstance(stress, (int, float)):
            observations.append(dict(condition=k, source_row=row_number,
                source_columns=[4*k+3, 4*k+4], draw_ratio=float(draw[k]),
                fracture_stress_MPa=float(stress), strain_percent=float(strain)))
            points.append([stress, strain])
        strain, stress = row[4*k:4*k+2]
        if isinstance(strain, (int, float)) and isinstance(stress, (int, float)):
            curve.append([strain, stress])
    points = np.asarray(points)
    assert len(points) == 27 and np.isfinite(points).all()
    groups.append(dict(draw_ratio=float(draw[k]), n=len(points),
        beta_fraction=float(beta[k]), mean_area_um2=float(area[k]),
        mean=points.mean(0).tolist(), sample_sd=points.std(0, ddof=1).tolist()))
    curves.append(np.asarray(curve, dtype=float))
wb.close()
X = np.column_stack([draw, beta])
Y = np.array([g["mean"] for g in groups])  # [MPa, percent]
SD = np.array([g["sample_sd"] for g in groups])
names = ["feedstock_mean", "draw_ridge", "draw_beta_ridge", "draw_forest"]
labels = ["Feedstock mean", "Draw: ridge", "Draw + structure", "Draw: forest"]
colors = ["#929c99", "#347a8c", "#247765", "#b87c4f"]
predictions = {name: np.zeros_like(Y) for name in names}
folds, fitted = [], []
ridge_check = 0.
for test in range(4):
    train = np.array([i for i in range(4) if i != test])
    assert test not in train
    predictions["feedstock_mean"][test] = Y[train].mean(0)
    record = dict(test_condition=test, train_conditions=train.tolist(), models={})
    models = {}
    for name, columns in [("draw_ridge", [0]), ("draw_beta_ridge", [0, 1])]:
        scaler = StandardScaler().fit(X[train][:, columns])
        xt = scaler.transform(X[train][:, columns])
        xe = scaler.transform(X[[test]][:, columns])
        model = Ridge(alpha=1.).fit(xt, Y[train])
        predictions[name][test] = model.predict(xe)[0]
        center = Y[train].mean(0)
        coefficient = np.linalg.solve(xt.T @ xt + np.eye(len(columns)),
                                      xt.T @ (Y[train] - center))
        independent = (xe @ coefficient + center)[0]
        ridge_check = max(ridge_check, float(np.max(abs(independent - predictions[name][test]))))
        record["models"][name] = dict(columns=columns,
            mean=scaler.mean_.tolist(), scale=scaler.scale_.tolist(),
            coef=model.coef_.tolist(), intercept=model.intercept_.tolist())
        models[name] = (scaler, model)
    forests = []
    for seed in [15, 25, 35]:
        # Joint two-output squared-error trees; outputs retain MPa and percent.
        # One input feature means bootstrap sampling supplies the randomness.
        forest = RandomForestRegressor(n_estimators=100, max_depth=2,
            min_samples_leaf=1, max_features=1., bootstrap=True,
            random_state=seed, n_jobs=1).fit(X[train, :1], Y[train])
        forests.append(forest)
    seed_predictions = np.array([m.predict(X[[test], :1])[0] for m in forests])
    predictions["draw_forest"][test] = seed_predictions.mean(0)
    record["models"]["draw_forest"] = dict(seeds=[15, 25, 35],
        predictions=seed_predictions.tolist(), n_estimators=100, max_depth=2)
    models["draw_forest"] = forests
    folds.append(record)
    fitted.append(models)
assert ridge_check < 1e-10

def score(predicted, observed):
    error = predicted - observed
    return dict(RMSE=np.sqrt(np.mean(error**2, axis=0)).tolist(),
                MAE=np.mean(abs(error), axis=0).tolist())

raw_y = np.array([[r["fracture_stress_MPa"], r["strain_percent"]] for r in observations])
raw_group = np.array([r["condition"] for r in observations])
scores = {name: dict(condition_mean=score(p, Y),
    individual=score(p[raw_group], raw_y),
    interpolation=score(p[[1, 2]], Y[[1, 2]]),
    extrapolation=score(p[[0, 3]], Y[[0, 3]])) for name, p in predictions.items()}
result = dict(source=dict(paper="10.1038/s41598-019-51589-9",
    data="10.5281/zenodo.3457387", sha256=SHA, sheet=sheet.title),
    groups=groups, targets=["fracture_stress_MPa", "strain_percent"],
    predictions={k: v.tolist() for k, v in predictions.items()}, scores=scores,
    folds=folds, checks=dict(independent_ridge_max_error=ridge_check,
        raw_records=len(observations), conditions=4,
        representative_curve_points=[len(c) for c in curves]),
    protocol=dict(split="leave one complete draw condition out",
        alpha=1., structure_input="independent post-characterization FTIR fraction",
        forest_loss="joint squared error in MPa and percent; target units retained",
        measurement="50% RH, ambient temperature, 10 mm gauge, 20%/min strain rate"))
for filename, value in [("results.json", result), ("samples.json", observations),
                         ("curves.json", [c.tolist() for c in curves])]:
    (OUT / filename).write_text(json.dumps(value, ensure_ascii=False, indent=2) + "\n", encoding="utf-8")

# All panels use the same executed data. SVG is deterministic and editable.
plt.rcParams.update({"font.family": "DejaVu Sans", "font.size": 10,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.labelcolor": "#30453f", "text.color": "#243d35",
    "axes.edgecolor": "#bac7c0", "xtick.color": "#53675e",
    "ytick.color": "#53675e", "svg.hashsalt": "L15-silk",
    "figure.facecolor": "#fffef9", "axes.facecolor": "#fffef9"})
condition_colors = ["#bc8b58", "#699a89", "#3b8393", "#334f73"]

def style(ax, title, xlabel="Draw ratio", ylabel=None):
    ax.set_title(title, loc="left", fontsize=12, pad=14, weight="bold")
    ax.set_xlabel(xlabel)
    if ylabel:
        ax.set_ylabel(ylabel)
    ax.grid(axis="y", alpha=.18)
    ax.set_axisbelow(True)

def panel(i, fig, spec):
    if i in [1, 4, 5]:
        inner = spec.subgridspec(1, 2, wspace=.08)
        axes = [fig.add_subplot(inner[j]) for j in range(2)]
    else:
        axes = [fig.add_subplot(spec)]
    ax = axes[0]
    if i == 0:
        for k, curve in enumerate(curves):
            ax.plot(curve[:, 0], curve[:, 1], color=condition_colors[k], lw=1.6,
                    label=f"{draw[k]:g}x")
            v = raw_y[raw_group == k]
            ax.scatter(v[:, 1], v[:, 0], color=condition_colors[k], s=18, alpha=.45)
        style(ax, "A  Curves and fracture records", "Engineering strain (%)", "Engineering stress (MPa)")
        ax.set(xlim=(0, 85), ylim=(0, 510))
        ax.legend(ncol=4, frameon=False, fontsize=9, loc="upper right")
        ax.text(.98, .04, "4 representative curves\n108 fracture records", transform=ax.transAxes,
                ha="right", va="bottom", fontsize=9)
    elif i == 1:
        for a, value, sd, title, unit, color in zip(axes, [area, beta*100],
                [[118, 56, 31, 20], [2, 2, 2, 1]],
                ["B  Cross-section", "FTIR structure"],
                ["Mean area (µm²)", "Beta-sheet fraction (%)"], ["#347a8c", "#247765"]):
            a.errorbar(draw, value, yerr=sd, fmt="o-", color=color, capsize=3)
            style(a, title, ylabel=unit)
            a.set_xticks(draw, ["7.5", "10", "12.5", "15"])
            a.tick_params(axis="x", labelsize=8)
        axes[0].text(.96, .92, "n = 120", transform=axes[0].transAxes, ha="right", fontsize=9)
        axes[1].text(.06, .05, "n = 3\nMean ± SD", transform=axes[1].transAxes, fontsize=9)
    elif i in [2, 3]:
        target = i-2
        ax.errorbar(draw, Y[:, target], yerr=SD[:, target], fmt="o", color="#263d35",
                    capsize=4, ms=6, label="Observed mean ± SD", zorder=5)
        for name, label, color, marker in zip(names, labels, colors, ["v", "s", "D", "^"]):
            ax.plot(draw, predictions[name][:, target], marker=marker, color=color,
                    lw=1.3, ms=4, label=label, linestyle="--")
        style(ax, ["C  Predict fracture stress", "D  Predict strain at break"][target],
              ylabel=["Engineering stress (MPa)", "Engineering strain (%)"][target])
        ax.set_xlim(6.9, 15.6)
        ax.set_ylim((130, 470) if target == 0 else (0, 79))
        ax.set_xticks(draw)
        ax.legend(frameon=False, fontsize=8, ncol=2, loc="upper left")
    elif i == 4:
        for target, a in enumerate(axes):
            values = np.array([scores[n]["condition_mean"]["RMSE"][target] for n in names])
            a.barh(np.arange(4), values, color=colors, height=.58)
            a.set_yticks(range(4), ["Mean", "Draw", "Draw + β", "Forest"] if target == 0 else [])
            a.invert_yaxis()
            a.set_xlim(0, values.max()*1.3)
            for j, v in enumerate(values):
                a.text(v+values.max()*.025, j, f"{v:.1f}", va="center", fontsize=9)
            style(a, ["E  Stress error", "Strain error"][target],
                  ["RMSE (MPa)", "RMSE (percentage points)"][target])
    else:
        grid = np.linspace(6, 17, 301)[:, None]
        for test, a in zip([1, 3], axes):
            train = np.array([j for j in range(4) if j != test])
            scaler, model = fitted[test]["draw_ridge"]
            ridge = model.predict(scaler.transform(grid))[:, 0]
            forest = np.mean([m.predict(grid)[:, 0] for m in fitted[test]["draw_forest"]], axis=0)
            a.axvspan(draw[train].min(), draw[train].max(), color="#e9efdf", zorder=0)
            a.plot(grid[:, 0], ridge, color=colors[1], label="Ridge")
            a.plot(grid[:, 0], forest, color=colors[3], label="Forest")
            a.scatter(draw[train], Y[train, 0], color="#263d35", s=25, zorder=5)
            a.scatter(draw[test], Y[test, 0], marker="D", facecolor="white", edgecolor="#263d35", s=45, zorder=6)
            style(a, "F  Hold out 10x" if test == 1 else "Hold out 15x",
                  ylabel="Stress (MPa)" if test == 1 else None)
            a.set(xlim=(6, 17), ylim=(150, 410), xticks=[7.5, 12.5, 15])
            a.tick_params(axis="x", labelsize=8)
            a.legend(frameon=False, fontsize=8, loc="upper left")

keys = ["records", "structure", "strength", "strain", "scores", "holdout"]
for i, key in enumerate(keys):
    fig = plt.figure(figsize=(8.2, 5.1), layout="constrained")
    panel(i, fig, fig.add_gridspec(1, 1)[0])
    fig.savefig(OUT / f"{key}.svg", metadata={"Date": None})
    plt.close(fig)
fig = plt.figure(figsize=(16.4, 15.3), layout="constrained")
grid = fig.add_gridspec(3, 2, hspace=.09, wspace=.05)
for i in range(6):
    panel(i, fig, grid[i//2, i%2])
fig.savefig(OUT / "silk_learning.svg", metadata={"Date": None})
fig.savefig(OUT / "silk_learning.png", dpi=160, metadata={"Software": "L15 reproducible example"})
plt.close(fig)
print("Original workbook: SHA-256 verified")
print("108 available fracture records; 4 conditions; 4 held-out folds")
print("Model                  stress RMSE (MPa)  strain RMSE (percentage points)")
for name, label in zip(names, labels):
    stress, strain = scores[name]["condition_mean"]["RMSE"]
    print(f"{label:22s} {stress:17.3f} {strain:31.3f}")
print(f"Independent ridge solution: maximum difference {ridge_check:.2e}")
print("Six panels and complete data/results written to silk_outputs/")
本次实际运行输出
Original workbook: SHA-256 verified
108 available fracture records; 4 conditions; 4 held-out folds
Model                  stress RMSE (MPa)  strain RMSE (percentage points)
Feedstock mean                    72.259                          14.611
Draw: ridge                       22.246                           3.561
Draw + structure                  10.528                           4.701
Draw: forest                      51.616                           9.501
Independent ridge solution: maximum difference 5.68e-14
Six panels and complete data/results written to silk_outputs/
先看A图。每种颜色对应一档牵伸条件,连续曲线是代表性测试,散点是各试样的断裂记录。散点有宽度,说明同一档工艺中的试样也存在差异。B图把原论文的截面积和β折叠比例放在旁边,让我们同时看到几何和局部结构随工艺的变化。两类表征各有自己的重复测量数,图中的误差棒表示标准差,描述相应测量的分散程度。
一次运行 · 六幅结果图
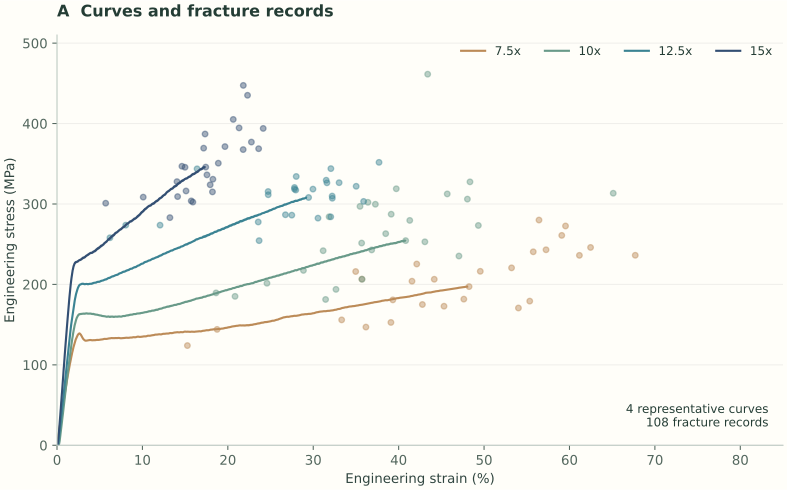
A|四条代表性拉伸曲线与附件中108条断裂记录;曲线上的采样点属于同一次测试。
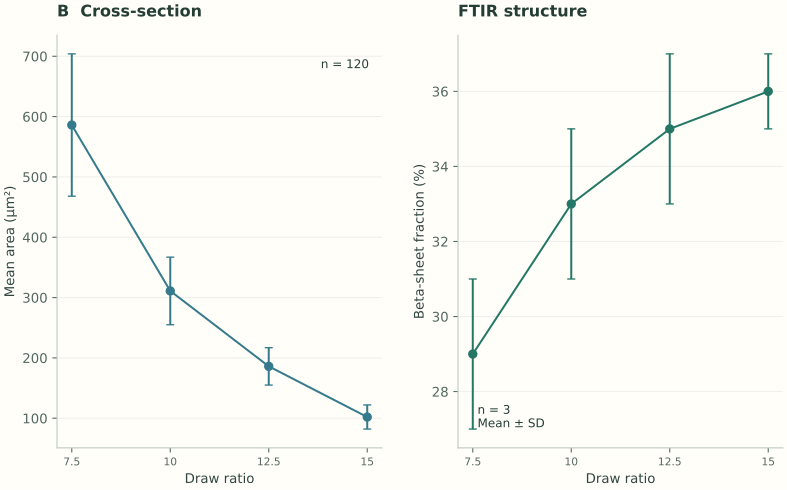
B|原论文独立测量的平均截面积和FTIR β折叠比例,误差棒为样本标准差。
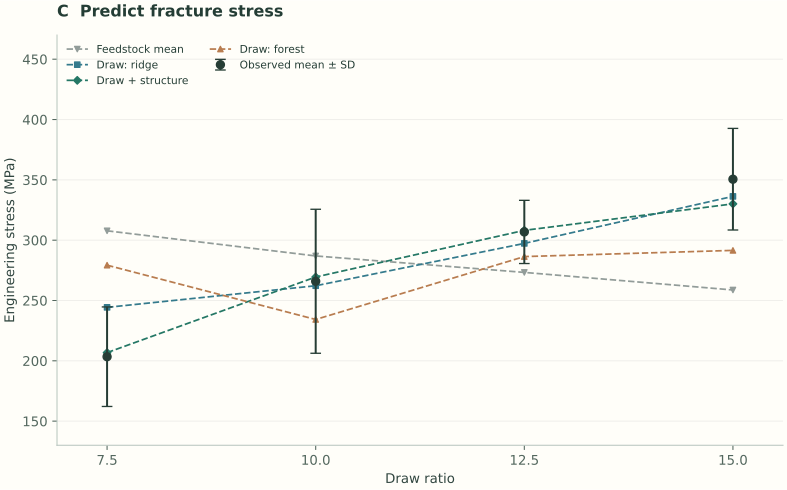
C|四次整档留出后的强度预测;黑点及误差棒表示附件记录的均值与标准差。
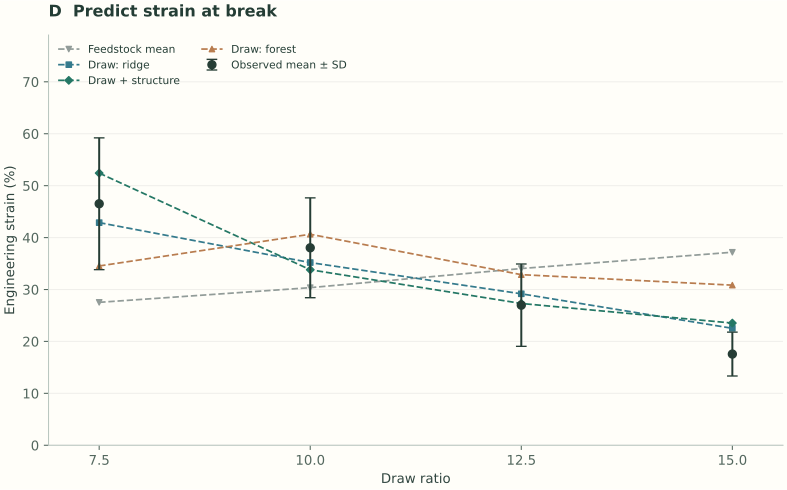
D|相同划分下的断裂应变预测;连线用于辨认各模型的四次结果。
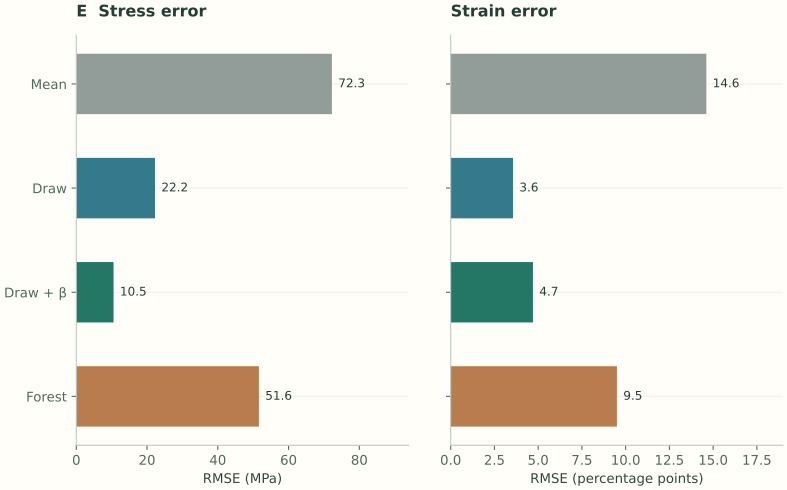
E|以四档条件均值为单位计算误差,强度和应变各按自己的单位报告。
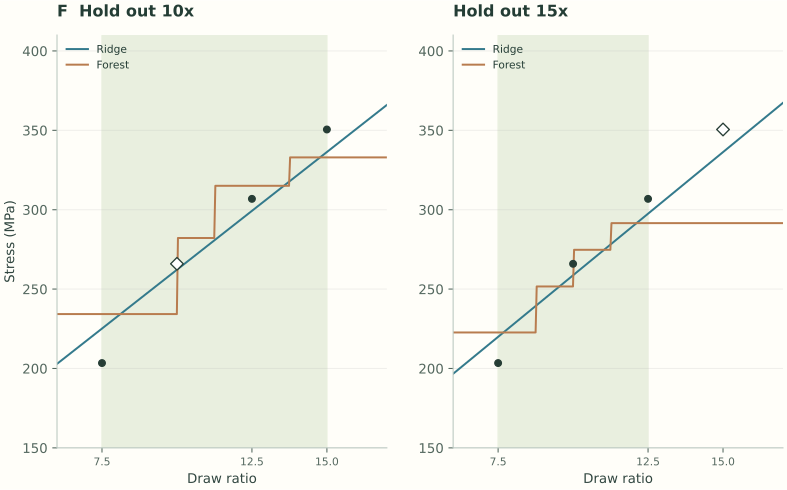
F|分别留出10倍与15倍条件,浅色区为训练牵伸范围;实心点为训练条件,空心菱形为留出条件。
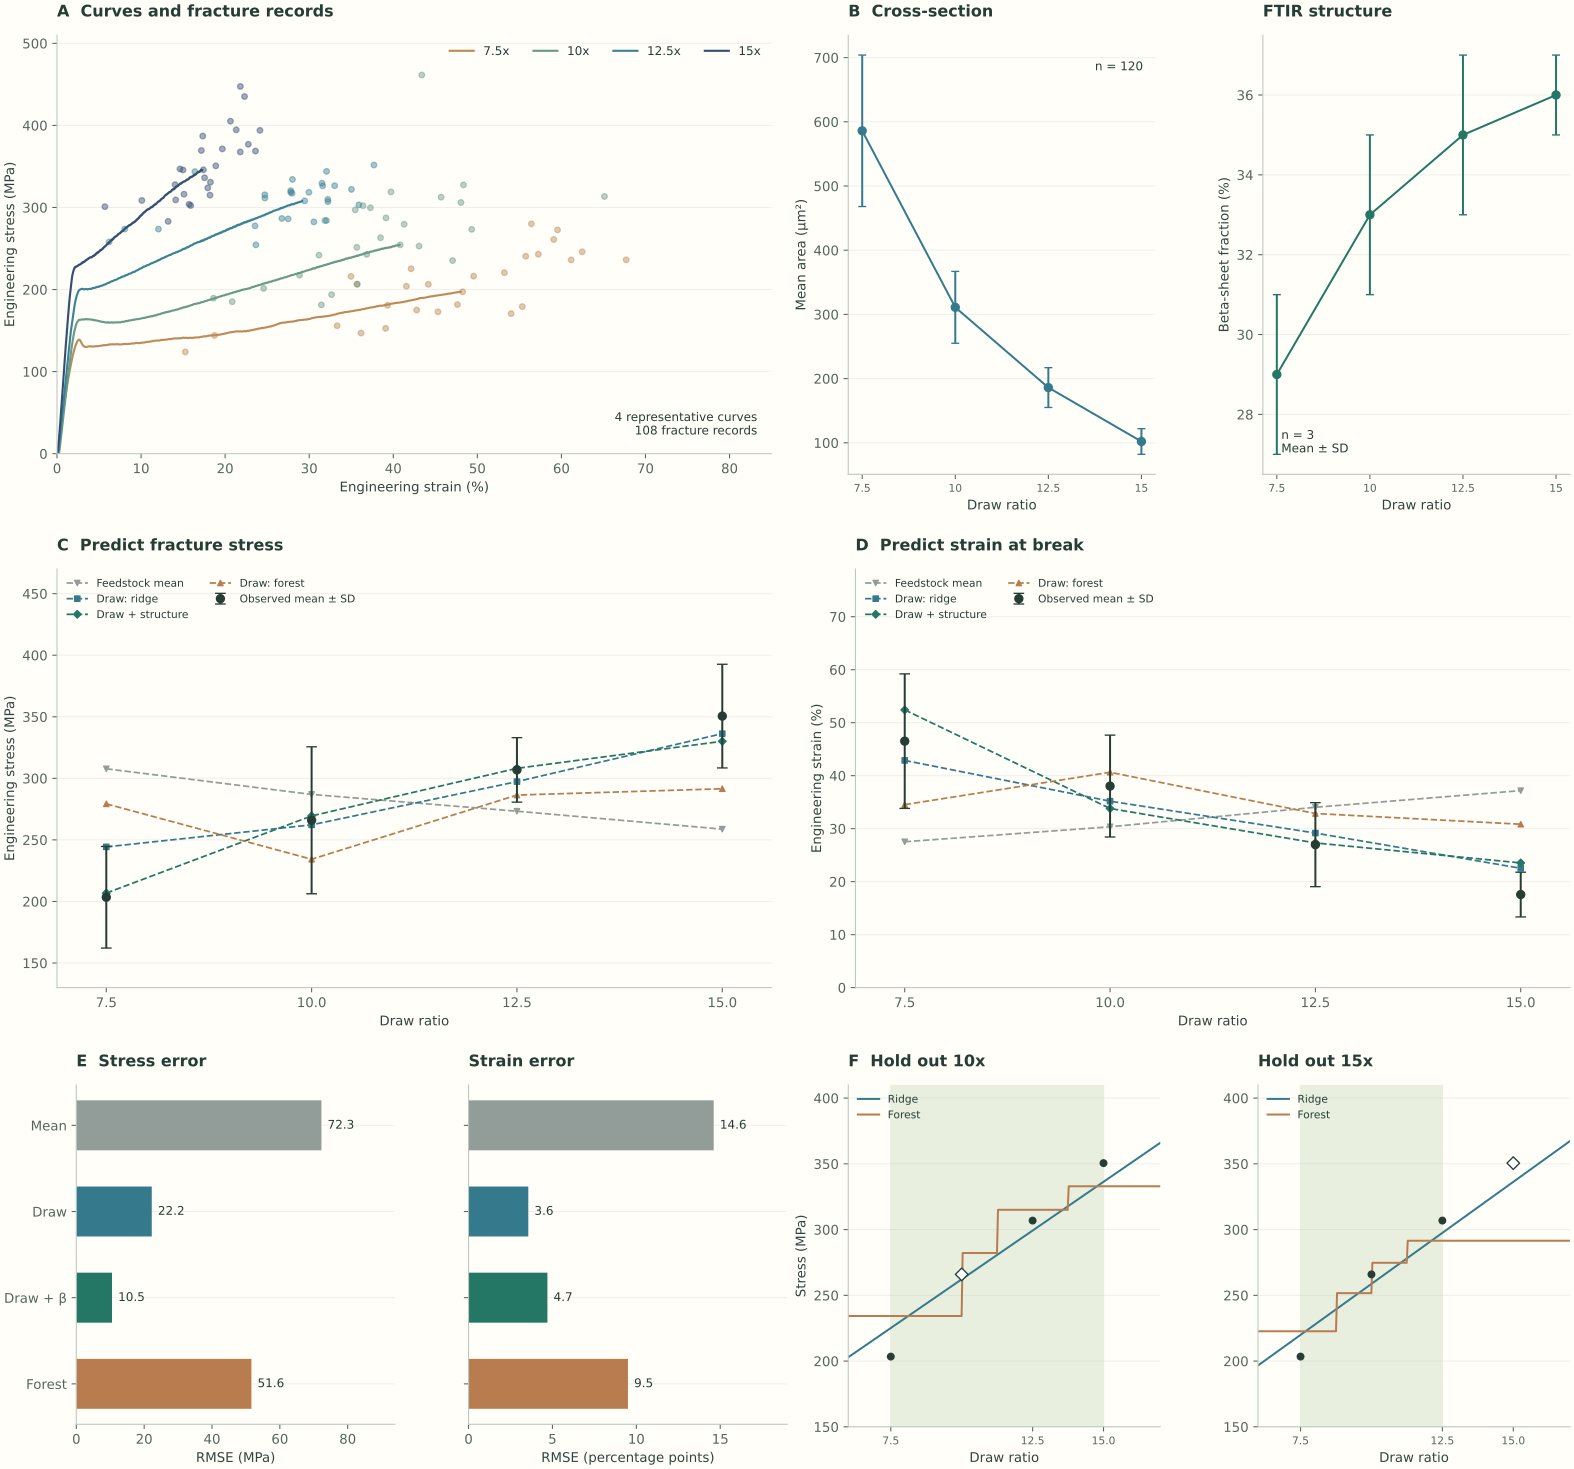
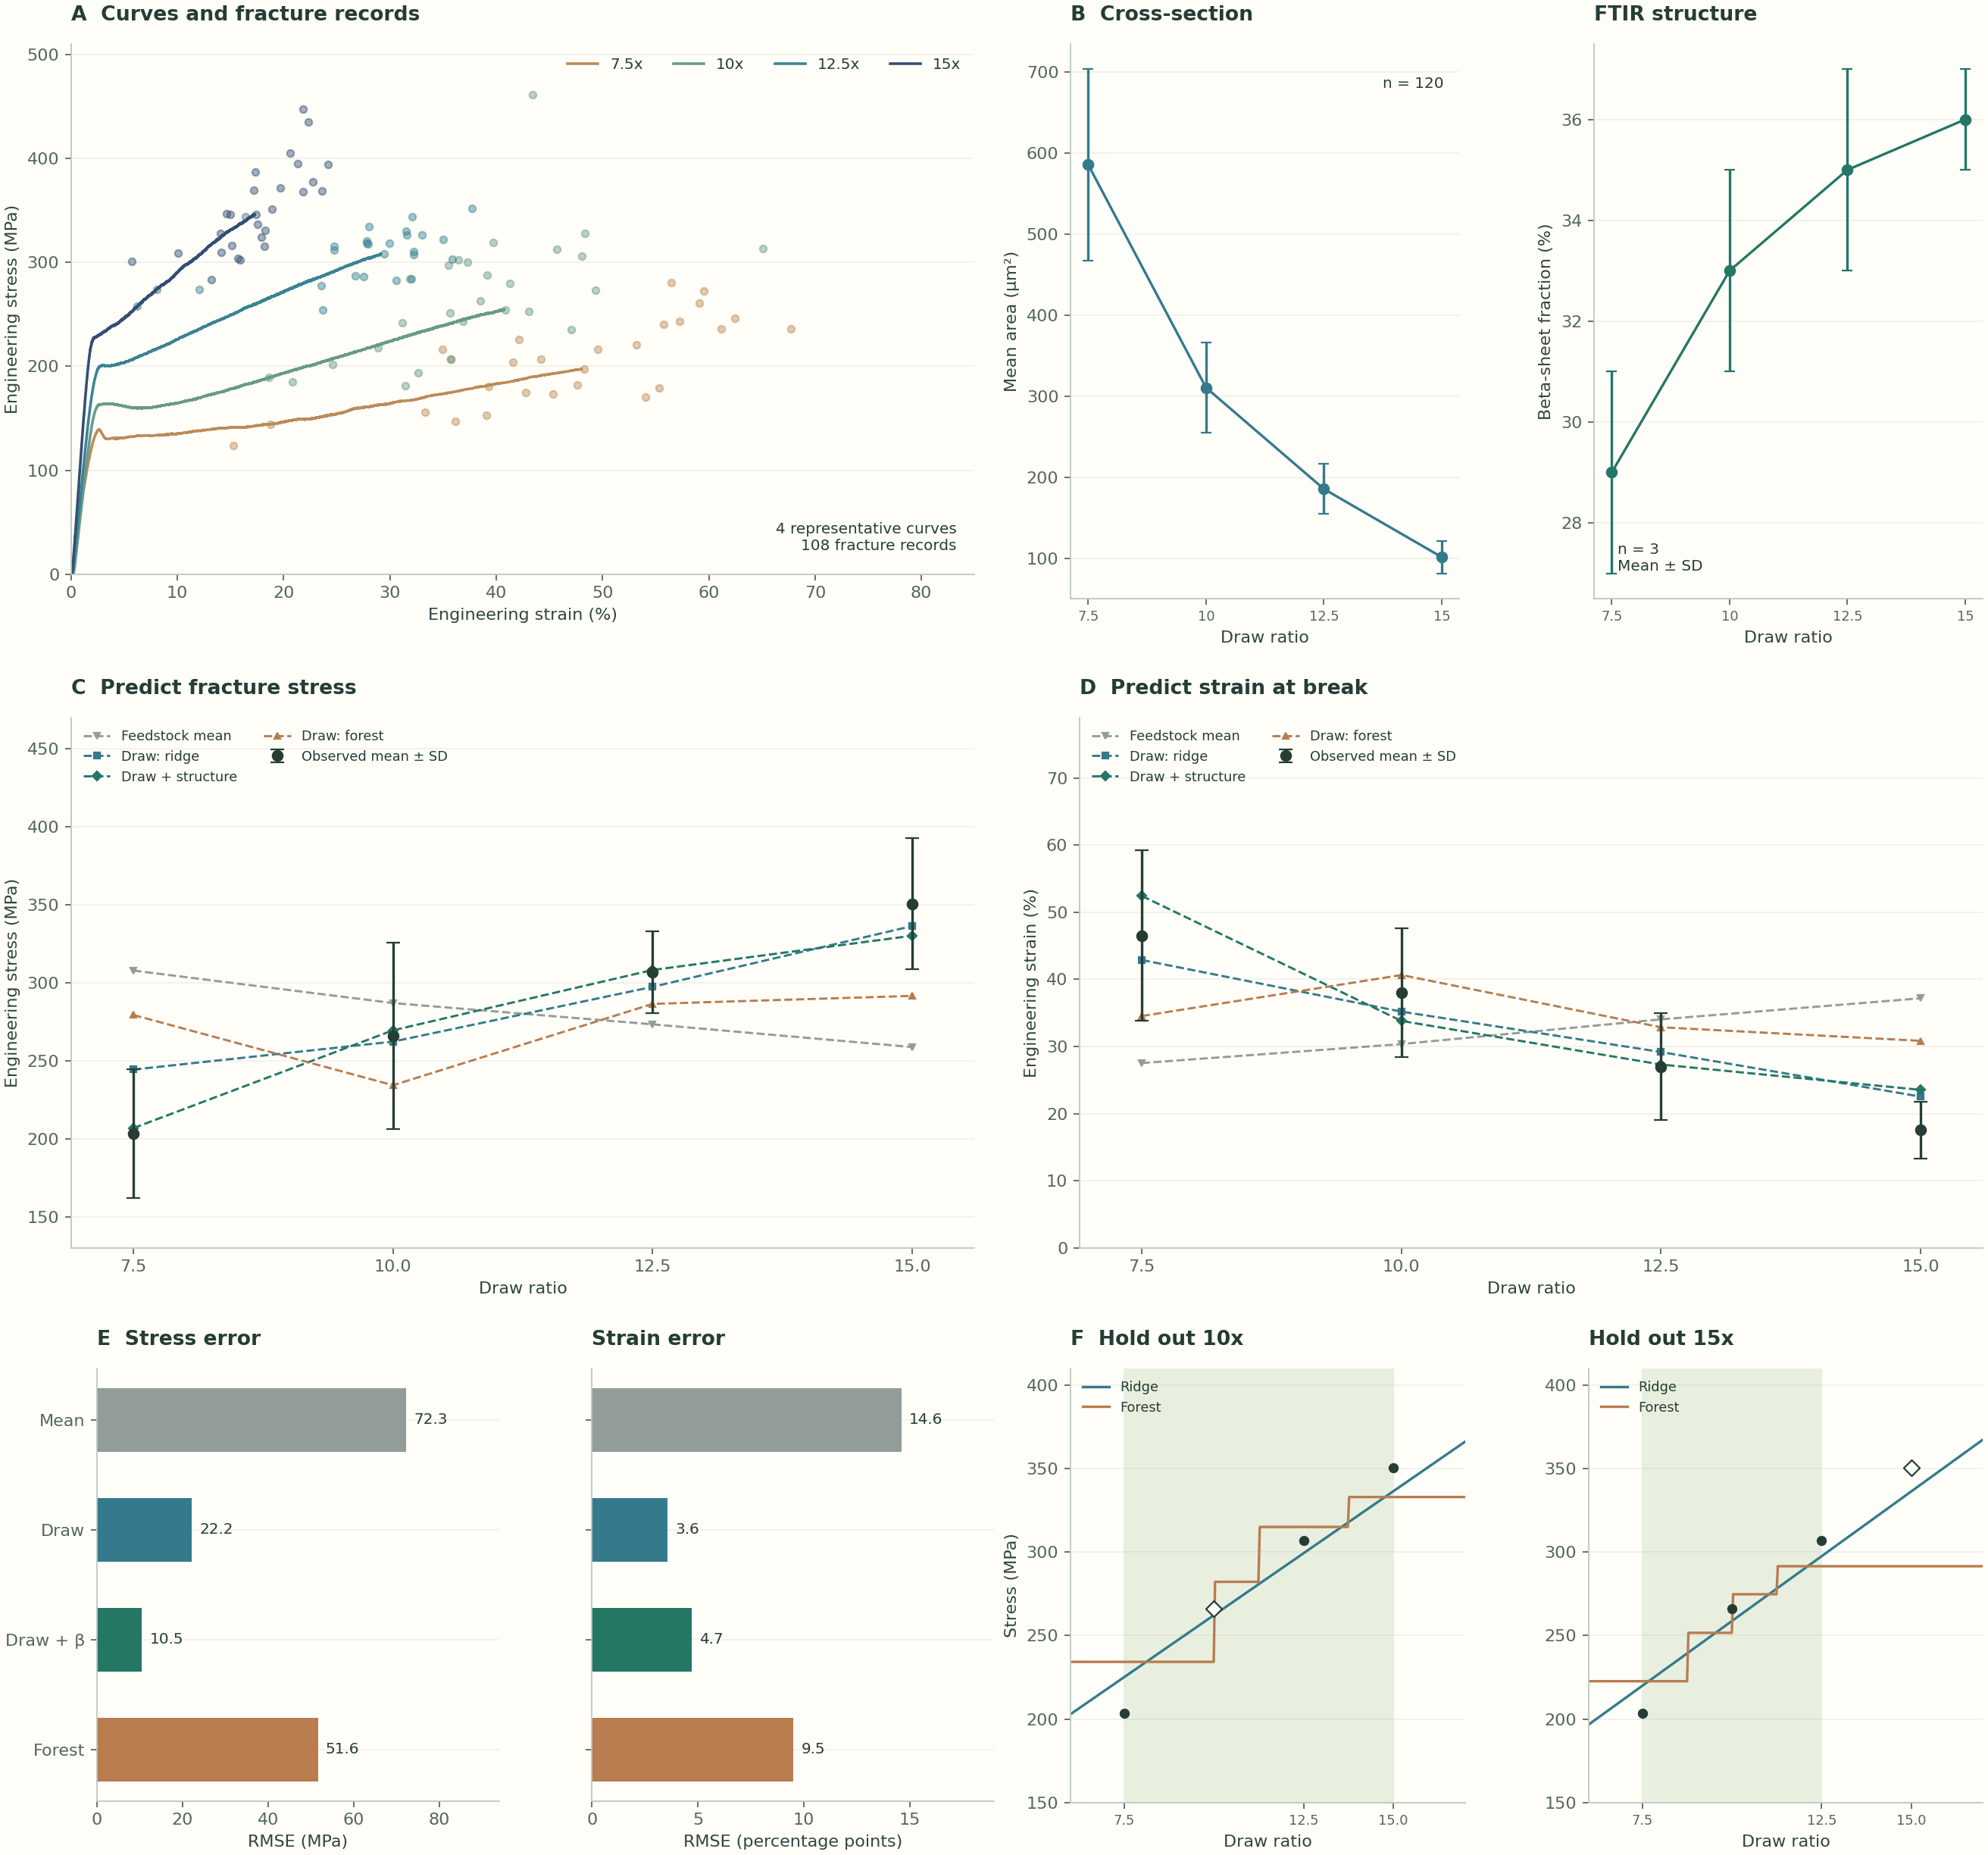
C图与D图展示四次留出结果。横坐标上的每一个条件都曾经单独作为测试集,该位置的彩色预测来自另外三档条件训练的模型,所以这些点不属于一条用全部数据拟合的曲线。黑点是工作簿记录得到的条件均值,黑色误差棒表示该档试样之间的标准差。沿着横轴看,可以比较模型是否捕捉到不同条件之间的变化;沿着误差棒看,可以认识单个试样相对于条件平均值的波动。
G是被依次留出的工艺条件数,这里为4。带横线的y表示某档条件的实测均值,带帽子的对应量是模型预测。计算时先把两者相减,再平方,四档平均后开平方。开平方让结果回到原来的单位:强度误差仍是兆帕,应变误差以百分点报告。假设两次预测分别相差3兆帕和4兆帕,均方根误差为√[(9+16)/2],约3.54兆帕;平方还使较大的偏差在汇总时占更明显的权重。
按四档条件均值计算,只知道原料身份的参照模型,强度误差为72.26兆帕,应变误差为14.61个百分点。加入牵伸比的岭回归分别得到22.25兆帕和3.56个百分点。这里新增的信息很具体:模型终于能够区分同一种原料经历的不同工艺。双输入的“牵伸比加结构”模型得到10.53兆帕和4.70个百分点,结构信息改善了本例的强度预测,应变预测则由单输入岭回归得到较小误差。
这个差别可以从目标本身来理解。强度和断裂伸长不是同一个性质,某项结构测量对它们提供的信息也可以不同。与此同时,两项输入在四档条件中相关,新增变量会改变拟合的方向与正则化的作用。因此,本例给出的是这组条件下两个任务的实测比较。要进一步判断结构变量在哪些工艺范围内持续有用,可以增加牵伸之外的独立调节条件,获得牵伸相近而结构不同、或结构相近而牵伸不同的样品。
森林在当前设置下的两项误差为51.62兆帕和9.50个百分点。F图帮助解释其中的行为:留出10倍条件时,训练范围仍覆盖它,问题属于内插;留出15倍条件时,训练牵伸范围止于12.5,问题属于外推。绿色背景标出训练范围,树的预测在范围外延续已有叶子的值,岭回归则继续沿直线变化。将四档汇总的分数与这种具体图形一起看,才能知道误差主要发生在哪类预测位置。
还可以把条件均值预测拿去与108个单独试样比较。代码保留了这组结果:单输入岭回归的强度误差约48.52兆帕,双输入约44.39兆帕。它们高于各自的条件均值误差,因为同一档中的每个试样得到相同的条件预测,而真实试样仍有分散。若研究目标转向逐根筛选,就应增加逐根可取得的信息,例如单根截面、缺陷图像或局部结构,并把试样记录与相应测量一一对应。
从这个例子扩展研究时,可以先建立一张沿加工顺序组织的数据表:原料来源与制备批次,原液状态,牵伸和停留过程,干燥或调湿状态,结构表征,以及最后的性能测试。每个试样关联到它实际经历的记录,才能按新的制备批次或新的工艺范围留出检验。若计划预测跨湿度使用表现,则再增加受控湿度实验;当前50%湿度下的比较已经对应一个明确起点,新增实验会把模型的应用问题继续向前推进。
到这里,分子与样品之间出现了一条可追踪的路线:分子组成影响能够形成的联系,加工过程影响联系怎样建立,层级结构和界面影响力怎样传递,测量把其中一部分变化变成数据。AI可以在这条路线上承担不同任务,帮助比较工艺候选、结合结构筛选样品,或为下一次实验提出可检验的预测。《凝胶的黏弹响应:松弛、循环加载与历史效应》将把样品放进一次真实的使用过程,继续研究加载速度、保持时间与恢复过程怎样改变观察到的材料行为。
资料与延伸阅读
Pauling与Corey,1951,The Pleated Sheet, A New Layer Configuration of Polypeptide Chains;Vollrath与Knight,2001,Liquid crystalline spinning of spider silk。前者提供局部结构的历史起点,后者把结构变化联系到纺丝过程。
Yao等,2008年在线发表、2009年卷期,Organic–inorganic interfaces and spiral growth in nacre;Greco等,2021,Tyrosine residues mediate supercontraction in biomimetic spider silk。两项研究分别用于理解界面的内部层次,以及序列、湿度与样品约束的关系。
Frydrych等,2019,Artificial spinning of natural silk threads,原文以CC BY 4.0发表;作者公开的原始数据工作簿。本节图表由完整Python例子计算,断裂记录取自Figure 5A - Tensile工作表,结构与截面积统计取原文表1。
Hoerl与Kennard,1970,Ridge Regression: Biased Estimation for Nonorthogonal Problems;Breiman,2001,Random Forests。实现细节可对照scikit-learn的Ridge与RandomForestRegressor文档。