从一次拉伸走向完整的使用历史
凝胶的黏弹响应:松弛、循环加载与历史效应
把一块软垫压下去,停住几秒,再抬起手,能够观察到三个不同的过程:刚压下去时的阻力、保持形状时的变化,以及松手后的恢复。快压和慢压的手感还可能不同。凝胶、蛋白质纤维和许多生物组织也会随时间改变受力。本节从一次完整的使用过程出发,认识材料怎样保留加载历史,读懂公开凝胶实验中的循环曲线,再训练能够逐步读取变形过程的AI模型。这样,研究问题便从“材料有多硬”延伸到“按这样的速度使用、停留和反复加载,它会怎样响应”。
01先把一次使用的过程描述完整
《从分子到样品:制备、加工与层级结构》讨论原料经过加工以后怎样成为一个样品。现在,样品已经做出来,下一步是让它承担实际任务。例如,一条柔性传感带贴在活动的关节附近,会经历伸长、停留、回缩和下一次伸长;一种含水凝胶作为柔软支撑层,可能长时间受压,也可能反复受力。研究者需要知道每一段过程中力怎样变化,以及重复使用后响应能否保持。只测一个断裂强度或初始模量,很难描述这些连续发生的事情。
可以先把使用过程写成一段很具体的叙述:从原长开始,用半秒拉长一定距离,保持两秒,再用半秒回到原长,最后静置。这段话已经包含了计算所需的骨架。它告诉我们初始状态、变形幅度、每一步持续多久,以及下一步从什么状态接着进行。把“半秒”改成“三秒”,就得到另一条过程;虽然最大长度相同,材料内部来得及发生的变化可能不同,拉力也就可能不同。
读一条时间曲线,先看实验保持什么、测量什么。拉伸仪把夹具停在固定位置时,试样长度近似不变,仪器继续记录拉力怎样下降,这叫应力松弛;装置维持近似恒定的拉力,记录试样怎样继续伸长,则叫蠕变。把软绳拉长后固定两端,与在软绳上挂住一个重物,分别对应这两种安排。它们测的是同一类时间响应,却用不同方式向材料提问。交给AI之前,需要把受控量写成输入、被测量写成目标,才能让模型预测所要进行的那种实验。
为了比较不同尺寸的试样,先把长度和力换成应变与应力。应变表示相对于初始长度改变了多少,应力则把力分摊到所选截面积上。这里沿用《从分子到样品:制备、加工与层级结构》的工程定义,以初始标距和初始截面积作参照。标距是用于测量变形的那段长度;实际实验还应记录测量来自夹具位移还是试样上的标记,因为夹具滑移和设备变形可能使两者出现差别。
式中的L0和A0分别是初始标距和初始截面积,L是当前标距,F是轴向力。假设标距原来20毫米,后来变成21毫米,则ε=1/20=0.05,也就是5%;若1平方毫米的初始截面承受0.02牛顿拉力,工程应力就是0.02兆帕,即20千帕。应变没有单位,应力有单位,因此“伸长5%”与“应力20千帕”分别说明形状变化和受力程度。
小变形时,用初始面积还是当前面积,差别往往较小;拉得很长时,横截面收缩便会明显影响比较。若材料均匀拉伸、体积保持不变,长度比λ=L/L0增大到2,当前面积就变成初始面积的一半,同一个力对应的真实应力便是工程应力的2倍。这个换算依赖均匀变形和体积不变的条件。对存在颈缩、失水或局部破坏的试样,需要测量相应的截面与变形,而不能直接套用这个例子。
时间也要配上清楚的量。夹具每分钟移动多少毫米是位移速度,把它除以初始标距,才得到对应的工程应变率,单位是每秒或每分钟。相同的夹具速度作用在10毫米与20毫米标距的试样上,后一种的工程应变率只有前一种的一半。数据表中保留速度、标距、温度和含水条件,后续才能判断两次“拉伸实验”到底经历了多相近的过程。
对生物大分子材料,含水状态尤其值得和时间一起记录。水可以影响链段运动、离子联系和分子间接触,也可能在载荷作用下重新分布。因此,观察到力慢慢下降以后,可以继续问:主要是链与接触在重排,还是流体在迁移,或者几个过程共同发生?第八节已经讨论过运动的时间尺度,这里把同一个思路放进仪器记录的曲线中。改变样品尺寸、环境或加载时间,有助于设计区分这些机制的实验。
AI接收数据时,也需要这段完整的实验叙述。若一行只写“应变5%,应力某值”,模型无法知道这个5%是在拉伸途中、保持阶段,还是卸载途中测到的。把时间点拼成有顺序的轨迹,并保存前面的状态,才能表达这些差别。接下来先用一个能够手算的模型认识内部状态,再让不同学习模型面对同一组轨迹,比较加入历史以后究竟改善了什么。
02为什么长度保持不变,内力还会慢慢变化
想象用弹簧连接一个可以缓慢移动的活塞。刚拉开时,活塞还来不及移动,弹簧伸长并产生较大的力;保持两端距离以后,活塞逐渐移动,弹簧的伸长随之减少,力也逐渐下降。这个装置把“立即产生弹性力”和“需要时间才能调整”放到了一起。真实凝胶里没有这样的金属弹簧和活塞,但链构象、分子接触或其他结构重排可以产生类似的宏观效果,因而这个等效装置很适合帮助理解。
Maxwell在1867年的论文中讨论了从弹性到黏性响应的联系,并把应力随时间松弛写成方程。那篇题为《气体动力学理论》的论文也涉及固体与纤维的观察,其中引用了Weber对丝纤维扭转的研究。这个历史细节颇有启发:今天在软凝胶上测量的“保持形状以后内力怎样变化”,与早期研究者观察扭转纤维时提出的问题相通。不同材料可以通过各自的微观过程,产生能够用同类方程描述的响应。
先看两个最简单的元件。理想弹簧的力取决于当前伸长多少,伸长保持不变,弹性力也保持不变。理想黏性元件则像推动一个受黏性阻力的活塞,移动越快,需要的力越大;停止移动以后,这个理想元件的黏性力降为零。把它们写成应力与应变的关系,就能在同一个尺度下比较。下式中的下标s与v分别指弹性元件和黏性元件,各自的应变由连接方式决定。
E是弹性模量,单位为帕;η读作“eta”,这里是黏度,单位为帕·秒。应变上面的点表示对时间的变化率,例如一秒增加0.02应变,对应每秒0.02的应变率。若E=10千帕,弹簧元件伸长5%便产生0.5千帕应力;若η=2千帕·秒,黏性元件以每秒0.1的应变率变形,产生0.2千帕应力。把速率降低一半,后一种应力也降低一半,这正是黏性元件对快慢敏感的含义。
当这两个元件串联时,力依次通过它们,因而两者承担相同的应力;总伸长则由两者的伸长相加。用总应变率减去黏性元件的应变率,就得到弹簧还在以多快的速度伸长。再乘弹性模量,便得到弹簧应力的变化率。这样整理以后,会出现一个“外部加载使应力增加,内部松弛使应力减少”的方程,这就是一条Maxwell支路。它的内部应力q可以作为过去加载留下的状态。
i表示第几条支路,qi是这条支路当前承担的应力,τi是其松弛时间。τ=η/E的单位是秒:黏性阻力越大,调整越慢;在相同黏度下,弹簧越强,推动调整的作用越大。把几条支路并联,它们经历相同的总应变,承担的应力则相加。再并联一个模量为E∞的弹簧,就能表示长时间以后仍然保留的弹性支撑。下标∞提示我们关注充分松弛以后的响应。
保持总应变时,右侧的加载项变成零,每条支路便按自己的时间尺度减小内力。经过一个τ,该支路剩下的应力约为原来的37%;经过三个τ,约剩5%。这像几个排水快慢不同的小水槽同时放水:开始时快过程变化明显,稍后慢过程仍在继续。类比中的水量对应这里的内部状态,实际材料是否存在几种可区分的结构调整,还要由实验与结构证据来判断。
上式考虑一个理想阶跃:材料原来充分松弛,在时刻零立即获得应变ε0,随后保持。E(t)叫松弛模量,表示在这个过程下应力与所施加应变的比值。后面代码选用E∞=6千帕,两条支路的模量分别为12和8千帕,τ分别为0.3和3秒。若阶跃应变为8%,初始应力是(6+12+8)×0.08=2.08千帕;3秒后约为0.715千帕;等待足够久,则接近6×0.08=0.48千帕。
这些数值是为本节设置的教学参数。它们让快、慢过程都能在一张图里看见,并让我们知道模拟数据的确切来源。真实仪器总要花一定时间完成加载,因此下文代码使用一段段斜坡,而不是瞬间跳变。如果加载用时已经接近某个松弛时间,那条支路在拉伸途中就开始释放应力,达到同一最大应变时的拉力会低于理想阶跃的初始值。这也是快拉与慢拉可以得到不同峰值的原因。
材料响应的快慢也会进入生物学问题。细胞会牵动周围的网络,网络能否在相应时间内重排,会影响细胞与环境之间的力学交流。Chaudhuri等在2015年在线发表、2016年编入卷期的研究,通过藻酸盐水凝胶调节应力松弛,并在特定三维培养条件下观察细胞铺展、增殖与分化相关活动。研究把初始模量与松弛快慢分别调控,使“环境有多硬”之外的时间信息进入了实验设计。
读这类结果时,可以沿着三个相连的问题理解:细胞施加怎样的力,网络通过什么过程调整,调整又怎样改变细胞周围可用的空间和联系?这样,松弛曲线就与具体生物过程连接起来了。若进一步用AI研究细胞—凝胶关系,输入除了初始模量,还可以包含定义明确的松弛指标、配体条件和培养时间,目标则对应实际测量的细胞行为。每一列数据都来自这个因果问题中的一个位置,特征选择也就有了科学依据。
03卸载以后,形状、内力和能量怎样接着变化
从拉伸转入卸载时,外部应变开始减少,内部状态却不会立刻清零。可以想象一群步速不同的人排成队走过一段弯路:队伍前端已经转向,后面的各个人仍处在此前过程留下的位置。材料中的慢过程也需要时间调整,所以同样的长度,在加载途中和卸载途中可能对应不同的拉力。将应力对着应变画出来,去程与回程不再重合,就形成一条回线。
为了计算整条路径,需要把连续变化分成许多小段。本节每隔0.05秒记录一次应变,并把相邻记录之间的变化看成直线。因此,每一小段里的应变率是常数,可以直接求出Maxwell方程在这段时间内的精确更新。这个做法同时保留两件事:上一步尚未松弛完的应力,以及这一小段加载新增加的应力。它让“材料记住过去”变成一个可以检查的计算过程。
n表示当前时间步,Δt是步长,rn表示这一小段的应变率。ai位于0到1之间,决定旧应力还保留多少。假设某支路E=12千帕、τ=0.3秒,上一步应力为0.2千帕;接下来0.05秒应变增加0.01,则r=0.2每秒,a约为0.8465。旧状态留下约0.1693千帕,新加载增加约0.1105千帕,两者相加得到约0.280千帕。式子的两项各自对应一个看得见的物理过程。
拉伸、保持、松开:内力走过怎样的路径?
初始充分松弛,0.5秒后开始加载到8%应变,保持2秒,再卸载至原长。各支路松弛时间为0.3秒和3秒。
先在交互图中保持默认加载速度,拖动时刻滑块,依次看加载结束、保持结束和卸载结束。保持阶段应变不再改变,应力仍继续下降;卸载以后,应变回到零,内部状态还可能没有回到零。图中夹具继续把样品保持在原长,模型可以出现短暂压应力,随后逐渐松弛。如果改成只承受拉力、受压便松弛的细绳,就要为受力方式增加相应条件。交互图中的边界安排说明了这段曲线怎样产生。
再把加载与卸载时间都调长,观察峰值和回线怎样变化。慢过程给各支路更多调整机会,因而改变加载时积累的内力和卸载时释放的能量。这里有一个容易混淆的地方:恢复到原长、恢复到初始内力状态,以及恢复到初始的材料结构,是三个不同的问题。我们的线性模型描述前两者,不含断键、裂纹或永久结构变化;真实材料的反复使用还需要把这些结构过程接入实验观察。
能量提供了另一种读曲线的方法。拉伸时,外力沿位移做功;按初始体积归一化,便可用应力乘应变增量表示一小步的功。若一段过程中应力近似为1千帕,应变增加0.01,输入功密度就是0.01千焦每立方米,也就是10焦每立方米。把许多小步累加,就得到整段过程的功。绘图时面积之所以有物理意义,是因为横轴的变形增量与纵轴的应力正好组成做功关系。
ψ读作“psi”,表示当前储存的弹性能密度。长期弹簧的能量是E∞ε²/2;每条支路里,弹簧应变等于qi/Ei,代入弹性能公式,便得到qi²/(2Ei)。𝒟表示单位时间内耗散的能量密度。分子是应力的平方,分母由正的模量和松弛时间构成,所以每一项都非负。将储能对时间求变化率,再利用前面的支路方程,就得到“输入功率=储能变化率+耗散功率”。
例如应变为0.04,长期模量仍取6千帕,两支路应力分别为0.3和0.2千帕,则储能密度为0.0048+0.00375+0.0025=0.01105千焦每立方米。此刻即使停止继续拉伸,支路仍有可以释放的储能。保持长度时外力不再做位移功,储能的减少转成耗散;卸载时,储能的一部分还可以通过试样对夹具做功返回外部。因而累计输入功可以下降,累计耗散却持续增加或保持不变。
如果一个循环结束时,形状和全部内部状态都回到起点,储能变化为零,循环净输入功便等于耗散。若仅仅回到原长,支路中还保留应力,就要把剩余储能也计入。代码把每一小段的功和耗散分别积分,直接检查这笔能量账。一个只看当前应变、输出单值应力的模型,沿同一路径来回走时,其解析闭合功为零;它即使能拟合某一段曲线,也缺少描述这种历史耗散的能力。
现在把目光转向真实的大变形凝胶。Xue等在2023年研究了含肽纤维的复合水凝胶:体系包含聚丙烯酰胺网络与肽相关结构,并比较加入铜配位后的响应。论文利用结构中的隐藏长度解释拉伸与恢复机制,又通过反复循环考察性能保持。这里的“隐藏长度”可以理解为初始结构里尚未充分参与整体伸长的链长,受力后的结构调整让其中一部分逐渐被调动起来。
这项研究适合与前面的简单模型接着读。Maxwell支路让我们认识内力如何随历史变化,实验则展示具有具体分子设计的材料怎样承受大幅度、反复的拉伸。下面三幅图由论文原始附件重新绘制:第一幅比较三种配方的一次循环;第二幅比较铜配位复合凝胶的第1与第100次循环;第三幅沿循环次数追踪峰值应力和耗能的保留率。这样既能看完整曲线,也能看长期变化的指标。
从一次循环到反复使用 · 公开实验数据重绘
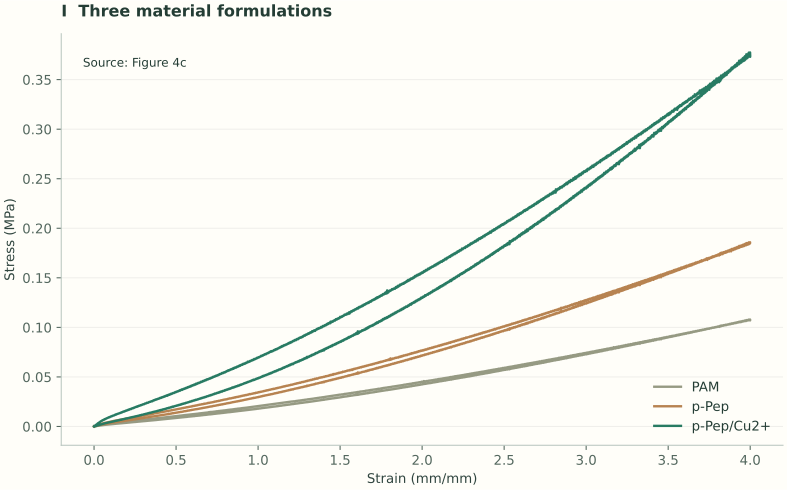
I|最大应变4,即长度达到初始值的5倍;比较三种配方的完整加载与卸载。
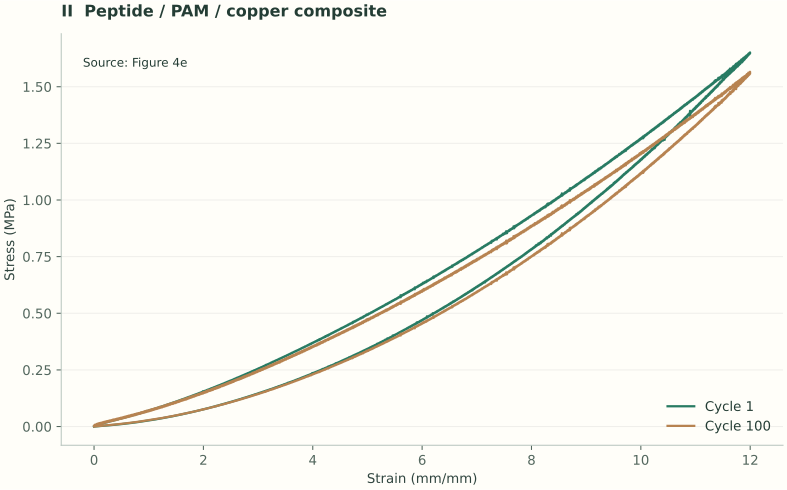
II|铜配位复合凝胶的第1与第100次循环,最大应变12。
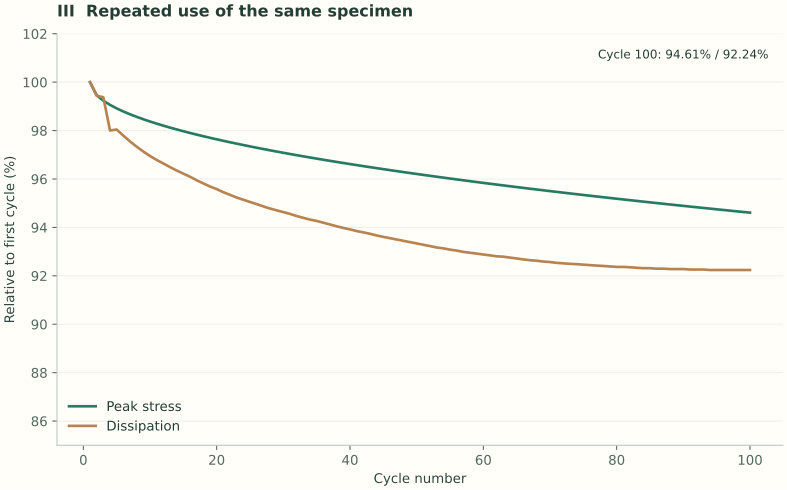
III|原附件汇总的峰值应力与耗能保留率,以第一次循环为100%。
第一幅图横轴最大应变为4,也就是400%,长度达到原来的5倍;第二幅图最大应变为12,长度达到原来的13倍,已经属于显著的大变形。第三幅图的第100次循环,峰值应力约保留94.61%,耗能约保留92.24%。铜配位体系两条原始曲线的有序积分之比约为92.23%,与附件给出的耗能保留率接近。曲线保留原始加载和卸载点序,不能按应变从小到大重新排序,否则去程与回程就会被混在一起。
这里的100次循环来自同一试样的连续使用,提供的是一段材料历史。若研究目标是预测另一块新制备凝胶的表现,还需要独立试样与制备批次的信息。还可以进一步改变循环幅度、等待时间和环境,观察恢复机制在不同过程下怎样发挥作用。回线面积、峰值保留和裂纹扩展分别回答不同的问题;把它们安排进同一实验计划,才能从“某一轮拉得很好”逐步走向对反复使用的理解。
04让AI在每一步保留有用的过去
前面的方程给出了可以计算答案的学习任务:输入按时间排列的应变,预测每一时刻的应力。考虑两个瞬间,试样长度一样,一个正在拉伸,另一个刚从更长的位置卸载;如果只告诉模型当前应变,它就会把这两个状态看成同一个输入。加入应变增量后,模型能够辨认正在加载还是卸载;继续保存此前的内部状态,才有机会利用更早的历史。下面按这个顺序比较模型。数据的生成方程和初始状态都已确定,因此我们能把误差与缺少的输入信息、模型学到的关系逐项对应起来。
只看应变的模型像拿到一张当前位置的照片:看到样品伸长了多少,却不知道它怎样来到这里。加入当前应变增量以后,可以识别正在加载、保持还是卸载,像再看一眼当前运动方向。不过,保持阶段的应变和应变增量都可以完全相同,而刚刚加载结束与已经等待三秒的应力仍不同。要区分这两种情形,模型就需要某种随时间更新的状态,把此前发生的事情带到当前计算中。
循环神经网络提供了这种思路。它逐步读取序列,每读入一个时刻,就更新一组称为隐状态的数字,再由隐状态预测当前输出。这组数字可以看作模型自己整理的笔记:哪些变化值得保留,哪些信息可以逐渐淡去,都由训练来决定。隐状态中的每个分量通常没有预先指定的物理意义;与前面直接表示支路应力的q相比,它具有更自由的表达方式,也需要额外的研究来理解学到了什么。
Cho等在2014年的机器翻译研究中提出了门控循环单元,也就是GRU。原任务需要把句子中的顺序与上下文带入后续计算,门机制帮助网络控制信息的保留和更新。力学历史同样包含“前面发生的事会影响后面”的结构,因此可以借用这一类序列模型。迁移到材料研究时,输入、输出、时间步与评价方法都要围绕加载实验重新定义。
h是隐状态向量,n表示当前时刻,带波浪线的h表示本步新形成的候选状态。z是更新门,每个分量都在0到1之间;符号⊙表示对应位置的数字分别相乘。若某一分量的z接近1,该位置主要保留旧信息;若接近0,则主要采用新的候选信息。例如旧状态为0.6、候选状态为0.2、z=0.75,更新后就是0.75×0.6+0.25×0.2=0.5。门的取值本身也由网络根据输入和旧状态计算。
本例使用16维、单向GRU。每一步输入两个数:当前应变和本步应变增量,分别除以0.1作为固定尺度;时间间隔统一为0.05秒,所以增量同时携带了这一步快慢的信息。网络只从前往后读取,不使用未来时刻。最后用一个线性读出层,把16个状态分量组合成应力。完整实现采用PyTorch的GRU约定,其中重置门作用在旧状态的仿射变换之后,公式细节可对照官方说明与本页代码阅读。
在神经网络之外,还可以让物理结构直接参与学习。我们预先放置12个不同的正松弛时间,每一个都按照前面的Maxwell更新记录历史;先把它们的模量都设为单位值,得到12条状态曲线,再让训练数据决定每条曲线应乘多大的系数。加上一个长期弹性项,就得到13个待拟合系数。这个模型将“可能以哪些速度松弛”作为预先给定的结构,把“各个过程有多强”交给数据。
uj,n表示第j种单位模量过程在第n步的状态,cj则是它的模量系数,单位为千帕。所有系数都约束为非负,松弛时间也保持为正,因此每个被保留的支路都具有前面推导的非负耗散结构。拟合时使用非负最小二乘,寻找能让训练应力误差平方和最小的一组系数。例如某个候选过程对数据帮助很小,其系数就可以被拟合为零,在最终预测里不再贡献应力。
四类模型面对同一组训练数据:当前应变的三次回归、读取当前应变与增量的普通前馈网络、保留隐状态的GRU,以及非负松弛模型。前馈网络与GRU都分别训练三个随机种子,使用相同的训练路径,预测时取三次结果的平均。普通前馈网络有337个参数,GRU有977个参数,非负模型拟合13个系数。比较时既看误差,也看它们能够使用的信息与已经写入的物理结构。
数据划分以整条加载路径为单位。240条单次拉伸、保持、卸载的路径中,144条用于训练,48条用于选择训练过程中的模型,48条留作测试。另生成32条双次加载与32条更快加载,检验新的使用过程。这样,某条测试曲线前半段不会出现在训练集里。若把同一条曲线的相邻时间点随机拆开,模型很容易在训练时已经见过几乎相同的状态,得到的误差就难以回答“新过程会预测得怎样”。
训练应力加入标准差0.008千帕的高斯噪声,让学习过程面对带扰动的观测;生成模型给出的无噪应力仍被保留,用来评价预测是否接近真实的受控规律。网络学习率固定为0.01,最多训练120轮,每5轮按验证集检查并保留较好的模型,测试路径不参与这些选择。全部轨迹最初都充分松弛,改变初始预加载或时间间隔会形成新的问题,可以通过新增输入与实验协议继续研究。
05运行完整例子,再沿着图解释研究结果
下面的代码同时完成两条相互联系的工作。一条是生成可追溯的受控路径,训练四类模型,并画出预测与能量结果;另一条是读取公开工作簿,重绘前面的真实凝胶循环曲线。实验附件约63兆字节,首次运行会下载到当前目录,之后使用本地副本并核对文件校验值。受控模型的参数、训练划分、网络权重、实验曲线和运行结果都写入输出目录,便于继续修改问题或核查某一幅图。
阅读代码时可以沿着三个函数与变量走:pulse生成一次规定的使用过程,integrate根据应变历史更新内部应力与能量,predictions收集四类模型的预测。实验数据读取保留了工作表、列号和原始点序;绘图仅从这些实际计算或读取的数值出发。安装代码开头列出的依赖后即可运行。
"""L16: loading history, learned states, and experimental cyclic curves.
Run: python example.py
Install: numpy scipy scikit-learn torch matplotlib openpyxl requests
The synthetic teacher parameters are specified below. Experimental source data
are read separately; they are not training labels for this small-strain model.
"""
from pathlib import Path
import json,copy,time
import numpy as np
from scipy.optimize import nnls
from sklearn.linear_model import Ridge
import torch
from torch import nn
torch.set_num_threads(2)
HERE=Path.cwd()
OUT=HERE/"history_outputs";OUT.mkdir(exist_ok=True)
DT=.05;T=np.arange(401)*DT;E0=6.;E=np.array([12.,8.]);TAU=np.array([.3,3.])
rng=np.random.default_rng(1616)

def pulse(onset,rise,hold,fall,amplitude):
    knots=np.array([0,onset,onset+rise,onset+rise+hold,onset+rise+hold+fall,20.])
    return np.interp(T,knots,[0,0,amplitude,amplitude,0,0])

def duration(lo,hi):return round(rng.uniform(lo,hi)/DT)*DT

strain=[];records=[]
for k in range(304):
    amp=rng.uniform(.02,.1);on=duration(.2,.9)
    kind='single' if k<240 else 'double' if k<272 else 'fast'
    rise=duration(.4,3.2) if kind!='fast' else duration(.1,.25)
    fall=duration(.4,3.2) if kind!='fast' else duration(.1,.25)
    hold=duration(.4,3.)
    eps=pulse(on,rise,hold,fall,amp)
    if kind=='double':
        rise=duration(.4,1.2);fall=duration(.4,1.2);hold=duration(.4,1.2)
        eps=pulse(on,rise,hold,fall,amp)+pulse(10+on,rise,hold,fall,.7*amp)
    strain.append(eps);records.append(dict(id=k,kind=kind,amplitude=amp,onset=on,rise=rise,hold=hold,fall=fall))
strain=np.array(strain);rate=np.diff(strain,axis=1)/DT

def integrate(eps,e0,moduli,times):
    n,steps=eps.shape;q=np.zeros((n,len(times)));out=np.zeros_like(eps)
    states=np.zeros((n,steps,len(times)));work=np.zeros_like(eps);diss=np.zeros_like(eps)
    a=np.exp(-DT/times);one=-np.expm1(-DT/times)
    for j in range(1,steps):
        r=(eps[:,j]-eps[:,j-1])/DT;c=moduli*times*r[:,None];b=q-c
        iq=c*DT+b*times*one
        iq2=c*c*DT+2*c*b*times*one+b*b*times*.5*(-np.expm1(-2*DT/times))
        work[:,j]=work[:,j-1]+e0*.5*(eps[:,j]**2-eps[:,j-1]**2)+(r[:,None]*iq).sum(1)
        diss[:,j]=diss[:,j-1]+(iq2/(moduli*times)).sum(1)
        q=a*q+moduli*times*one*r[:,None];states[:,j]=q
        out[:,j]=e0*eps[:,j]+q.sum(1)
    energy=e0*.5*eps**2+(states**2/(2*moduli)).sum(2)
    return out,states,work,diss,energy

truth,states,work,diss,energy=integrate(strain,E0,E,TAU)
assert np.max(abs(work-energy-diss))<1e-12
assert np.min(np.diff(diss,axis=1))>-1e-13
ids=rng.permutation(240);train=ids[:144];val=ids[144:192];test=ids[192:]
splits=dict(train=train.tolist(),validation=val.tolist(),test=test.tolist(),double=list(range(240,272)),fast=list(range(272,304)))
noise=rng.normal(0,.008,truth.shape);noise[:,0]=0;observed=truth+noise
features=np.stack([strain/.1,np.column_stack([np.zeros(304),np.diff(strain,axis=1)])/.1],axis=2)
# Current-strain model receives no time or history state.
poly=np.stack([strain/.1,(strain/.1)**2,(strain/.1)**3],axis=2)
ridge=Ridge(alpha=1e-6).fit(poly[train].reshape(-1,3),observed[train].ravel())
predictions={'strain_only':ridge.predict(poly.reshape(-1,3)).reshape(truth.shape)}

# A fixed positive relaxation bank learns the nonnegative strength of each mode.
bank=np.geomspace(.05,12.,12);history=np.zeros((304,401,13));history[:,:,0]=strain
for m,tau in enumerate(bank):
    h=np.zeros(304);a=np.exp(-DT/tau);b=tau*(-np.expm1(-DT/tau))
    for j in range(1,401):
        h=a*h+b*rate[:,j-1];history[:,j,m+1]=h
weights,residual=nnls(history[train].reshape(-1,13),observed[train].ravel())
predictions['positive_state']=history@weights

class FeedForward(nn.Module):
    def __init__(self):
        super().__init__();self.layers=nn.Sequential(nn.Linear(2,16),nn.Tanh(),nn.Linear(16,16),nn.Tanh(),nn.Linear(16,1))
    def forward(self,x):return self.layers(x).squeeze(-1)

class Recurrent(nn.Module):
    def __init__(self):
        super().__init__();self.gru=nn.GRU(2,16,batch_first=True);self.readout=nn.Linear(16,1)
    def forward(self,x):
        h,_=self.gru(x);return self.readout(h).squeeze(-1)

xt=torch.tensor(features,dtype=torch.float32);yt=torch.tensor(observed,dtype=torch.float32)
models={};histories={};seeds=[16,26,36]
start=time.monotonic()
for name,cls in [('instantaneous',FeedForward),('gru',Recurrent)]:
    seed_preds=[];models[name]=[];histories[name]=[]
    for seed in seeds:
        torch.manual_seed(seed);model=cls();optimizer=torch.optim.Adam(model.parameters(),lr=.01)
        best=float('inf');best_state=None;curve=[];best_epoch=None
        for epoch in range(1,121):
            model.train();optimizer.zero_grad();prediction=model(xt[train]);loss=((prediction-yt[train])**2).mean()
            loss.backward();nn.utils.clip_grad_norm_(model.parameters(),1.);optimizer.step()
            if epoch%5==0:
                model.eval()
                with torch.no_grad():v=float(((model(xt[val])-yt[val])**2).mean())
                curve.append([epoch,float(loss.detach()),v])
                if v<best:best=v;best_state=copy.deepcopy(model.state_dict());best_epoch=epoch
        model.load_state_dict(best_state);model.eval()
        with torch.no_grad():p=model(xt).numpy().astype(float)
        seed_preds.append(p)
        models[name].append(dict(seed=seed,best_epoch=best_epoch,validation_mse=best,
            parameters=sum(v.numel() for v in model.parameters()),weights={k:v.tolist() for k,v in best_state.items()}))
        histories[name].append(curve)
        print(f'{name} seed{seed}: epoch{best_epoch}, validation RMSE{best**.5:.6f}',flush=True)
    predictions[name]=np.mean(seed_preds,axis=0)

def rmse(a,b):return float(np.sqrt(np.mean((a-b)**2)))
scores={name:{split:dict(clean_RMSE_kPa=rmse(p[ix],truth[ix]),observed_RMSE_kPa=rmse(p[ix],observed[ix]))
              for split,ix in splits.items() if split!='train'} for name,p in predictions.items()}
result=dict(dt=DT,teacher=dict(E0_kPa=E0,E_kPa=E.tolist(),tau_s=TAU.tolist()),records=records,splits=splits,
    scores=scores,models=models,history=histories,positive_state=dict(tau_s=bank.tolist(),moduli_kPa=weights.tolist()),
    strain_only=dict(coef=ridge.coef_.tolist(),intercept=float(ridge.intercept_)),
    checks=dict(energy_balance_max=float(np.max(abs(work-energy-diss))),minimum_dissipation_increment=float(np.min(np.diff(diss,axis=1)))))

# Whole-path scores and a second window that includes the active loading process.
active={}
for name,p in predictions.items():
    active[name]={}
    for split in ['test','double','fast']:
        values=[]
        for k in splits[split]:
            rec=records[k]
            end=rec['onset']+rec['rise']+rec['hold']+rec['fall']+3+(10 if rec['kind']=='double' else 0)
            mask=T<=min(20,end)
            values.append(rmse(p[k,mask],truth[k,mask]))
        active[name][split]=float(np.mean(values))
result['active_window_mean_path_RMSE_kPa']=active
result['data_definition']=dict(seed=1616,noise_sd_kPa=.008,time_step_s=DT,
    train_unit='complete loading protocol',units='stress kPa; energy density kJ/m3',
    teacher='chosen small-strain Maxwell solid, constant temperature, no damage',
    architecture='PyTorch GRU: reset gate applied after hidden affine transform')
zero_input=torch.zeros((1,2001,2));zero={}
for name,cls in [('instantaneous',FeedForward),('gru',Recurrent)]:
    rest=[]
    for item in models[name]:
        model=cls();model.load_state_dict({k:torch.tensor(v) for k,v in item['weights'].items()});model.eval()
        with torch.no_grad():rest.append(model(zero_input).numpy()[0])
    y=np.mean(rest,axis=0)
    zero[name]=dict(initial_kPa=float(y[0]),after100s_kPa=float(y[-1]))
result['zero_input_100s']=zero

# Read the unmodified publisher workbook. A local copy avoids repeated downloads.
import hashlib,csv
import requests
from openpyxl import load_workbook
SOURCE='https://media.springernature.com/original/springer-static/esm/art%3A10.1038%2Fs41467-023-38280-4/MediaObjects/41467_2023_38280_MOESM7_ESM.xlsx'
SOURCE_SHA='788fa83caa5b2f835a63bab45f06107c17fe1c4f2e78acefb195e48334bbd809'
source=HERE/'peptide_source_data.xlsx'
if not source.exists():
    temporary=source.with_suffix('.xlsx.part')
    for attempt in range(4):
        offset=temporary.stat().st_size if temporary.exists() else 0
        try:
            with requests.get(SOURCE,headers={'Range':f'bytes={offset}-'} if offset else {},stream=True,timeout=(20,90)) as response:
                response.raise_for_status()
                mode='ab' if offset and response.status_code==206 else 'wb'
                with temporary.open(mode) as stream:
                    for chunk in response.iter_content(1024*1024):stream.write(chunk)
            assert hashlib.sha256(temporary.read_bytes()).hexdigest()==SOURCE_SHA
            temporary.replace(source);break
        except (requests.RequestException,AssertionError):
            if attempt==3:raise
assert hashlib.sha256(source.read_bytes()).hexdigest()==SOURCE_SHA
workbook=load_workbook(source,read_only=True,data_only=True)
curves=[]
for sheet,columns in [('Figure 4c',[(1,'PAM',1),(4,'p-Pep',1),(7,'p-Pep/Cu2+',1)]),
                      ('Figure 4e',[(25,'p-Pep/Cu2+',1),(45,'p-Pep/Cu2+',100)])]:
    pairs=[[] for _ in columns]
    for row in workbook[sheet].iter_rows(min_row=6,values_only=True):
        for j,(col,material,cycle) in enumerate(columns):
            x,y=row[col:col+2]
            if isinstance(x,(int,float)) and isinstance(y,(int,float)):pairs[j].append([float(x),float(y)])
    for points,(col,material,cycle) in zip(pairs,columns):
        a=np.asarray(points)
        curves.append(dict(sheet=sheet,material=material,cycle=cycle,columns=[col+1,col+2],
            points=a,n=len(a),peak_MPa=float(a[:,1].max()),
            ordered_curve_integral_MPa=float(np.trapezoid(a[:,1],a[:,0]))))
summary=[]
for row in workbook['Supp. Fig. 21a'].iter_rows(min_row=6,values_only=True):
    if isinstance(row[4],(int,float)):
        summary.append([int(row[4]),float(row[5]),float(row[11])])
workbook.close();summary=np.array(summary)
assert len(summary)==100 and summary[-1,0]==100
result['experiment']=dict(doi='10.1038/s41467-023-38280-4',source_url=SOURCE,sha256=SOURCE_SHA,
    curves=[{k:v for k,v in c.items() if k!='points'} for c in curves],
    summary_sheet='Supp. Fig. 21a',summary_columns=[5,6,12],
    copper_cycle100_peak_percent=float(summary[-1,1]),
    copper_cycle100_dissipation_percent=float(summary[-1,2]),
    copper_integral_retention_percent=100*curves[-1]['ordered_curve_integral_MPa']/curves[-2]['ordered_curve_integral_MPa'],
    material='peptide fibres in a polyacrylamide matrix; with/without copper coordination',
    sequence_note='Repeated cycles from the same specimen are not independent specimen replicates')
with (OUT/'experimental_curves.csv').open('w',encoding='utf-8',newline='') as stream:
    writer=csv.writer(stream);writer.writerow(['sheet','material','cycle','point_order','strain_mm_per_mm','stress_MPa'])
    for c in curves:
        writer.writerows([c['sheet'],c['material'],c['cycle'],i,*xy] for i,xy in enumerate(c['points']))
(OUT/'experimental_cycle_summary.json').write_text(json.dumps(summary.tolist(),indent=2)+'\n',encoding='utf-8')
(OUT/'results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
samples=dict(records=records,splits=splits,time_s=T.tolist(),strain=strain.tolist(),
    clean_stress_kPa=truth.tolist(),observed_stress_kPa=observed.tolist())
(OUT/'samples.json').write_text(json.dumps(samples,separators=(',',':'))+'\n',encoding='utf-8')
np.savez_compressed(OUT/'predictions.npz',**predictions,states=states,work=work,dissipation=diss,energy=energy)

# Consistent axes, units, and panel order for the offline HTML and notebook.
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
plt.rcParams.update({'font.family':'DejaVu Sans','font.size':10,'axes.spines.top':False,
    'axes.spines.right':False,'axes.labelcolor':'#30453f','text.color':'#243d35',
    'axes.edgecolor':'#bac7c0','xtick.color':'#53675e','ytick.color':'#53675e',
    'svg.hashsalt':'L16-history','figure.facecolor':'#fffef9','axes.facecolor':'#fffef9'})
names=['strain_only','instantaneous','gru','positive_state']
labels=['Strain only','Instantaneous MLP','GRU history','Positive modes']
colors=['#a2937b','#b57552','#387da0','#287b63']
def style(ax,title,xlabel='Time (s)',ylabel='Stress (kPa)'):
    ax.set_title(title,loc='left',fontsize=12,pad=13,weight='bold');ax.set_xlabel(xlabel);ax.set_ylabel(ylabel)
    ax.grid(axis='y',alpha=.18);ax.set_axisbelow(True)
demo=np.array([pulse(.5,d,1,d,.08) for d in [.5,3]])
demo_stress,_,demo_work,demo_diss,demo_energy=integrate(demo,E0,E,TAU)
def panel(i,fig,spec):
    if i==0:
        grid=spec.subgridspec(2,1,hspace=.08,height_ratios=[1,2]);axes=[fig.add_subplot(grid[j]) for j in range(2)]
        for j,(label,color) in enumerate([('0.5 s ramp','#bc8452'),('3 s ramp','#387e94')]):
            axes[0].plot(T,demo[j]*100,color=color,label=label)
            axes[1].plot(T,demo_stress[j],color=color,label=label,lw=2)
        style(axes[0],'A  Same amplitude, different speed','','Strain (%)');axes[0].tick_params(labelbottom=False)
        style(axes[1],'',ylabel='Stress (kPa)');axes[0].legend(frameon=False,ncol=2,fontsize=9)
        for a in axes:a.set_xlim(0,12)
        axes[1].axhline(0,color='#b8c7bb',lw=.8)
        return
    ax=fig.add_subplot(spec)
    if i==1:
        k=int(test[0]);ax.plot(strain[k]*100,truth[k],color='#223b34',lw=2.7,label='Reference')
        for name,label,color in zip(names,labels,colors):ax.plot(strain[k]*100,predictions[name][k],color=color,lw=1.3,ls='--',label=label)
        style(ax,'B  A complete held-out loop','Strain (%)');ax.legend(frameon=False,fontsize=8,loc='upper left')
        ax.text(.98,.03,f'Protocol {k}',transform=ax.transAxes,ha='right',fontsize=9)
    elif i==2:
        k=240;ax.plot(T,truth[k],color='#223b34',lw=2.7,label='Reference')
        for name,label,color in zip(names,labels,colors):ax.plot(T,predictions[name][k],color=color,lw=1.3,ls='--',label=label)
        style(ax,'C  Two pulses: unseen history');ax.set_xlim(0,20)
        ax.legend(frameon=False,fontsize=8,ncol=2,loc='upper right');ax.axhline(0,color='#b8c7bb',lw=.8)
    elif i==3:
        x=np.arange(3)
        for j,(name,label,color) in enumerate(zip(names,labels,colors)):
            values=[scores[name][s]['clean_RMSE_kPa'] for s in ['test','double','fast']]
            positions=x+(j-1.5)*.18
            ax.bar(positions,values,.16,color=color,label=label)
            ax.scatter(positions,[active[name][s] for s in ['test','double','fast']],s=17,facecolor='white',edgecolor='#263e36',zorder=5)
        ax.set_xticks(x,['Single / 48','Double / 32','Fast / 32']);ax.set_yscale('log');ax.set_ylim(.0003,.65)
        style(ax,'D  Hold out complete protocols','Protocol family / count','RMSE (kPa, log scale)')
        ax.legend(frameon=False,fontsize=8,ncol=2,loc='upper right')
        ax.text(.02,.03,'Bars: full 20 s  ·  circles: active window',transform=ax.transAxes,fontsize=9,bbox=dict(facecolor='#fffef9',edgecolor='none',alpha=.9,pad=3))
    elif i==4:
        for y,label,color,ls in [(demo_work[0],'Cumulative work','#384f73','-'),
                (demo_energy[0],'Stored energy','#b78351','--'),(demo_diss[0],'Dissipated energy','#287b63','-')]:
            ax.plot(T,y,color=color,lw=2,ls=ls,label=label)
        style(ax,'E  Where did the work go?',ylabel='Energy density (kJ/m³)');ax.set_xlim(0,12)
        ax.legend(frameon=False,fontsize=9);ax.text(.98,.12,'Work = stored + dissipated',transform=ax.transAxes,ha='right',fontsize=9)
    else:
        nonzero=weights[1:]>1e-8
        ax.vlines(bank[nonzero],0,weights[1:][nonzero],color='#287b63',lw=4,label='Fitted positive modes')
        ax.scatter(bank[nonzero],weights[1:][nonzero],s=40,color='#287b63',zorder=3)
        ax.vlines(TAU,0,E,color='#b78351',lw=2,linestyle='--',label='Reference modes')
        ax.scatter(TAU,E,marker='D',s=44,facecolor='white',edgecolor='#b78351',zorder=4)
        ax.set_xscale('log');ax.set_xlim(.045,14);ax.set_ylim(0,15)
        style(ax,'F  A learned spectrum of time scales','Relaxation time (s, log scale)','Mode modulus (kPa)')
        ax.legend(frameon=False,fontsize=9,loc='upper right')
        ax.text(.03,.04,f'Equilibrium modulus: {weights[0]:.3f} kPa\nReference: 6.000 kPa',transform=ax.transAxes,fontsize=9)
keys=['speed','loop','double','scores','energy','spectrum']
for i,key in enumerate(keys):
    fig=plt.figure(figsize=(8.2,5.1),layout='constrained');panel(i,fig,fig.add_gridspec(1,1)[0])
    fig.savefig(OUT/f'{key}.svg',metadata={'Date':None});plt.close(fig)
fig=plt.figure(figsize=(16.4,15.3),layout='constrained');grid=fig.add_gridspec(3,2,hspace=.09,wspace=.05)
for i in range(6):panel(i,fig,grid[i//2,i%2])
fig.savefig(OUT/'history_learning.svg',metadata={'Date':None})
fig.savefig(OUT/'history_learning.png',dpi=160,metadata={'Software':'L16 reproducible example'});plt.close(fig)
for j,key in enumerate(['materials','cycles','retention']):
    fig,ax=plt.subplots(figsize=(8.2,5.1),layout='constrained')
    if j==0:
        for c,color in zip(curves[:3],['#969a83','#b78351','#287b63']):
            a=c['points'];ax.plot(a[:,0],a[:,1],color=color,lw=1.8,label=c['material'])
        style(ax,'I  Three material formulations','Strain (mm/mm)','Stress (MPa)');ax.legend(frameon=False)
        ax.text(.03,.92,'Source: Figure 4c',transform=ax.transAxes,fontsize=9)
    elif j==1:
        for c,color in zip(curves[3:],['#287b63','#b78351']):
            a=c['points'];ax.plot(a[:,0],a[:,1],color=color,lw=1.7,label=f"Cycle {c['cycle']}")
        style(ax,'II  Peptide / PAM / copper composite','Strain (mm/mm)','Stress (MPa)');ax.legend(frameon=False)
        ax.text(.03,.92,'Source: Figure 4e',transform=ax.transAxes,fontsize=9)
    else:
        ax.plot(summary[:,0],summary[:,1],color='#287b63',lw=2,label='Peak stress')
        ax.plot(summary[:,0],summary[:,2],color='#b78351',lw=2,label='Dissipation')
        style(ax,'III  Repeated use of the same specimen','Cycle number','Relative to first cycle (%)')
        ax.set_ylim(85,102);ax.legend(frameon=False,loc='lower left')
        ax.text(.98,.94,f'Cycle 100: {summary[-1,1]:.2f}% / {summary[-1,2]:.2f}%',transform=ax.transAxes,ha='right',fontsize=9)
    fig.savefig(OUT/f'experimental_{key}.svg',metadata={'Date':None});plt.close(fig)
print('Teacher: chosen small-strain model; experimental curves are a separate companion')
print('144 train / 48 validation / 48 test; 32 double and 32 fast extra histories')
print('Model                    single       double       fast   (clean RMSE, kPa)')
for name,label in zip(names,labels):
    values=[scores[name][s]['clean_RMSE_kPa'] for s in ['test','double','fast']]
    print(f'{label:22s} '+''.join(f'{v:12.6f}' for v in values))
print(f"Maximum exact energy-balance residual: {result['checks']['energy_balance_max']:.2e} kJ/m3")
print(f"Experimental Cu composite integral retention: {result['experiment']['copper_integral_retention_percent']:.4f}%")
print('Six model panels, three experimental panels and complete numerical results: history_outputs/')
本次实际运行输出
instantaneous seed16: epoch120, validation RMSE0.100682
instantaneous seed26: epoch120, validation RMSE0.106441
instantaneous seed36: epoch120, validation RMSE0.092860
gru seed16: epoch120, validation RMSE0.012172
gru seed26: epoch120, validation RMSE0.016794
gru seed36: epoch120, validation RMSE0.012560
Teacher: chosen small-strain model; experimental curves are a separate companion
144 train / 48 validation / 48 test; 32 double and 32 fast extra histories
Model                    single       double       fast   (clean RMSE, kPa)
Strain only                0.121347    0.137434    0.132850
Instantaneous MLP          0.096306    0.098837    0.123470
GRU history                0.010476    0.016533    0.024014
Positive modes             0.000774    0.001153    0.001866
Maximum exact energy-balance residual: 5.27e-16 kJ/m3
Experimental Cu composite integral retention: 92.2330%
Six model panels, three experimental panels and complete numerical results: history_outputs/
先看图A。两条路径最大应变都是8%,保持时间都是1秒,但加载与卸载分别用0.5秒和3秒。快速过程更接近“结构还来不及调整就被拉开”,因此峰值较高;慢速过程在加载途中已经发生较多松弛。卸载之后的短暂负应力来自本例固定长度的边界安排。将这幅图与前面的元件方程对应起来,便能看见同一组参数如何响应不同的使用节奏。
一次运行 · 六幅结果图
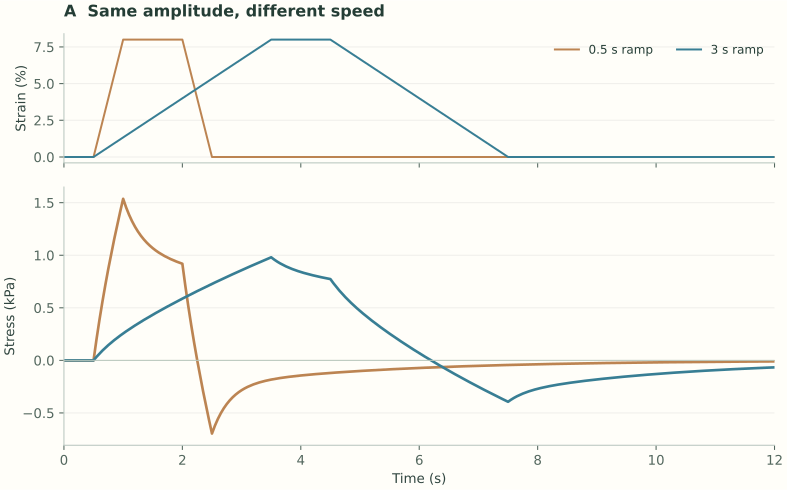
A|同为8%最大应变,分别用0.5秒和3秒加载,保持1秒,再按相同时长卸载。
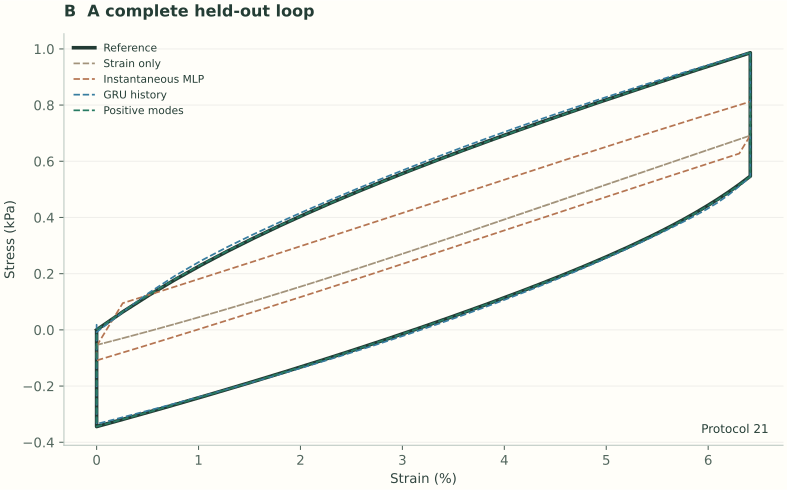
B|一整条留出加载路径的应力—应变曲线;参考解与四类模型在同一过程上比较。
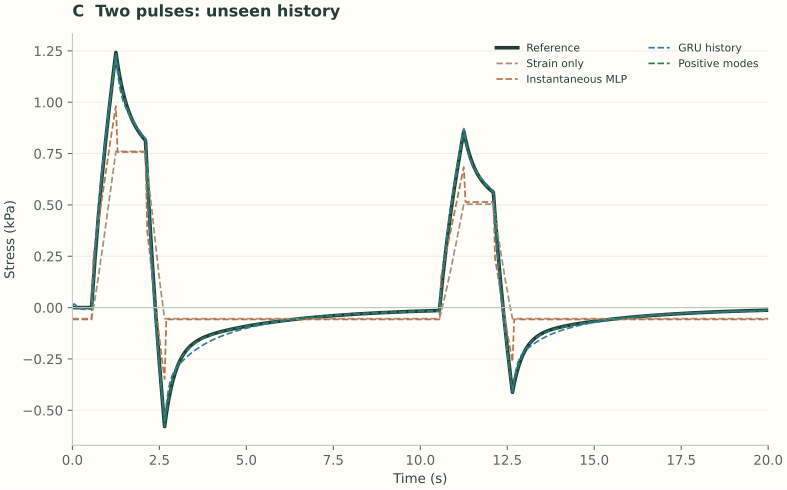
C|训练未见的双次加载路径;第二次加载开始时,材料的内部状态由此前历史决定。
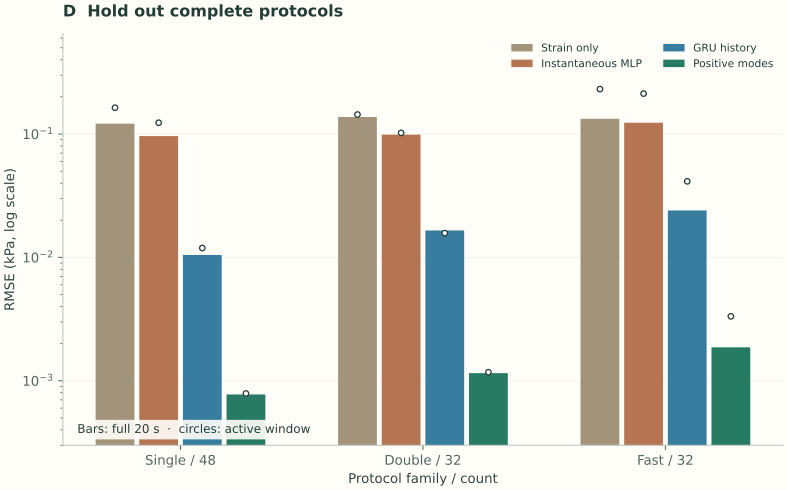
D|完整20秒路径误差以柱形表示;空心点为加载、卸载及其后3秒窗口的逐路径RMSE均值,纵轴为对数。
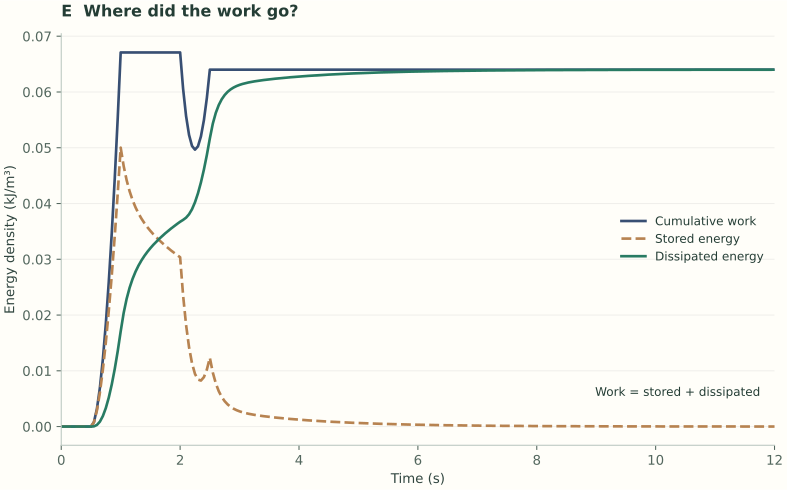
E|快速加载算例的累计输入功、储能与累计耗散;三者满足功的分配关系。
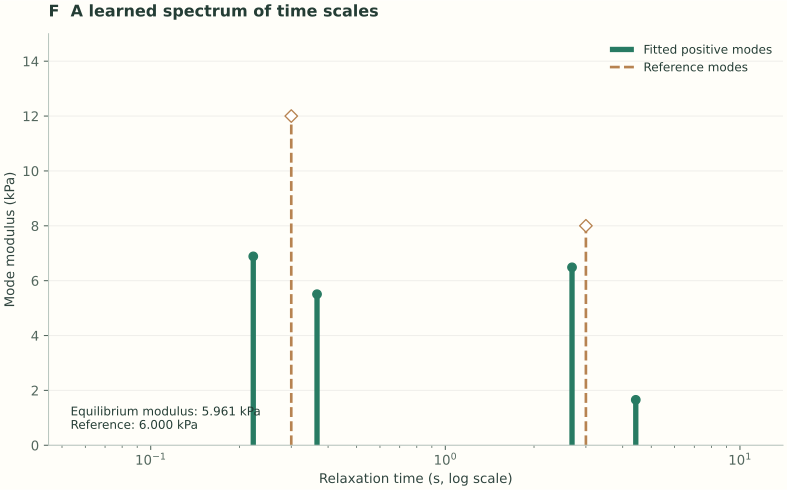
F|非负学习模型在固定时间网格上选择各支路模量;虚线菱形是生成数据所用的两个参考过程。
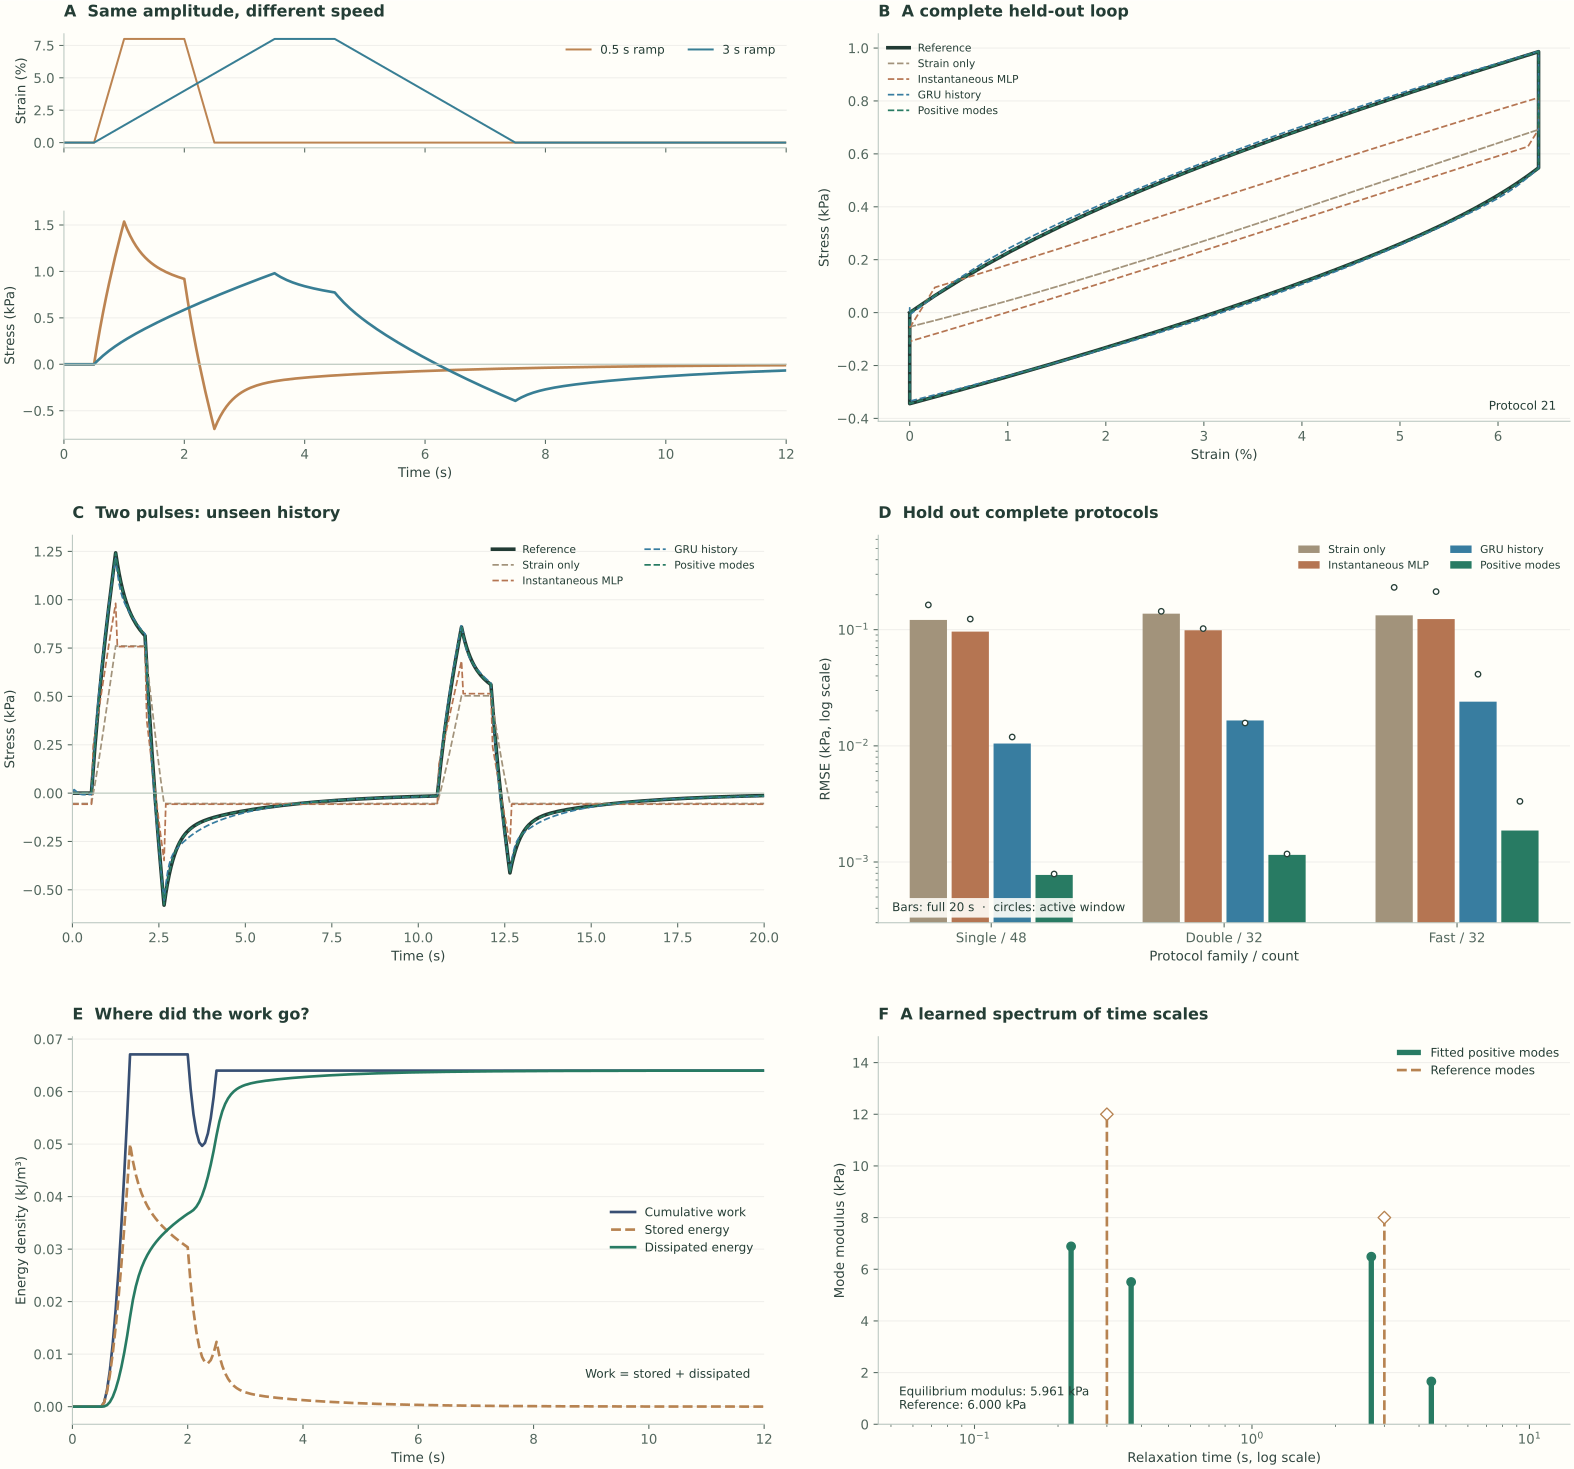
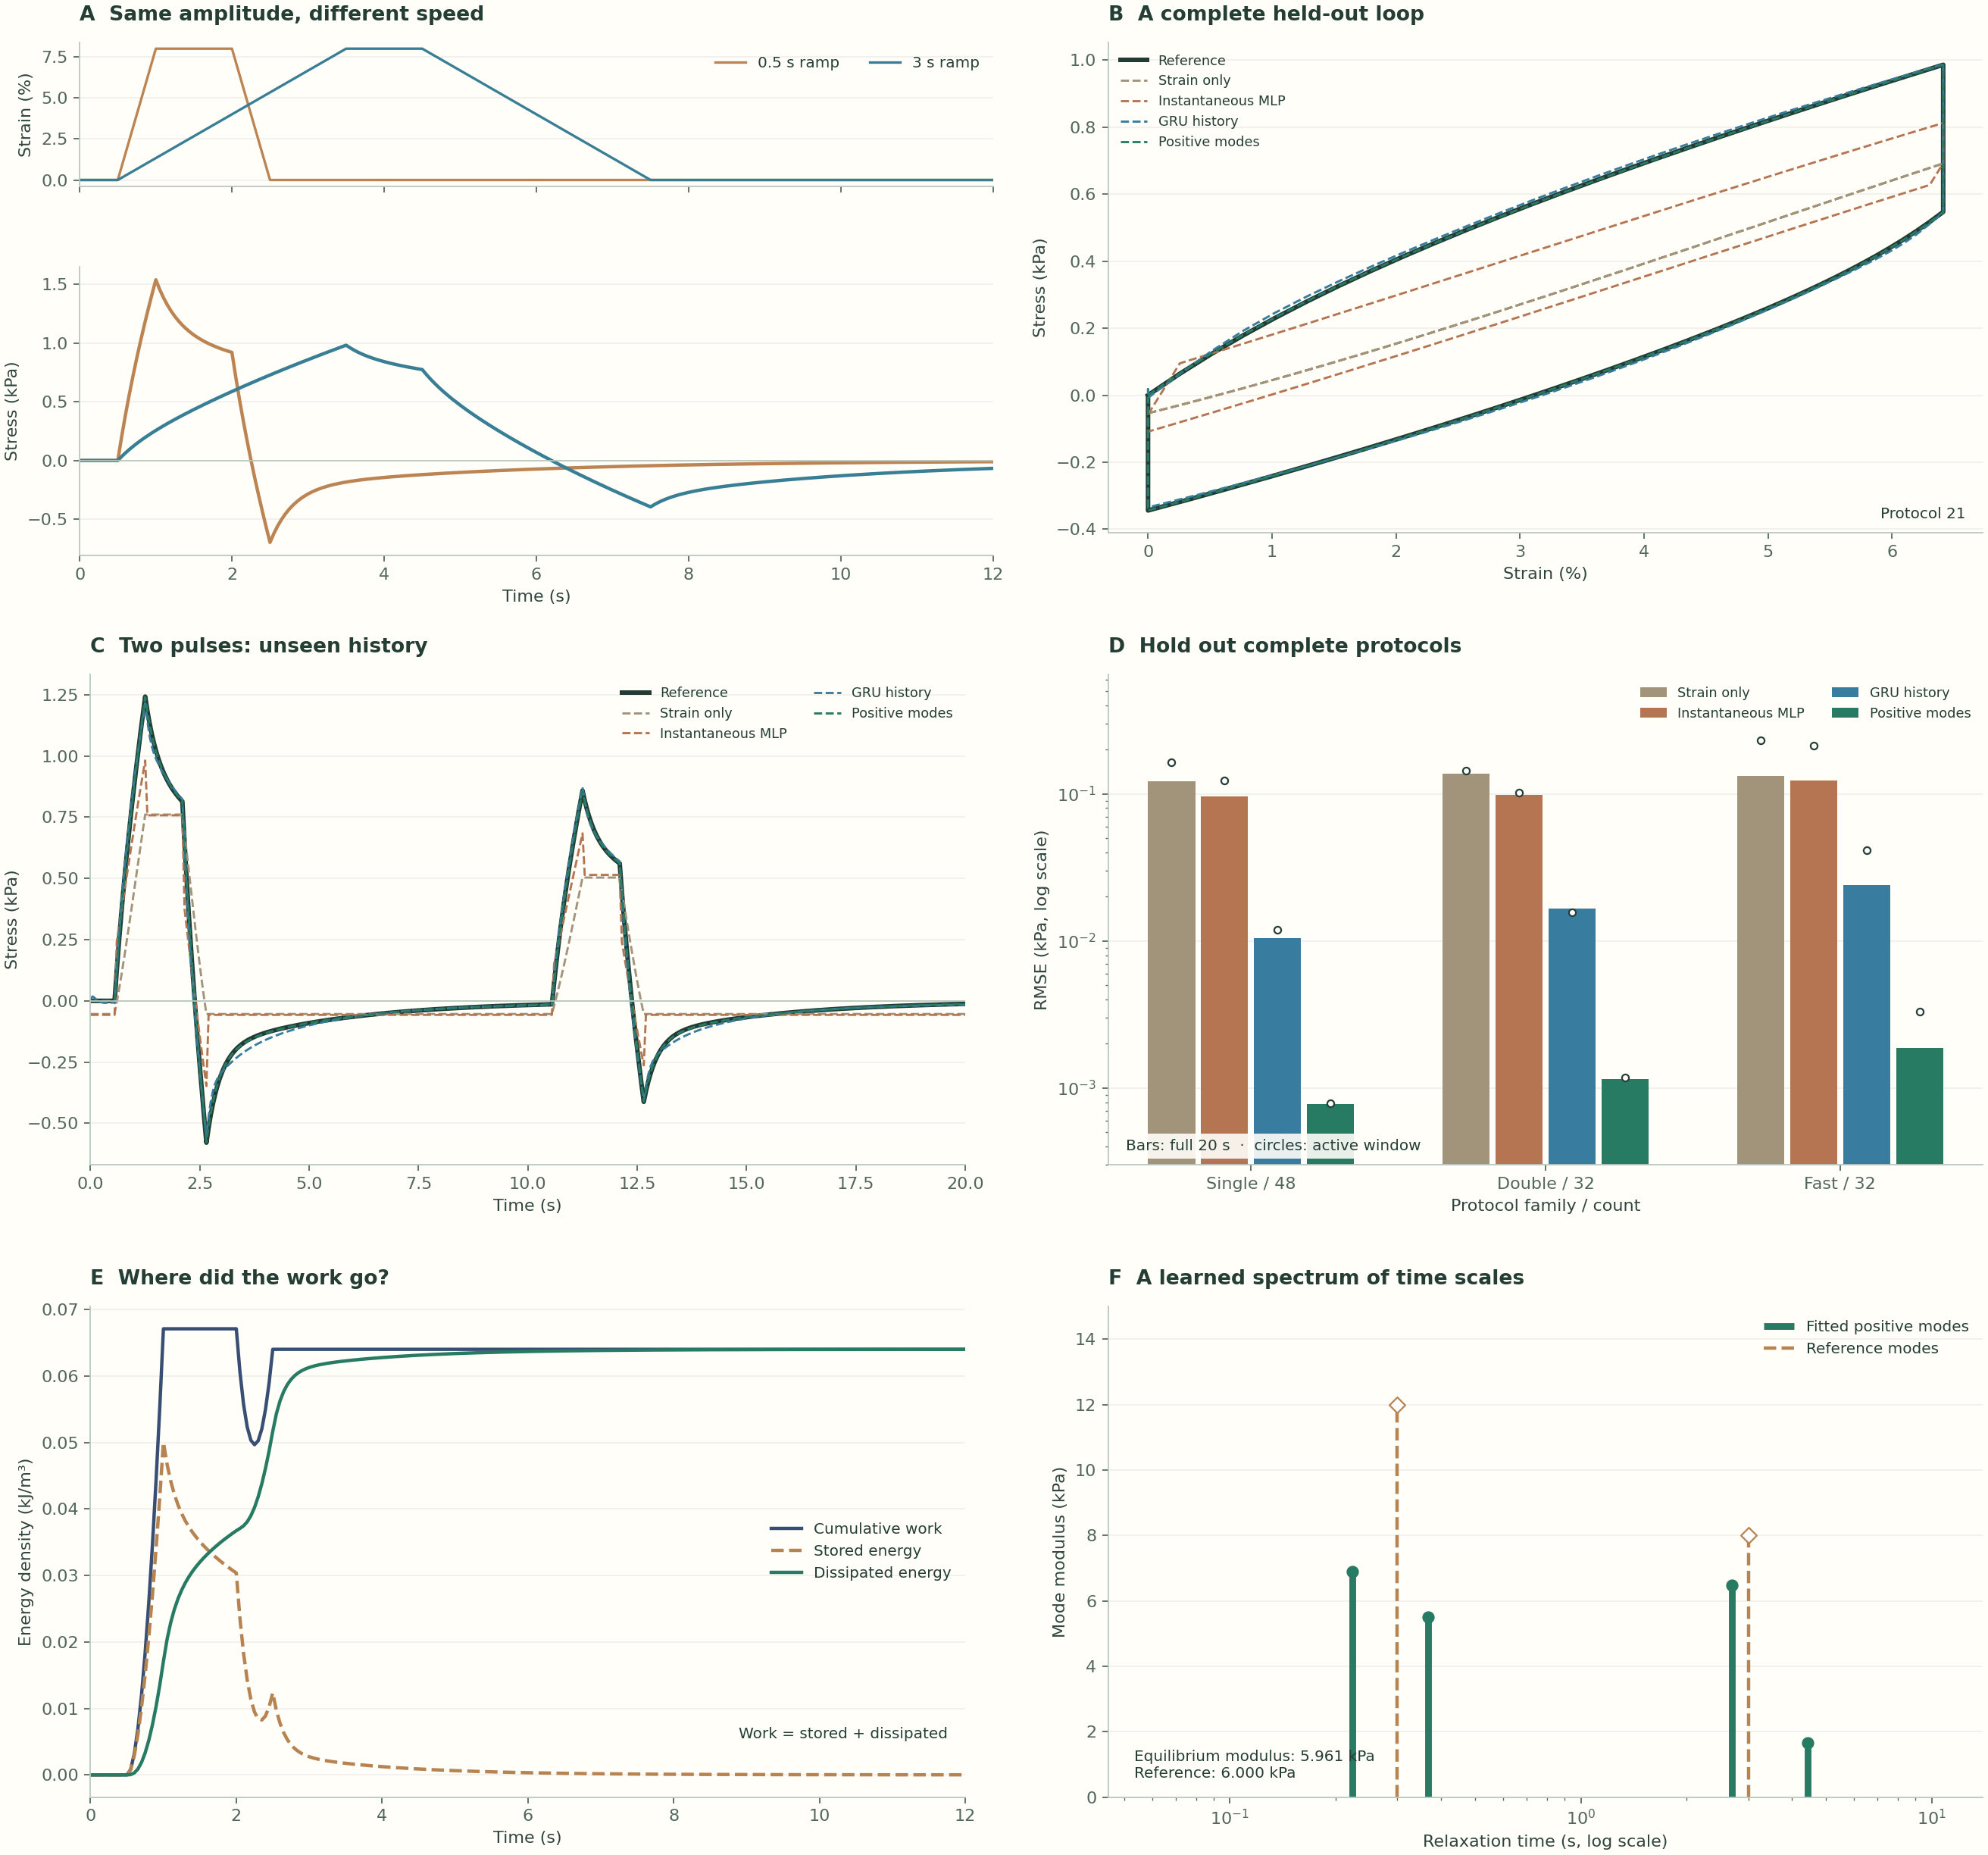
图B把一整条留出过程画成应力—应变回线。只看当前应变的模型只能给出一条单值关系,加载与卸载经过相同应变时会得到相同预测。加入增量的前馈网络能够区分方向,结果有所改善;GRU继续利用此前的状态,能够更接近参考回线。非负松弛模型则在与生成规律相容的结构中拟合支路强弱,因此获得了更低的误差。这个比较说明,提供合适的信息与选择合适的模型结构,都能减少学习的困难。
式中的P是当前评价组的路径数,M是每条路径的时间点数,本例M=401。先把各时刻的预测误差平方相加,除以总点数,再开平方,得到与应力相同单位的RMSE。普通留出路径上的误差依次约为0.12135、0.09631、0.01048和0.00077千帕,分别对应应变回归、前馈网络、GRU与非负松弛模型。这里对照的是无噪参考应力,含噪观测的误差也保存在结果文件中。
完整20秒内包含一段静置时间,所以图D还画出另一种评价:每条路径从开始到卸载结束后3秒的窗口,先计算各自的RMSE,再对路径取平均。对于更快的加载,变化集中在很短时间里,完整路径平均可能把这段难预测的过程稀释。GRU在快速路径上的完整误差约0.02401千帕,而上述窗口误差约0.04137千帕。两种数字对应不同的观察范围,一起看更容易找到模型需要改进的时段。
图C中的双次加载没有出现在训练路径里。第一次卸载后保留的状态,会继续影响第二次加载;模型每一步都从上一时刻的状态接着计算,而不是在第二次拉伸时重新开始。GRU在这组路径上的完整误差约0.01653千帕,非负模型约0.00115千帕。这个结果为下一步实验提供了明确方向:增加连续使用、不同等待时间和预加载条件,考察模型在更广的历史范围内怎样保留有效信息。
图E把能量关系画成三条曲线。加载时累计输入功增加,部分留在弹簧中,部分进入耗散;保持阶段没有新的位移功,储能仍会下降,耗散相应增加;卸载时试样能够向外部返回一部分功。程序逐段精确积分得到的能量平衡残差约为5.3×10⁻¹⁶千焦每立方米,处于浮点舍入的量级。这项检查直接核对了模型实现中的符号、单位和状态更新。
图F展示非负模型学出的时间尺度分布。真实生成参数有0.3秒与3秒两个过程,而预设的12个候选时间并不恰好包含它们;拟合便用相邻几个正的过程共同近似,长期模量得到约5.961千帕,接近设定的6千帕。这些柱表示在预设时间网格上拟合出的等效松弛过程,低预测误差说明它们能够共同表示所测路径。若要把时间尺度与具体接触或链段运动相联系,需要结合结构表征和针对性的环境变化实验。
还可以用一个简单输入检查学习模型:从初始零状态开始,始终保持零应变。非负松弛模型在这样的输入下保持零应力,而本次GRU平均预测到100秒时约为−0.0088千帕,前馈网络约为−0.0574千帕。这个小实验指出了可直接改善的地方:把静置条件纳入训练评价,约束读出偏置,或者采用能够保持零状态的物理结构。记住历史使曲线预测变好,已知的平衡条件则继续帮助我们设计更合适的模型。
回到柔性支撑层或传感带的研究,下一步可以据此安排采集:保留完整加载轨迹,测量独立试样,记录含水与温度,加入不同停留时间,并同时观察恢复和结构变化。第十三节的图结构、第十四节的图像与本节的历史状态也可以连接起来:先由分子连接或纤维图像描述样品,再由实际加载历史驱动时间响应预测。接下来的一节将转向实验信号本身,讨论怎样把仪器记录整理成可供这种研究使用的数据。
资料与延伸阅读
Maxwell,1867:On the Dynamical Theory of Gases,用于理解松弛时间与弹性、黏性联系。Chaudhuri等,2015在线、2016卷期:Hydrogels with tunable stress relaxation regulate stem cell fate and activity,用于连接水凝胶时间响应与细胞环境。
Xue等,2023:Strong, tough, rapid-recovery, and fatigue-resistant hydrogels made of picot peptide fibres;原始Source Data工作簿提供本节重绘的实验曲线与循环汇总。图中材料是肽纤维与聚丙烯酰胺构成的复合体系。
Cho等,2014:Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation。实现细节见PyTorch GRU文档。本节四组科学史插图为依据相关研究问题绘制的原创概念图,实验图和模型结果分别由注明的数据与代码生成。