从分子间的联系到一张可以检验的相图
分子怎样聚到一起:自组装、相分离与凝聚体
把糖放进水中搅拌,通常会得到看起来均匀的一杯糖水;把油和水混合,则常会看到小液滴逐渐聚成两层。进入生物大分子的世界,情况更加丰富:蛋白质可以排成纤维,核酸可以组装成设计好的形状,某些分子还会在细胞中形成富集的小区域。它们都涉及分子之间的联系,却需要用不同的测量来回答“形成了什么”。本节从这些看得见的现象出发,学习怎样把一个聚集问题整理成可计算、可学习的科学任务。
假设我们有一种蛋白质溶液,希望知道改变浓度和溶液条件后,它会保持均匀,还是出现分子较密集的区域。逐个配样观察能够积累证据,物理模型可以帮助安排条件,AI则可以从已经标好的样本中学习状态边界。后面的完整例子会建立一套明确的高分子溶液模型,数值求出共存边界,再训练分类器近似这张相图。数据、标签、模型与测试会在同一页展开,尤其关注最容易判断错的边界附近。
01先看清分子聚成了什么
“自组装”强调构件依靠彼此的相互作用形成一定的组织。《DNA与RNA:序列怎样组织成结构》介绍的DNA折纸就是一个例子:长支架与短链按照互补关系连接,形成设计的轮廓。在蛋白质中,局部相互作用也可以帮助许多分子沿某个方向排列,逐渐形成纤维。这里最关心的是构件怎样连接、是否具有方向或重复结构,以及形成的对象有多大。要描述这种组织,只有一张总体浓度表往往还不够。
把自组装想成搭积木会有帮助,不过分子积木一直处在热运动中,连接也可能形成和断开。构件的形状、可接触的位置以及接触强弱共同决定哪些组合容易出现。有些组装体偏向有限大小,有些会沿一个方向继续增长,还有些可以构成较大的网络。生物体系中的组装还可能受能量消耗和调控过程影响,因此,实验里“经过多久、怎样混合”也能改变我们实际观察到的结构。
“相分离”关注的是体系能否形成组成不同、在空间上分开的区域。对于本节的二元溶液,两个区域都含有高分子与溶剂,但一个区域高分子较稀,另一个较浓。油水分层可以帮助理解区域和界面,不过高分子溶液的两相通常不是一边只有高分子、另一边只有水。测量两侧各自的浓度,比把它们简单称为“水”和“固体”更能反映发生的过程。
相分离可以产生液滴,而液滴里的分子仍在运动、交换和重新排列。与此同时,分子也可能在富集区域内进一步形成有方向的组装结构。于是,自组装与相分离能够相互影响,却不能从一个名称直接推出另一个。若观察到浑浊,可以继续测粒子大小、局部组成和结构信号;若观察到纤维,可以继续检查它们是否均匀分布、是否形成浓稀区域。每种测量回答的问题都应当与所用标签对应。
第三个需要留意的变化是“连接成贯通的网络”。几条纤维彼此接触,并不一定已经把整个样品连接起来;一群液滴靠得很近,也不一定能承受持续的剪切。网络是否贯通、连接能维持多久以及受到载荷后如何运动,会影响凝胶与材料力学。本节先研究浓稀两相的平衡,《高分子网络与凝胶:交联、贯通和弹性》再把网络连通与凝胶响应作为独立问题展开,这样能够把组成变化和承载能力接得更清楚。
对准备数据的人来说,这些区分会直接改变表格的设计。同一个样品可以同时拥有“发现纤维”“观察到浓稀区域”“出现长期弹性响应”几个字段,每个字段对应各自的证据。若把它们全部压成“聚集”一个标签,模型即使预测得很一致,也很难回答研究者究竟应调整结构、浓度还是连接方式。科学问题先划清,后面的输入与输出才会有可解释的含义。
观察时间也应当进入记录。一种溶液在刚混合时均匀,几十分钟后出现小颗粒,再过几小时形成较长纤维,这些照片描述的是同一制备条件下的不同时间。将照片打散成独立训练样本,容易让模型在训练和测试中看到几乎相同的背景与同一批样品。更合适的组织方式是保留母样品、条件、观察时间和测量方法,按实际希望推广到的对象划分数据。
本节的计算任务选择其中一个容易严格定义的目标:在一个固定链长、固定自由能表达式的二元模型中,给定总体浓度和相互作用参数,平衡时是一相还是两相。纤维结构、网络连通和真实等待时间不进入这套标签。它们已经在前面的概念图中找到位置,后续可以分别增加模型与测量;当前程序则集中回答一张明确的平衡相图,让每个判断都能回到自由能核对。
02为什么长链有时愿意混合,有时愿意分开
从热运动的角度看,混合常常增加分子可选择的排列方式。将两种颜色的珠子放在一起,可以有许多混排顺序;若要求它们各自集中在一侧,可选的顺序就减少了。高分子带来一个特殊条件:同一条链上的珠子由骨架连着,不能像独立的小分子那样任意分配。因此,链长不仅改变单条链的尺寸,也改变整个溶液通过混合能够获得多少排列自由。
另一方面,不同成分相邻时的作用也会改变混合的代价。可以把体系想成一张座位表:高分子链占据一串相连座位,溶剂各占一个座位。安排座位时既要考虑有多少种排法,也要考虑不同邻居坐在一起的代价。这是格子模型的直观入口。格子帮助我们计数与定义体积分数,它并不要求真实液体里存在一张静止的方格桌。
在1940年代初,Flory与Huggins的研究把链的连通约束纳入溶液热力学。Flory在1942年的高分子溶液研究中,明确讨论了链段、溶剂占据格点以及平均邻接环境等假设;Huggins也在同期发展了长链化合物溶液的热力学描述。它们提供了一条很有启发的思路:先说明构件怎样占空间,再把可选排列和接触作用写进同一个量。
这个量是混合自由能。在温度、总体组成和所用模型已经给定时,比较不同状态的自由能,可以判断哪种组织方式在平衡中更有利。下面把总混合自由能除以格点总数与kBT,得到无量纲的g。kB是玻尔兹曼常数,T是绝对温度,二者乘积提供热能尺度;除完以后,g便表示“每个格点的混合自由能,以kBT为单位有多大”。
φ是高分子所占的体积分数,范围在0与1之间,1−φ就是溶剂体积分数。N表示一条链占据多少个与溶剂等体积的格点,本例固定为20;它是当前粗粒化模型的链长参数。χ是无量纲的有效相互作用参数,概括混合接触带来的贡献。这里采用不可压缩的二元体系,相同链长,并在每个指定条件下将χ视为不随浓度变化的常数。
前两项来自混合排列。由于0<φ<1时lnφ为负,这些项有利于降低混合自由能。高分子项带有1/N,是因为N个相连链段组成一个整体分子,独立分子数比同体积的独立小珠子少。把N增大,就减弱了这部分由独立链平移带来的混合收益。这里可以看出,分子“很长”为什么会影响溶液是否容易分开,而不仅是让显微图上的线条变长。
第三项χφ(1−φ)概括不同成分接触的贡献。φ(1−φ)在两种成分都较多时较大,在接近纯组分时趋近0;χ增大时,混合状态的这部分自由能随之上升。真实溶液中的χ可以随温度、溶剂条件和组成改变,具体关系需要实验或更细的模型来确定。本节直接扫描χ,保持它的含义为模型参数,因此相图纵轴不会把χ的数值冒充成某个温度读数。
取N=20、φ=0.20、χ=0.90,可以手算三个贡献。高分子排列项约为−0.01609,溶剂排列项约为−0.17851,接触项为0.90×0.20×0.80=0.14400,相加得到g≈−0.05061。负号表示相对于所选纯组分参考,混合自由能较低。但这还没有回答“保持均匀是否最好”,因为体系也可能分成两份各自仍含水的溶液,获得更低的总自由能。
这一步容易产生误解:看到g小于0,就以为一定不会相分离。实际上需要比较的是同一总组成下的候选状态。平均浓度为20%的均匀样品,与一部分较稀、一部分较浓但总量仍为20%的样品,才是公平的比较对象。单独拿20%与另一个完全不同总组成的自由能数值相比,会悄悄改变材料总量,也就改变了原本的问题。
把一份均匀溶液分成浓度不同的两相时,总的高分子量与溶剂量必须守恒。可以想象从一杯糖水中分出浓、稀两杯:浓的一杯多放了多少糖,稀的一杯就要相应少放,最后倒回去仍得到原来的总浓度。这个守恒关系会给两相各自的用量确定权重;用同样的权重平均两相自由能,图上得到的就是连接两点的直线。只要这条线低于原浓度处的自由能曲线,分成两相就有降低自由能的机会。下面的公切线计算将把这个直观判断精确到共存的两种浓度。
03用一条公切线找出两相,再理解细胞中的富集
设总体体积分数为φ₀,稀相浓度为φa,浓相浓度为φb,其中φa<φb。再设浓相占样品总体积的比例为λ,稀相占1−λ。总体高分子量等于两部分相加,所以φ₀是两个浓度的加权平均。这里的体积比例与高分子分子数比例不同:浓相里单位体积含有更多高分子,它们必须在守恒式中分别出现。
解出λ时,把φa移到左边,再除以两相浓度之差,就得到图中的杠杆规则。例如,如果稀相为0.05、浓相为0.55、总体为0.20,那么λ=(0.20−0.05)/(0.55−0.05)=0.30,表示浓相占总体积的30%。用原式验算,0.70×0.05+0.30×0.55恰好等于0.20。这个例子还说明,在同一对共存浓度之间改变总量,可以主要改变两相的体积比例。
在忽略宏观两相界面贡献的体相平衡模型中,每格点自由能也按相同的体积比例相加。因此,固定两端浓度后,总体组成从φa变化到φb时,两相自由能沿两个端点之间的直线变化。如果这条连线低于均匀状态的自由能曲线,分成这两相便能够降低自由能。像在一段凸起的山坡下架起直线桥,桥面与坡面的高度差就是可以直观看见的自由能收益。
真正的平衡两端还需要在所有可能组合里取最低。对于这里光滑的二元自由能曲线,合适的连线同时与两端相切:两端斜率相等,而且都等于连接它们的直线斜率。这叫公切线条件。移动少量成分或改变两相比例时,处于平衡的组合不再能继续降低总体自由能;几何上的共同斜率与截距,正对应二元体系中两种组分的平衡要求。
g′表示自由能对体积分数的变化率,可以先把它理解为曲线在某点的斜率。分式的分子是两端自由能差,分母是两端浓度差,所以它是连线斜率。公式要求左端斜率、右端斜率和连线斜率一致。程序先寻找自由能曲线的下凸包,即能够从下方支撑曲线的折线,再用公切线方程细化跨过非凸区间的两端,以得到共存浓度。
对于N=20、χ=0.90,本例得到稀相φa≈0.01308、浓相φb≈0.53798。若总体φ₀=0.20,浓相体积比例约为0.3561。注意稀相仍含有高分子,浓相也含有大量溶剂。下面的交互把浓度、自由能曲线和体积比例放在一起:改变总体浓度时,观察两相的组成与体积怎样分别变化;改变χ时,再观察公切线两端怎样移动。
改变组成与相互作用,观察平衡两相
N=20,χ=0.90,总体浓度0.20,浓相占总体积约35.61%。
自由能曲线的局部弯曲还能回答另一个问题。把一小块浓度略微提高,同时把另一块略微降低,使平均浓度不变,如果自由能下降,这种微小不均匀就有继续增长的热力学倾向。g″是曲率,也就是斜率随浓度怎样变化;g″<0时,均匀状态对这样的小扰动不稳定。令曲率等于0得到的两条边界叫旋节线,它们落在本模型的共存区内部。
每一项仍然是无量纲的,因为g和φ均无量纲。取N=20、φ=0.20、χ=0.90,曲率为1/(20×0.20)+1/0.80−1.80=−0.30,说明该均匀状态对小扰动不稳定。不过,共存边界与旋节线之间还有一些曲率为正的状态:微小扰动暂时不能降低自由能,但足够大的成分变化仍可以到达更低的两相组合。这一区域称为亚稳区,成核过程和界面代价会影响实际转变的等待过程。
因此,单凭曲率的正负判断“是否处于两相共存范围”,会漏掉亚稳区。它适合判断局部稳定性,公切线则比较全局的组成分配。随着χ减小,两相浓度逐渐接近,到临界点合并。本模型给出的临界浓度为1/(1+√N),临界χ为(1+1/√N)²/2;N=20时分别约0.18274和0.74861。相图上的这一点帮助我们看懂边界在哪里收拢。
生物学中的相分离研究让这些概念有了具体的细胞对象。2009年,Brangwynne等人在线虫胚胎P颗粒研究中观察到融合、润湿以及溶解和凝聚等液体样行为,并将其定位过程与凝聚条件的空间变化联系起来。P颗粒富含RNA和蛋白质,这项研究说明,细胞内某些富集区域可以从组成变化与液体行为的角度研究,而不必先假设它们都是被膜包住的固定颗粒。
把这段科学史放在公切线之后,是为了看清模型怎样帮助提问。若一个富集区域会随条件改变而消失,我们可以追踪内外浓度;若它们相遇后融合,可以测量形状恢复的时间;若分子持续进出,可以研究交换与局部环境。活细胞同时存在许多组分、反应和能量输入,具体凝聚体的研究需要把这些过程逐步加入。本节的二元平衡模型则提供一个起点,让“更容易凝聚”先对应一张有定义的条件图。
形状、动力学和组成信息可以互相补充。例如,圆形轮廓提示界面相关作用值得研究,但它本身没有给出两相各自浓度;观察到内部交换,则提示分子具有流动性,但其速率还需要与探针、时间尺度和环境联系起来。为AI准备凝聚体数据时,应保留这些可测量字段,使模型能够学习具体证据之间的关系。当前计算例子接下来使用的是自由能定义的标签,实验中的丰富现象由前面的观察思路继续承接。
04把相图变成AI任务,先决定什么算一个样本
在这张模型相图中,一个样本对应一组条件:总体高分子体积分数φ与相互作用参数χ,链长N固定20。数值计算先求该χ下的共存浓度;若φ严格位于两端之间,标签记为1,表示平衡两相共存;其余条件标签记为0,表示一相。恰好在共存端点时,另一相的体积比例趋于0,本例按一相端点处理。这个约定让训练目标与前面的守恒关系保持一致。
数据在56个χ条件上生成,范围为0.55到1.10,每个条件安排80个浓度点。浓度跨度较大,程序没有在φ上等间隔,而是在z=ln[φ/(1−φ)]上等间隔,z从−9到3。这样既能看到很稀的区域,也能覆盖较高浓度。z是体积分数的对数比值,是一种坐标变换,不是新的实验测量;由z还可以通过φ=1/(1+e−z)还原原始体积分数。
这个坐标为什么有用,可以用两个数理解。φ=0.5时,两种成分比例相等,z=ln1=0;φ=0.2时,z=ln0.25≈−1.386。对数把很小浓度附近的差别展开,使它们在输入空间中拥有可见距离。采用哪种坐标会影响聚类和模型的“相近”判断,因此代码和图注明确写出变换;绘图时仍使用原始φ,并用对数横轴显示较宽的浓度范围。
56个条件整组划分为34组训练、11组验证和11组测试,对应2720、880和880个常规样本。相邻五个条件按固定规则分配,一整行χ条件只能属于其中一个集合。因此,测试检查的是模型能否插值得到没有用于拟合的χ条件,而不是把同一行的一部分点留作训练、另一部分作为测试。所有χ仍位于同一个扫描区间,后面解释结果时也保持这一任务范围。
模型读取两个输入z和χ,它们各自的数值跨度可能不同。若直接计算距离,变化范围大的那一列容易占据主要份额,就像用毫米记长度、用米记宽度后直接比较数字大小。程序先用训练样本计算每列的均值和标准差,再把“离均值多远”换算成“相差几个标准差”,这一步叫标准化。验证与测试沿用同一组训练统计量,好比用同一把尺子量新样品;若每到一组数据就重新定刻度,同一个输入值在模型里代表的位置也会改变。
xj表示原始输入的第j个分量,这里j取1或2;μj与sj分别是训练集的均值和标准差,x̃j是变换后的值。例如某个输入在训练中的均值为0.8、标准差为0.1,新条件取0.9,标准化结果就是1。这个1表示比训练均值高一个标准差,不再沿用原始参数的单位。两维标准化后,欧氏距离才能按这套约定比较它们的共同差别。
先做一个没有标签的探索:K均值聚类把训练输入分为两组,使每个点到所属中心的距离平方之和尽量小。算法交替进行两个动作,把点分给最近中心,再把中心移动到所属点的平均位置。这里预先设K=2,并运行二十次不同初始化,保留较小的训练目标值。它回答的是“这些输入按当前距离怎样分组”,没有读取任何自由能标签,也没有被告知共存边界应该在哪里。
聚类与物理相态的差别,在这张相图上很容易看到。一个聚类可能主要收集较稀的输入,另一个收集较浓的输入,而两相共存区同时弯过多个浓度范围。即便恰好都用了数字0和1,聚类编号也不是物理标签。为了定量比较,程序只用训练集决定每个聚类的多数相态,再把这份对应关系用于测试;两个聚类也可以对应同一个多数相态,不能为了好看的分数强行一一配对。
监督分类则从一开始就使用物理标签。第一种分类器是逻辑回归,它先将标准化输入按权重相加,再通过sigmoid函数转换到0与1之间。这个值达到0.5时判为两相,否则判为一相。它提供了一条容易解释的参照:模型能调整方向和偏移,但在这两个输入坐标中,0.5对应的分界仍是一条直线,因此不一定能贴合弯曲的共存范围。
w是通过训练确定的两维权重,b是偏置,w·x̃表示两个“权重乘输入”结果相加。若相加结果为0,输出就是0.5;若为ln3≈1.099,输出为0.75。训练依据已知的0或1标签调整权重,使正确类别获得更合适的分数,并用正则化控制权重大小。这里的输出是分类模型的数值评分,是否与实验频率相符,还要通过对应的数据校准来研究。
为了学习弯曲边界,第二种方法采用带径向基核的支持向量分类器。可以把它理解为拿新条件与一些有代表性的训练条件比较:距离近的对象贡献较大,距离远的对象贡献衰减,不同对象的带符号贡献组合成最终判断。Cortes与Vapnik在1995年的支持向量网络研究中阐述了将输入非线性映射后进行分类的思路。这里用它解决的对象是模型相图中的条件点。
K表示两个标准化输入的相似性,γ控制相似性随距离减小的速度。若距离为0,相似性为1;若距离为1且γ=1,相似性为e−1≈0.368;距离增至2时,就变为e−4≈0.0183。ar是训练确定的带符号系数,x̃r是支持向量,b是偏置。将这些相似性加权求和得到h,h大于0时判为两相,小于0时判为一相;h本身不是配分函数或物理相分数。
代码用验证集选择正则化参数C和核参数γ。C控制训练误分类代价与较平滑分界之间的权衡,γ控制影响范围。候选值都提前列为0.1、1和10;逻辑回归比较三个C,核分类器比较九种组合,按验证集的平衡准确率选择。测试集只在选择完成后计算表现。这样可以区分模型在拟合时需要的信息、选择方法时需要的信息,以及最终评价才使用的信息。
对于这类任务,物理计算同时扮演监督来源和核对工具。我们用精确到数值容差的公切线计算定义目标,再问较轻便的分类器能学到多少边界形状。若未来加入更多分子特征、盐条件或多组分模型,可以继续沿用这样的组织方法:先明确标签如何获得,再安排条件组留出。模型越丰富,越需要保留每个标签与它所对应的科学定义之间的连接。
05完整运行一次,把边界附近单独拿出来看
下面的Python程序包含自由能、共存浓度求解、条件分组、聚类、两类监督模型以及六幅结果图。运行需要NumPy、SciPy、scikit-learn和Matplotlib。全部状态标签都来自本节的二元自由能模型,程序不调用实验数据库。输出中保存了每个条件的标签和预测、参数候选的验证结果、标准化统计量以及最终模型参数,可以从某个误判点一路查回它的物理判断依据。
"""An explicit polymer-solution model, clustering, and learned phase boundaries.

Dependencies: numpy, scipy, scikit-learn, matplotlib. All labels are calculated
from the stated N=20 Flory-Huggins model, not from condensate experiments.
"""
from pathlib import Path
from functools import lru_cache
import os
os.environ.setdefault("LOKY_MAX_CPU_COUNT", "4")
os.environ["OMP_NUM_THREADS"] = "1"
os.environ["OPENBLAS_NUM_THREADS"] = "1"
import json
import numpy as np
from scipy.optimize import least_squares
from scipy.special import expit, logit
from sklearn.cluster import KMeans
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score, balanced_accuracy_score, confusion_matrix
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.colors import ListedColormap

OUT = Path("phase_outputs")
N = 20
PHI_C = 1 / (1 + np.sqrt(N))
CHI_C = .5 * (1 + 1 / np.sqrt(N))**2
COLORS = ["#b38a57", "#567ca0", "#237c69", "#a75660"]


def free_energy(phi, chi):
    """Dimensionless mixing free energy per lattice site."""
    phi = np.asarray(phi)
    return phi / N * np.log(phi) + (1-phi)*np.log1p(-phi) + chi*phi*(1-phi)


def derivative(phi, chi):
    return (np.log(phi)+1)/N - np.log1p(-phi)-1 + chi*(1-2*phi)


def curvature(phi, chi):
    return 1/(N*phi) + 1/(1-phi) - 2*chi


def spinodal(chi):
    if chi <= CHI_C:
        return None
    return np.sort(np.roots([2*chi*N, N-1-2*chi*N, 1])).astype(float)


@lru_cache(maxsize=512)
def binodal(chi):
    """Lower convex hull supplies a bracket; common tangency refines endpoints."""
    if chi <= CHI_C:
        return None
    p = np.unique(np.r_[np.geomspace(1e-12, .08, 600),
                        np.linspace(.08, 1-1e-9, 3001)])
    f = free_energy(p, chi)
    hull = []
    for i in range(len(p)):
        while len(hull) >= 2:
            a, b = hull[-2:]
            if (f[b]-f[a])*(p[i]-p[b]) < (f[i]-f[b])*(p[b]-p[a]):
                break
            hull.pop()
        hull.append(i)
    a, b = max(zip(hull[:-1], hull[1:]), key=lambda ab: ab[1]-ab[0])
    sa, sb = spinodal(chi)

    def residual(z):
        lo, hi = expit(z)
        slope = (free_energy(hi, chi)-free_energy(lo, chi))/(hi-lo)
        return [derivative(lo, chi)-slope, derivative(hi, chi)-slope]

    fitted = least_squares(residual, logit([p[a], p[b]]),
        bounds=([logit(1e-13), logit(sb)], [logit(sa), logit(1-1e-10)]),
        xtol=1e-13, ftol=1e-13, gtol=1e-13, max_nfev=100)
    lo, hi = expit(fitted.x)
    assert fitted.success and max(abs(np.array(residual(fitted.x)))) < 1e-9
    assert lo < sa < sb < hi
    return [float(lo), float(hi)]


def phase_label(phi, bounds):
    phi = np.asarray(phi)
    if bounds is None:
        return np.zeros_like(np.asarray(phi), dtype=int)
    return ((phi > bounds[0]) & (phi < bounds[1])).astype(int)


def dataset():
    """Whole chi conditions belong to a single split; sampling fixed in advance."""
    rows = []
    for group, chi in enumerate(np.linspace(.55, 1.10, 56)):
        bounds = binodal(chi)
        split = "test" if group % 5 == 2 else ("validation" if group % 5 == 4 else "train")
        for z in np.linspace(-9, 3, 80):
            phi = float(expit(z))
            rows.append(dict(group=group, chi=float(chi), phi=phi, z=float(z),
                split=split, sample="grid", label=int(phase_label(phi, bounds)),
                distance=None if bounds is None else float(min(abs(z-logit(np.array(bounds)))))))
        # Challenge samples stay with held-out conditions. They never train models.
        if split == "test" and bounds is not None:
            for edge in bounds:
                for offset in [.005, .015, .05, .15, .35]:
                    for sign in [-1, 1]:
                        z = float(logit(edge)+sign*offset)
                        phi = float(expit(z))
                        rows.append(dict(group=group, chi=float(chi), phi=phi, z=z,
                            split="boundary", sample="boundary", label=int(phase_label(phi, bounds)),
                            distance=offset))
    return rows


def evaluate(y, pred):
    return dict(accuracy=float(accuracy_score(y, pred)),
                balanced_accuracy=float(balanced_accuracy_score(y, pred)),
                confusion=confusion_matrix(y, pred, labels=[0, 1]).tolist(), count=len(y))


def main():
    OUT.mkdir(exist_ok=True)
    rows = dataset()
    X = np.array([[r["z"], r["chi"]] for r in rows])
    y = np.array([r["label"] for r in rows])
    masks = {s: np.array([r["split"] == s for r in rows])
             for s in ["train", "validation", "test", "boundary"]}
    train, val = masks["train"], masks["validation"]
    scaler = StandardScaler().fit(X[train])
    Z = scaler.transform(X)
    # Clustering receives no labels. Cluster numbers have no phase identity.
    km = KMeans(n_clusters=2, n_init=20, random_state=1212).fit(Z[train])
    clusters = km.predict(Z)
    mapping = [int(np.mean(y[train & (clusters == k)]) >= .5) for k in range(2)]
    candidates = []
    models = {}
    for C in [.1, 1., 10.]:
        model = LogisticRegression(C=C, solver="lbfgs", max_iter=2000, tol=1e-9).fit(Z[train], y[train])
        score = balanced_accuracy_score(y[val], model.predict(Z[val]))
        candidates.append(dict(model="linear", C=C, validation=float(score)))
        if "linear" not in models or score > models["linear"][0]:
            models["linear"] = (score, model, dict(C=C))
    for C in [.1, 1., 10.]:
        for gamma in [.1, 1., 10.]:
            model = SVC(C=C, gamma=gamma, kernel="rbf", tol=1e-7).fit(Z[train], y[train])
            score = balanced_accuracy_score(y[val], model.predict(Z[val]))
            candidates.append(dict(model="rbf", C=C, gamma=gamma, validation=float(score)))
            if "rbf" not in models or score > models["rbf"][0]:
                models["rbf"] = (score, model, dict(C=C, gamma=gamma))
    preds = {
        "curvature": (curvature(expit(X[:, 0]), X[:, 1]) < 0).astype(int),
        "cluster_mapped": np.array(mapping)[clusters],
        "linear": models["linear"][1].predict(Z),
        "rbf": models["rbf"][1].predict(Z)}
    scores = {name: {s: evaluate(y[m], pred[m]) for s, m in masks.items()}
              for name, pred in preds.items()}
    for i, r in enumerate(rows):
        r["cluster"] = int(clusters[i])
        r["predictions"] = {k: int(v[i]) for k, v in preds.items()}
    svm = models["rbf"][1]
    linear = models["linear"][1]
    result = dict(scope="Equilibrium binary incompressible N=20 polymer solution; constant chi; generated labels",
        N=N, critical=dict(phi=float(PHI_C), chi=float(CHI_C)), scores=scores,
        counts={s: int(m.sum()) for s, m in masks.items()},
        groups={s: sorted({rows[i]["group"] for i in np.flatnonzero(m)}) for s, m in masks.items()},
        selected={k: v[2] for k, v in models.items()}, candidates=candidates,
        scaler=dict(mean=scaler.mean_.tolist(), scale=scaler.scale_.tolist()),
        cluster=dict(centers=km.cluster_centers_.tolist(), phase_mapping_from_train=mapping),
        linear=dict(coef=linear.coef_.tolist(), intercept=linear.intercept_.tolist()),
        rbf=dict(support_vectors=svm.support_vectors_.tolist(), dual=svm.dual_coef_.tolist(),
                 intercept=svm.intercept_.tolist(), gamma=float(svm._gamma)),
        example=dict(chi=.90, phi=.20, binodal=binodal(.90)))
    lo, hi = result["example"]["binodal"]
    result["example"]["dense_volume_fraction"] = (.20-lo)/(hi-lo)
    result["example"]["free_energy_drop"] = float(free_energy(.20, .9) -
        ((hi-.20)*free_energy(lo, .9)+(.20-lo)*free_energy(hi, .9))/(hi-lo))
    # Independently useful coordinates for an offline equilibrium-condition viewer.
    result["interaction_table"] = [{"chi":float(c), "binodal":binodal(c)} for c in np.linspace(.55,1.10,111)]
    make_plots(rows, X, Z, y, masks, models, km, scaler, preds, result)
    (OUT/"results.json").write_text(json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8")
    (OUT/"samples.json").write_text(json.dumps(rows, ensure_ascii=False, indent=2), encoding="utf-8")
    print("N = 20; critical phi = %.6f, chi = %.6f" % (PHI_C, CHI_C))
    print("Samples:", result["counts"])
    print("Selected on validation:", result["selected"])
    for name in preds:
        print("%-15s balanced accuracy: test %.4f, boundary %.4f" %
              (name, scores[name]["test"]["balanced_accuracy"], scores[name]["boundary"]["balanced_accuracy"]))
    print("chi=0.90: dilute %.6f, dense %.6f, dense volume fraction %.6f" %
          (lo, hi, result["example"]["dense_volume_fraction"]))


def make_plots(rows, X, Z, y, masks, models, km, scaler, preds, result):
    plt.rcParams.update({"font.family":"DejaVu Sans", "font.size":10,
        "axes.spines.top":False, "axes.spines.right":False, "axes.labelcolor":"#2a4139",
        "text.color":"#2a4139", "svg.hashsalt":"L12-phase", "figure.facecolor":"#fffdf8",
        "axes.titlepad":13, "savefig.facecolor":"#fffdf8"})
    zs = np.linspace(-9,3,181); cs = np.linspace(.55,1.10,111)
    zz, cc = np.meshgrid(zs,cs); pp = expit(zz)
    GX = np.c_[zz.ravel(),cc.ravel()]; GZ = scaler.transform(GX)
    gr = models["rbf"][1].predict(GZ).reshape(zz.shape)
    gc = km.predict(GZ).reshape(zz.shape)
    bounds = [binodal(c) for c in cs]
    cmap = ListedColormap(["#e4eee7","#70b7a2"])

    def phase_axes(ax):
        ax.set_xscale("log");ax.set_xlim(expit(-9),expit(3));ax.set_ylim(.55,1.10)
        ax.set_xlabel("Polymer volume fraction");ax.set_ylabel("Interaction parameter chi")
        ax.set_xticks([.0002,.002,.02,.2,.8], labels=["0.0002","0.002","0.02","0.2","0.8"])

    def boundaries(ax, spin=False):
        use=np.array([[c,*b] for c,b in zip(cs,bounds) if b is not None])
        for j in [1,2]:ax.plot(use[:,j],use[:,0],color="#283b35",lw=1.5,label="Coexistence" if j==1 else None)
        if spin:
            ss=np.array([[c,*spinodal(c)] for c in cs if c>CHI_C])
            for j in [1,2]:ax.plot(ss[:,j],ss[:,0],color="#ab7046",ls="--",lw=1.4,label="Spinodal" if j==1 else None)
        ax.plot(PHI_C,CHI_C,"o",color="#ab7046",ms=4)

    def draw(ax, key):
        if key=="energy":
            p=np.linspace(.00001,.65,501);chi=.9;lo,hi=binodal(chi)
            m=(free_energy(hi,chi)-free_energy(lo,chi))/(hi-lo)
            # Subtract the tangent to magnify the meaningful free-energy difference.
            tangent=free_energy(lo,chi)+m*(p-lo)
            ax.plot(p,free_energy(p,chi)-tangent,color=COLORS[2],lw=2,label="Uniform state minus tangent")
            ax.hlines(0,lo,hi,color="#ac7852",lw=3,label="Two-phase free energy")
            ax.scatter([lo,hi],[0,0],color="#ac7852",zorder=5)
            ax.axvline(.20,color="#aaa18c",ls=":")
            ax.set(xlabel="Polymer volume fraction",ylabel="Free energy per site / kBT\nrelative to common tangent",
                   title="A  Why two compositions can lower free energy",ylim=(-.0006,.009))
            ax.legend(fontsize=8)
        elif key=="phase":
            truth=np.array([phase_label(expit(zs),b) for b in bounds])
            ax.contourf(pp,cc,truth,levels=[-.5,.5,1.5],cmap=cmap,antialiased=False)
            boundaries(ax,True);phase_axes(ax);ax.legend(fontsize=8,loc="lower left")
            ax.set_title("B  One phase, coexistence, and local instability")
            ax.text(.002,1.04,"Two phases",fontsize=10);ax.text(.002,.61,"One phase",fontsize=10)
        elif key=="clusters":
            ax.contourf(pp,cc,gc,levels=[-.5,.5,1.5],cmap=ListedColormap(["#d5e2ee","#dfceba"]),antialiased=False)
            boundaries(ax);phase_axes(ax);ax.set_title("C  Two clusters of inputs are not two phases")
            centers=scaler.inverse_transform(km.cluster_centers_)
            ax.scatter(expit(centers[:,0]),centers[:,1],marker="X",s=65,color="#495b69",edgecolor="white")
        elif key=="learned":
            ax.contourf(pp,cc,gr,levels=[-.5,.5,1.5],cmap=cmap,antialiased=False)
            boundaries(ax);phase_axes(ax);ax.set_title("D  Learned boundary and held-out errors")
            m=masks["test"] & (preds["rbf"]!=y)
            ax.scatter(expit(X[m,0]),X[m,1],s=20,marker="x",color="#b04c56",label="Wrong grid test")
            ax.legend(fontsize=8,loc="lower left")
        elif key=="scores":
            names=["curvature","cluster_mapped","linear","rbf"]
            labels=["Local curvature","Mapped clusters","Linear classifier","RBF classifier"]
            for j,s in enumerate(["test","boundary"]):
                ax.barh(np.arange(4)+(.17 if j else -.17),
                    [result["scores"][k][s]["balanced_accuracy"] for k in names],
                    height=.3,color=["#9bbcac","#477c9f"][j],label=["Held-out grid","Near boundary"][j])
            ax.axvline(.5,color="#9b9589",ls=":",label="Chance reference")
            ax.set_yticks(range(4),labels);ax.set_xlim(0,1.03);ax.invert_yaxis()
            ax.set(xlabel="Balanced accuracy",title="E  Evaluate both classes and both test sets")
            ax.legend(fontsize=8,loc="upper center",bbox_to_anchor=(.5,1.01),ncol=3)
            ax.set_title("E  Evaluate both classes and both test sets",pad=34)
        elif key=="boundary":
            for name,color in zip(["curvature","linear","rbf"],[COLORS[0],COLORS[1],COLORS[2]]):
                offsets=[.005,.015,.05,.15,.35];rates=[]
                for d in offsets:
                    m=masks["boundary"] & np.array([r["distance"]==d for r in rows])
                    rates.append(balanced_accuracy_score(y[m],preds[name][m]))
                ax.plot(offsets,rates,"o-",color=color,label=name.replace("rbf","RBF").replace("curvature","Local curvature"))
            ax.set_xscale("log");ax.set_ylim(0,1.04);ax.axhline(.5,color="#aaa18c",ls=":")
            ax.set(xlabel="Distance from coexistence boundary in logit(phi)",
                   ylabel="Balanced accuracy",title="F  Moving toward a boundary makes the test harder")
            ax.legend(fontsize=8)
        ax.grid(alpha=.12)

    keys=["energy","phase","clusters","learned","scores","boundary"]
    for key in keys:
        fig,ax=plt.subplots(figsize=(7.4,5.2),layout="constrained");draw(ax,key)
        fig.savefig(OUT/(key+".svg"),metadata={"Date":None});plt.close(fig)
    fig,axes=plt.subplots(3,2,figsize=(14.8,15.6),layout="constrained")
    for ax,key in zip(axes.flat,keys):draw(ax,key)
    fig.savefig(OUT/"phase_learning.svg",metadata={"Date":None})
    fig.savefig(OUT/"phase_learning.png",dpi=180)
    plt.close(fig)


if __name__ == "__main__":
    main()
本次实际运行输出
N = 20; critical phi = 0.182744, chi = 0.748607
Samples: {'train': 2720, 'validation': 880, 'test': 880, 'boundary': 140}
Selected on validation: {'linear': {'C': 1.0}, 'rbf': {'C': 10.0, 'gamma': 1.0}}
curvature       balanced accuracy: test 0.7361, boundary 0.5071
cluster_mapped  balanced accuracy: test 0.5000, boundary 0.5000
linear          balanced accuracy: test 0.6780, boundary 0.5000
rbf             balanced accuracy: test 0.9977, boundary 0.8786
chi=0.90: dilute 0.013079, dense 0.537982, dense volume fraction 0.356105
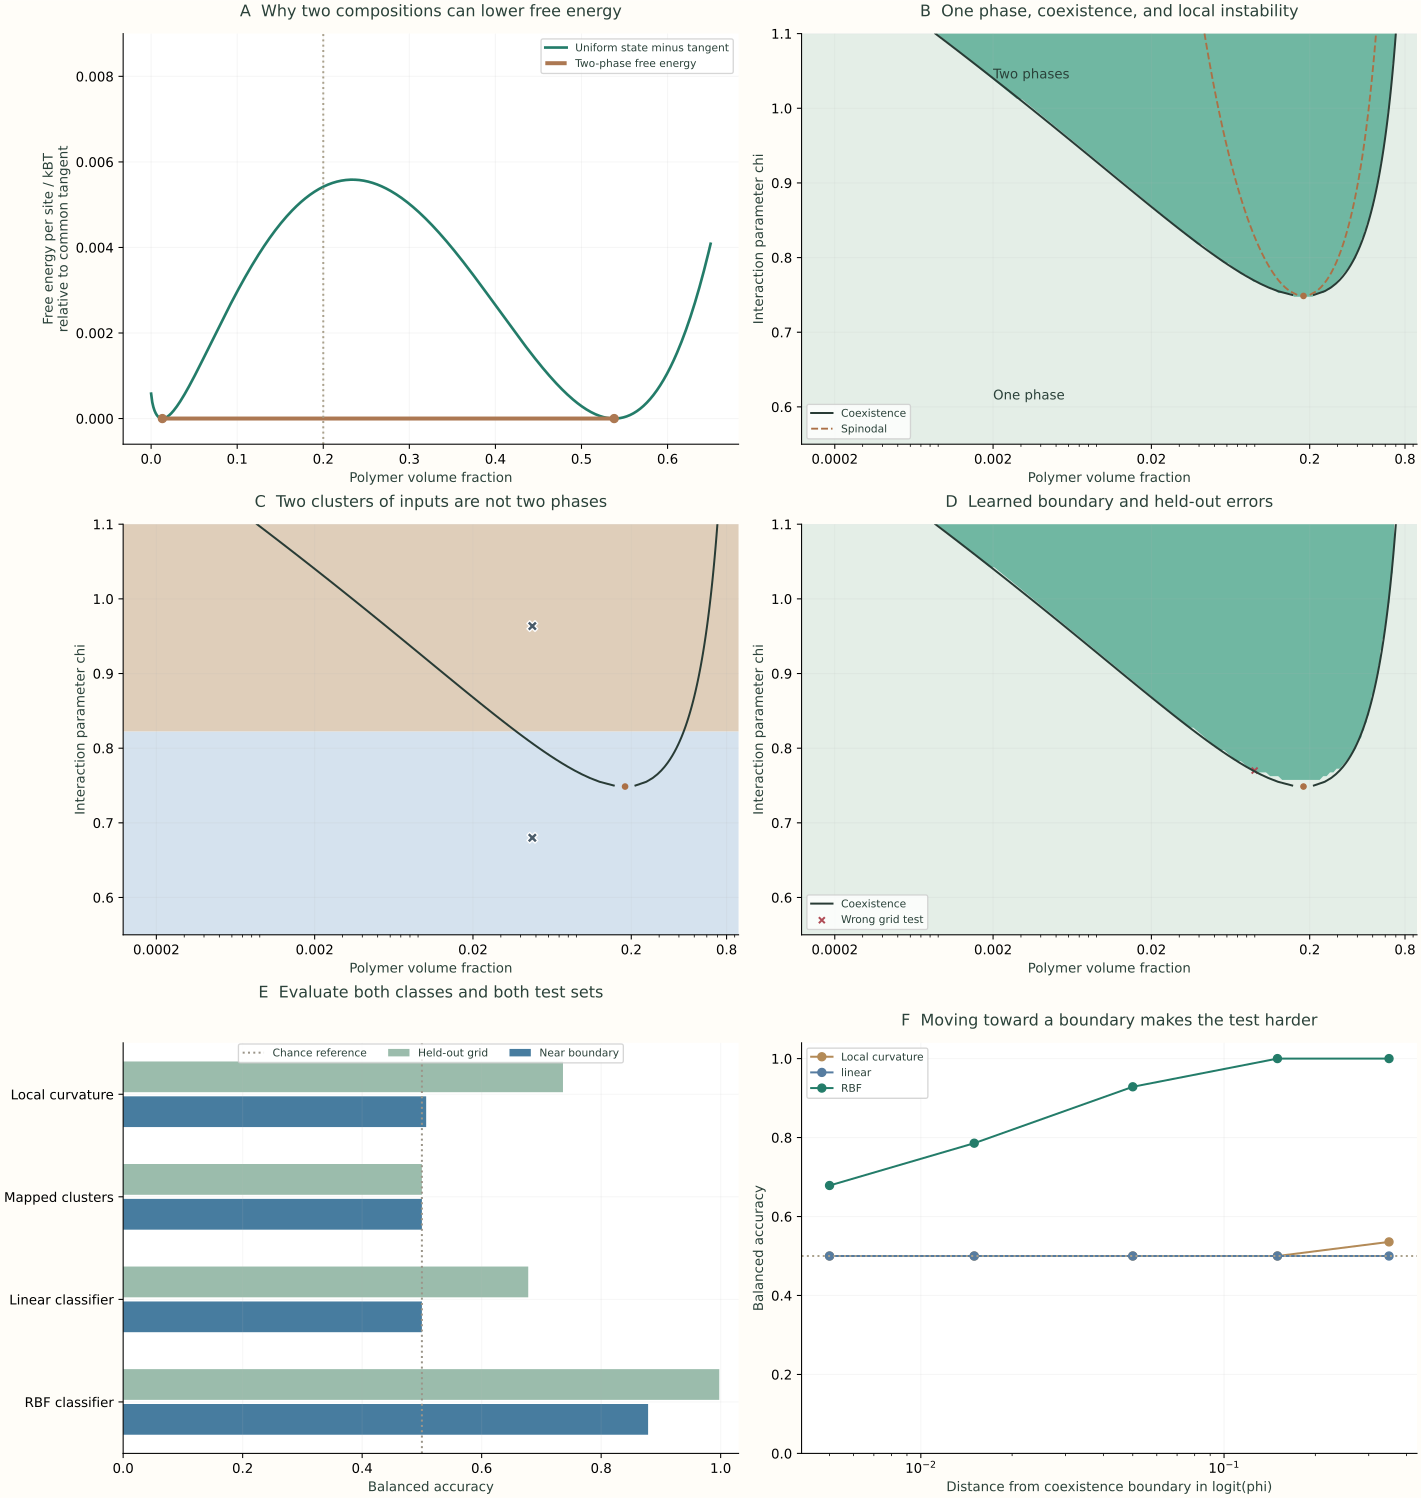
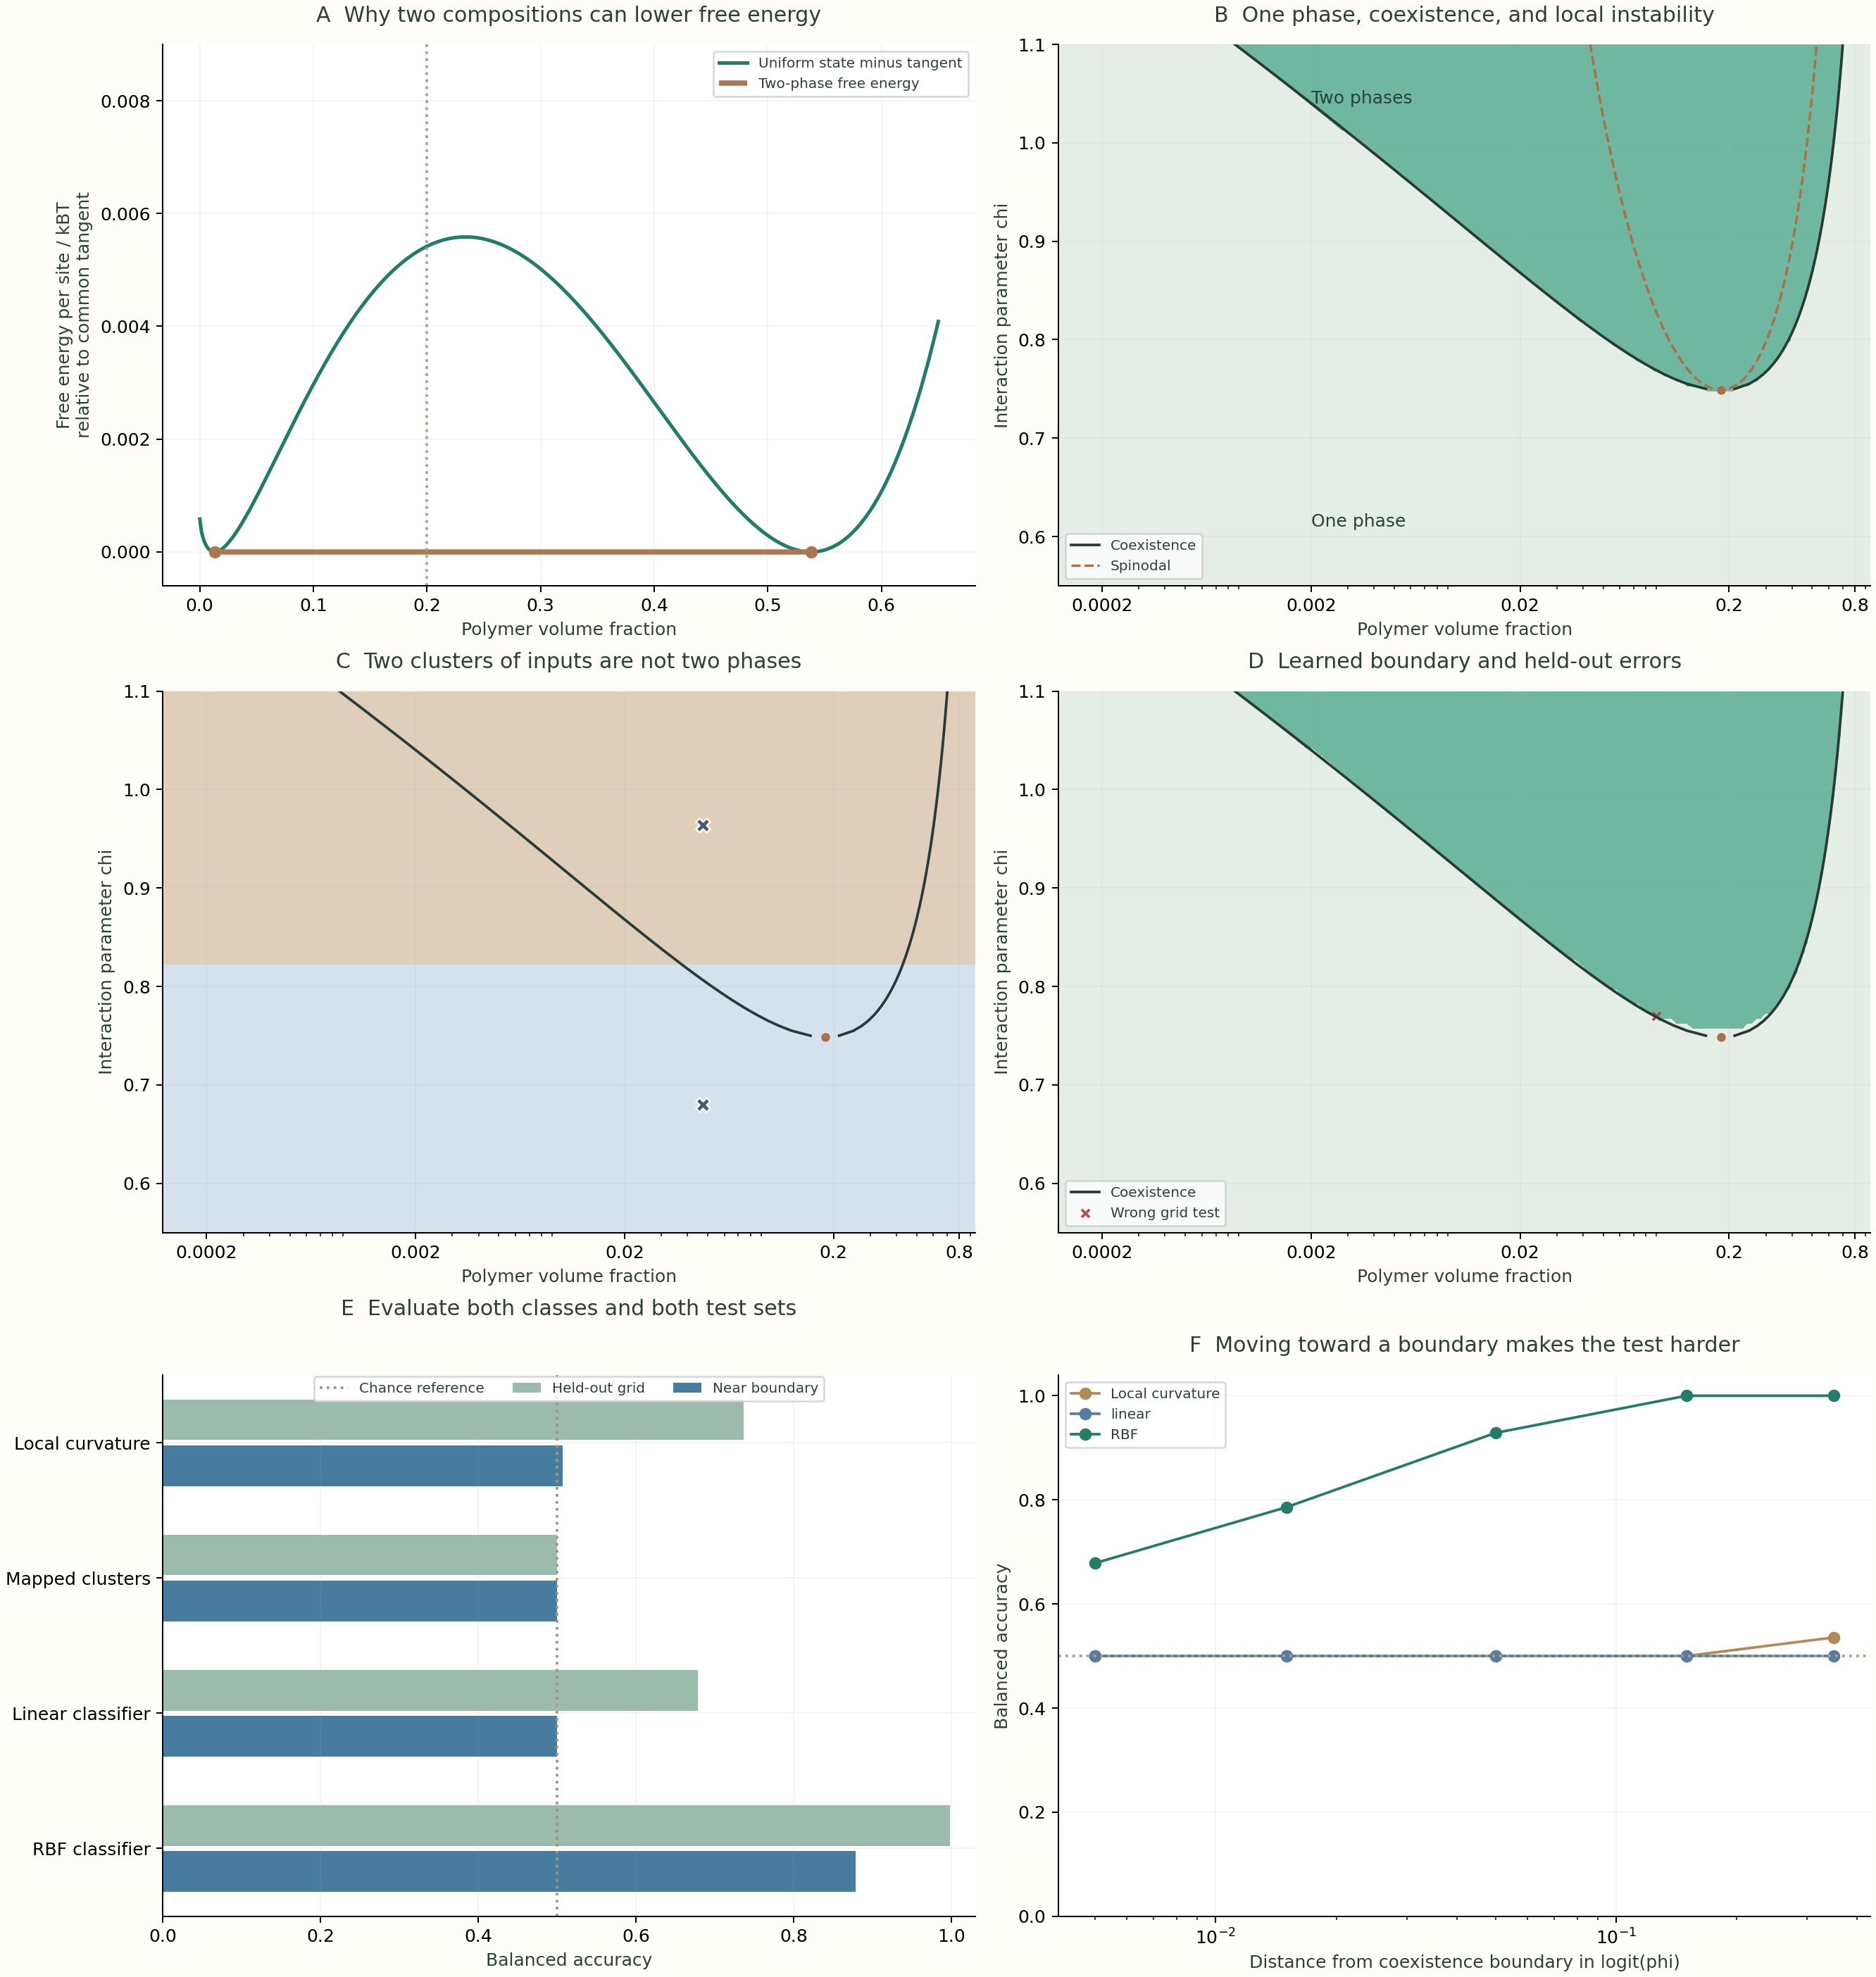
A图先处理一个容易被纵轴尺度遮住的问题。原始自由能曲线可能整体倾斜,使较小的相分离收益不容易看清,因此图中从每个点的g减去了同一条公切线的值。减去一条直线不改变曲率,也不改变共存端点;两相连线变成水平的0,均匀状态高于它的部分就直接表示自由能差。竖虚线标出总体浓度0.20,帮助对应前面的手算与交互。
B图给出物理模型的相图。浅色是一相范围,绿色是平衡两相共存范围,两条实线对应稀相与浓相的共存浓度,虚线标出旋节线。沿固定χ的一条水平线移动,就是改变总体浓度;沿固定φ的一条竖线移动,就是改变相互作用参数。临界点标在两条边界汇合处。对数横轴保留了稀相端的细节,因此等宽距离代表的是浓度倍数变化,而不是相同浓度差。
C图是同一输入平面上的两个聚类,叉形标记是从训练样本得到的中心,黑线仍是物理共存边界。两种颜色的分界与黑线的形状明显不同,因为前者优化输入距离,后者来自自由能与组成守恒。训练多数标签映射后,这次两个聚类都对应一相,测试平衡准确率为0.5000。这个结果让我们具体看见,“发现两个数据簇”与“识别两种平衡状态”需要不同的证据。
D图展示实际训练后的核分类器,底色是模型预测,黑线是物理边界,红叉是常规测试集上判断错误的条件。该图中的新χ行未参与训练或参数选择。大部分底色边缘贴近黑线,但越接近边界,细小偏移越容易让标签翻转。把误判点放回相图,可以比单独报告一个总分更直接地说明模型在哪些条件上需要进一步补充数据。
一次运行 · 六幅结果图
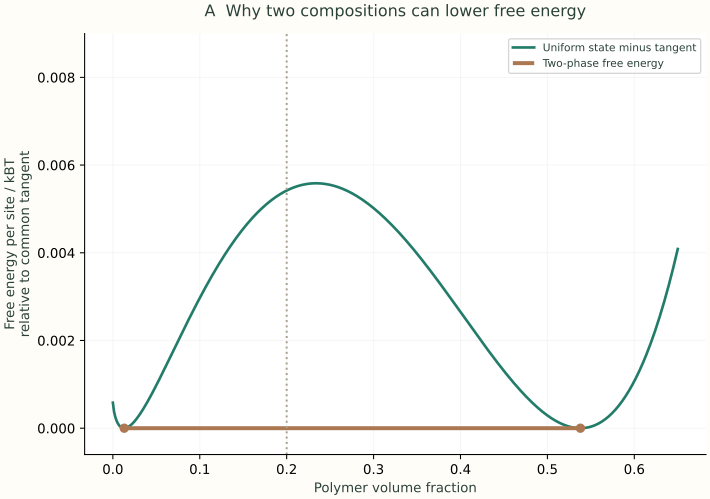
A|减去公切线后,直接观察均匀状态与两相状态的自由能差。
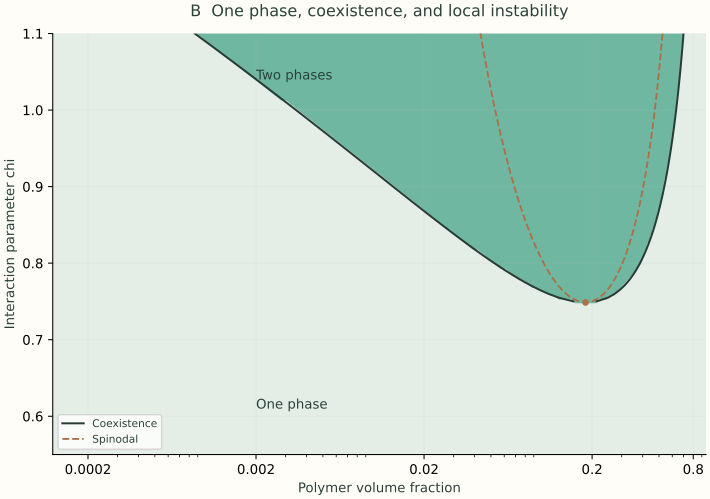
B|数值共存边界与旋节线:全局平衡和局部稳定性分别判断。
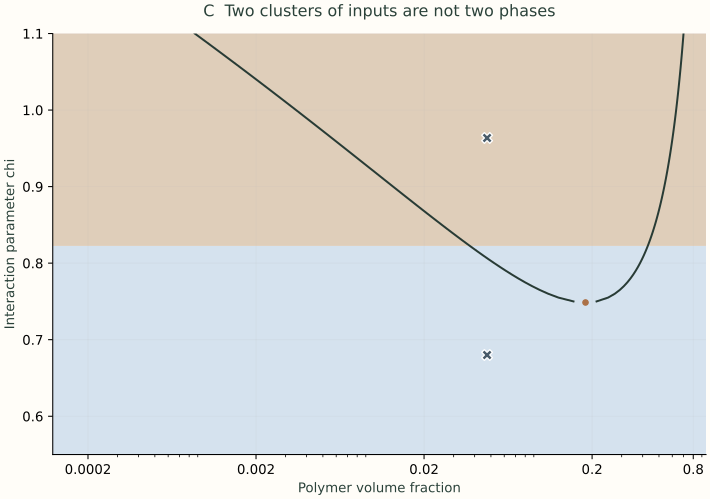
C|标准化输入的两个聚类,与物理共存边界对照。
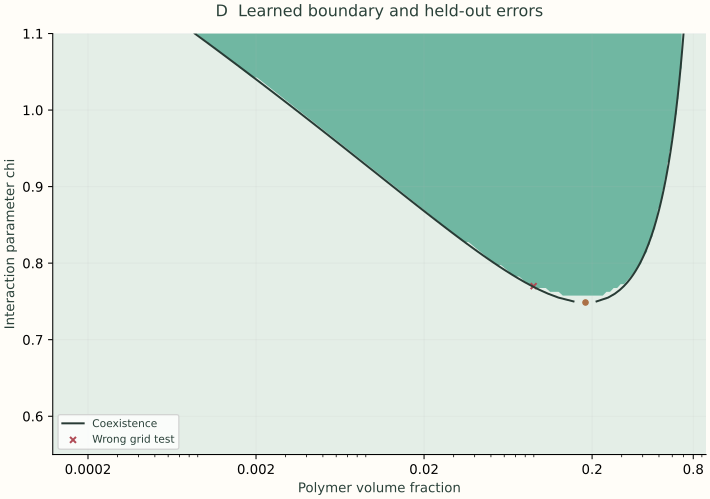
D|核分类器实际学到的相图,红叉标出整组留出χ条件上的错误。
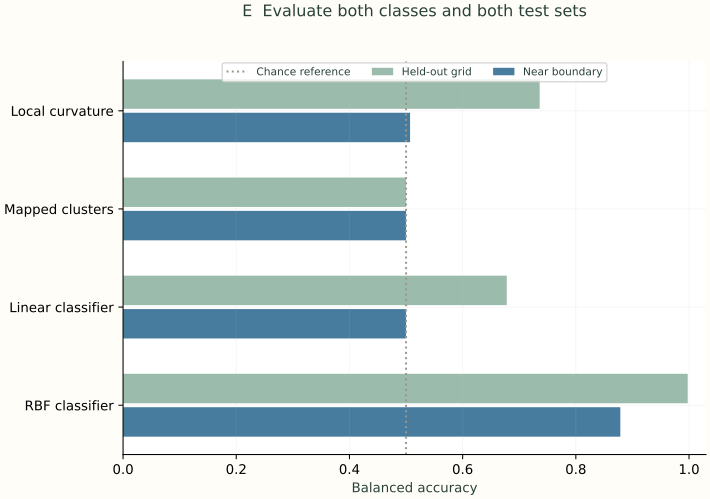
E|四种判断方法,在常规网格和边界加密测试中的平衡准确率。
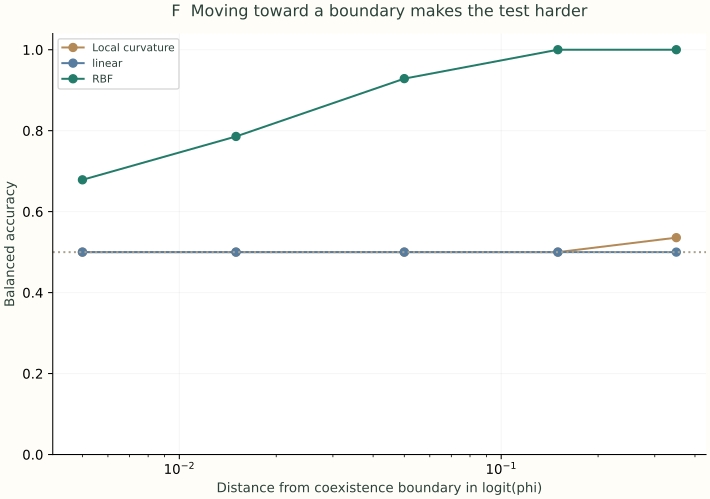
F|按距离分组的边界测试:距离采用浓度的对数比值坐标。
计算总体准确率时,一相样本多的测试集可能使“总猜一相”看起来也不差。本节同时采用平衡准确率:先分别计算一相样本和两相样本各有多少被正确识别,再让两个比例等权平均。这样每一类都占一半评价权重。它与物理相分数不同,一个衡量分类结果,一个描述样品内部的体积组成,名称相近时尤其需要看清分母是什么。
nc表示真实第c类的样本数,ncok表示其中预测正确的数量;它们相除得到Rc。R₀表示真实一相样本中判对的比例,R₁表示真实两相样本中判对的比例。若一相判对90%、两相判对60%,平衡准确率为(0.90+0.60)/2=0.75。总猜一相时,R₀=1而R₁=0,结果恰为0.5。E图将几种方法都放在这把尺子上:用曲率负值判断、聚类映射、直线分类器和核分类器,分别在常规测试与边界测试中比较。
常规测试集上,曲率规则的平衡准确率为0.7361,直线分类器为0.6780,核分类器为0.9977。曲率规则的漏判集中在共存区中的亚稳部分,来源是局部稳定性与全局平衡的含义不同;直线分类器受分界形状约束;核分类器则通过训练学习了更接近共存曲线的边界。它们的误差分别提示科学定义、表示能力和有限样本学习三个层面的问题。
为了更仔细地评价边界,程序还在七个高于临界χ的留出条件上,围绕稀相与浓相两端分别加密采样。在每个端点的z坐标两侧,按0.005、0.015、0.05、0.15和0.35五种距离各放一个点,共140个挑战样本。它们对应的χ都属于测试条件,没有进入训练或验证。这种有目的的采样检查“离真实边界多近时还能分清”,与常规网格测试互相补充。
边界测试中,核分类器的平衡准确率为0.8786,低于常规测试得分。F图将这些样本再按距离分组,使难度变化直接可见。这里的距离是在z=ln[φ/(1−φ)]坐标中测量的,因此不是固定的体积分数差;在不同浓度处,相同z距离对应不同的绝对浓度变化。评价时把这个定义保留下来,读者才能复算图中的每个点,也才能设计另一种更贴近实验精度的采样方式。
这张边界图还能转成下一步的数据安排。如果仪器测浓度的误差已经接近模型分界附近的差别,就应当将测量重复性与预测误差一起考虑;若某一段边界样本特别少,可以在那一组条件周围补样。此时AI提供的是一个有待实验检查的条件候选,研究者仍需记录温度、溶剂、分子组成和观察时间,再测量对应的相态证据。后面讨论主动学习时,会进一步把这种补样选择写成算法。
读者也可以从本例做一个明确的小研究:保持N=20不变,先改成更稀疏的训练χ行,观察哪些边界位置最先出现误判;或者保持采样不变,调整输入坐标,比较聚类的形状如何变化。每次只改变一个研究因素,并继续使用原定的训练、验证与测试职责,就能够把结果联系到具体原因。若改动是在查看测试结果后提出的,下一轮再安排新的留出条件,便能继续检验这项改动。
当研究对象从模型溶液走向蛋白质、核酸与它们的混合物时,分子之间的连接方式会重新进入主线。可结合位点的数量、序列排列、电荷与环境会改变局部作用,富集又能改变接触机会,随后还可能发生纤维形成或网络连接。我们已经有了组织这些问题的方法:为组成、结构、动力学和力学分别选择可测量的量,再让AI学习它们与条件之间的关系。《高分子网络与凝胶:交联、贯通和弹性》从这里继续,研究大量水存在时,分子网络怎样让样品保持形状。
资料与延伸阅读
Flory,1942,Thermodynamics of High Polymer Solutions;Huggins,1942,Thermodynamic Properties of Solutions of Long-Chain Compounds。本节选用固定N、不可压缩二元体系与浓度无关χ的自由能表达式,曲线、共存浓度及标签均由这一模型实际计算。
Brangwynne等,2009,Germline P granules are liquid droplets that localize by controlled dissolution/condensation,研究记录了P颗粒的液体样行为及溶解、凝聚与定位的联系。历史插图按研究问题重新绘制,细胞与液滴轮廓用来解释概念。
Cortes与Vapnik,1995,Support-vector networks;实现接口参见scikit-learn的KMeans、LogisticRegression和SVC说明。本节聚类与分类均由同页代码实际拟合,完整条件与结果保存在可下载文件中。