把分子放回环境中
高分子的环境响应:水合、温度与电荷
一杯牛奶加入酸以后,可能出现絮状物;含水凝胶换进另一种盐溶液,体积可能改变;同一份蛋白质样品,加热前后也可能表现不同。这些现象提醒我们,材料的行为与周围环境密切相连。《生命中的三类长链:蛋白质、糖链与核酸》记录了分子的组成、顺序和连接,这一节把水、温度和溶液条件补进来,解释它们如何改变分子之间的接触,再训练一个能读取酸碱度的回归模型。
本节要解决的是一个很实际的数据问题:如果同一种分子在两次实验里表现不同,研究者怎样判断差别来自哪里?我们会先从分子与水的接触讲起,再用酸性、碱性基团的电离建立一个可以亲手计算的例子。最后,程序将把相同组成放在一系列pH条件下,比较只看组成与同时看到环境的预测。这样,环境不再只是论文方法部分的一段背景,而成为每条数据里可以检查、计算和比较的变量。
01水一直在场,也一直参与
看生物大分子的结构图时,我们经常只看见一条彩色的链,周围是一片空白。真实的水溶液却很拥挤:水分子不断移动,与链的不同位置接触,又被其他水分子替换。离子、小分子和其他大分子也可能在附近。一处侧链能否与另一处侧链相遇,遇到以后能停留多久,都受这个环境影响。图中的空白是为了让链看得清楚;理解分子行为时,需要把那些暂时没有画出的对象重新放回去。
水分子的电荷分布并不均匀。氧附近与氢附近具有不同的电荷分布,使水能与带电或极性的基团产生有方向的相互作用。羟基、羧基和酰胺等基团与水接触时,会形成不同的局部环境;某些非极性部分与水相邻时,周围水的组织也会改变。这些接触共同影响一种结构出现的概率。我们把较容易与水建立有利接触的部分称为亲水,把另一类接触倾向称为疏水。它们是讨论分子行为的有用语言,具体结果仍要看接触面积、温度以及其他分子的参与。
可以把一个接触想成一次座位调整:链上的两处表面靠到一起时,原来在它们附近的水需要换位置,链本身也失去或获得一些可摆出的姿势。只看两处表面之间新增加的一项吸引,会漏掉周围水和链的变化。这个比喻的重点是“比较调整前后的整个局面”。以后写自由能时,我们会把能量和状态数量放进同一个量里;目前先记住,分子间相互作用常常意味着多个接触同时被替换,不能只数新形成的那一条线。
氢键也是如此。蛋白质内部的氢键可以参与稳定局部结构,水与蛋白质之间也可以形成氢键。链折叠时,一些原有的水接触被替换,一些新接触出现;是否更有利,要把这些变化合起来考虑。把“多了几个氢键”直接翻译成“样品必然更稳定”,会跳过接触发生在哪个环境中的问题。研究者因此会同时记录结构、溶剂、温度与观测方法,让有关稳定性的比较对应到同一组条件。
蛋白质、糖链与核酸在这个问题上各有自己的化学细节。蛋白质侧链种类丰富,表面会出现性质不同的区域;许多糖单元带有多个羟基,但糖链能否溶解,还与链间组织和有序结构有关;核酸骨架在通常的近中性水溶液中带负电,周围离子会参与它的电荷环境。因此,“有亲水基团”只是分析的起点。就像知道一块布的纤维种类之后,还要知道它怎样织成,认识单个基团以后,也要看它们在整条链和多链结构中怎样排列。
1972年,Christian Anfinsen在诺贝尔演讲中讨论蛋白质序列与天然结构的关系时,明确列出了溶剂、pH、离子强度、温度以及其他组分等环境条件。把这段话与核糖核酸酶的研究放在一起读,可以看见一个重要的实验思想:序列信息要在具体环境中表现为结构。今天建立蛋白质数据库时,“分子序列相同”与“实验条件相同”需要分别检查,二者共同决定一次比较的含义。[1]
这对AI输入有直接影响。两条记录的序列相同,pH或温度却不同;删掉条件列以后,模型收到同样的输入,却要预测不同的观测结果。它往往会把不同条件下的表现平均起来,于是给出的值可能对哪一次实验都不贴切。把条件补回来,相当于告诉模型“这次观察发生在曲线的哪个位置”。下面先固定分子的酸性、碱性位点数,只改变pH,观察带电比例怎样变化。每次只改一个条件,组成与环境各自起了什么作用就更容易看清。
02热运动与相互作用怎样放在一起比较
一条链在水里不断换姿势,来自它与环境持续交换能量的过程。温度升高时,许多微观运动的统计分布会变化;与此同时,水的性质、相互作用以及化学平衡也可能改变。因此,加热既会影响运动,又可能改变哪些状态更容易出现。为了判断某个接触的能量在这个环境里算大还是算小,我们需要一把适合分子尺度的尺子。常用的尺子是玻尔兹曼常数与绝对温度的乘积,写成kBT。
T使用开尔文K,而不是摄氏度。换算时,把摄氏温度加上273.15;接近室温的25℃约为298K。玻尔兹曼常数kB的值是1.380649×10⁻²³J/K,乘上温度后,K约掉,留下焦耳J这个能量单位。代入298K,得到约4.11×10−21J。一个皮牛乘一个纳米等于10−21J,因此也可以写成4.11pN·nm。这种写法尤其适合以后讨论“用多少力拉开多长距离”。常数值采用NIST公布的SI定义值。[2]
例如,一个接触对应的能量差若约为8pN·nm,在298K下就是约1.95个kBT。把两者相除后没有单位,便能比较这项能量与环境中的热能尺度。这里的kBT是一把统计尺度尺,并不是说每个分子在每一时刻都恰好携带这份能量。不同运动方式具有各自的能量分布;一个接触是否容易打开,还与通往另一状态需要跨过的能垒和观察时间有关。第八节讨论运动时,会把“更常出现”与“多久才能到达”进一步区分。
带电部分之间的作用也要在水中理解。符号相同的电荷通常相互排斥,符号相反的电荷通常相互吸引;水的极化会改变作用的强度,周围可移动的离子又会重新分布。可以想象在一张长链图的每个负号附近,周围溶液的正、负离子并不是完全均匀的。它们的重新分布会减弱较远处感受到的电场,这种效果称为屏蔽。加入盐提供了更多可移动的离子,但盐还可能有其他与化学种类有关的作用,需要随研究对象具体分析。
“链上的电荷有多少”与“这些电荷隔着溶液怎样相互作用”因此是两个问题。前者与哪些基团得到或失去质子有关,后者还与周围离子的分布和溶液条件有关。两条带负电的链即使具有相同净电荷,在不同盐条件下也可能有不同的相互接近方式。只把盐浓度作为一个无关的实验备注,便可能把本应分开的响应混在一起。后面的凝胶章节还会讨论链内、链间和凝胶内外离子分布如何共同改变含水量。
1951年,Aharon Katchalsky发表关于水中聚电解质与机械化学系统的研究,将电离、链形态、溶液黏度以及离子条件联系起来,并讨论可把化学条件变化转为机械运动的体系。这里的聚电解质,就是带有可电离或带电基团的高分子。对本教程而言,这段历史把几件熟悉的实验操作接在了一起:改变溶液条件,改变电荷状态与相互作用,再观察链或材料的响应。研究生物凝胶时,我们仍然沿着这些可测量的环节追问。[3]
同一种环境变化也不一定使所有链朝相同方向响应。一个主要带负电的多糖,与一条同时含较多正、负电基团的多肽,内部可形成的接触就不同;电荷在链上均匀分布还是聚集成片段,也会影响局部结构。于是《生命中的三类长链:蛋白质、糖链与核酸》讨论的“组成、顺序、连接”仍然有用:环境变量与分子表示需要一起进入模型。本节先选一个容易核对的量——平均净电荷——计算酸碱度怎样参与预测,再把尺寸、相态和力学响应留给有相应观测量的后续章节。
03酸碱度怎样改变一条链的平均电荷
pH在日常生活里经常被当作“酸碱程度”的刻度。数值越小,通常意味着水溶液中与氢离子有关的有效活度越高。活度可以先理解为参与化学平衡时使用的有效浓度指标;它把离子彼此影响等因素纳入一个无量纲的量。在足够接近理想稀溶液的计算里,可以用氢离子浓度与标准浓度的比值近似活度。这样既能保留高中化学熟悉的浓度图像,也能知道这个简化对应什么条件。[4]
log10表示以10为底的对数,它回答“10的几次方等于这个数”。例如10−6的对数是−6,前面再加负号便得到pH=6。标准浓度c°取1mol/L,浓度c与它相除后,单位约掉,才能放进对数。在上述近似下,pH从6升到7,对应氢离子浓度从10−6降到10−7mol/L,减少到原来的十分之一。刻度只动了一个单位,背后的比例却变了十倍,这正是对数刻度压缩大范围变化的方式。
链上的某些基团可以得到或失去一个质子。以一个酸性位点为例,用HA表示保留质子的状态,用A−表示失去质子、带一个负电的状态。周围环境会影响这两种状态各占多少。用pKa描述这项酸碱平衡,在与它一致的近似中,带负电状态与中性状态的数量比,可以写成下面的形式。对一群相同位点,它对应不同状态所占的比例;对一个不断切换的位点,也可以用长时间统计来理解。
方括号在这里表示相应状态的浓度或统计数量所对应的比例。pH等于pKa时,右边是10的零次方,也就是1,两种状态一样多。pH比pKa高1时,比例为10,意味着每1份HA对应10份A−;全部11份中,负电状态占10/11,约90.9%。pH低1时,比例为0.1,负电状态占0.1/1.1,约9.1%。这三次计算已经足以画出电离曲线的大致样子:在pKa附近变化较快,远离以后逐渐靠近两端。
若用r表示上面的比值,那么负电状态占全部酸性位点的比例就是r/(1+r)。把分子、分母同时除以r,得到1/(1+1/r),再代入r=10pH−pKa,就得到下一式的第一行。碱性位点采用另一对状态:得到质子时带一个正电,失去质子时变为中性。我们关注它“仍带正电”的那部分,因此随pH升高而减少,式子中的指数次序也随之改变。把这两种方向分清,净电荷的正负号就有了明确来源。
α−与α+都是0到1之间的比例;下标提醒我们分别数负电状态和正电状态。pKa,A对应酸性位点,pKa,B对应碱性位点的共轭酸。程序把二者分别设为4.2和9.5,用来构造一个清楚的教学对象。这两个指定值给本例定义了一种明确的酸碱响应。真实分子中,附近电荷、溶剂暴露程度和局部结构都可能改变位点的酸碱行为;研究具体分子时,应使用与该对象和条件相对应的参数或实验数据。
现在考虑一条共有N个单元的链,其中NA个单元各有一个上述酸性位点,NB个各有一个上述碱性位点,其余单元在本模型中保持中性。先乘以相应带电比例,就能得到平均有多少个负电位点、多少个正电位点。每个正电位点贡献+e,每个负电位点贡献−e,e是基本电荷的大小,约为1.602×10⁻¹⁹C。把两类贡献相加,再按总单元数归一化,便得到本节AI要预测的量。
q上方的横线表示平均,ζ读作zeta,表示每个单元平均携带多少个基本电荷;fA=NA/N、fB=NB/N是两类位点所对应的单元比例。假设N=100、NA=30、NB=20,在pH=4.2时,酸性位点一半带负电,碱性位点几乎都带正电,所以平均净电荷约为(20−15)e=5e,每单元约为0.05e。平均值可以不是整数,因为我们平均的是许多可能电荷状态,而不是把一个基本电荷切成了若干份。
同一条链,沿着pH刻度移动
总单元数固定为100;pKa分别为4.2与9.5。曲线来自本节的独立位点平衡式。拖动pH只改变圆点位置,改变组成会改变整条曲线。
这个加法采用固定pKa、各位点独立电离的模型。它像分别计算一组开关被打开的概率,再把预期打开的个数相加,因此每个正、负电荷贡献都能追溯到具体位点。在实际分子里,一个位点带电后还会改变邻近位点的电场,链形和溶剂接触也可能随之变化。研究时,可以先把测得的电荷曲线与这个独立位点模型放在一起,看偏离集中在哪段pH,再加入对应的耦合或环境作用。这样,增加模型细节就有了观测依据,也能检验新机制是否解释了原来那段偏离。
04让AI同时读到对象与条件
把前面的计算整理成数据表,每行应当是一条链在某个pH下的一次观测。除了链或样品的组号,还需要总单元数、两类位点数量、pH,以及观测到的平均电荷。如果同一条链在33个pH条件下各测一次,就会留下33行;这些行共享组成,应作为一条响应曲线保存和划分。评价对新组成的预测时,要把同一组成的整条响应曲线留在同一侧。第二节讨论的分组原则,到这里变成了一个具体的实验安排。
我们将比较两种回归输入。第一种只有酸性、碱性单元的比例,它可以学习不同组成之间的平均差别,却无法针对同一组成给出随pH变化的曲线。第二种把pH也写进去,但不满足于只加一列数字。酸碱响应是弯曲的,在某些区间变化快,在另一些区间逐渐接近平台;一条随pH无限延伸的直线很难同时表达这些部分。于是,我们用一组在不同pH附近亮起来的钟形函数,作为描述局部环境的特征。
h代表pH,cj是第j个钟形函数的中心,s控制宽度。h等于中心时,平方差为0,exp(0)=1,这个特征达到峰值;当相差一个宽度s时,指数为−1/2,函数值约0.607;相差两个宽度时,值约0.135。指数为负、距离先平方,使中心两侧都逐渐降低。可以把每个函数想成一个只对附近区间较敏感的观察窗口:一个窗口负责酸性附近,另一个关注较高pH,多个窗口一起覆盖训练范围。
不过,只放入这些窗口,还没有说明不同组成对同一种环境如何响应。程序进一步把每个窗口分别乘以fA和fB,让酸性位点多、碱性位点多的对象产生不同特征值。例如,同一个pH下的窗口值为0.6,一条链酸性单元比例0.3,对应输入就是0.18;另一条链比例0.1,对应0.06。随后,回归模型为这些输入学习权重并相加。这样,“条件处在什么位置”和“链上有多少相应位点”在进入预测时已经相互联系。
1990年,Tomaso Poggio与Federico Girosi发表《Networks for Approximation and Learning》,讨论用网络近似未知函数以及正则化等问题。径向基函数网络与这条思路密切相关:先由局部响应构成特征,再学习怎样把它们合成输出。本节选用固定的高斯形状,直接学习最后的权重,因此每一步都容易画出来。沿着这样的例子理解网络,有助于看见学习方法如何承担一个具体任务——用有限观测重建随条件变化的函数。[5]
训练需要一个可以比较的目标。与《生命中的三类长链:蛋白质、糖链与核酸》的分类不同,本次输出是连续的电荷量,因此用预测值与观测值的差来计算误差。平方让正、负偏差都增加代价,也使较大的偏差受到更明显的影响。再加上一项权重平方惩罚,可以限制模型用过大的系数相互抵消来追逐噪声;这就是本例采用的岭回归。它仍然是从训练数据选择权重,只是选择时同时考虑拟合程度和系数大小。
M是训练行数,yk是第k行的带噪观测,帽子表示预测值,wj是特征权重,D为不含偏置的权重数。λ控制惩罚的强弱,程序固定取10−5,偏置不加入惩罚。所有输入特征与输出在本例中都是无量纲数;如果以后把温度、长度、能量等量混在一起,需要先规定单位,并根据训练侧数据安排合适的尺度。否则,同样大小的数值惩罚可能对不同列产生不同含义。
本例通过解一个线性方程组直接求出权重。可以先看最简单的一项预测wx:平方误差对w求导,得到2x(wx−y);对所有训练行求平均并加上权重惩罚,令导数为0,便能把含w的项放在左边、已知的x与y放在右边。多项特征时,每个权重都有一个这样的条件,合起来就是一组方程。代码中的X.T@X收集特征之间的乘积和,X.T@y收集特征与观测的乘积和,solve求出同时满足这些条件的权重。它与逐步减小同一个损失的训练方法,在这里追求的是相同的最小值。
这个模型学到的是训练覆盖范围里的响应。固定的钟形函数远离中心以后会逐渐变小,范围外的预测便受剩下的组成项和有限的窗口尾部支配。真实酸碱平衡却有自己的饱和趋势,二者未必一致。我们因此把“新的组成”与“新的pH范围”分成两个测试任务:先检查在已覆盖环境中换一种组成,再检查组成和环境都变新时的表现。这种分开评价的办法,比一个把全部条件混合的平均误差更容易帮助我们安排下一次实验。
05完整计算:预测曲线,也检查曲线的边界
下面的程序生成320种不同组成,每种包含50至200个单元。两类位点的比例经过查重,避免只把同一种比例放大总数量以后当成新组成。每种组成在pH=3至11之间取33个等间隔条件,按独立位点模型计算平均电荷,再加上标准差0.01的高斯噪声,形成模拟观测。噪声的单位也是每单元基本电荷数;在N=100的链上,0.01对应平均净电荷约1e的观测波动尺度。这些数据均由明确定义的模型产生。
训练使用240种组成、pH=4.5至9.5之间的条件,共5040行。剩余80种组成完整留出:其中1680行位于同一pH范围,用来检验新组成;另外960行位于两端的未见区间,用来检验新组成与新条件。训练组成在范围外的那些行保存为未使用记录,既不参与拟合,也不混入这两项测试。组号由程序单独管理,模型输入里没有组号这一列。
为了让结果能逐项解释,两种学习模型都用同一个岭回归方法。组成模型有偏置及两项比例特征;条件模型额外加入11个pH窗口与两类比例相乘后的22项特征。窗口中心均匀放在4.5至9.5之间,宽度固定为0.65,惩罚系数也事先固定。整个训练过程不根据测试结果挑窗口、改宽度或选择样品。作为第三个参照,程序保留生成数据时使用的平衡公式,检查学得曲线与已知响应之间的距离。
我们会同时报告两种误差。“对平衡值的平均绝对误差”把每次预测与无噪声的模型值比较,反映回归是否恢复了指定的响应函数;“对带噪观测的均方根误差”则比较实际用于模拟测量的数值。即使直接使用平衡公式,后一项也会留下噪声,因为观测里另加了随机扰动。分清这两种对象,可以避免把模拟中能访问的真值,与真实实验里通常只能获得的测量结果混在一起。
"""分子组成与环境条件:学习独立位点模型的净电荷响应。

运行:python example.py;依赖:numpy、matplotlib。
教学数据由指定的酸碱平衡模型生成,加上已知尺度的随机噪声。
比较组成模型、条件RBF回归和生成模型本身;温度固定为298 K。
"""
from pathlib import Path
from fractions import Fraction
import json
import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

OUT = Path('environment_outputs')
OUT.mkdir(exist_ok=True)
SEED = 20261024
PKA_ACID, PKA_BASE = 4.2, 9.5
CENTERS = np.linspace(4.5, 9.5, 11)
WIDTH, PENALTY, NOISE = .65, 1e-5, .01
GREEN, GOLD, BLUE = '#14786b', '#bc7041', '#406e9c'
plt.rcParams.update({
    'font.family': 'sans-serif', 'font.sans-serif': ['Microsoft YaHei', 'DejaVu Sans'],
    'font.size': 14, 'axes.titlesize': 13, 'axes.spines.top': False,
    'axes.spines.right': False, 'axes.edgecolor': '#a7b9b2',
    'axes.labelcolor': '#24423c', 'text.color': '#24423c',
    'xtick.color': '#536c63', 'ytick.color': '#536c63',
    'figure.facecolor': '#fcfaf5', 'axes.facecolor': '#fcfaf5',
    'svg.fonttype': 'path', 'svg.hashsalt': str(SEED),
})


def ionization(ph):
    """酸性位点带-1的比例,碱性位点带+1的比例。"""
    ph = np.asarray(ph)
    acid = 1 / (1 + 10.0 ** (PKA_ACID - ph))
    base = 1 / (1 + 10.0 ** (ph - PKA_BASE))
    return acid, base


def charge(f_acid, f_base, ph):
    a, b = ionization(ph)
    return f_base * b - f_acid * a  # q/(N e),无量纲


def design(f_acid, f_base, ph, conditional):
    basic = np.column_stack([np.ones(len(ph)), f_acid, f_base])
    if not conditional:
        return basic
    # 固定中心和宽度。每个钟形函数看一个pH邻域。
    phi = np.exp(-.5 * ((ph[:, None] - CENTERS) / WIDTH) ** 2)
    # 乘上组成比例:相同环境对不同组成可以产生不同响应。
    return np.column_stack([basic, f_acid[:, None] * phi, f_base[:, None] * phi])


def ridge(x, y):
    # 最小化平均平方误差 + PENALTY * 权重平方和;不惩罚偏置。
    diagonal = np.ones(x.shape[1])
    diagonal[0] = 0
    return np.linalg.solve(x.T @ x / len(y) + PENALTY * np.diag(diagonal),
                           x.T @ y / len(y))


def main():
    rng = np.random.default_rng(SEED)
    compositions, seen = [], set()
    while len(compositions) < 320:
        n = int(rng.integers(50, 201))
        a, b, neutral = rng.multinomial(n, rng.dirichlet([2, 2, 4]))
        key = (Fraction(int(a), n), Fraction(int(b), n))
        if key not in seen and a > 0 and b > 0:
            seen.add(key)
            compositions.append([n, int(a), int(b)])
    compositions = np.array(compositions)
    grid = np.linspace(3, 11, 33)
    group = np.repeat(np.arange(320), len(grid))
    ph = np.tile(grid, 320)
    counts = compositions[group]
    fa, fb = counts[:, 1] / counts[:, 0], counts[:, 2] / counts[:, 0]
    exact = charge(fa, fb, ph)
    measured = exact + rng.normal(0, NOISE, len(exact))
    heldout = rng.choice(320, 80, replace=False)
    new_group = np.isin(group, heldout)
    in_range = (ph >= 4.5) & (ph <= 9.5)
    train = ~new_group & in_range
    interpolation, extrapolation = new_group & in_range, new_group & ~in_range
    weights, predictions = {}, {}
    for name, conditional in [('composition', False), ('conditional', True)]:
        x = design(fa, fb, ph, conditional)
        weights[name] = ridge(x[train], measured[train])
        predictions[name] = x @ weights[name]
    predictions['equilibrium'] = exact.copy()
    metrics = {}
    for name, mask in [('new_composition', interpolation), ('new_composition_new_ph', extrapolation)]:
        metrics[name] = {key: {
            'mae_to_exact': float(np.mean(np.abs(value[mask] - exact[mask]))),
            'rmse_to_observation': float(np.sqrt(np.mean((value[mask] - measured[mask]) ** 2))),
        } for key, value in predictions.items()}
    # 两端电离极限、总电荷范围及独立组划分。
    check_fa, check_fb = .3, .2
    limit_error = max(abs(charge(check_fa, check_fb, -20) - check_fb),
                      abs(charge(check_fa, check_fb, 30) + check_fa))
    checks = {
        'train_test_group_overlap': len(set(group[train]) & set(group[new_group])),
        'unique_composition_groups': len(seen),
        'low_high_ph_limit_error': float(limit_error),
        'charge_bounds': bool(np.all(exact >= -fa) and np.all(exact <= fb)),
        'acid_fraction_at_pka': float(ionization(PKA_ACID)[0]),
        'base_fraction_at_pka': float(ionization(PKA_BASE)[1]),
    }
    assert checks['train_test_group_overlap'] == 0 and len(seen) == 320
    assert limit_error < 1e-10 and checks['charge_bounds']
    assert checks['acid_fraction_at_pka'] == checks['base_fraction_at_pka'] == .5
    # 选用测试组之一展示完整响应曲线,不参与调参。
    probe_group = int(heldout[0])
    probe = group == probe_group
    residual_ph = []
    for p in grid:
        mask = new_group & (ph == p)
        residual_ph.append([float(p), *[float(np.mean(np.abs(predictions[key][mask] - exact[mask])))
                                      for key in ['composition', 'conditional', 'equilibrium']]])
    result = {
        'seed': SEED, 'source': 'specified_independent_site_model_with_gaussian_noise',
        'pka_acid': PKA_ACID, 'pka_base': PKA_BASE, 'temperature_K': 298,
        'noise_sd_charge_per_unit': NOISE, 'n_groups': 320,
        'n_train': int(train.sum()), 'n_test_in': int(interpolation.sum()),
        'n_test_out': int(extrapolation.sum()),
        'centers': CENTERS.tolist(), 'basis_width': WIDTH, 'ridge_penalty': PENALTY,
        'weights': {k:v.tolist() for k,v in weights.items()},
        'metrics': metrics, 'checks': checks,
        'probe': {'group': probe_group, 'counts_N_acid_base': compositions[probe_group].tolist(),
                  'ph': ph[probe].tolist(), 'exact': exact[probe].tolist(),
                  'observation': measured[probe].tolist(),
                  'prediction': {k:v[probe].tolist() for k,v in predictions.items()}},
        'mae_by_ph': residual_ph,
    }
    records = []
    for i in range(len(ph)):
        split = 'train' if train[i] else 'test_in' if interpolation[i] else 'test_out' if extrapolation[i] else 'unused'
        records.append({'group':int(group[i]), 'N':int(counts[i,0]),
            'n_acid':int(counts[i,1]), 'n_base':int(counts[i,2]), 'pH':float(ph[i]),
            'exact_charge_per_unit':float(exact[i]), 'noisy_observation':float(measured[i]), 'split':split})
    (OUT/'samples.json').write_text(json.dumps(records,ensure_ascii=False,indent=2),encoding='utf-8')
    (OUT/'results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2),encoding='utf-8')

    def shade(ax):
        ax.axvspan(3, 4.5, color='#e9dac7', alpha=.55)
        ax.axvspan(9.5, 11, color='#e9dac7', alpha=.55)
        ax.set_xlim(3, 11)

    def fractions(ax):
        dense = np.linspace(3, 11, 300)
        a, b = ionization(dense)
        ax.plot(dense, a, color=GREEN, lw=2, label='酸性位点:负电比例')
        ax.plot(dense, b, color=GOLD, lw=2, label='碱性位点:正电比例')
        ax.scatter([PKA_ACID, PKA_BASE], [.5, .5], c=[GREEN, GOLD], s=55, zorder=3)
        ax.axhline(.5, color='#bac8bd', lw=1, ls=':')
        ax.set(xlabel='pH', ylabel='带相应电荷的位点比例', ylim=(-.03,1.05),
               title='A  两类位点,响应方向不同')
        ax.legend(frameon=False, fontsize=10, loc='lower right')

    def response(ax):
        shade(ax)
        ax.scatter(ph[probe], measured[probe], c='#9caea3', s=18, label='带噪观测')
        for key,color,ls,name in [('equilibrium',GREEN,'-','平衡参照'),
            ('conditional',BLUE,'--','条件回归'),('composition',GOLD,':','组成回归')]:
            ax.plot(ph[probe],predictions[key][probe],color=color,ls=ls,lw=2,label=name)
        ax.set(xlabel='pH(米色为训练范围外)',ylabel='平均电荷 q/(N e)',
               title='B  一个完整留出组成的响应曲线')
        ax.legend(frameon=False,fontsize=10,ncol=2)

    def surface(ax):
        pp, ff = np.meshgrid(np.linspace(3,11,150),np.linspace(0,.65,100))
        zz = charge(ff,.2,pp)
        im = ax.pcolormesh(pp,ff,zz,cmap='BrBG',vmin=-.65,vmax=.65,shading='auto',rasterized=True)
        ax.contour(pp,ff,zz,levels=[0],colors=['#333f3a'],linewidths=[1.1])
        ax.set(xlabel='pH',ylabel='酸性位点比例',title='C  组成与环境共同决定响应')
        cb=ax.figure.colorbar(im,ax=ax,pad=.025);cb.set_label('q/(N e)')

    def comparison(ax):
        # 图上抽稀便于看清,误差使用全部测试例子。
        take=np.flatnonzero(interpolation)[::6]
        ax.scatter(exact[take],predictions['composition'][take],color=GOLD,s=15,alpha=.55,label='只看组成')
        ax.scatter(exact[take],predictions['conditional'][take],color=BLUE,s=12,alpha=.55,label='加入pH')
        lo,hi=exact[interpolation].min(),exact[interpolation].max()
        ax.plot([lo,hi],[lo,hi],color=GREEN,lw=1.5)
        ax.set(xlabel='平衡参照 q/(N e)',ylabel='模型预测 q/(N e)',title='D  新组成、已见过的pH范围')
        ax.legend(frameon=False,fontsize=10)

    def errors(ax):
        names=['composition','conditional','equilibrium']
        pos=np.arange(3)
        for split,offset,color,label in [('new_composition',-.18,GREEN,'pH范围内'),
                 ('new_composition_new_ph',.18,GOLD,'pH范围外')]:
            values=[metrics[split][k]['mae_to_exact'] for k in names]
            bars=ax.bar(pos+offset,values,width=.34,color=color,label=label)
            for bar,value in zip(bars,values):
                ax.text(bar.get_x()+bar.get_width()/2,value+.002,f'{value:.3f}',ha='center',fontsize=10)
        ax.set(xticks=pos,xticklabels=['组成回归','条件回归','平衡参照'],
               ylabel='对无噪平衡值的MAE',title='E  留出新条件,重新检查误差')
        ax.set_ylim(0,max(metrics['new_composition_new_ph'][k]['mae_to_exact'] for k in names)*1.3)
        ax.legend(frameon=False,fontsize=10)

    def error_curve(ax):
        shade(ax)
        a=np.array(residual_ph)
        for col,color,label in [(1,GOLD,'组成回归'),(2,BLUE,'条件回归')]:
            ax.plot(a[:,0],a[:,col],color=color,lw=2,label=label)
        ax.set(xlabel='pH(米色为训练范围外)',ylabel='新组成上的平均绝对误差',
               title='F  看误差在哪些条件下积累')
        ax.legend(frameon=False,fontsize=10)

    panels=[('fractions',fractions),('response',response),('surface',surface),
            ('comparison',comparison),('errors',errors),('error_curve',error_curve)]
    for name,draw in panels:
        fig,ax=plt.subplots(figsize=(6.6,4.6),layout='constrained');draw(ax)
        fig.savefig(OUT/(name+'.svg'),metadata={'Date':None});plt.close(fig)
    fig,axes=plt.subplots(3,2,figsize=(14,14),layout='constrained')
    for (_,draw),ax in zip(panels,axes.ravel()):draw(ax)
    fig.savefig(OUT/'environment_diagnostics.svg',metadata={'Date':None})
    fig.savefig(OUT/'environment_diagnostics.png',dpi=180);plt.close(fig)
    print(f'训练例子 {train.sum()};范围内测试 {interpolation.sum()};范围外测试 {extrapolation.sum()}')
    for split,rows in metrics.items():
        for key,value in rows.items():
            print(f'{split} / {key}: MAE(平衡值)={value["mae_to_exact"]:.5f}, RMSE(带噪观测)={value["rmse_to_observation"]:.5f}')
    print('训练/测试共有组成组数:',checks['train_test_group_overlap'])
    print('结果与完整样本已保存至 environment_outputs')


if __name__=='__main__':
    main()
本次实际运行输出
训练例子 5040;范围内测试 1680;范围外测试 960
new_composition / composition: MAE(平衡值)=0.03157, RMSE(带噪观测)=0.05122
new_composition / conditional: MAE(平衡值)=0.00209, RMSE(带噪观测)=0.01016
new_composition / equilibrium: MAE(平衡值)=0.00000, RMSE(带噪观测)=0.00965
new_composition_new_ph / composition: MAE(平衡值)=0.20052, RMSE(带噪观测)=0.23599
new_composition_new_ph / conditional: MAE(平衡值)=0.14326, RMSE(带噪观测)=0.16956
new_composition_new_ph / equilibrium: MAE(平衡值)=0.00000, RMSE(带噪观测)=0.01038
训练/测试共有组成组数: 0
结果与完整样本已保存至 environment_outputs
一次运行 · 六幅结果图
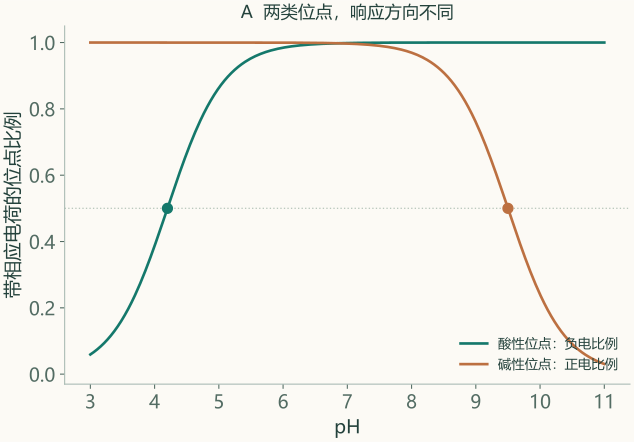
A · 在各自的pKa处,两类位点各有一半处于指定带电状态。
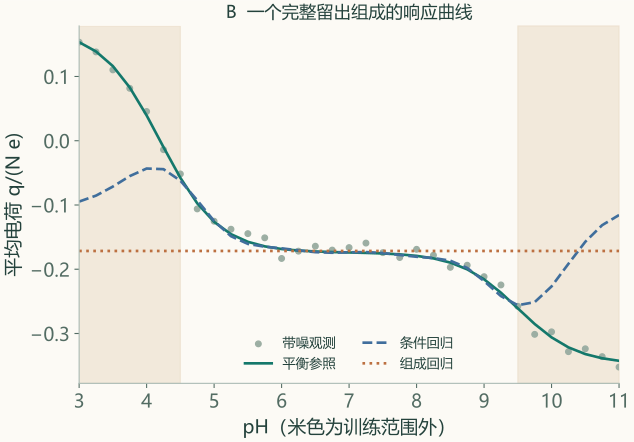
B · 留出组成的完整曲线;米色区间的pH未进入训练。
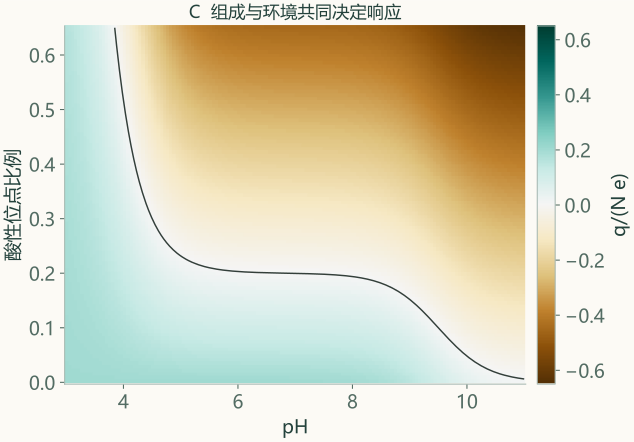
C · 固定碱性位点比例0.2,比较酸性比例和环境;黑线表示平均净电荷为零。
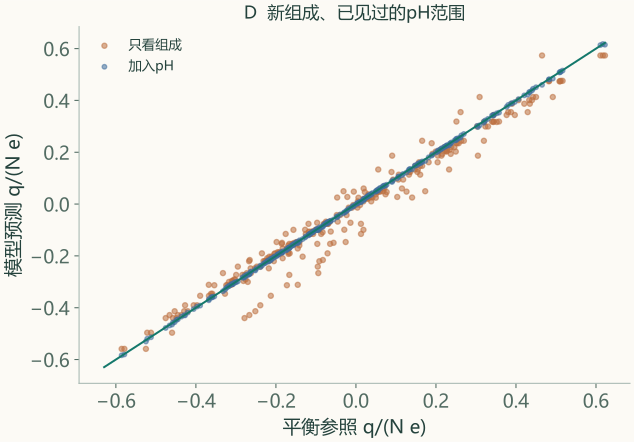
D · 范围内的新组成预测;图上抽稀显示,误差按全部测试例子计算。
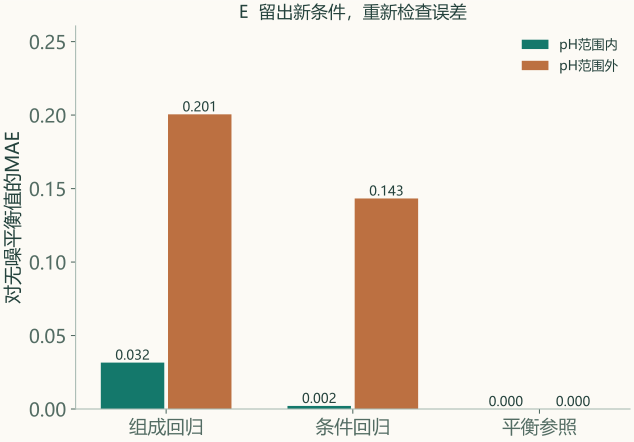
E · 按新组成与新条件分别报告误差,平衡参照对应本次生成规则。
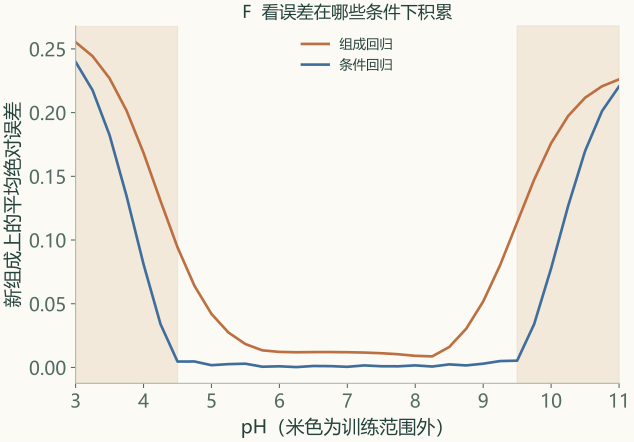
F · 按pH查看平均绝对误差,观察范围外的偏离。
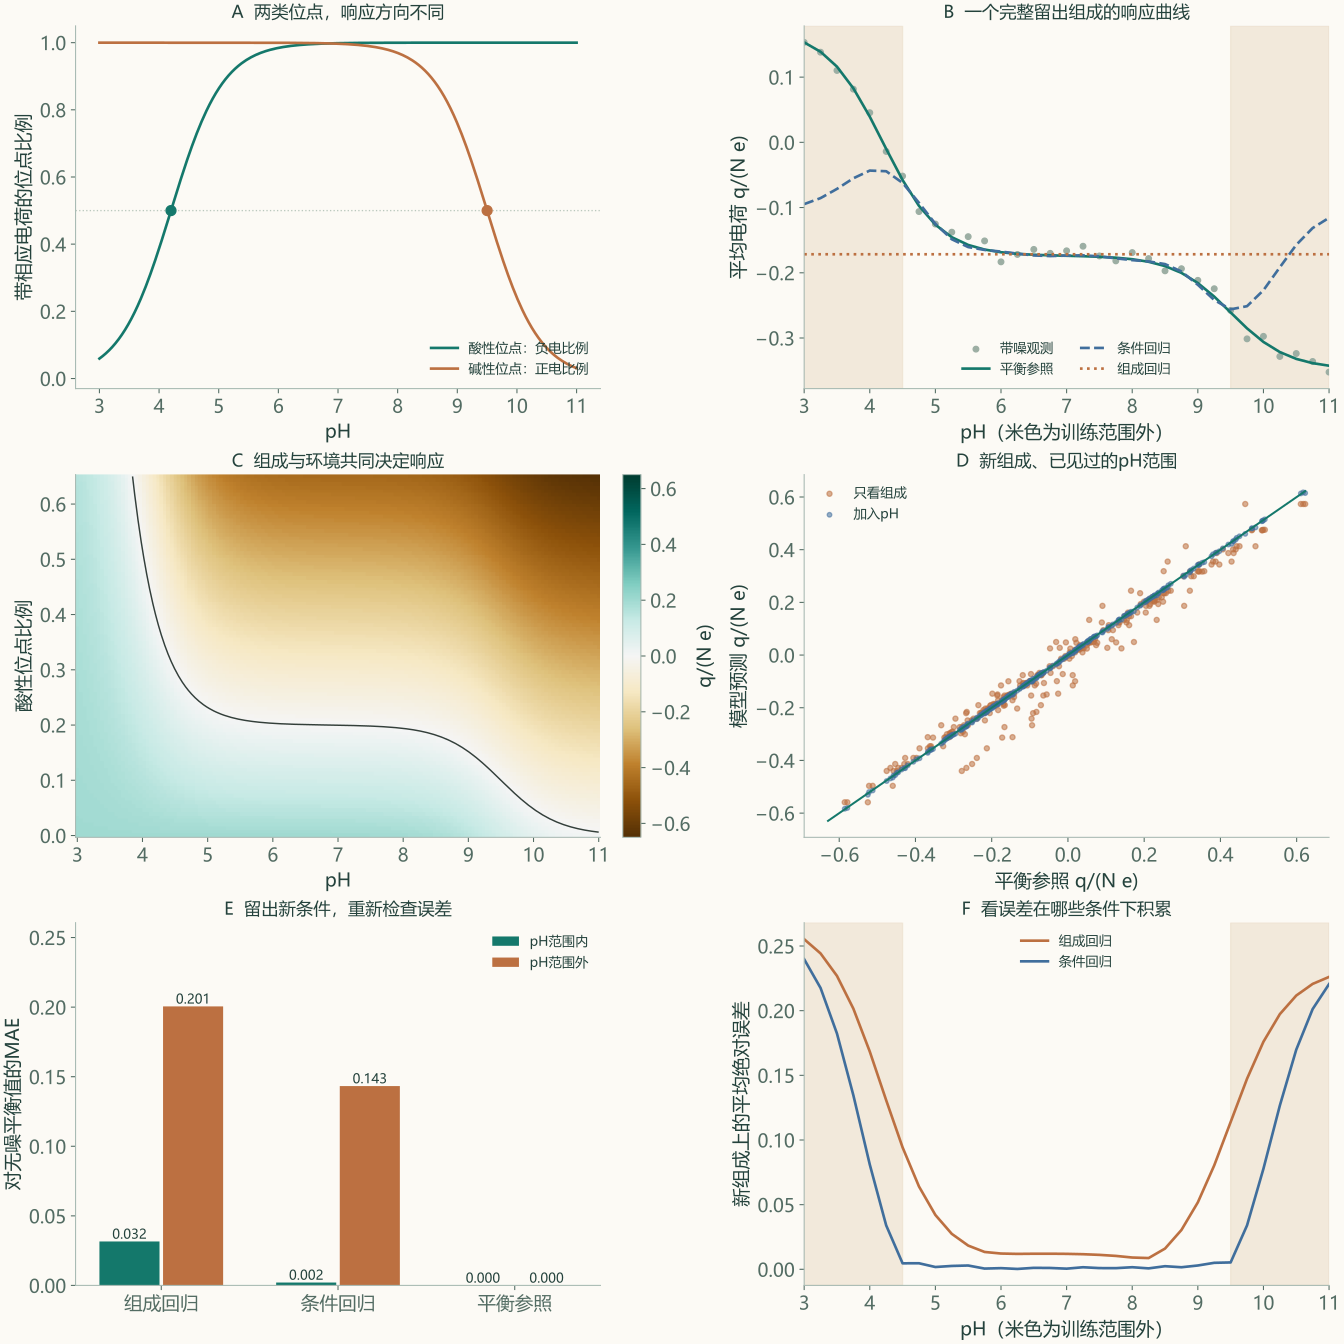
先从图A和图B读起。图A画出了酸性位点的负电比例与碱性位点的正电比例,两个pKa位置都对应各自的50%。图B选取一个完整留出的组成,展示它的整条响应曲线:只看组成的模型给出一条不随pH改变的水平线;条件模型在训练范围内跟随平衡曲线弯曲,来到米色标出的范围外以后则出现偏离。灰色点是同一次运行生成的带噪观测,绿色曲线是本次数据定义中的无噪平衡值。
图C把酸性位点比例与pH放在同一张图里,固定碱性位点比例为0.2。颜色表示每单元平均电荷,黑色线标出净电荷为0的位置。沿横向移动,相当于改变同一种组成的环境;沿纵向移动,相当于改变酸性位点的数量比例。即使处在净电荷为0的位置,链上也可能同时存在正、负电位点,只是平均总和相互抵消。局部电荷分布和空间接触仍然可以影响链的行为,因此净电荷与“所有位置都不带电”要分开理解。
在已覆盖的pH范围内,新组成上的平均绝对误差由组成模型的0.0316降为条件模型的0.0021;到了两端的未见区间,条件模型误差为0.1433。这些数值的单位都是每单元基本电荷数。若以100个单元为例,把0.01乘以100,可理解为平均净电荷约1e的差别。图D用散点显示范围内的预测,图E把两个测试任务并排放置,图F则进一步指出误差集中在哪些pH条件下。
平衡参照对无噪值的误差为0,是因为它就是本次生成响应的规则;对带噪观测的均方根误差约为0.01,与设定的噪声尺度一致。这个参照让学习实验有一个清楚的落点:当我们已经知道一个适用的解析关系,直接计算能提供稳定的预测;学习模型帮助我们检查有限观测和输入表示能恢复多少关系。将来遇到更复杂的真实体系,可以把解析关系保留为基线,让新增机制或学习模型去解释它与实测响应之间的系统差别。
想把本例用于一条真实多肽,下一步应先明确有哪些可电离位点、采用哪些参数、测量的究竟是哪一种电荷相关信号,再把温度、盐与样品条件一同记录。电泳迁移率、表面电势等信号,则应先通过相应的观测模型与电荷联系起来。我们在第十七节会从实验信号出发,讨论观测量、结构量与模型参数之间怎样连接。这样,AI参与研究时,输入和输出都能落到明确的测量对象上。
可以保留当前样本,只把所有pH输入都替换成同一个值,观察条件模型失去哪些变化;也可以把训练范围扩大到3至11,重新拟合后比较原来两端区间的误差。第二项改动增加了新的条件观测,因此应把评价任务改成“新组成、同一条件范围”。若要继续检验更远的条件,就要另留一段pH区间。每次修改都先说明测试对象发生了什么变化,再看误差曲线。
到这里,描述一个生物大分子时,我们已经会同时记录它的组成与连接,以及它所在的环境。下一步把注意力转回空间:同一条链在这些条件下蜷起来以后占多大地方,哪些平均量能够稳定描述它?第五节将从熟悉的坐标和距离出发,计算末端距与回转半径,并比较AI从链长学习尺寸时,怎样面对更长的链。
资料与延伸阅读
- Anfinsen,1972,Studies on the Principles that Govern the Folding of Protein Chains,诺贝尔演讲。
- NIST,Boltzmann constant。玻尔兹曼常数的SI定义值。
- Katchalsky,1951,Solutions of Polyelectrolytes and Mechanochemical Systems,Journal of Polymer Science 7:393–412。
- IUPAC Gold Book,pH,活度定义及测量约定。
- Poggio与Girosi,1990,Networks for Approximation and Learning,Proceedings of the IEEE 78:1481–1497;相关原始报告Networks and the Best Approximation Property。
科学史图为本节绘制的概念示意;电荷曲线、模型比较与误差图由页面中的Python程序生成。