从分子快照到统计与学习
高分子构象统计:采样、分布与独立样本
用手机拍一团松散的耳机线,你能从这一张照片判断它通常占多大地方吗?把线提起来,抖散,再放回桌面,两个接头之间的距离就变了。分子链也有许多可能的姿态,周围分子的热运动会不断扰动它。研究一条生物大分子,除了知道它由什么连接而成,还需要知道它会怎样变化,以及哪些变化经常发生。
这个问题直接关系到研究中的几个决定:模拟应该保存多少帧,平均尺寸后面应当写多大的误差条,AI的训练集和测试集又该怎样分开。本节从“拍照”开始,把分布、标准差和独立样本逐一讲清楚,再用一个可以完整运行的例子检查它们。读完以后,面对一张装着许多分子数据的表,你会多问一步:这些行到底来自多少份新信息?
01一张照片告诉我们什么
先把镜头拉近。一个构象,是分子链在某一时刻的空间安排:每个原子或模型中每颗珠子在哪里,整条链怎样弯曲,哪些部分靠得近。给同一条链换一种姿态,化学连接可以完全不变,构象却已经改变。《高分子结构基础:连接、链长与尺度》用“散珠与项链”解释连接的重要性;现在要在项链保持连接的前提下,研究它有多少种摆法。对于蛋白质和核酸,序列告诉我们单元的排列,构象描述这些单元在空间里的安排,两者提供的信息互相补充。
在固定温度、溶剂和链长等条件下,某些姿态出现得多,某些出现得少。把所有允许的状态及其出现的概率放在一起考虑,就得到统计物理中的系综。为了在计算机上研究它,我们抽取许多构象组成样本。可以把系综想成一副张数极多、各张出现机会并不一定相同的牌,模拟得到的构象是从这副牌中抽出的记录。抽到哪几张有随机性,牌的组成和抽取规则决定了长期能够看到的规律。
这一层区分在生物大分子研究中很实用。同一条蛋白质序列在固定溶液条件下出现许多构象,讨论的是构象分布;把不同序列、不同链长的蛋白质混在一起,得到的分布还包含对象之间的差异。如果两种变化混在一张直方图里,就很难判断图变宽究竟因为分子更柔软,还是因为样品本来就有更多种类。建立数据表时记录序列、链长、温度和溶液条件,正是为了能在分析时把这些问题分别提出。
1827年,植物学家Robert Brown观察植物花粉内部微小颗粒在水中的运动。他后来也检查了其他材料,发现这种运动并不限于有生命的对象。1828年发表的记录让一个原本很容易被解释成“生命活动”的现象,变成了需要更一般物理解释的问题。显微镜下可见的是微粒,它们的无规则运动给研究者留下了连续观察的线索。我们今天从多次观测寻找统计规律,与这种把现象记录下来、再比较不同对象的做法相通。[1]
从植物材料出发,比较其他材料,让“运动来自什么”成为可以逐项检查的问题。

下面用一个容易计算的珠链模型练习观察。每条链由32段组成,每段长1 nm,相邻两段可以自由改变方向。每次抽样都重新生成所有方向,得到一幅独立构象。这个模型暂时允许链穿过自己,也省略了真实生物大分子的侧基和特定相互作用;它适合把“同样的连接可以对应许多尺寸”这件事单独拿出来看。图中显示三维构象在平面上的投影,端到端距离则用完整三维坐标计算,所以投影里看着很短的一段,在空间中仍然保持1 nm。
翻看同一链模型的不同构象
如果只保存其中一幅,首尾距离可能碰巧很小,也可能比较大。保存2000幅以后,就可以把距离按区间计数:落在4到4.5 nm之间的有多少幅,落在4.5到5 nm之间的又有多少幅。把这些计数排成柱子,就得到直方图。它把许多看起来杂乱的姿态压缩成一个可以回答问题的对象:多数构象占据什么尺度,特别伸展的状态常不常见,换一种条件后分布是整体移动,还是只改变了尾部。
一份分布也不等于一条运动轨迹。直方图告诉你各个区间出现了多少次,已经丢掉先后顺序;轨迹保留了顺序,因而能回答“从一个状态走到另一个状态需要多久”。把同一组照片重新排序,直方图不变,看到的运动过程却会改变。后面研究分子松弛、折叠和采样时,需要同时保留这两种视角。
02平均数之外,还要留下变化的幅度
平均数很适合给一组数据找一个中心。测到三次距离分别为3、4、5 nm,总和12 nm,除以3次,得到4 nm。这里“除以3”表示把总量平均分到每次观测上,因此单位仍然是nm。用字母X表示要统计的量,用下标j给记录编号,X₁就是第一条记录,X₂就是第二条。字母上方的一横表示这批记录的平均值,数学中常称它为样本均值。
式子里的Σ是求和符号,把它展开,就是从j=1开始逐个相加,一直加到j=n,再除以记录总数n。例如三幅照片量得4、5、6 nm,平均值就是(4+5+6)/3=5 nm;记录变成三千幅,计算规则完全相同。X用来代表选中的观测量,它可以是链的尺寸、能量、荧光强度,也可以是预测误差。选好这列数以后,求和与除法才有清楚的对象:4 nm能与6 nm相加,一列长度和一列能量却不能混在同一次平均里。
现在把记录换成1、4、7 nm。平均数仍是4 nm,但第一组数据离中心较近,第二组明显散得更开。如果只在论文表格中写“平均4 nm”,读者看不出两组分布的差别。柔软分子在一段时间内的尺寸波动,与尺寸较稳定的分子,可能因此被写成同一个结果。我们还需要一种量,表示各次观测离中心有多远。
先试着把每个数减去平均数。第一组得到−1、0、1 nm;第二组得到−3、0、3 nm。直接相加,两组都得到0,因为正负偏离抵消了。为了留下偏离的大小,可以先平方,再平均。第一组的平方偏离平均为2/3 nm²,第二组为6 nm²。方差便是这样得到的。最后开平方,第一组约为0.816 nm,第二组约为2.449 nm,单位回到原来的长度,这就是标准差。第二组的标准差是第一组的3倍,和我们看到的伸展幅度一致。
上面的计算把三种数各出现一次的情形当成完整分布,用3作分母。如果这三个数只是从更大总体中独立抽出的少量记录,而我们要估计总体的方差,常用的样本方差会改用n−1作分母。为什么少减了一个?因为中心也由这批数据估计,偏离值被迫满足总和为0。前两个偏离一旦确定,第三个就跟着确定了。对独立、同分布且方差有限的抽样,这种约束使直接除以n的结果平均偏小;除以n−1能校正方差估计的这一偏差。代码中的ddof=1就是指定这个分母。[4]
这里μ读作“缪”,表示总体均值;σ读作“西格玛”,表示总体标准差。尖括号表示按总体分布取平均,σ²便是总体方差。下面一行的s²则由手中的n条记录估计,使用样本均值。对刚才两组三条记录,样本标准差分别为1和3 nm。两种计算规则对应的任务已经不同,因此写出数值时要交代是在描述完整的有限分布,还是用抽样去估计更大的总体。
平方偏离也会让很远的点产生较大影响:偏离从1变成10,平方贡献会从1变成100。这在研究中有两面性。如果链偶尔真的进入很伸展的构象,远处的点是重要信号;如果测量仪器偶发异常,它也会显著改变结果。平均数和标准差因此需要与分布图一起阅读。尤其当分布有两个峰时,均值可能落在两个峰之间一个很少出现的位置,像把早晚两个交通高峰平均成“中午最拥挤”。数据的中心有用,常见状态是否就在中心附近,还要看图。
动手算一遍。把3、4、5 nm都增加2 nm,得到5、6、7 nm。均值怎样变化?每个数减去新均值以后,得到的偏离有没有变化?再把原来的三个数都乘以2,比较标准差与方差各扩大多少倍。前一个操作帮助区分“中心移动”和“分布变宽”,后一个操作可以直接检查单位平方的含义。
展开计算
加2 nm后,均值从4变成6 nm,偏离仍为−1、0、1 nm,因此标准差不变。乘以2后,均值从4变成8 nm,所有偏离也乘以2;标准差乘以2,方差乘以4。使用总体分母或样本分母,都满足这两条变化关系。
03拍得更多,为什么有时并没有准得更快
标准差描述记录彼此有多大差别,平均值本身的精度则是另一个问题。想知道全校学生的平均身高,可以随机抽取一组学生来估计;换一组学生,平均数会稍有变化。学生身高的分散程度是个体之间的差别,不同抽样得到的平均身高之间的分散程度,才衡量这次估计有多稳定。在分子计算中,构象的尺寸可以有很大波动,而它们的平均尺寸仍然可以估计得很精确。
把“抽取n次观测、算出一个均值”的整个实验重复许多遍,再计算这些均值的标准差,得到的量叫标准误差,常简写为SE。对于独立、同分布且方差有限的观测,SE有一个简洁表达。独立表示某次观测的随机偏离不会告诉我们另一条记录往哪边偏;同分布表示各次记录遵循同样的统计规则。比如测量过程中温度持续变化,记录的均值也在漂移,就需要先处理这种条件变化。
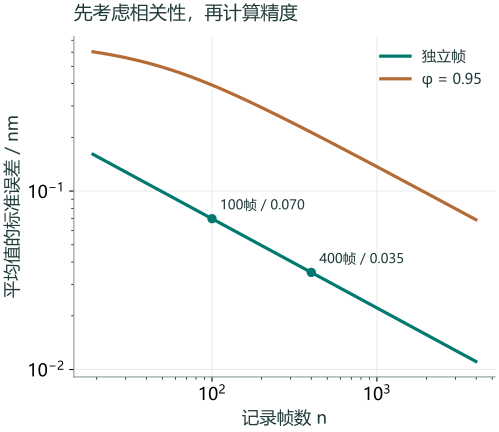
为什么分母是根号n?独立观测的方差相加,n个观测总和的方差是单次的n倍。求平均又要把总和除以n,而一个量除以n时,它的平方偏离会除以n²。两个变化合起来,均值的方差是原来的1/n;标准差需要再开平方,于是得到1/√n。若单次观测的标准差为0.7 nm,100次独立观测的SE为0.07 nm,400次为0.035 nm。把精度提升到误差减半,需要4倍的独立观测。
拍摄分子运动时,照片之间通常会保留联系。假设每隔很短时间记录一次链形,链还没来得及明显改变,下一幅照片就拍好了。这些帧能细致地记录运动,却不等于同样多次独立观察:把一张照片复制100次,仍只见过一种姿态。真实轨迹处在完全复制和完全独立之间,近处的帧通常相似,间隔拉长后联系逐步减弱。因此,选择拍摄间隔与选择拍摄总时长,解决的是两个问题:前者决定能看清多快的变化,后者关系到是否看到了足够多的状态。下面用一个带相关性的数列把这种差别算出来。
1953年,Prince E. Rouse研究稀溶液中卷曲高分子的黏弹性时,把链划分成适合统计描述的部分,并将各部分相互协调的运动纳入同一理论。连接点的移动会同时改变相邻部分的状态,因而整条链的运动包含多种松弛过程。这个研究思路解释了为什么“链上各处怎样连接”和“变化需要多长时间”必须一起考虑,也为我们理解轨迹中的相关性提供了具体的高分子图景。[2]
一个连接点移动,会改变它两侧的链段
为了把相关性的影响单独看清楚,下方实验用一个标量序列。想象我们记录链上某个标记点沿指定方向的坐标X。把它的长期平均位置记为μ,当下偏离平均位置多少记为z,所以X=μ+z。下一步保留前一步偏离的φ倍,再加上一次新的随机扰动ε。φ读作“斐”,没有单位;ε读作“艾普西隆”,在这里与z一样使用nm。φ=0时,前一步的偏离全部丢开;φ=0.95时,前一步偏离的大部分会延续到下一步。
代码让μ保持4 nm,让每一帧的总体标准差都保持0.7 nm。为做到这一点,初始偏离从均值0、标准差0.7 nm的正态分布抽取,每次新扰动的标准差设为0.7√(1−φ²) nm,而且各次扰动相互独立。验证这个选择只需要方差相加:上一帧贡献φ²σ²,新扰动贡献(1−φ²)σ²,加起来仍是σ²。这样改变φ时,我们比较的是联系的持续程度,单帧分布的宽度保持相同。正态分布就是常见的钟形分布,它描述有正有负的坐标偏离。
在这个平稳序列中,相隔k步的相关系数是φᵏ,间隔越长,联系越弱。计算均值方差时,除了每帧自己的方差,还要把不同帧之间共同涨落的贡献算进去。相隔k步的配对有n−k组,两个排列方向都要计数,于是得到下面的相关性因子gₙ。Var是方差的英文缩写,公式第一行表示:先按独立观测算方差,再乘上这个因子。φ为0时,gₙ回到1;正相关时,它大于1。
同样记录许多帧,相关性改变了多少精度
在φ=0.95、n=400时,若按独立观测计算,理论SE是0.035 nm;计入相关性后,理论SE约为0.213 nm。同样的均值精度,相当于约10.78个同方差的独立观测。记录400帧仍然有用:我们保留了过程,也比只记录一帧知道得更多,只是新增信息没有按文件数量增加得那样快。在实际研究中,可以延长观测总时间、增加独立起点,并检查不同时间间隔的相关程度,再决定怎样估计误差。
这里的坐标序列用来隔离统计效应,步号没有对应某种真实分子的秒数。不同分子、不同温度甚至同一轨迹里的不同观测量,都可能有不同的相关时间。因此,“隔十帧取一次”需要由具体数据的时间结构来支持。对于一条始终困在某个状态附近的轨迹,单纯间隔抽帧还不能补上其他状态;先看轨迹走到了哪里,再估计它提供了多少近似独立的信息,两步都需要做。
04AI也需要分清一幅新图与一个新对象
统计分布与AI的联系,比给材料性质拟合一条曲线更深。《高分子结构基础:连接、链长与尺度》的回归模型为输入给出一个刚度预测;如果我们关心一条分子链的多种可能姿态,就希望模型能够表达不同状态及其出现机会。一个总是输出“平均姿态”的模型,可能把两个常见构象折中成一个很少出现的形状。对生物大分子而言,知道哪些构象能够出现、它们各占多少,以及外界条件怎样改变这些比例,往往和预测一个中心值同样重要。
1985年,David Ackley、Geoffrey Hinton和Terrence Sejnowski发表了关于Boltzmann机器学习算法的论文。网络用随机单元描述可能状态,通过调整连接,让内部产生的模式分布与训练例子相联系。这里出现了一条连接统计物理和机器学习的思路:学习的对象可以是一组状态的分布。今天读这篇论文,不必立即计算复杂网络的全部概率;先认识到“让模型产生恰当的多样性”本身就是一种学习任务,便能理解为什么生物大分子的AI研究需要走出单张结构图。[3]
让模型学会“哪些状态常出现”
不过,模型能从数据里学到什么,还取决于我们怎样安排训练与检验。假设一份样品拍了12幅图,120份样品共得到1440条记录。把这些行随机打散后分成训练集和测试集,常常会让同一份样品的照片出现在两边。模型可能通过背景、局部纹理或其他稳定特征认出这份样品。在“预测已经见过的样品的另一幅图”这个任务里,认识样品确实有帮助;如果研究目标是“预测一份新样品”,就应把完整样品留给测试。
我们可以设计一个很直接的对照来观察它。先为120份虚拟样品各生成8个随机数,作为该样品的指纹。拍摄每一帧时,在指纹上加一点很小的扰动,同一样品的12帧就仍然很相似。再把样品随机分成A、B两类,各60份;这些标签与指纹之间没有预设规律。这样,新的样品来自同一种随机生成过程,过去某个指纹属于A还是B,不会给另一个新指纹提供稳定的判断依据。
分类器采用最邻近的方法:收到一条测试记录,就在训练记录里寻找最相似的一条,把它的类别作为预测。相似性用8维特征的平方距离衡量,也就是8个分量分别作差、平方,再相加。程序先根据训练集计算各列的中心和尺度,让不同列可以在同一距离里比较,再把同一套转换用于测试集。读到这里,你已经可以预测实验结果:如果训练集中保存着同一样品的其他帧,它们几乎就是现成的近邻。
| 划分方式 | 训练与测试共有的样品 | 测试准确率 |
|---|---|---|
| 随机留出360条记录 | 115份 | 100.0% |
| 完整留出30份样品,共360条记录 | 0份 | 52.2% |
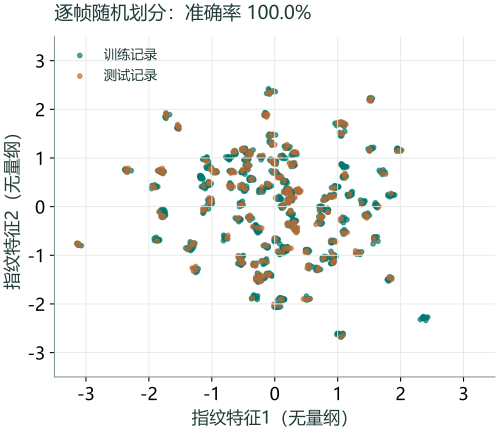
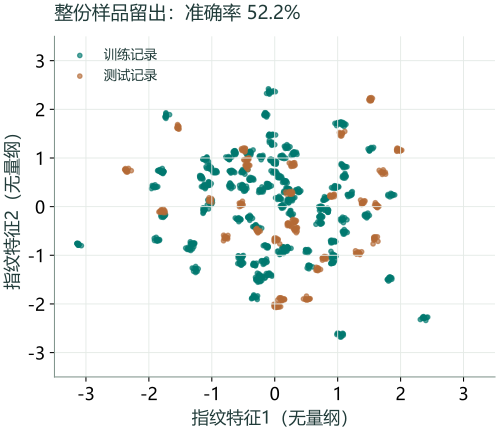
固定随机种子的这次运行里,逐行划分得到了100%的准确率。完整留出样品以后,准确率约为52.2%,接近这类平衡随机标签问题的机会水平。前一个结果说明近邻方法成功认出了已见样品留下的指纹;后一个结果与我们事先设定的“新样品标签没有可学规律”相符。这个对照让评价目标变得可见:测试记录的来源改变以后,我们考查的能力也随之改变。表中的数值由下面的代码实际计算,可以修改种子重做整个实验。
今后把构象交给图神经网络时,也需要先解决这件事。可以把原子或残基作为节点,把选定的连接关系作为边,再把坐标或距离放入特征;同一轨迹的相邻帧会生成相似的图。若目标是预测新序列,就按序列划分;若目标是评价新实验批次,就按批次划分;若目标是研究已知分子的未来演化,则保留时间顺序,让过去与未来各在相应的位置。选择更复杂的网络并不会自动改变数据之间的联系,科学问题仍然决定应在哪个层次上留出测试对象。[5]
实际训练前,还可以让AI协助整理数据来源:从记录中提取序列编号、样品编号、制备批次、轨迹编号和时间戳,再检查哪些记录共享同一个来源。这些标记随后进入划分脚本,而不应只留在文件名里。训练完成后,按这些来源分别看误差,可以发现模型在哪类对象上表现稳定、在哪些条件下需要增加样本。这样,AI既参与预测,也参与建立可追溯的数据组织方式。
05把构象、误差和AI评价放进一次计算
下面的完整例子把三个问题放在一起做:生成独立珠链构象并统计尺寸,重复抽取独立或相关序列以比较均值的波动,再用虚拟样品检查训练与测试划分。三段实验各有明确的对象。第一段处理三维链形状,第二段只控制一个坐标观测量的时间相关性,第三段使用8维指纹研究样品身份。它们共享统计思路,各自保留回答当前问题所需的最少变量。
程序使用NumPy处理数组、使用Matplotlib绘图,运行后在当前目录建立statistics_outputs文件夹,保存六幅单图、六联组图和一份数值文件。随机种子使抽样过程可以复现。链方向由三维正态向量归一化得到,利用其没有偏好方向的性质在球面上均匀抽样;cumsum把链段位移依次加起来,得到每颗珠子的位置。axis指定沿哪一维运算,例如沿坐标维度求长度,或沿记录维度求均值。
第二段把“重复整个实验”直接写进数组:每一行是一轮400帧的观测,总共2000行。先在每行内部求平均,再在2000个均值之间计算标准差,就能检验SE公式。如果把顺序反过来,先把所有数展平,再求一个标准差,得到的主要是单帧分布的宽度。代码里看似简单的维度选择,对应着你究竟要衡量哪一种波动。
完整Python例子
"""9.8.2: conformations, correlated observations and grouped AI evaluation."""
from pathlib import Path
import json
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import font_manager

output = Path("statistics_outputs")
output.mkdir(exist_ok=True)
rng = np.random.default_rng(20261023)

# 1. 独立生成2000条三维等长珠链:每条32段,每段1 nm。
# 正态向量归一化后,方向均匀分布在球面上。
directions = rng.normal(size=(2000, 32, 3))
directions /= np.linalg.norm(directions, axis=2, keepdims=True)
positions = np.concatenate([np.zeros((2000, 1, 3)),
                            np.cumsum(directions, axis=1)], axis=1)
end_vectors = positions[:, -1, :]
distances = np.linalg.norm(end_vectors, axis=1)
print("链的平均端到端距离 / nm:", round(distances.mean(), 4))
print("平均端到端向量 / nm:", end_vectors.mean(axis=0).round(4))

# 2. 用标量随机序列隔离相关性的影响。
# z代表一个观测量相对均值的偏离;phi决定前一帧的影响保留多少。
# 这是统计教学模型,步号没有映射为真实分子的物理时间。
mu, sigma, n, repetitions = 4.0, 0.7, 400, 2000
def correlated_series(phi, repeats, frames):
    z = np.empty((repeats, frames))
    z[:, 0] = rng.normal(0, sigma, repeats)
    scale = sigma*np.sqrt(1-phi**2)
    for t in range(1, frames):
        z[:, t] = phi*z[:, t-1] + rng.normal(0, scale, repeats)
    return mu+z

def exact_mean_se(phi, frames):
    lag = np.arange(1, frames)
    inflation = 1 + 2*np.sum((1-lag/frames)*phi**lag)
    return sigma*np.sqrt(inflation/frames)

independent = correlated_series(0.0, repetitions, n)
correlated = correlated_series(0.95, repetitions, n)
summary = {}
for label, values, phi in [("independent", independent, 0.0),
                            ("correlated", correlated, 0.95)]:
    mean_sd = values.mean(axis=1).std(ddof=1)
    naive_se = np.mean(values.std(axis=1, ddof=1)/np.sqrt(n))
    summary[label] = dict(mean_sd=float(mean_sd), naive_se=float(naive_se),
                          exact_se=float(exact_mean_se(phi, n)))
    print(label, "重复实验均值的标准差:", round(mean_sd, 4),
          "逐帧独立公式给出的SE:", round(naive_se, 4))

# 3. 给120个虚拟样品各保存12帧。样品指纹在帧间保留。
# A/B标签按样品随机分配,构造一个“新样品上无可学规律”的对照。
groups = np.repeat(np.arange(120), 12)
centers = rng.normal(size=(120, 8))
features = centers[groups] + rng.normal(0, .025, (len(groups), 8))
sample_labels = np.repeat([0, 1], 60)
rng.shuffle(sample_labels)
labels = sample_labels[groups]
row_test = np.zeros(len(groups), dtype=bool)
row_test[rng.permutation(len(groups))[:360]] = True
heldout = rng.permutation(120)[:30]
group_test = np.isin(groups, heldout)

def nearest_neighbor(test):
    train = ~test
    # 缩放参数只从训练记录估计;测试记录使用同一套参数。
    center = features[train].mean(axis=0)
    scale = features[train].std(axis=0)
    a = (features[test]-center)/scale
    b = (features[train]-center)/scale
    squared = (a*a).sum(axis=1)[:, None] + (b*b).sum(axis=1)[None, :] - 2*a@b.T
    prediction = labels[train][np.argmin(squared, axis=1)]
    return prediction, float(np.mean(prediction == labels[test]))

scores = {}
for name, test in [("row", row_test), ("group", group_test)]:
    prediction, accuracy = nearest_neighbor(test)
    train_groups, test_groups = set(groups[~test]), set(groups[test])
    scores[name] = dict(accuracy=accuracy,
                       overlapping_groups=len(train_groups & test_groups),
                       test_rows=int(test.sum()), test_groups=len(test_groups))
    print(name, "准确率:", round(accuracy, 4),
          "两侧共有样品数:", scores[name]["overlapping_groups"])
assert scores["group"]["overlapping_groups"] == 0

# 4. 所有图表由上面的同一批数据生成,保存为SVG与PNG。
available = {f.name for f in font_manager.fontManager.ttflist}
font = next((s for s in ["Microsoft YaHei", "Noto Sans CJK SC", "SimHei"]
             if s in available), "DejaVu Sans")
plt.rcParams.update({"font.family": font, "font.size": 13,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.edgecolor": "#82968e", "text.color": "#203b39",
    "axes.labelcolor": "#203b39", "axes.unicode_minus": False,
    "svg.fonttype": "path", "svg.hashsalt": "ai4s-statistics-20261023"})
green, orange, blue = "#00796f", "#b46b36", "#6170a4"
panels = ["conformations", "trajectory", "means", "precision", "split_row", "split_group"]
def draw(ax, name):
    ax.grid(color="#e4eae6", zorder=0, linewidth=.7)
    if name == "conformations":
        ax.hist(distances, bins=np.linspace(0, 15, 31), density=True,
                color=green, alpha=.75, edgecolor="white", zorder=2)
        ax.axvline(distances.mean(), color=orange, lw=2, label="平均距离")
        ax.set(xlabel="端到端距离 R / nm", ylabel="概率密度 / 每nm", xlim=(0, 15))
        ax.set_title("同一链模型的2000幅构象", loc="left", pad=13, fontsize=14)
        ax.legend(frameon=False, fontsize=11)
    elif name == "trajectory":
        ax.plot(independent[0], color=green, alpha=.6, lw=1, label="相邻帧独立")
        ax.plot(correlated[0], color=orange, lw=1.6, label="相关系数 φ = 0.95")
        ax.axhline(mu, color="#777777", ls="--", lw=1)
        ax.set(xlabel="记录步号", ylabel="示意观测量 X / nm", xlim=(0, n), ylim=(1.4, 6.6))
        ax.set_title("同样400帧,不同的信息重复程度", loc="left", pad=13, fontsize=14)
        ax.legend(frameon=False, fontsize=10, loc="upper right")
    elif name == "means":
        bins=np.linspace(3.2, 4.8, 45)
        ax.hist(correlated.mean(axis=1), bins=bins, density=True, color=orange, alpha=.6, label="相关序列")
        ax.hist(independent.mean(axis=1), bins=bins, density=True, color=green, alpha=.65, label="独立序列")
        ax.axvline(mu, color="#324e45", ls="--", lw=1.2)
        ax.set(xlabel="一次实验的平均值 / nm", ylabel="概率密度 / 每nm", xlim=(3.2, 4.8))
        ax.set_title("重复2000次,平均值会怎样波动", loc="left", pad=13, fontsize=14)
        ax.legend(frameon=False, fontsize=11)
    elif name == "precision":
        counts=np.unique(np.logspace(1.3, 3.6, 80).astype(int))
        for phi, color, label in [(0, green, "独立帧"), (.95, orange, "φ = 0.95")]:
            ax.loglog(counts, [exact_mean_se(phi, int(m)) for m in counts],
                      lw=2.4, color=color, label=label)
        for count in [100, 400]:
            value=exact_mean_se(0, count)
            ax.scatter(count,value,color=green,zorder=4)
            ax.annotate(f"{count}帧 / {value:.3f}", (count,value),
                        xytext=(6,7), textcoords="offset points",fontsize=10)
        ax.set(xlabel="记录帧数 n", ylabel="平均值的标准误差 / nm")
        ax.set_title("先考虑相关性,再计算精度", loc="left", pad=13, fontsize=14)
        ax.legend(frameon=False, fontsize=11)
    else:
        test=row_test if name=="split_row" else group_test
        for mask,color,label in [(~test,green,"训练记录"),(test,orange,"测试记录")]:
            ax.scatter(features[mask,0],features[mask,1],s=11,c=color,alpha=.65,label=label)
        key="row" if name=="split_row" else "group"
        title="逐帧随机划分" if key=="row" else "整份样品留出"
        ax.set_title(title+f":准确率 {100*scores[key]['accuracy']:.1f}%",loc="left",pad=13,fontsize=14)
        ax.set(xlabel="指纹特征1(无量纲)",ylabel="指纹特征2(无量纲)",
               xlim=(-3.5,3.5),ylim=(-3.5,3.5))
        ax.legend(frameon=False,fontsize=10,loc="upper left")

for name in panels:
    fig,ax=plt.subplots(figsize=(5.2,4.5),layout="constrained")
    draw(ax,name)
    fig.savefig(output/f"{name}.svg",metadata={"Date":None})
    fig.savefig(output/f"{name}.png",dpi=180)
    plt.close(fig)
fig,axes=plt.subplots(2,3,figsize=(16.2,10),layout="constrained")
for ax,name in zip(axes.flat,panels):draw(ax,name)
fig.suptitle("从构象分布到可信的AI评价\n独立构象与相关序列为不同的教学模型",fontsize=20)
fig.savefig(output/"statistics_diagnostics.svg",metadata={"Date":None})
fig.savefig(output/"statistics_diagnostics.png",dpi=220)
plt.close(fig)

# 记录数值、模型条件及少量构象,供网页交互和复核使用。
payload={"seed":20261023,"n_chains":2000,"segments":32,"bond_nm":1,
    "mean_R":float(distances.mean()),"rms_R":float(np.sqrt(np.mean(distances**2))),
    "mean_vector":end_vectors.mean(axis=0).tolist(),"std_R":float(distances.std(ddof=1)),
    "photos":positions[:24].round(7).tolist(),"distances":distances.tolist(),
    "mean_model":{"mu":mu,"sigma":sigma,"n":n,"phi":.95,"repetitions":repetitions},
    "summary":summary,"scores":scores,
    "exact_neff":float(sigma**2/exact_mean_se(.95,n)**2)}
(output/"statistics_results.json").write_text(json.dumps(payload,ensure_ascii=False,indent=2),encoding="utf-8")
print("图表与数值已保存至:",output.as_posix())
链的平均端到端距离 / nm: 5.2150
平均端到端向量 / nm: [-0.0674 -0.1108 -0.0161]
independent 重复实验均值的标准差: 0.0356 逐帧独立公式给出的SE: 0.0349
correlated 重复实验均值的标准差: 0.2145 逐帧独立公式给出的SE: 0.0329
row 准确率: 1.0000 两侧共有样品数: 115
group 准确率: 0.5222 两侧共有样品数: 0
图表与数值已保存至:statistics_outputs
从独立构象到可信评价 · 一次运行的六幅结果图
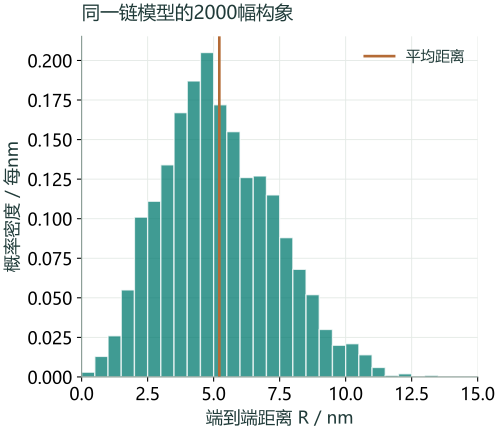
A · 同一模型独立抽取2000幅构象,尺寸形成一份分布。
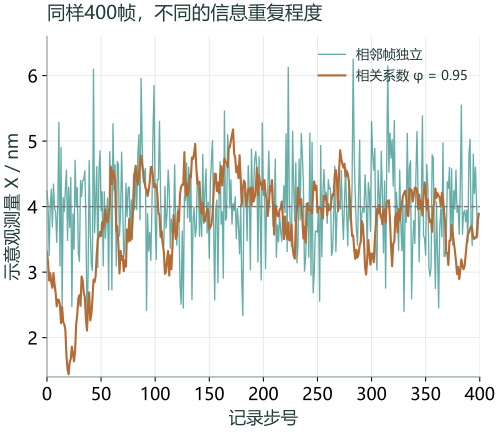
B · 单帧总体方差相同,连续记录可以有不同的相关性。
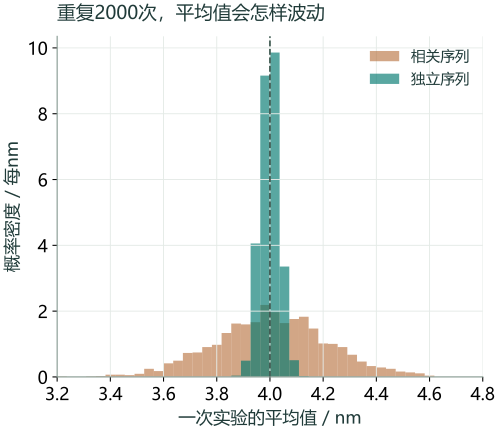
C · 重复整个400帧实验2000次,相关序列的均值分布更宽。
D · 绿色曲线上的两个点显示4倍独立观测让SE减半。
E · 按行划分时,同一样品的帧出现在训练和测试两侧。
F · 按样品划分后,一份样品的全部记录进入同一侧。
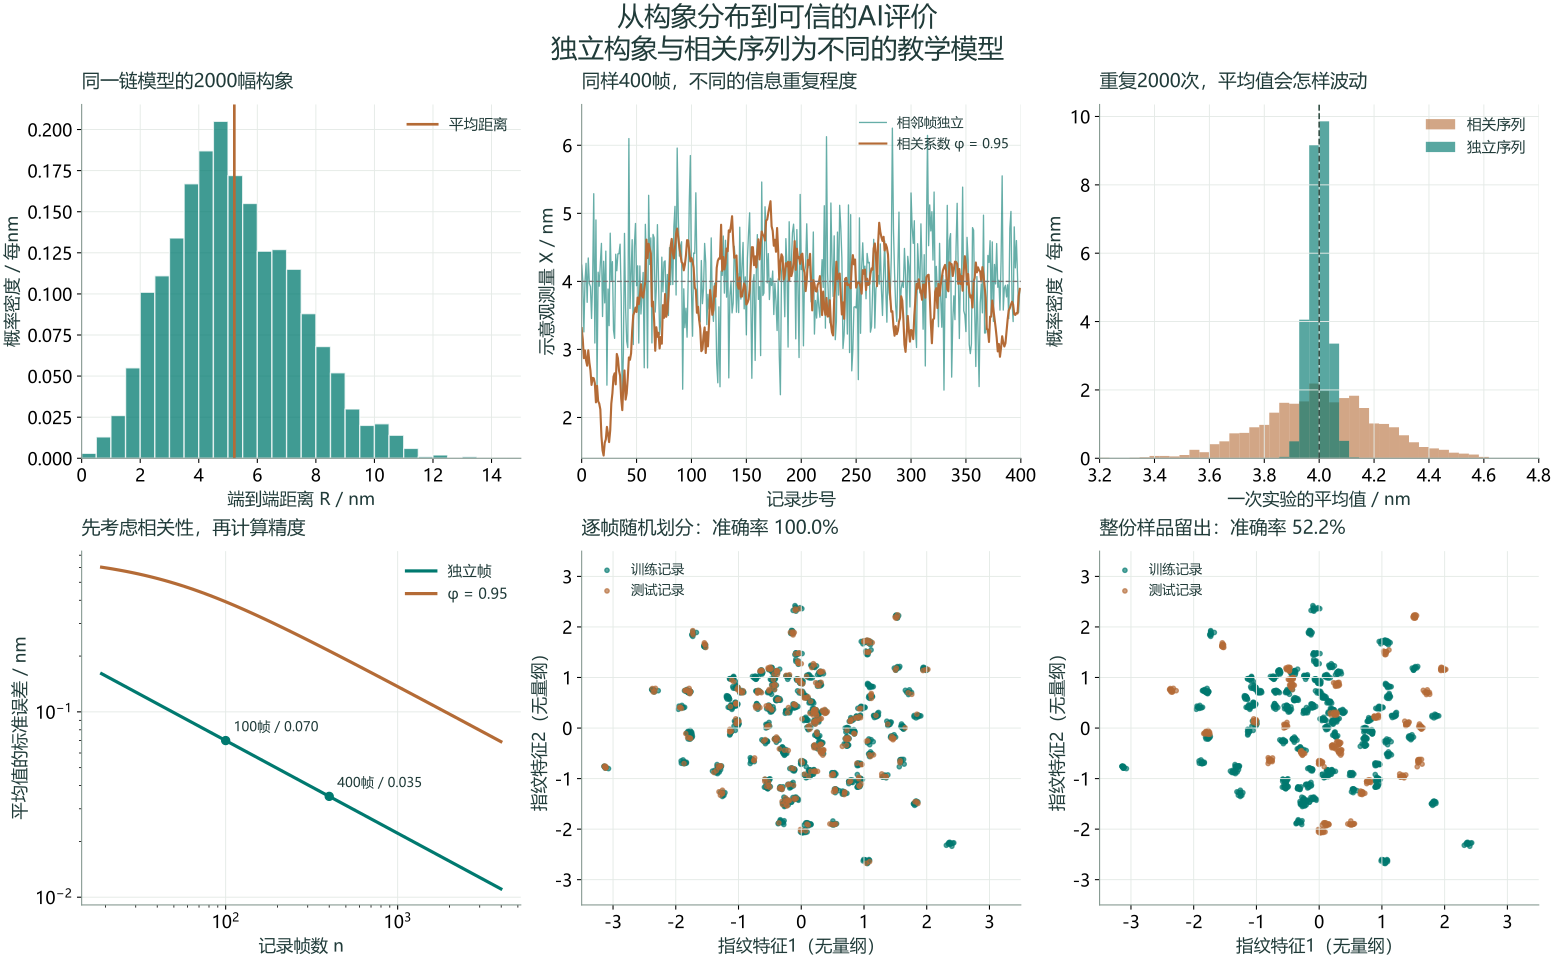
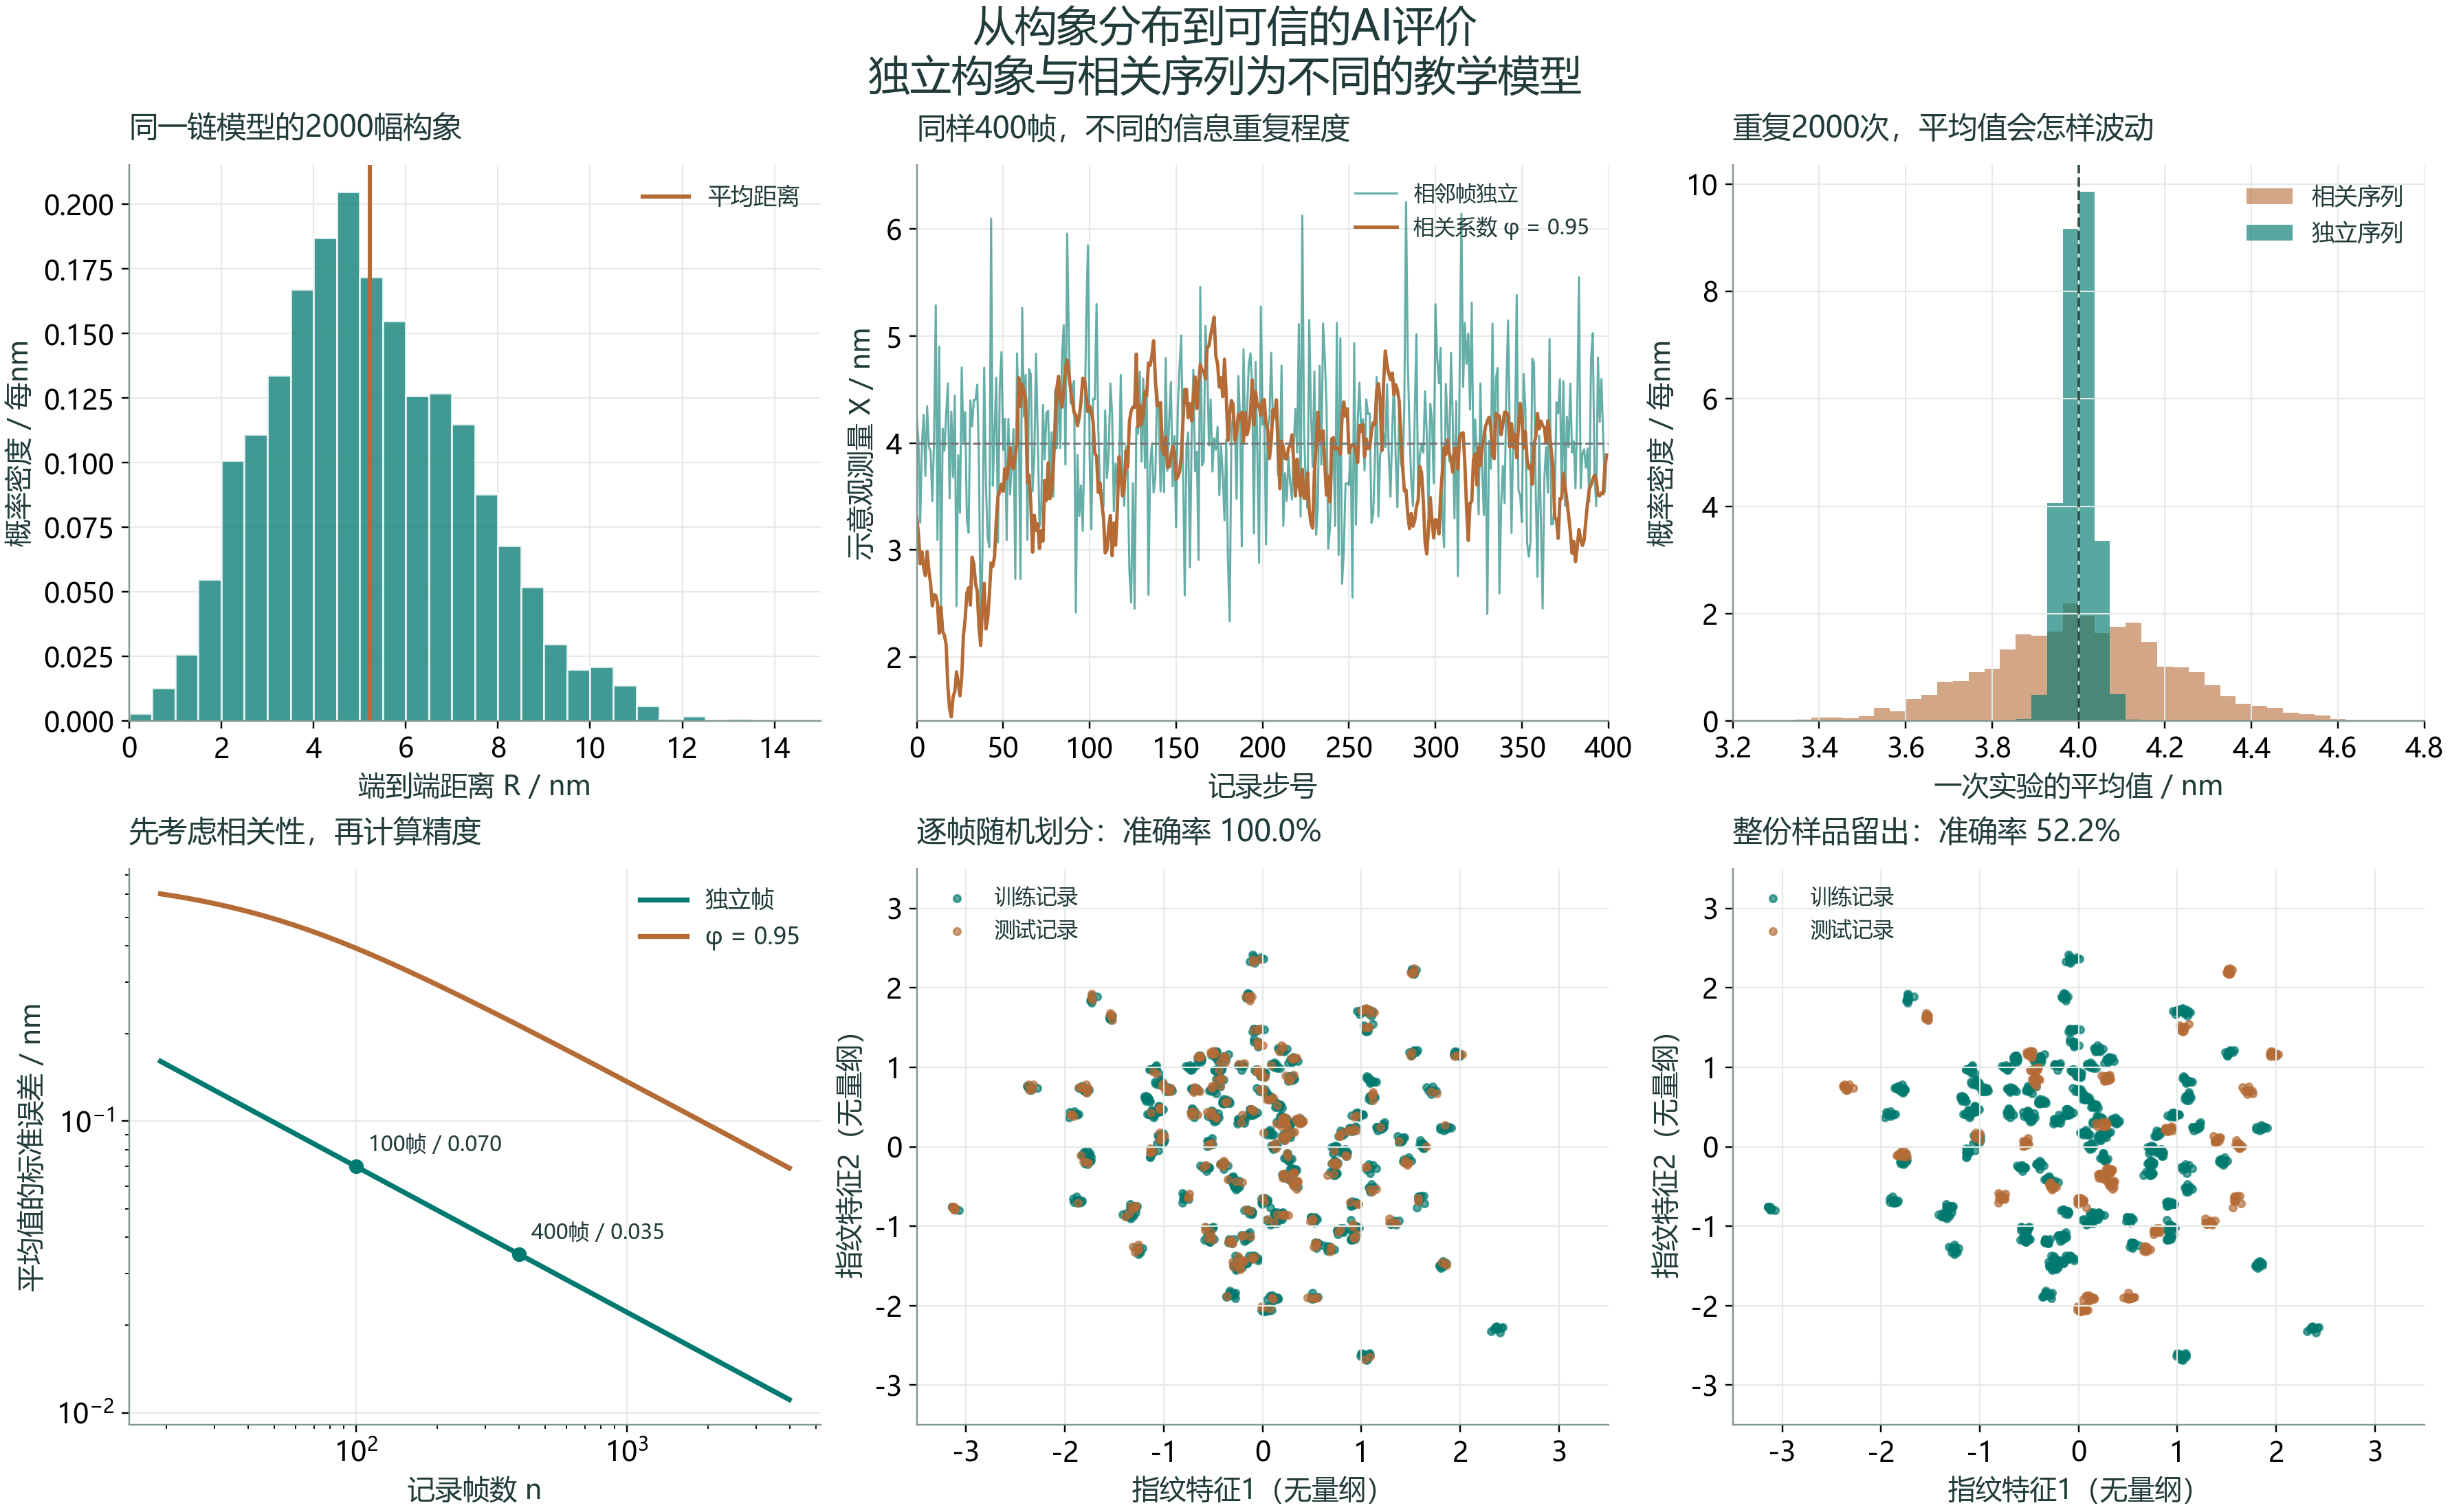
先看A图。横轴是端到端距离,纵轴是概率密度,也就是每单位长度中分配了多少概率。某根柱子的高度乘以宽度,才是距离落在该区间内的比例;所有柱子的面积相加为1。因此,密度的单位是每nm,数值本身也可以大于1。C图中独立实验的均值集中在很窄的区间里,柱子较高,正是因为相同的总概率挤进了更窄的范围。读图时同时看宽度和面积,就不会把柱子的高度误认为某种状态的直接概率。
B图保留记录顺序,能看到橙色相关序列常在同一方向连续偏离均值;绿色独立序列每一步重新抽样。两者的单帧总体均值和方差相同,连续偏离却更容易让一整段观测的平均值一起偏高或偏低。C图把这个后果显示出来:重复2000轮以后,相关序列均值的分布明显更宽。D图再把它概括成“记录数量与均值精度”的关系,图上的100帧与400帧标记对应前面计算的0.07与0.035 nm。
E、F图展示同一批样品指纹的前两个分量,每团彼此很近的点来自同一样品。E图里,绿色训练记录和橙色测试记录常混在同一小团;F图里,每份样品整体落在一种颜色中。分类器计算距离时使用全部8个分量,图只画出其中两维,方便看清划分方式。两个坐标范围保持一致,读者可以直接追踪同一团点怎样改变身份,而不必猜测差异是否来自缩放。
把这些计算带回生物大分子研究,可以形成一条具体工作顺序。先确定对象与条件,为序列、链长、溶液和轨迹保存标记;再查看构象及观测量随时间的变化,判断记录是否已经覆盖关心的状态;随后用适合依赖结构的方法估计均值精度;最后按照希望推广到的新对象划分AI数据。若研究的是不同序列的蛋白质,增加同一序列的许多相邻帧能帮助刻画它的运动,却不能替代新序列带来的信息。样品数量和每份样品记录多长,分别对应研究设计中的两个选择。
改动代码,检查“记录更多”意味着什么。把独立序列的每一帧复制10遍,再按新的记录数量套用s/√n。与原来相比,公式给出的误差会接近缩小到原来的1/√10,而每轮实验的均值完全不变。解释两者为什么矛盾。再把指纹实验中的每份样品帧数增加一倍,观察它增加的是样品种类,还是已知样品的重复记录。
展开思路
复制后的相邻记录完全相关,独立观测的公式已不适用于扩充后的行数。每轮平均数没有变化,因此重复整轮实验所得均值的波动也没有变化。指纹实验增加帧数以后,120份样品仍是120份;它改善了对已有样品指纹的记录,新增样品上的标签仍由原来的随机规则决定。
最后回到链的尺寸。一个人从家向东走1 km,另一天向西走1 km,两次位移相加再平均可以是0,但两次离家的距离都是1 km。向量记录方向,距离记录大小,平均的顺序会改变答案。下方关系中的双竖线表示取向量长度,尖括号表示对构象取平均。在没有偏好方向的链模型中,各方向的末端位移会互相抵消;每个构象的首尾距离则仍然为正。
这次2000个构象的平均端到端向量约为(−0.067,−0.111,−0.016) nm,已经比较接近原点;平均端到端距离约为5.215 nm。前一个结果在问“末端整体偏向哪一边”,后一个在问“末端通常离起点多远”。第五节会从这个差别出发,把每一段的方向相加,解释链尺寸怎样随链长变化。接下来的第三、四节先认识蛋白质、糖链与核酸,以及它们所处的水、温度和电荷环境,让这些统计量对应到具体分子。
资料与延伸阅读
- Brown, R. (1828). 关于1827年观察的简要报告,记述植物颗粒及其他材料的微观运动。原始论文扫描件。肖像来源与权利信息见图注。
- Rouse, P. E. (1953). A Theory of the Linear Viscoelastic Properties of Dilute Solutions of Coiling Polymers. Journal of Chemical Physics, 21, 1272–1280. 原始论文。本节借其协调运动的思路说明相关性,标量实验另外采用明确给出的随机序列。
- Ackley, D. H., Hinton, G. E., & Sejnowski, T. J. (1985). A Learning Algorithm for Boltzmann Machines. Cognitive Science, 9, 147–169. 作者提供的原始论文。
- NumPy. 标准差函数与ddof参数。代码使用ddof=1估计样本方差,再开平方;本节的总体方差、均值方差与相关性因子按正文定义推导。
- scikit-learn. 交叉验证、分组数据与时间序列。完整例子用NumPy实现划分与近邻计算,便于逐步查看每个对象进入了哪一侧。