从生活材料走进分子与计算
高分子结构基础:连接、链长与尺度
保鲜膜可以随手折起,矿泉水瓶却能稳稳立住;棉线适合缝衣服,橡皮筋拉长后又会缩回去。这些东西都由分子构成,表现却差别很大,这是为什么?答案藏在四件相互关联的事情里:分子由什么组成,彼此怎样连接,如何排列,以及最后被加工成什么形状。
本教程参考AI4S in Hand 的材料科学讨论中“组成—结构—加工—性能”的主线,从你能摸到、弯得动的物品进入高分子和生物大分子。我们先把研究对象看清楚,再学习用数字描述它,最后亲手比较几种AI输入方式。读完之后,你应当能解释“链很长”究竟是哪一种长,算清一袋长短不一的链为什么有两个常用平均值,并把一句“这个材料比较软”改写成可测量、可建模的研究问题。
一路上会用到几个生活中的比喻:散珠和项链帮助我们理解“连接”,盘起来的充电线帮助我们区分“长度”和“形状”。天然橡胶、纤维素和胰岛素的研究故事则会告诉我们,今天看起来理所当然的概念,当初是为了解释哪些现象才一步步建立起来的。到了AI实验部分你会发现,前面建立的物理认识,会直接决定数据表里该有哪些列。
01从一盒散珠,到有顺序的分子链
把一盒散珠倒在桌上,推一颗珠子,动的基本只有它自己。把同样的珠子串成项链,拉住一端,后面一长串都会跟着动。珠子没有变,变的是连接,运动方式也随之改变。高分子的关键特点就在这里:许多小的结构单元通过化学键连成一个很大的分子。例如,聚乙烯的主链由 –CH₂–CH₂– 单元重复连接而成;棉纤维的主要成分纤维素,由许多葡萄糖单元连接而成;蛋白质则由不同的氨基酸残基按特定顺序连接起来。[1]
“结构单元”可以先理解成搭链用的积木。积木的种类决定局部的化学性质;积木怎样相连,决定链的整体结构;每个连接处能怎样转动,又决定链能摆出哪些形状。项链只体现了最基本的连接约束,真实分子还要考虑键角、转动能垒、电荷和立体结构。打个比方:一根软绳很容易盘成一团,一根较硬的钓鱼线却总想保持原来的方向。可见,即使长度相同,弯曲难易不同的链,占据的空间也会很不一样。
人类使用天然大分子的历史,远早于理解它们的结构。人们穿棉衣、用橡胶、把纤维纺成线的时候,这些材料早就在发挥作用。可是,“这么大的分子真的存在吗”,在一百年前仍有争论。当时一种解释是:许多小分子靠较弱的相互作用聚成团簇,表现出了大颗粒的性质。1920年前后,Hermann Staudinger提出,许多结构单元可以通过化学键连成一条很长的分子链。两种解释看起来都能得到“大”,对化学处理后的产物却可能给出不同预期。1922年,Staudinger与Jacob Fritschi研究天然橡胶及其加氢产物;加氢改变了碳碳双键,产物仍表现出大分子特征,为长链解释提供了实验支持。[2]从此,研究者能够围绕链的质量、长度和连接方式设计更有针对性的实验。Staudinger于1953年获得诺贝尔化学奖。
一群小分子聚在一起,和许多单元连成一条长链,具有不同的内部连接。先分清研究对象,再用链的质量、连接与形状解释溶解和弹性。

再看桌上的珠子,一团散珠和一条盘起的项链可能占据相近的空间,内部连接却不同。沿项链拉动一处,其他部分的运动受到连接的约束;对于散珠组成的团簇,则还要问珠子靠什么聚在一起、怎样分开和交换。分清“一个分子内部的连接”与“多个分子之间的组织”,才能接着解释溶解、弹性和组装。下面的图把这个问题分成三个观察层次:单元的化学结构、沿链的排列顺序,以及整条链在空间中的形状。
同样叫“连接”,研究的层次可以不同
生物大分子把问题又往前推了一步:只知道单元的种类和数量还不够,还要知道它们的顺序。以蛋白质为例,“有哪些氨基酸”和“氨基酸按什么顺序排列”是两类信息,就像同一盒汉字可以排成意思不同的句子。20世纪50年代,Frederick Sanger和同事以胰岛素为对象,逐步测出了它的氨基酸排列顺序。1955年发表的研究又确定了二硫键的位置,包括连接两条链的链间二硫键和A链内部的二硫键。二硫键是两个半胱氨酸残基的硫原子之间形成的共价连接。这样,一种蛋白质就能用具体的序列和连接关系来描述,而不再只能用整体组成或平均质量来概括。[3]
要测出顺序,一个重要办法是把长链分成能够分析的短片段,再用片段之间的关系还原整体。Sanger在诺贝尔演讲中回顾了这样的过程:对胰岛素的一条链进行部分水解,分离得到的短肽,分析它们由哪些氨基酸组成、哪个残基位于开头,再综合多份片段的信息推断排列。可以把它想成拼接同一句话的不同剪贴片段:在一个刻意简化的字母例子中,AGK与GKE共享GK,便提供了拼成AGKE的线索。真实实验需要分离、标记和相互印证,而这个小例子说明了核心思想——局部测量之间的重合关系,能够帮助我们恢复完整的连接。[3]
把长链分成可以分析的短片段,再综合组成、端点与重合关系,是把实验信号变成序列信息的一条路径。完整序列也成为后续生物大分子计算的重要输入。

这一转变也解释了为什么生物材料方向的AI模型常把序列当作输入。假如两条链组成相同、排列不同,一张只记录组成比例的数据表会把它们当成同一个对象。只有保存了序列,模型才有机会学到相邻片段之间、以及相距较远的单元之间的关系。当然,一条序列最终形成什么结构,还和温度、溶液环境以及与其他分子的相互作用有关。所以,从生物学读到材料科学,我们要同时追踪两件事:分子身份说明“这是哪条链”,所处状态说明“它在什么条件下表现出什么行为”。
现在把视线拉回一片薄膜。在分子层次,我们关心链的化学结构和长度;许多链聚在一起时,要关心链的取向、结晶区域和缠结;做成物品以后,还要关心厚度、形状和受力方式。加工就像连接这些层次的桥梁:拉伸、冷却、溶剂处理都会改变结构的形成过程,进而影响最终性能。接下来,我们会给这些对象逐一起名字、定单位,好让不同层次的信息能放进同一个研究问题里。
02一根盘起的线,为什么需要几种“大小”
想象一根一米长的充电线。把它拉直,两个接头相距接近一米;把它盘成一圈,两个接头可以碰在一起。线并没有变短,变的是形状。描述分子链也要做同样的区分:轮廓长度是沿着链一步步走完的总路程,端到端距离是起点和终点之间的直线距离。前者像导航记录的行驶里程,后者像地图上两地的直线距离。两者单位相同,回答的却是不同的问题。
为了把“沿链走”变成可以计算的量,我们把一条模型链分成 N 个等长的链段,每段长 b。注意,N 只是段数,没有单位;b 才是长度。如果每段2 nm、一共12段,沿链走完就是24 nm。这和把12根2 cm长的小木条首尾相接是一回事,只是尺度不同。写成公式:
链段怎样划分,由模型决定。一个链段可以对应一个化学键,也可以代表一组原子在更大尺度上的整体运动。把好几个原子的细节合并成一颗“模型珠”,就叫粗粒化。城市地图会省略房子里的家具,道路关系才看得清楚;分子模型也要根据问题决定保留多少细节。关心某个原子附近的化学反应,就得保留局部化学环境;关心整条长链伸展得多开,就可以先用更粗的描述。所以,记录一个长度时,最好同时说明“每一段代表什么”,以免混淆。
转动连接处:轮廓长度不变,端点距离改变
12个模型链段,每段2 nm。
绿色:沿链走 橙色虚线:连接两端
端到端距离会变,是因为每一段都有方向。沿第一段向右走,再沿第二段向左走,走过的路程增加了,两步的位移却可能相互抵消。把每一段看作一个箭头,依次首尾相加,得到的就是终点相对于起点的位移,这个位移的长度就是 R。因为两点之间直线最短,任何这样的链都满足 R ≤ L,只有完全伸直、各段同向时才取等号。这个简单的检查很实用:如果程序算出 R 比 L 还大,就该回头检查坐标、单位或连接顺序。
还可以先估计一下随机取向会带来多大差别。假设各段长度相同、方向彼此独立,而且各方向出现机会相同,许多构象的端到端距离平方取平均后再开方,得到 √N × b。这叫均方根距离。12段、每段2 nm的链,轮廓长度为24 nm,均方根距离却约为6.93 nm。它概括许多构象,单独一幅快照仍可以更大或更小。后面讨论构象统计时,我们会逐步推导它;这里先记住,许多段的方向相互抵消后,空间尺寸可以远小于沿链长度。
两个接头靠得很近,也不等于整团线只占很小的地方。把线盘成一个大圆环,起点和终点挨着,线本身却铺开在一大片区域里。为了描述整条链围绕自身中心分布得多开,后面会引入回转半径 Rg。对于质量相同的模型珠,先把各珠子的坐标分别求平均,找到中心;再把每颗珠子到中心的距离平方,求平均后开方。平方使远离中心的珠子贡献更大,最后开方让结果重新具有长度单位。端到端距离只看两个端点,回转半径看全部位置;选哪一个,取决于想解释的现象,这也是物理研究中选择特征的一个例子。
确认长链存在以后,下一步就是弄清它在空间里怎样展开。沿着化学键数出来的长度,并不能直接告诉我们链团有多大:连接处能够转动,同一条链便有许多种形状。Flory在1974年的诺贝尔演讲中回顾了从局部化学结构理解整条链空间构象的研究。[6]这也为生物大分子提出了清楚的问题:一条确定的蛋白质序列,在给定环境中会形成怎样的结构、在多少种构象之间变化?要回答它,首先得把链的质量、沿链长度和空间尺寸分别记录。
尺度感需要从熟悉的单位慢慢建立。1 nm = 10⁻⁹ m,1 mm = 10⁻³ m,所以1毫米等于一百万纳米。分子中常见的共价键长度约为0.1—0.2 nm;模型链段代表多少原子,要按问题选择;整条链的空间尺寸,则由链长、弯曲难易和环境共同决定。它们之间没有固定的换算格子。从纳米走向毫米,还会遇到多链组织、界面、孔隙和加工取向等新的信息。把一条链画得再大,仍然只画出了一条链;解释一件物品为什么能承载、透水或弯曲,还要把相应的结构层次补进来。
03一袋长短不一的链,为什么有两个平均值
我们已经把长度和形状分开了。接下来还有一件事,常常被一句“平均分子量”轻轻带过:一份聚合物样品通常包含大量的链,而且往往长短不一。想象一家项链工厂同时生产短项链和长项链,所有成品都装进同一个袋子。如果你想知道“一条典型的项链有多重”,可以随手摸一条,每条项链被摸到的机会相等;如果你想知道“原料主要用在了哪些项链上”,就应该让更重的项链在统计里占更大的份额。两个问题都合理,于是有了两种平均。
先把单位说清楚。摩尔是一种计数单位:就像“一打”是12个,一摩尔约是6.022×10²³个指定的实体。摩尔质量 M 是一摩尔这种实体的质量,常用 g/mol 或 kg/mol。说某种链的摩尔质量是10 kg/mol,意思是一摩尔这种链共重10 kg,而不是一条链重10 kg。条数相同的两类链,摩尔质量越大,总质量就按同样比例越大,所以可以直接用摩尔质量计算各类链在样品中所占的质量份额。[8]
现在构造最小的例子:一种链为10 kg/mol,另一种为30 kg/mol,两种链的条数相同。按条数投票,每类各得一半权重,平均值为20 kg/mol,这叫数均摩尔质量Mn。若按质量投票,第二类链虽然条数相同,却贡献了第一类三倍的质量;两类的权重因而分别为1/4和3/4。用这两个权重加权,就得到25 kg/mol,这叫重均摩尔质量Mw。“数”与“重”提醒我们的,正是投票规则。
各类链条数不同时,规则不变。设第 i 类链有 nᵢ 条,摩尔质量为 Mᵢ。数均时,这一类的权重是 nᵢ / Σⱼnⱼ;重均时,权重是 nᵢMᵢ / ΣⱼnⱼMⱼ。这里Σ表示“把后面的量逐类相加”,下标j负责遍历全部类别。给每个 Mᵢ 乘上对应权重,再把结果加起来,便得到 Mₙ = (ΣᵢnᵢMᵢ)/(Σᵢnᵢ),Mw = (ΣᵢnᵢMᵢ²)/(ΣᵢnᵢMᵢ)。第二式出现平方,是因为质量权重中已经含有一个 Mᵢ,平均时又乘上一次。两套权重各自加起来都等于1;代入刚才的10与30 kg/mol,就会回到20与25 kg/mol。下图把两套权重并排画出,拖动长链比例时,可以同时观察条数份额和质量份额怎样变化。
同一份样品,两套权重
按条数:每条链拥有一票
按质量:较重的链占更多份额
常用的分散度 Đ 定义为 Mw/Mn,本例中是25/20 = 1.25。分子和分母单位相同,所以 Đ 没有单位。如果所有链的摩尔质量都相同,两种投票规则给出同一个平均值,Đ = 1;只要摩尔质量有差异,质量加权就会偏向较重的链,使 Mw > Mn,于是 Đ > 1。IUPAC在2009年的建议中推荐用 dispersity(分散度)这个术语描述这一特征,取代过去常用的“多分散指数”(PDI)。[4]
更准确地说,Đ 衡量的是摩尔质量相对于平均值有多分散:Đ 越大,按条数统计的分布的相对标准差就越大(下面的推导给出了精确关系)。但单凭一个数,看不出分布是单峰还是双峰,也看不出有没有少数特别长的链拖出一条长尾。两份形状完全不同的分布可能有相同的 Đ,就像两个班平均分一样,成绩分布却可能大不相同。研究流动、加工或组装时,分布中哪一部分最重要,还要结合具体机制来判断。
再走一步:为什么Đ至少为1?
先以“随机挑一条链”为抽样方式,把平均摩尔质量记为μ,把摩尔质量与μ的偏差平方的平均记为σ²。由于平方不为负,σ²也不为负。展开偏差平方,可以得到“摩尔质量平方的平均”等于μ²+σ²。重均值恰好是这个平方平均再除以μ,因此Mw=μ+σ²/μ,继续除以Mn=μ,就得到:
这个式子同时说明两件事:Đ ≥ 1;Đ − 1 恰好等于相对标准差 σ/μ 的平方。这里的 μ 和 σ 都按链的条数统计。若平均值保持不变,摩尔质量围绕平均值散得更开,σ就更大,Đ也随之增大;把它们写进数据表时,需要连同“按条数统计”这个定义一起保存。
天然大分子让“分布”这件事更有层次。对于化学形式确定的一种蛋白质,氨基酸序列通常给出确定的链组成;但实际样品里还可能混有不同的修饰形式、切割产物、聚集体或其他蛋白。多糖则常常同时在链长、分支和取代程度上存在差异。所以,描述一份生物大分子样品时,先要说清:你数的是哪一种分子、哪一种化学形式,测量时有没有把不同组分混在一起。Sanger式的“序列身份”和聚合物的“分布语言”,是两种互相补充的认识方式。
04让AI看见的是样品,而不只是材料名称
回到开头的问题。假设我们要预测一张薄膜能承受多大的拉力,输入却只有“聚乙烯”这个名称,会漏掉什么?同一种聚合物可以有不同的摩尔质量分布、支化程度、结晶度和取向;薄膜可以有不同的厚度;测试时的温度、拉伸速度和方向也会改变结果。只凭名称做预测,就像只知道“这是一辆汽车”,却要判断它能拉多少货。我们需要把一个名称一步步展开,变成“一个在特定条件下被测量的具体样品”。
“该把什么信息交给机器”,这个问题从机器学习诞生之初就存在。1958年,Frank Rosenblatt在感知机论文中讨论了一个系统怎样根据输入的刺激做出分类反应,并通过经验调整内部连接的强弱。这让“从例子中调整参数”成了一个可以研究的计算问题。[5]今天使用机器学习,步骤依然相同:先决定哪些信息进入系统,再让学习过程去调整参数。感知机是一种分类模型,下面的练习用的是更简单的回归,但两者都提醒我们:学习方法和输入表示必须一起设计。
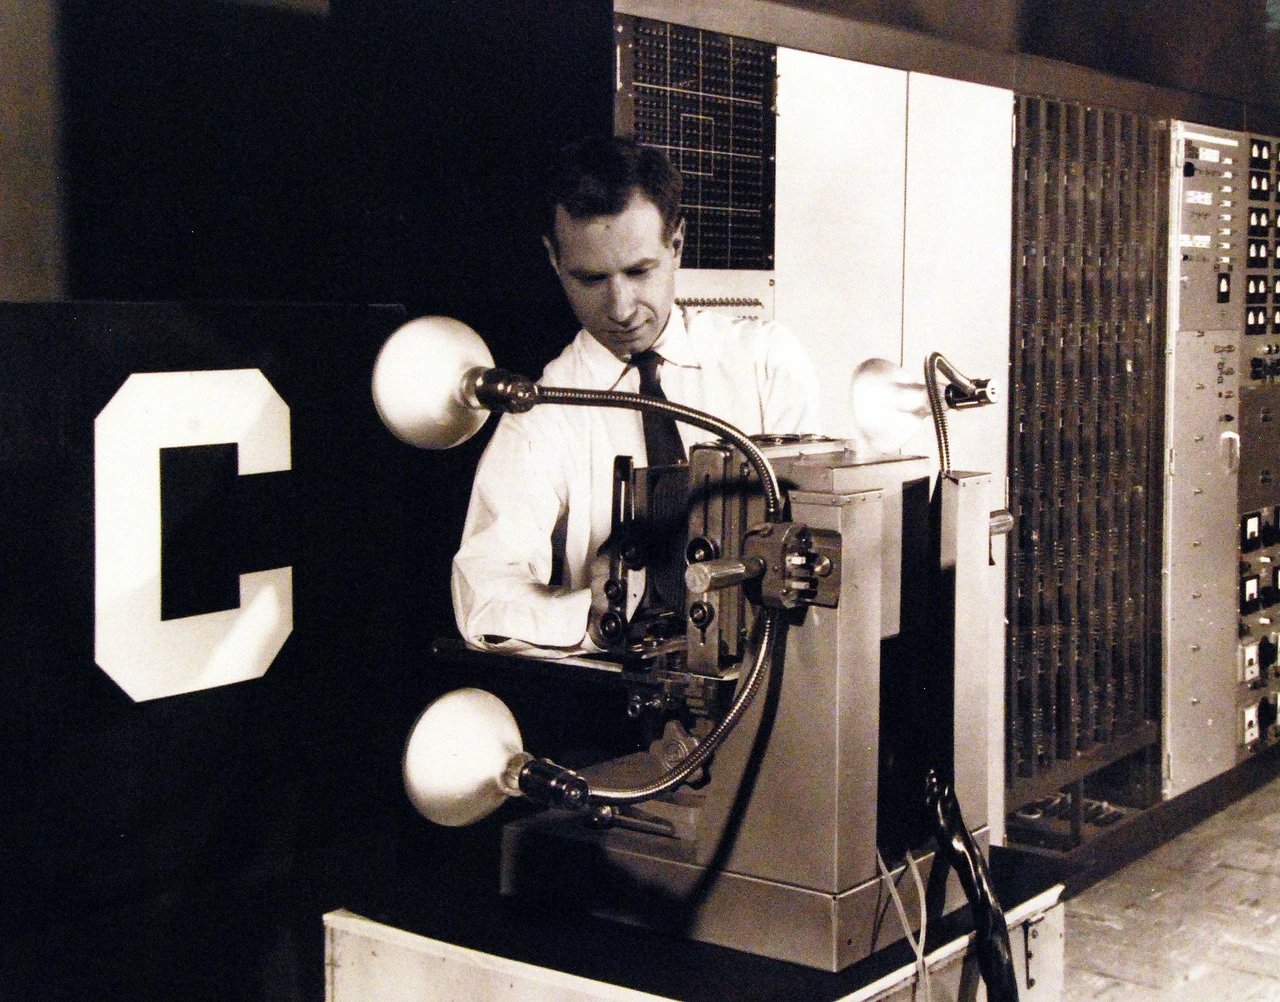
输入先被转换成信号,再经过连接形成输出。照片中的装置把“看见图样”和“调整连接”变成了可以操作的研究对象;今天的数据表、特征和训练参数,延续了其中的一部分问题。

设想交给模型两条记录:第一条写着“聚乙烯,较软”,第二条也写着“聚乙烯,较软”,实际上一条是薄膜,一条是厚板。不管模型内部有多少层,它看到的输入完全一样,就不可能把两者区分开。只有补上厚度,这两条记录在模型眼里才成为不同的对象。这就是本节反复强调连接、尺度和分布的原因:它们是把物理差别保存进数据的手段。给蛋白质补上序列,给糖链补上连接位置和分支,给凝胶补上含水率和交联状态,都是同一个思路在不同材料上的应用。
建表时,可以把“输入”和“目标”翻译成两个朴素的问题:预测之前,我们已经知道什么?预测之后,我们想得到什么?如果目标是在制备之前筛选候选材料,输入就应该是配方、序列和计划采用的工艺;如果目标是评价已经做好的样品,就可以使用事先测好的结构或含水率。信息在什么时候能拿到,非常关键。比如,用拉伸试验后观察到的断口形貌去“预测”同一次试验的断裂强度,其实是在做事后分析;想在样品断裂之前就做出判断,就必须换成事先能拿到的信息。机器学习中把这类“用了预测时本不该知道的信息”的问题称为信息泄漏。
| 想说明什么 | 可记录的信息 | 它帮助模型区别什么 |
|---|---|---|
| 是哪一类分子 | 重复单元、蛋白序列、糖链连接 | 组成、顺序与拓扑 |
| 这一批样品由哪些链组成 | Mn、Mw、分布或组分比例 | 平均值相同而分布不同的样品 |
| 怎样形成现在的结构 | 加工批次、拉伸方向、含水率 | 同一种分子的不同材料状态 |
| 怎样观察性能 | 尺寸、温度、测试速度、加载方向 | 材料响应与试验条件的共同影响 |
| 模型要输出什么 | 指定定义和单位的尺寸、刚度或强度 | 清楚区分不同的预测任务 |
AI也可以从“整理信息”这一步就参与进来。比如,让语言模型从实验记录中提取样品编号、配方、尺寸和测试条件,整理成表格,并附上每一项对应的原文句子;再用一小段程序统一单位,列出记录中缺失的字段,以便安排补测或查找原始记录。对生物大分子,还可以把序列、修饰和实验条件分开存放,再用样品编号关联起来。这样整理出的数据,人回头核对很方便,后续接入序列模型或图神经网络也很方便。下面这个小任务可以直接交给语言模型试试,拿到输出后再和原始记录逐项对照。
可复制的材料记录整理任务
请把下面的材料实验记录整理为一行结构化数据,字段包括样品编号、材料名称、宽度、厚度、自由长度、夹持方式、加载位置、温度、材料模量及其测量来源。每个字段同时给出数值或描述、单位和支持它的原句;原文未提供的字段写null,并列出需要补充的测量或记录。原文:“样品A为同一批次制得的聚合物薄条,宽5 mm,厚0.50 mm,自由长度20 mm。一端夹紧,在另一端施加小幅竖向力。该批材料另取试样,在相同温度下独立测得拉伸模量为500 MPa。”
读输出时,先检查两点:一是“相同温度”这个条件关系有没有被保留下来;二是具体温度数值是否仍然标为 null,没有被模型自行编造。这个细节决定了来自不同来源的记录能不能直接放在一起比较。
后面的章节会沿着这条思路继续:学习图神经网络(GNN)时,我们会把“谁和谁相连”保存成图;学习蛋白质和核酸的表示时,会把序列和结构放在一起;学习“设计—实验”闭环时,还会记录每一次计算和实验的状态。本节先打下它们共同的基础:一份数据不只是一个数值,还要说明这个数值属于谁、怎样得到、在什么条件下成立。把这些信息整理好,模型学习和科学解释才能围绕同一个对象展开。
05做一次AI实验:薄片容易弯,究竟要记录什么
为了亲眼看到“补上一个物理量”怎样改变预测,我们把薄膜和水瓶的复杂比较,缩小成一个能算清楚的问题:取一根均匀的长条,一端夹紧,在另一端向下施加一个很小的力,看末端移动了多少。这就像把一把塑料尺伸出桌边,再轻轻往下按。力稍微加大,位移也随之增大;在小变形、近似线性的范围内,用力 F 除以末端位移 δ,就得到这根条带的初始弯曲刚度 k。注意,k 描述的是整个物体有多难弯,单位可以是 N/mm;而弹性模量 E 描述的是材料本身,即产生单位应变需要多大的应力,单位是 MPa,也就是 N/mm²。
这个区分很实用。同一种材料做得更厚,整体就更难弯;同样尺寸的条带换成模量更大的材料,也会更难弯。你手里感受到的“软硬”,是材料模量和几何形状共同决定的。对于均匀材料、矩形截面、线弹性、小挠度的细长悬臂梁,设条带宽度为 w、厚度为 h、自由长度为 ℓ,有下面的关系。这个例子把材料和几何的作用清楚地分开,很适合用来构造第一组AI学习数据。[7]
先读懂公式怎样分配材料和尺寸的作用。宽度加倍,相当于并排多放一根相同的条带,刚度也加倍;自由长度加倍,同样的力更容易压弯条带,刚度降到原来的八分之一;厚度加倍,刚度则变为原来的八倍。厚度影响很大,是因为弯曲时存在一个近似不伸不缩的中性层,离它越远的材料伸长或压缩得越多,对抗弯曲的力矩也越大。把截面上各处的贡献相加,会得到矩形截面的面积二次矩 I = wh³/12;梁的末端刚度为3EI/ℓ³,代入后就是上面的式子。这里的I是描述截面几何的量,单位为长度的四次方。这个计算让“把材料放到离中性层更远处”与厚度的三次方联系起来。
单位也能帮我们检查公式。E 的单位是 N/mm²,w 的单位是 mm,h³/ℓ³ 没有单位,所以结果是 N/mm。后面的图表把它乘以1000,写成 mN/mm,数字更好读。以 E = 500 MPa、w = 5 mm、h = 0.50 mm、ℓ = 20 mm 为例,k 约为9.77 mN/mm;其他条件不变、厚度改为1.00 mm时,刚度约为78.13 mN/mm,正好是8倍。本实验中,宽度固定为5 mm,自由长度固定为20 mm,厚度在0.2—1.0 mm之间变化,只关注小位移附近的初始响应。
先固定研究对象,再让模型学习
我们构造160个虚拟材料批次。每个批次有一个模量 E,再从每个批次各取三根厚度不同的条带,共480条记录。模量在100—1000 MPa之间按对数均匀抽取(即在对数尺度上均匀分布),厚度在0.2—1.0 mm之间均匀抽取。先用梁公式算出每根条带的刚度,再乘上一个接近1的随机因子来模拟测量波动:这个因子取自然对数后,标准差为0.04,所以波动大约在百分之几。这组数据完全按指定的物理模型生成,好处是我们既知道“标准答案”,又能看到学习结果,正好用来检查模型到底用上了哪些信息。
接着分出120个批次用于训练,40个批次用于测试。同一批次的三根条带始终放在同一侧,因为它们共享材料模量与批次身份。训练部分用来选择参数,测试部分用来观察新批次上的预测。这个安排与真实生物材料研究十分接近:一份丝蛋白溶液制成的多根纤维、同一次制备得到的多个凝胶试样,都可能共享一些隐含条件。用批次编号把它们关联起来,便能按照研究目标安排“新试样”或“新批次”的评价。
我们比较三种回归输入:只给 E、只给 h、同时给 E 和 h。为了方便学习幂律关系,特征使用无量纲比值的自然对数。可以把对数理解成一个“把乘法变成加法”的工具:厚度乘以2,ln(h/h₀) 就增加 ln 2;刚度乘以8,ln(k/k₀) 就增加 ln 8,也就是 3 ln 2。于是,三次方关系在对数坐标中就变成了一条斜率为3的直线。这里取 E₀ = 100 MPa、h₀ = 0.5 mm、k₀ = 1 mN/mm;比值的分子分母单位相同,所以取对数的对象都是纯数。
a、b、c 是要从训练数据中确定的参数,不需要手动去猜。程序用最小二乘法找一组值,让训练记录中“预测的对数刚度”与“观测的对数刚度”之差的平方和尽可能小。训练好以后,给出一根新条带的 E 和 h,代入公式就能得到预测值。“只看 E”的模型去掉含 h 的那一项,“只看 h”的模型去掉含 E 的那一项。三种模型使用相同的批次划分和相同的训练目标,唯一的区别是它们能看到哪些信息。
| 模型看到的输入 | 平均绝对误差 mN/mm | 平均绝对百分比误差 |
|---|---|---|
| 只看材料模量 E | 13.3805 | 199.33% |
| 只看厚度 h | 8.9018 | 59.84% |
| 同时看 E 与 h | 0.7608 | 3.75% |
平均绝对误差(MAE)是把每根条带的预测与观测之差取绝对值,再求平均;它保留刚度单位。平均绝对百分比误差(MAPE)先把绝对误差除以该条带的观测值,再求平均并乘以100%,用来观察相对偏差。只有E时,模型会把同一批次的不同厚度条带赋予相同预测,厚度带来的大幅差异就被压进了误差;只有h时,模型看到了尺寸,却把不同材料的模量差异混在一起。同时输入E和h后,这组测试的平均绝对误差为0.7608 mN/mm,平均绝对百分比误差为3.75%。学到的两个斜率分别约为1.0042与3.0000,与生成关系中的一次方和三次方对应。
同一批测试对象,换一组输入再看预测
试着保持E不变,只移动厚度滑块,并在三种模型之间切换。只看E的模型输出保持不变,是因为它的输入没有变化;同时看E和h的模型会随厚度作出相应变化。这正是本次实验要读懂的现象:把决定响应的物理信息放进表示,学习才有机会对应到真正的差别。我们知道这组数据的解析公式,因此用公式作直接计算最方便;训练模型在这里承担的是一个有标准答案的学习实验,让你能够检查特征、拟合与独立评价的每一步。
完整Python例子:生成数据、学习规律、画出结果
下面的代码使用NumPy和Matplotlib。复制到一个Python文件后运行,即可得到表中的三组误差以及随后展示的六幅结果图;随机种子固定,批次划分也随之固定。column_stack把不同输入列排成表格,lstsq寻找最小二乘参数,exp把对数预测还原为刚度。布尔数组train和test负责选择记录,不需要手工逐行移动数据。
# AI4S in Hand · Science 补给 · 材料科学
import numpy as np

# 160 virtual material batches; three strips per batch.
# E: MPa = N/mm^2; h, width and free length: mm.
rng = np.random.default_rng(20261021)
batch = np.repeat(np.arange(160), 3)
E = np.repeat(np.exp(rng.uniform(np.log(100), np.log(1000), 160)), 3)
h = rng.uniform(0.2, 1.0, len(batch))
width, length = 5.0, 20.0

# Rectangular, uniform, linear-elastic cantilever; small deflection.
# Convert N/mm to mN/mm by multiplying by 1000.
k_exact = 1000 * E * width * h**3 / (4 * length**3)
noise = rng.normal(0, 0.04, len(batch))
k_observed = k_exact * np.exp(noise)

# Keep every strip from one batch in the same data subset.
order = rng.permutation(160)
test = np.isin(batch, order[:40])
train = ~test
assert set(batch[train]).isdisjoint(set(batch[test]))

# Logs use dimensionless ratios; k is divided by 1 mN/mm.
one = np.ones(len(batch))
x_E = np.log(E / 100)
x_h = np.log(h / 0.5)
y = np.log(k_observed / 1.0)
inputs = {
    "material": np.column_stack([one, x_E]),
    "thickness": np.column_stack([one, x_h]),
    "both": np.column_stack([one, x_E, x_h]),
}

results = {}
for name, X in inputs.items():
    weights = np.linalg.lstsq(X[train], y[train], rcond=None)[0]
    predicted = np.exp(X @ weights)  # mN/mm
    mae = np.mean(np.abs(predicted[test] - k_observed[test]))
    mape = 100 * np.mean(np.abs(predicted[test] / k_observed[test] - 1))
    results[name] = dict(weights=weights, predicted=predicted, mae=mae, mape=mape)
    print(name, "weights =", weights.round(4),
          "MAE =", round(mae, 4), "mN/mm; MAPE =", round(mape, 2), "%")

# 接在上方拟合代码之后运行:生成可复用的结果图与表格。
from pathlib import Path
import csv
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import font_manager
from matplotlib.ticker import FuncFormatter

output = Path("strip_learning_outputs")
output.mkdir(exist_ok=True)
# 优先使用系统中已有的中文字体;跨平台时可安装 Noto Sans CJK SC。
available = {f.name for f in font_manager.fontManager.ttflist}
font = next((n for n in ["Microsoft YaHei", "Noto Sans CJK SC", "SimHei"]
             if n in available), "DejaVu Sans")
plt.rcParams.update({
    "font.family": font, "font.size": 13, "axes.labelsize": 13,
    "axes.titlesize": 14, "axes.titleweight": "bold",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.edgecolor": "#80918d", "text.color": "#203b39",
    "axes.labelcolor": "#203b39", "xtick.color": "#53676e",
    "ytick.color": "#53676e", "axes.unicode_minus": False,
    "figure.facecolor": "white", "axes.facecolor": "white",
    "svg.fonttype": "path", "svg.hashsalt": "ai4s-strip-20261021",
})
colors = {"material": "#b46b36", "thickness": "#6170a4", "both": "#00796f"}
labels = {"material": "只看 E", "thickness": "只看 h", "both": "同时看 E 和 h"}
keys = list(results)
formatter = FuncFormatter(lambda value, _: f"{value:g}")

# 每次重新抽取的是40个测试批次,每个批次的3根条带一起进入。
# 这描述固定已训练模型在测试批次组成变化时的MAE波动。
test_batches = np.unique(batch[test])
bootstrap_rng = np.random.default_rng(20261022)
resamples = bootstrap_rng.integers(0, len(test_batches), (2000, len(test_batches)))
intervals = {}
for name in keys:
    error = np.abs(results[name]["predicted"] - k_observed)
    batch_mae = np.array([error[batch == g].mean() for g in test_batches])
    intervals[name] = np.quantile(batch_mae[resamples].mean(axis=1), [0.025, 0.975])

def draw_panel(ax, kind):
    ax.grid(color="#e6ece8", linewidth=0.7, zorder=0)
    if kind in keys:
        name = kind
        ax.loglog([.1, 200], [.1, 200], color="#82928e", ls="--", lw=1.2)
        ax.scatter(k_observed[test], results[name]["predicted"][test],
                   c=colors[name], s=23, alpha=.75, edgecolors="white", linewidths=.35)
        ax.set(xlim=(.1, 200), ylim=(.1, 200),
               xlabel="观测刚度 / (mN/mm)", ylabel="预测刚度 / (mN/mm)")
        ax.set_xticks([.1, 1, 10, 100]); ax.set_yticks([.1, 1, 10, 100])
        ax.xaxis.set_major_formatter(formatter); ax.yaxis.set_major_formatter(formatter)
        ax.minorticks_off()
        ax.set_title(labels[name], loc="left", color=colors[name], pad=13)
        ax.text(.04, .94, f"MAE  {results[name]['mae']:.3f}",
                transform=ax.transAxes, va="top", fontsize=12,
                bbox=dict(facecolor="white", alpha=.9, edgecolor="none", pad=3))
    elif kind == "residuals":
        for name in keys:
            residual = np.log10(results[name]["predicted"][test] / k_observed[test])
            ax.scatter(h[test], residual, s=16, alpha=.55, color=colors[name], label=labels[name])
        ax.axhline(0, color="#203b39", lw=1)
        ax.set(xlabel="厚度 h / mm", ylabel=r"$\log_{10}$(预测值 / 观测值)",
               xlim=(.18, 1.02), ylim=(-1.25, 1.6))
        ax.set_title("误差是否随厚度变化", loc="left", pad=13)
        ax.legend(frameon=False, fontsize=10, loc="upper right")
    elif kind == "response":
        thickness = np.linspace(.2, 1, 150)
        truth = 1000 * 500 * width * thickness**3 / (4 * length**3)
        ax.plot(thickness, truth, color="#203b39", lw=4, alpha=.3, label="物理公式")
        for name in keys:
            ones = np.ones(len(thickness))
            features = {"material": [ones, ones*np.log(500/100)],
                        "thickness": [ones, np.log(thickness/.5)],
                        "both": [ones, ones*np.log(500/100), np.log(thickness/.5)]}
            prediction = np.exp(np.column_stack(features[name]) @ results[name]["weights"])
            ax.plot(thickness, prediction, color=colors[name], lw=2,
                    ls="--" if name == "both" else "-", label=labels[name])
        ax.set(xlabel="厚度 h / mm", ylabel="初始刚度 / (mN/mm)",
               xlim=(.2, 1), ylim=(0, 85))
        ax.set_title("固定 E = 500 MPa,再改变厚度", loc="left", pad=13)
        ax.legend(frameon=False, fontsize=10, loc="upper left")
    elif kind == "uncertainty":
        for i, name in enumerate(keys):
            mid = results[name]["mae"]; low, high = intervals[name]
            ax.hlines(i, low, high, color=colors[name], lw=4)
            ax.scatter(mid, i, s=75, color=colors[name], zorder=3, edgecolors="white")
            ax.annotate(f"{mid:.3f}  [{low:.3f}, {high:.3f}]", (mid, i),
                        xytext=(0, 14), textcoords="offset points", ha="center", fontsize=10)
        ax.set_xscale("log"); ax.set_xlim(.35, 28); ax.set_ylim(-.6, 2.7)
        ax.set_yticks(range(3), [labels[k] for k in keys]); ax.tick_params(axis="y", labelsize=11)
        ax.set_xticks([.5, 1, 3, 10, 20]); ax.xaxis.set_major_formatter(formatter); ax.minorticks_off()
        ax.set_xlabel("测试 MAE / (mN/mm),对数刻度")
        ax.set_title("按批次重抽样的95%区间", loc="left", pad=13)

panel_ids = keys + ["residuals", "response", "uncertainty"]
for panel_id in panel_ids:
    fig, ax = plt.subplots(figsize=(5.2, 4.5), layout="constrained")
    draw_panel(ax, panel_id)
    fig.savefig(output / f"{panel_id}.svg", metadata={"Date": None})
    fig.savefig(output / f"{panel_id}.png", dpi=180)
    plt.close(fig)

fig, axes = plt.subplots(2, 3, figsize=(16.2, 10.0), layout="constrained")
for ax, panel_id in zip(axes.flat, panel_ids):
    draw_panel(ax, panel_id)
fig.suptitle("输入表示如何改变学习结果\n120根测试条带 · 40个独立测试批次 · 合成数据", fontsize=20)
fig.savefig(output / "model_diagnostics.svg", metadata={"Date": None})
fig.savefig(output / "model_diagnostics.png", dpi=220)
plt.close(fig)
with (output / "model_summary.csv").open("w", newline="", encoding="utf-8-sig") as f:
    writer = csv.writer(f)
    writer.writerow(["model", "MAE_mN_per_mm", "MAPE_percent", "MAE_q025", "MAE_q975"])
    for name in keys:
        writer.writerow([name, results[name]["mae"], results[name]["mape"], *intervals[name]])
print("结果图与汇总表已保存至:", output.as_posix())
只看材料模量 E:MAE = 13.3805 mN/mm;MAPE = 199.33%
只看厚度 h:MAE = 8.9018 mN/mm;MAPE = 59.84%
同时看 E 与 h:MAE = 0.7608 mN/mm;MAPE = 3.75%
结果图与汇总表:strip_learning_outputs/
把一次运行读成一组相互解释的结果图
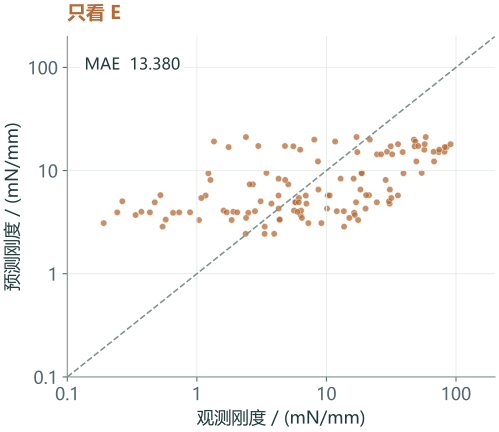
A · 只知道E时,厚度不同的条带被混在同一种预测里。
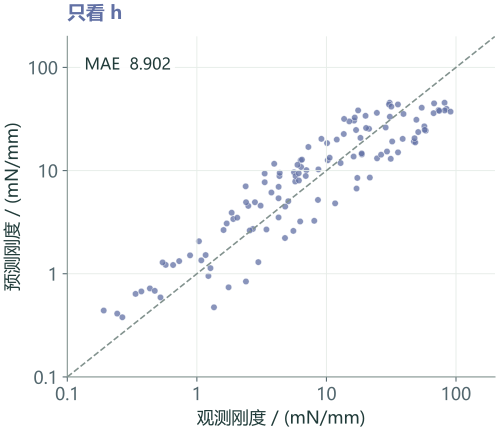
B · 厚度帮助模型恢复变化趋势,材料模量的差异仍留在散点中。
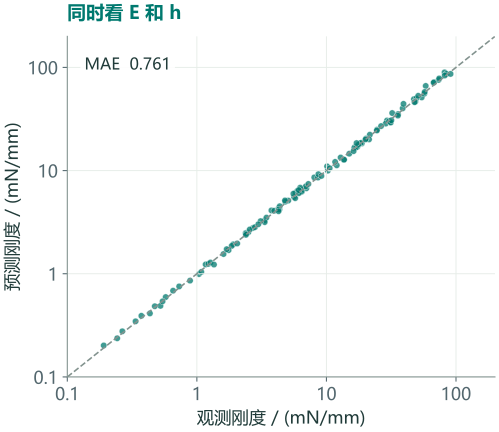
C · 把E与h同时保留,预测与观测靠近同一条对角线。
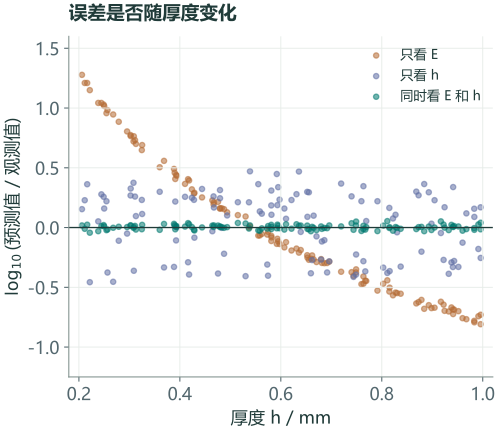
D · 残差随厚度形成曲线,提示输入遗漏了随厚度变化的信息。
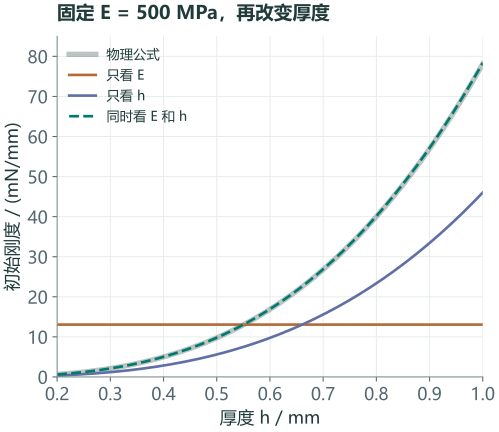
E · 固定材料模量后,比较三种模型如何响应厚度变化。
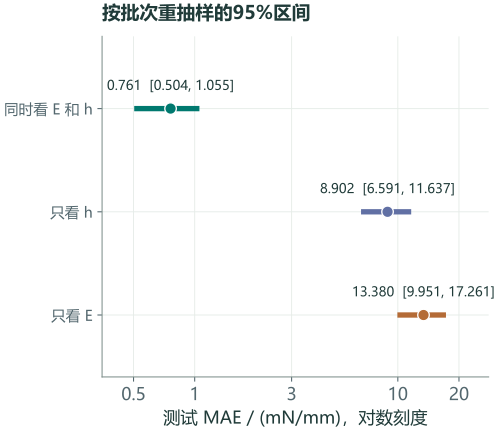
F · 点是测试MAE,线段表示按测试批次重抽样得到的95%区间。
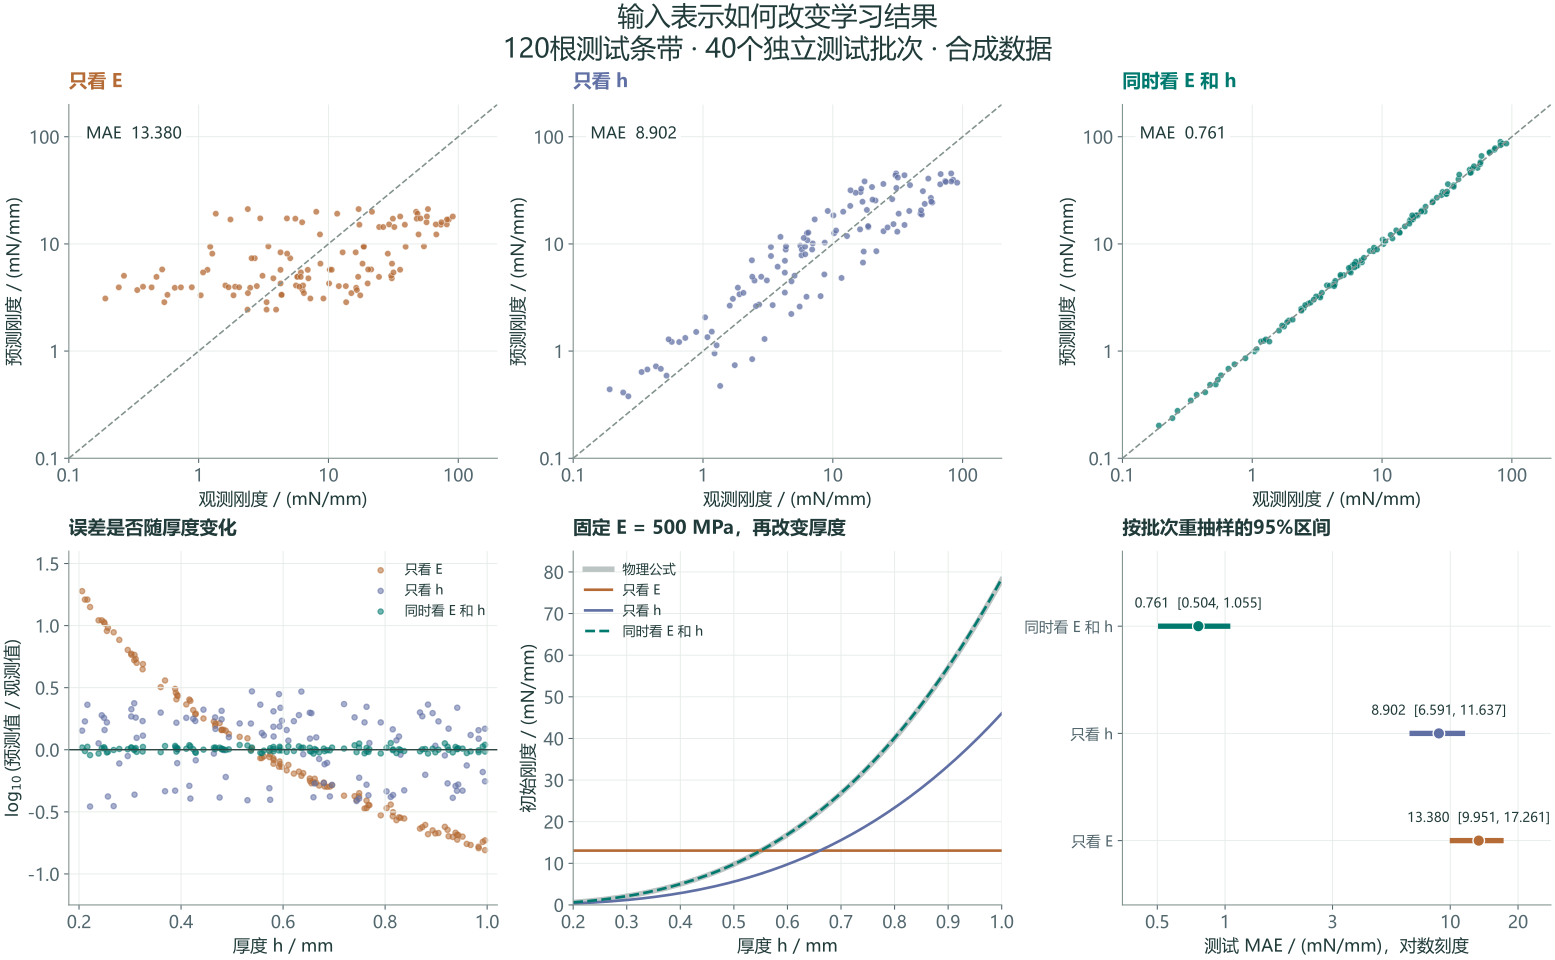
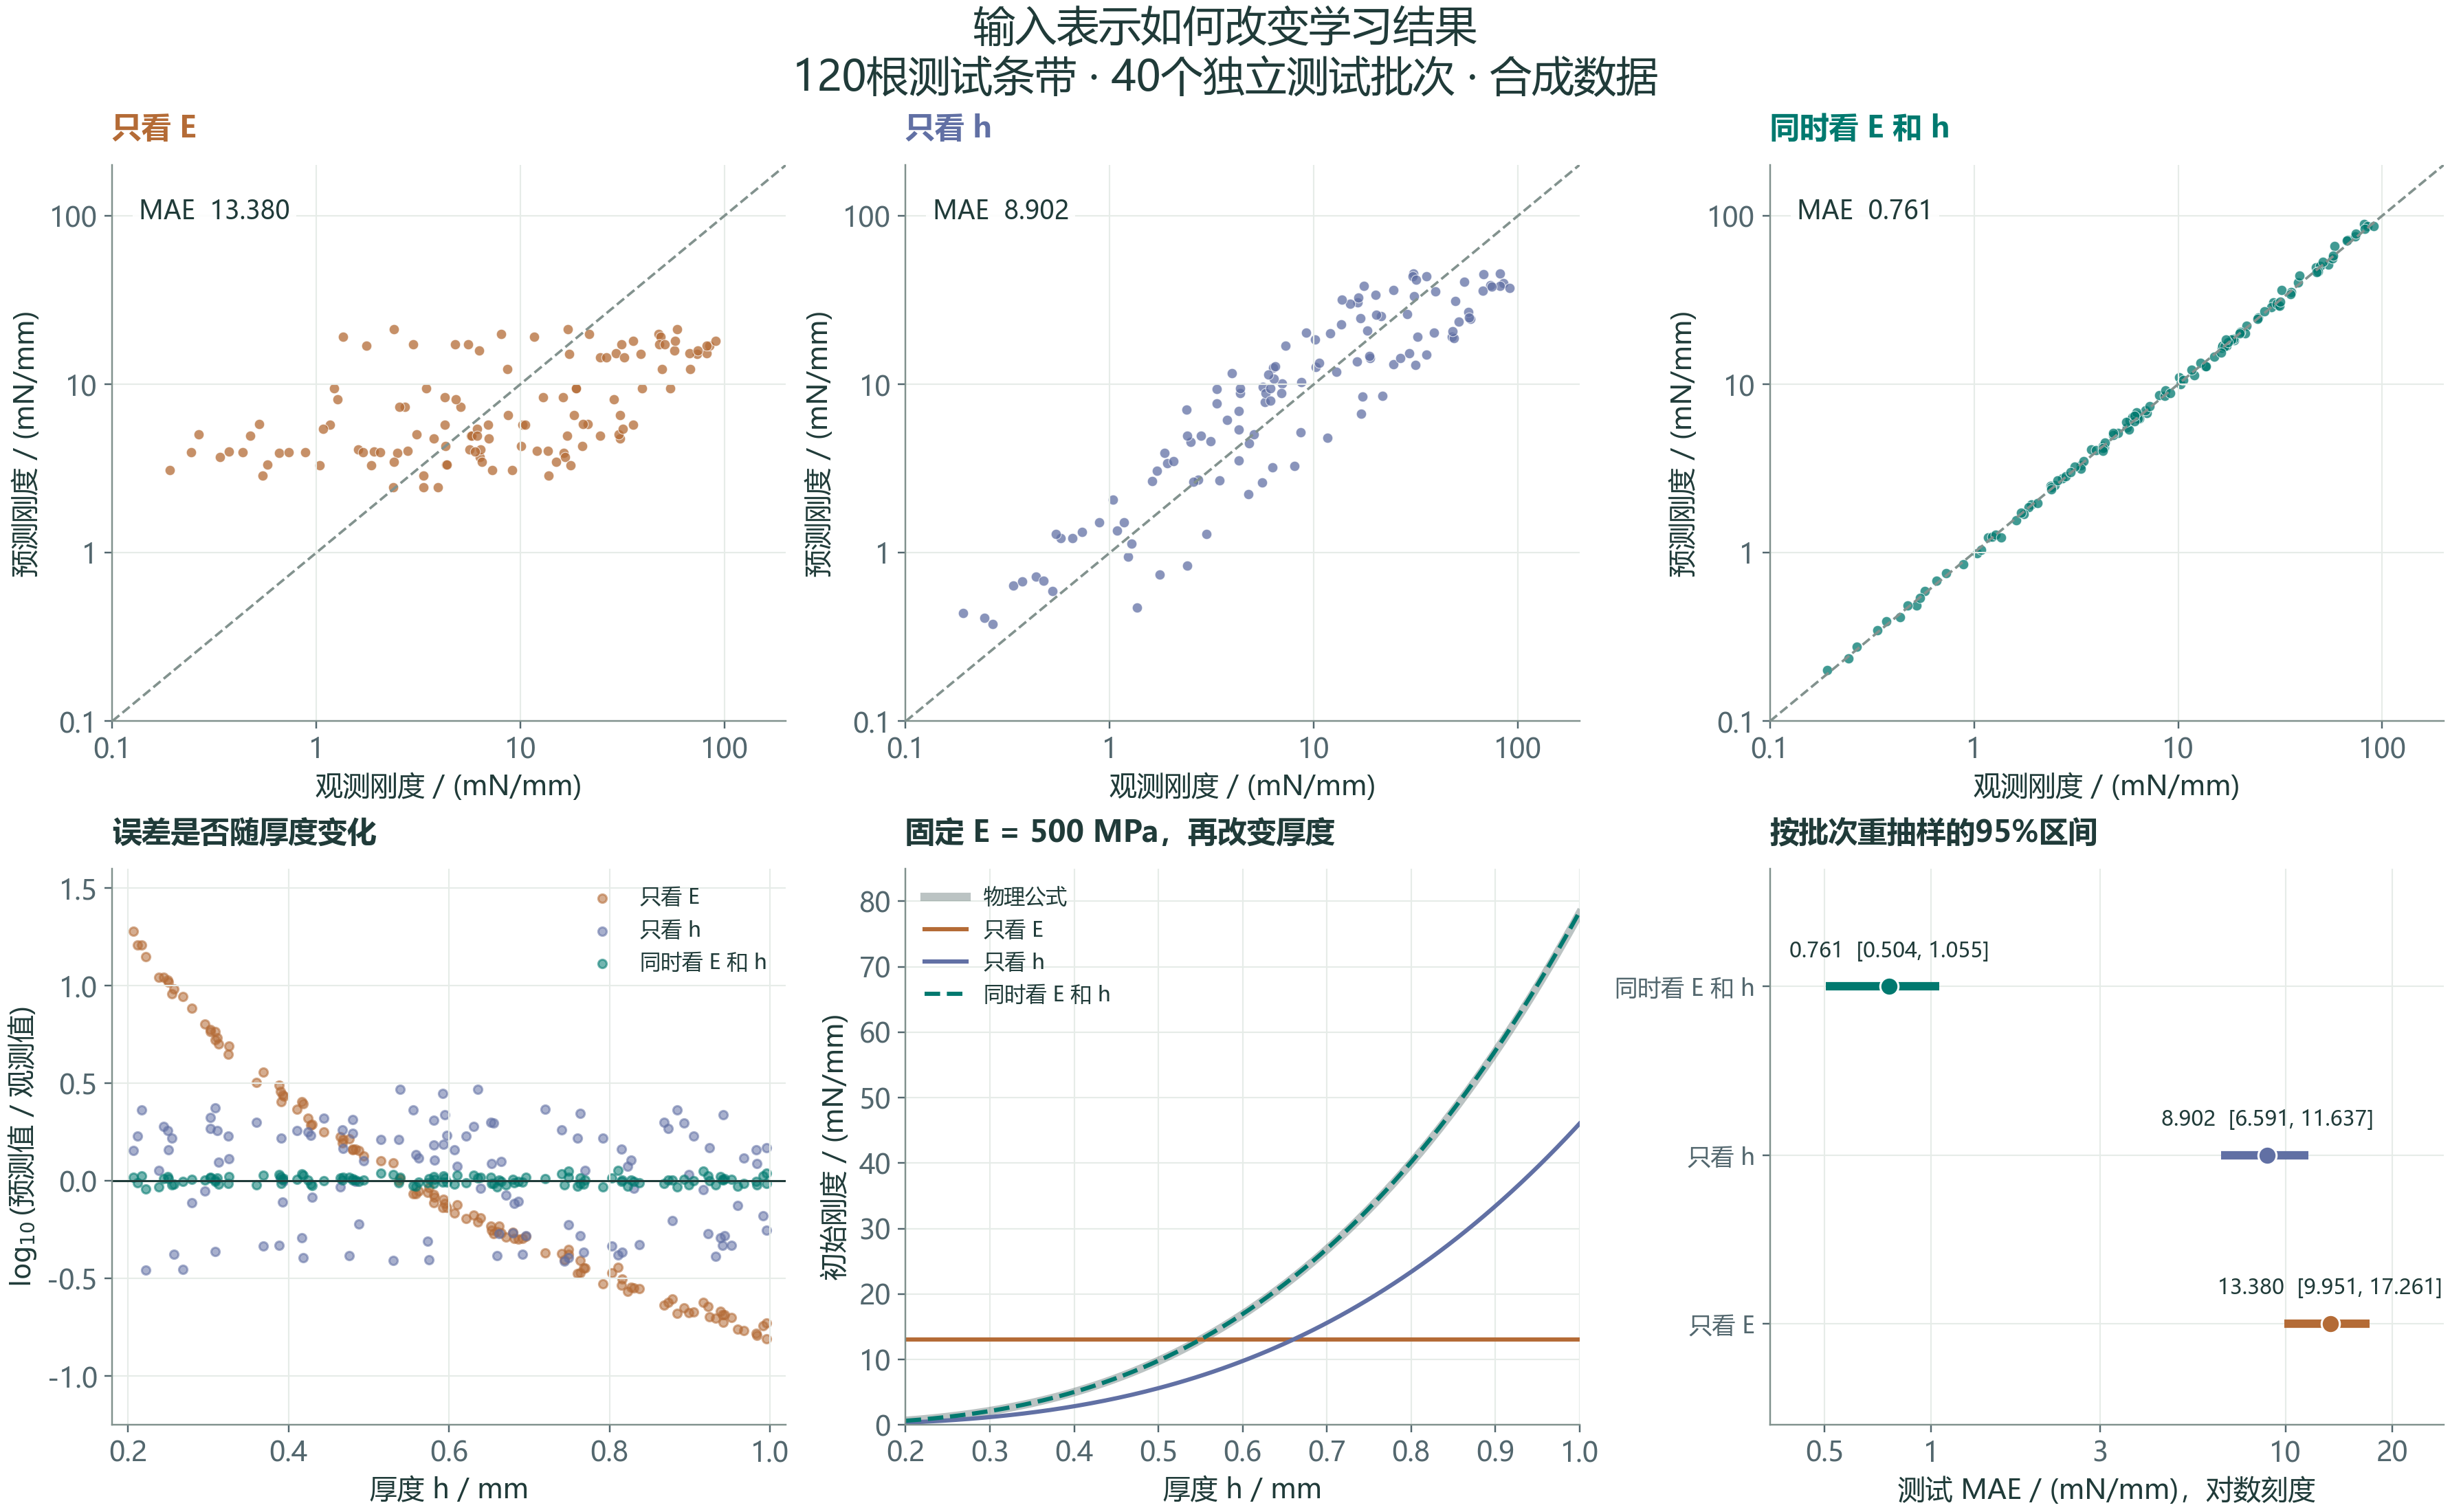
先把A、B、C看成同一场比较:点越靠近对角线,预测与观测越接近。只看E的模型把不同厚度造成的差异留在了误差里;只看h的模型抓住了厚度的作用,却把材料之间的差别混在一起。D进一步把误差放回物理变量旁边。纵轴为预测值与观测值之比的以10为底对数,0表示两者相同,1表示预测为观测的10倍,−1表示预测为观测的十分之一。若残差随h系统变化,就值得回到模型的输入与物理关系中寻找原因。
E把这个判断变成一个可以提问的实验:保持材料模量不变,把条带做得更厚,模型的输出会怎样改变?三种曲线把输入信息的差别直接显示出来。F则提醒我们,测试集本身也来自一批有限样品。这里从40个测试批次中有放回地抽取40次,重复2000轮,每轮重新计算MAE;截取中间95%的结果,得到图中的区间。它描述的是固定模型面对这批测试样本组成变化时的误差波动。模型重训、制备条件改变或进入新的材料家族,需要在相应的数据层次上另行评价。
把这个练习接到真实的生物大分子研究时,可以保留同样的组织方法,再换成具体对象。例如研究丝蛋白薄膜,先确定是预测已制成样品的初始刚度,还是在制备前选择配方;然后记录蛋白来源、处理历史、含水率、厚度与测试条件。若E作为输入,应由预测前的独立测量或可信材料模型提供;若希望直接从序列或工艺预测,则需要让这些信息成为输入,重新建立训练任务。模型输出也要与测量一一对应:小形变刚度、断裂强度和耗散能各自回答不同问题。
回看科学史,就能看见一条连续的研究路线。Staudinger把注意力引向长链的化学连接,Sanger及同事把生物大分子的身份具体到残基顺序和连接,学习模型则让我们尝试从这些表示中提取与目标有关的规律。今天的研究还需要把环境和加工接进来:哪一部分关系已经由物理模型解释,哪一部分适合交给数据学习,下一次测量又能补上什么信息。科学史中的每次概念推进,都在帮助我们把“研究对象是什么”说得更清楚。
把本节变成自己的研究起点。 选一件熟悉的生物材料,例如棉线、丝线或明胶制品。写一段连续的描述:它由哪些分子组成,这些分子怎样连接和组织,你观察到什么现象,准备用什么量测量它。再画出一张最小数据表,说明每一行对应什么对象、每一列在预测之前怎样获得。先完成这段描述,再决定需要序列模型、图模型还是简单回归。
从生活物品走到分子和AI,我们已经学会了第一件事:用合适的对象、尺度与表示,把一个现象变成可以计算的问题。下一步将进一步追问,同一条链不断改变形状时,怎样用许多幅构象照片描述它的规律。
资料与延伸阅读
化学单元、链形和条带为示意图;交互图与结果图中的数值按图注给出的构造规则计算。
- IUPAC Gold Book,Macromolecule。用于理解高分子与组成单元的术语。
- ETH Library,Hermann Staudinger (1881–1965)。大分子观念与获奖历史;橡胶加氢实验见Staudinger与Fritschi (1922),Über die Hydrierung des Kautschuks und über seine Konstitution,Helvetica Chimica Acta 5,785–806。
- Ryle, Sanger, Smith & Kitai (1955),The disulphide bonds of insulin,Biochemical Journal 60,541–556;另见Sanger的1958年诺贝尔演讲:The Chemistry of Insulin。
- Stepto (2009),Dispersity in polymer science (IUPAC Recommendations 2009),Pure and Applied Chemistry 81,351–353。
- Rosenblatt (1958),The perceptron: A probabilistic model for information storage and organization in the brain,Psychological Review 65,386–408。可从开篇的问题与感知机组织方式读起。
- Flory (1974),Spatial Configuration of Macromolecular Chains,诺贝尔演讲。从链的化学结构与转动自由度理解空间构象和统计性质。
- Bower,Applied Mechanics of Solids,§10.3.2 Euler–Bernoulli梁理论。结合矩形截面的面积二次矩,可得到小挠度悬臂条带的刚度。
- BIPM,The mole,摩尔与阿伏伽德罗常数的定义。